

Klasifikimi i të dhënave në bazë të përmbajtjes është një detyrë e hapur. Sistemet tradicionale për parandalimin e humbjes së të dhënave (DLP) e zgjidhin këtë problem duke krijuar gjurmë të të dhënave përkatëse dhe duke monitoruar pikëfundet për të marrë gjurmët. Duke marrë parasysh numrin e madh të burimeve të dhënash që ndryshojnë vazhdimisht në Facebook, ky qasje është jo vetëm jo e shkallëzuar, por gjithashtu joefektive për të përcaktuar se ku ndodhen të dhënat. Ky artikull është i përkushtuar për një sistem të plotë, i ndërtuar për të zbuluar lloje të ndjeshme semantike në Facebook në shkallë dhe për të siguruar automatikisht ruajtjen e të dhënave dhe kontrollin e qasjes.
Qasja e përshkruar këtu është sistemi ynë i parë i plotë për privatësi, i cili përpiqet të zgjidhë këtë problem duke përfshirë sinjalet e të dhënave, mësimin e makinerive dhe metodat tradicionale të gjurmimit për të paraqitur dhe klasifikuar të gjitha të dhënat në Facebook. Sistemi i përshkruar operon në një mjedis prodhimi, duke arritur një rezultat mesatar F2 mbi 0,9 për klasat e ndryshme të privatësisë ndërsa përpunon një numër të madh burimesh të dhënash në dhjetëra depo. Po paraqesim përkthimin e publikimit të Facebook në ArXiv mbi klasifikimin e shkallëzueshëm të të dhënave për të siguruar sigurinë dhe privatësinë në bazë të mësimit të makinerisë.
Hyrje
Sotditë organizatat mbledhin dhe ruajnë sasi të mëdha të dhënash në formate dhe vende të ndryshme [1], pastaj të dhënat konsumohet në shumë vende, ndonjëherë kopjohen ose ruajnë disa herë, duke rezultuar që informacioni i vlefshëm dhe i fshehtë i biznesit shpërndahen në shumë depo të dhënash korporative. Kur një organizatë kërkohet të përmbushë disa kërkesa ligjore ose rregullative, siç është përmbushja e rregullave gjatë procedurave civile, shfaqet nevoja për të mbledhur informacion mbi vendndodhjen e të dhënave të nevojshme. Kur një urdhër për mbrojtjen e të dhënave thotë se organizata duhet të mashtrojë të gjithë numrat e sigurimeve shoqërore (SSN) gjatë transferimit të informacionit personal te subjekte të paautorizuara, hapi natyror i parë është të kërkojmë të gjithë SSN në depo të dhënash të gjithë organizatës. Në ato rrethana, klasifikimi i të dhënave bëhet jetik [1]. Një sistem klasifikimi do t’i lejojë organizatat të sigurojnë automatikisht përputhshmërinë me politikën e mbi periodit dhe privatësisë, siç është përfshirja e politikave të menaxhimit të aksesit, ruajtjes së të dhënave. Facebook paraqet një sistem të ndërtuar nga ne në Facebook që përdor një shumëllojshmëri sinjalesh të dhënash, një arkitekturë të sistemit të shkallëzuar dhe mësim makine për zbulimin e llojeve të dhënave sensitive semantike.
Zbulimi dhe klasifikimi i të dhënave janë kërkimi dhe etiketimi i tyre në një mënyrë që, kur është e nevojshme, informacioni përkatës mund të nxirret shpejt dhe efikasht. Procesi aktual është kryesisht manual dhe përfshin shqyrtimin e ligjeve ose rregullativave përkatëse, përcaktimin e llojeve të informacionit që duhet të përllogariten të ndjeshme dhe çfarë janë nivelet e ndryshme të ndjeshmërisë, dhe pastaj ndërtimin përkatës të klasave dhe politikave të klasifikimit [1]. Pas sistemeve të mbrojtjes nga humbja e të dhënave (DLP), merren gjurmët e të dhënave dhe ndiqen pikëfundet poshtë për të marrë gjurmë. Kur punoni me një depo me shumë aktive dhe petabajt të dhënash një qasje e tillë thjesht nuk shkallëzohet.
Qëllimi ynë është të ndërtojmë një sistem klasifikimi të të dhënave që shkallëzohet si për të dhënat e qëndrueshme ashtu edhe për të dhënat e paqëndrueshme të përdoruesve, pa ndonjë kufizim të mëtejshëm mbi llojin ose formatin e të dhënave. Kjo është një qëllim guximtar dhe, natyrisht, vjen me sfida. Çdo regjistrim të dhënash mund të ketë një gjatësi prej mijëra karakteresh.
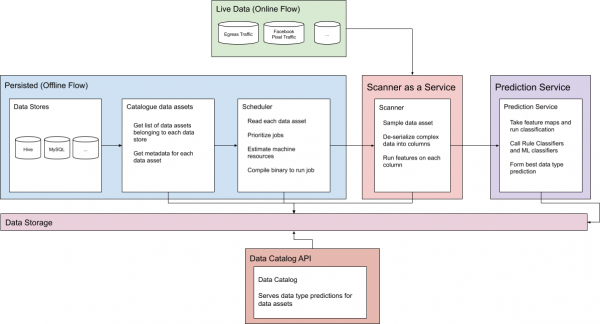
Fig. 1. Flukset e parashikimit online dhe offline
Prandaj, ne duhet ta paraqesim atë në mënyrë efikase, duke përdorur një grup të përbashkët veçorish, të cilat më pas mund të kombinohen dhe lehtësisht të lëvizin. Këto veçori duhet të sigurojnë jo vetëm klasifikim të saktë, por gjithashtu fleksibilitet dhe zgjerueshmëri për shtimin dhe zbulimin e lehtë të llojeve të reja të të dhënave në të ardhmen. Në radhë të dytë, duhet të merremi me tabela të mëdha autonome. Të dhënat e qëndrueshme mund të ruhen në tabela me përmasa prej disa petabaytësh. Kjo mund të shkaktojë një rënie të shpejtësisë së skanimit. Në radhë të tretë, ne duhet të zbatojmë klasifikim të rreptë SLA për të dhënat e paqëndrueshme. Kjo e bën sistemin të jetë shumë efikas, të shpejtë dhe të sakta. Së fundi, ne duhet të sigurojmë klasifikimin e të dhënave me vonesë të ulët për të dhënat e paqëndrueshme për të kryer klasifikimin në kohë reale, si dhe për raste të përdorimit në internet.
Në këtë artikull përshkruhet si e trajtuam problemet e mësipërme dhe paraqitet një sistem klasifikimi i shpejtë dhe i shkallëzuar, i cili klasifikon elementët e të dhënave të të gjitha tipave, formateve dhe burimeve në bazë të një grupi të përbashkët veçorish. Ne rritëm arkitekturën sistemike dhe krijuam një model të veçantë të mësimit të makinerisë për klasifikim të shpejtë të të dhënave offline dhe online. Ky artikull është organizuar si më poshtë: në seksionin 2 paraqitet dizajni i përgjithshëm i sistemit. Në seksionin 3 diskutohen pjesët e sistemit të mësimit të makinerisë. Në seksionet 4 dhe 5 flitet për punën e lidhur, dhe rindërtohet një drejtim të ardhshëm.
Arkitektura
Për të përballuar problemet e të dhënave të qëndrueshme dhe të dhënave online në shkallën e Facebook-ut, sistemi i klasifikimit ka dy flukse të ndara, të cilat do t'i diskutojmë në detaje.
Të dhënat e qëndrueshme
Sistemi fillimisht duhet të njohë shumë informacion për asetet e Facebook-ut. Për çdo depo, mblidhet disa informacion themelor, si qendra e të dhënave që përmban këto të dhëna, sistemi me këto të dhëna dhe asetet e vendosura në një depo të caktuar të dhënash. Kjo formon një katalog të metadave, duke lejuar sistemin të nxjerrë të dhëna në mënyrë efikase pa e ngarkuar klientin dhe burimet që përdoren nga inxhinierë të tjerë.
Ky katalog i metadave siguron një burim të besueshëm për të gjitha asetet e skanuara dhe lejon ndjekjen e gjendjes së aseteve të ndryshme. Me këtë informacion përcaktohet prioriteti i planifikimit në bazë të të dhënave të mbledhura dhe informacionit të brendshëm nga sistemi, si koha e fundit e skanimit të suksesshëm të aktivës dhe koha e krijimit të saj, si dhe kërkesat e mëparshme për memorie dhe procesor për këtë akt, nëse ishte skanuar më parë. Pastaj, për çdo burim të dhënash (ndërsa burimet bëhen të disponueshme) thirret një detyrë për skanimin real të burimit.
Çdo detyrë është një skedar binar i kompiluar që kryen një zgjedhje Bernoulli mbi të dhënat më të fundit të disponueshme për çdo aktiv. Aktiviteti ndahen në kolona të veçanta, ku rezultati i klasifikimit të çdo kolone përpunon në mënyrë të pavarur. Gjithashtu, sistemi skanon çdo të dhënë të ngopur brenda kolonave. JSON, array, struktura të koduara, URL-të, të dhënat e serializuara base 64 dhe shumë më tepër skanohet. Kjo mund të rrisë ndjeshëm kohën e ekzekutimit të skanimit, pasi një tabelë mund të përmbajë mijëra kolona të ngulitura në një objekt binar të madh. json..
Për çdo rresht që përzgjidhet në aktivin e të dhënave, sistemi i klasifikimit nxjerr objekte flotante dhe tekstuale nga përmbajtja dhe lidh çdo objekt përsëri me kolonen nga e cila u mor. Rezultati i fazës së nxjerrjes së objekteve është një hartë e të gjitha objekteve për çdo kolonë të gjetur në aktivin e dhënave.
Për çfarë shërbejnë karakteristikat?
Koncepci i karakteristikave është një çështje kyçe. Në vend të karakteristikave float dhe text, ne mund të dërgojmë prova të papërpunuara të shenjave, të cilat janë nxjerrë drejtpërdrejt nga çdo burim të dhënash. Për më tepër, modelet e mësimit të makinerisë mund të mësojnë direkt nga çdo mostrë, e jo nga qindra llogaritje të karakteristikave, të cilat përpiqen vetëm të afrojnë mostrën. Kjo ka disa arsye:
- Privatësia është përparësi: më e rëndësishmja, koncepti i karakteristikave na lejon të ruajmë në memorie vetëm ato mostra që nxjerrim. Kjo garanton që ne ruajmë mostrën për një qëllim të vetëm dhe kurrë nuk i regjistrojmë ato me përpjekjet tona. Kjo është veçanërisht e rëndësishme për të dhënat e paqëndrueshme, pasi shërbimi duhet të mbajë një gjendje klasifikimi para se të ofrojë parashikimin.
- Memoria: disa mostra mund të kenë gjatësi nga mijëra karaktere. Ruajtja e të dhënave të tilla dhe dërgimi i tyre pjesëve të sistemit pa nevojë konsumon shumë bajta të tjerë. Dy faktorë mund të bashkohen me kalimin e kohës, duke marrë parasysh se ka shumë burime të dhënash me mijëra kolona.
- Agregimi i karakteristikave: me anë të karakteristikave, përmes setit të tyre paraqiten qartë rezultatet e çdo skanimi, duke i lejuar sistemit të bashkojë rezultatet e skanimet e mëparshme të të njëjtit burim të dhënash në një mënyrë të përshtatshme. Kjo mund të jetë e dobishme për të aggreguar rezultatet e skanimit të një burimi të dhënash në disa ekzekutime.
Pastaj, karakteristikat dërgohen në shërbimin e parashikimit, ku ne përdorim klasifikimin e bazuar në rregulla dhe mësimin e makinerisë për të parashikuar etiketat e të dhënave të çdo kolone. Shërbimi mbështetet si në klasifikuesit e rregullave, ashtu edhe në mësimin e makinerisë dhe zgjidh parashikimin më të mirë, të dhënë nga çdo objekt parashikimi.
Klasifikuesit e rregullave janë heuristika manuale, ata përdorin llogaritje dhe koeficiento për të normalizuar objektin në një gamë nga 0 në 100. Sa herë që një pikë fillestare krijohet për çdo lloj të dhënash dhe emri i kolonës që lidhet me këto të dhëna, nëse nuk bie në asnjë 'listë ndalimi', klasifikuesi i rregullave zgjedh pikën më të lartë të normalizuar midis të gjithë llojeve të të dhënave.
Për shkak të kompleksitetit të klasifikimit, përdorimi ekskluziv i heuristikës manuale çon në saktësi të ulët të klasifikimit, veçanërisht për të dhëna të pa strukturuara. Për këtë arsye, ne zhvilluam një sistem mësimi automatik për të punuar me klasifikimin e të dhënave të pa strukturuara, siç janë përmbajtja e përdoruesve dhe adresa. Mësimi automatik na lejoi të fillojmë të largohemi nga heuristika manuale dhe të aplikojmë sinjale shtesë të dhënash (për shembull, emrat e kolonave, origjina e të dhënave), duke rritur ndjeshëm saktësinë e zbulimit. Ne do të thellohemi në arkitekturën tonë të mësimit automatik më vonë.
Shërbimi i parashikimit ruan rezultatet për çdo kolonë së bashku me metadaten lidhur me kohën dhe gjendjen e skanimit. Çdo konsumator dhe procese të tjera që varen nga këto të dhëna, mund t'i lexojnë ato nga seti i të dhënave që publikohet çdo ditë. Ky set agregon rezultatet e të gjitha këtyre detyrave të skanimit, ose API-në e kohës reale të katalogut të të dhënave. Parashikimet e publikuara janë themeli i aplikimit automatik të politikës së privatësisë dhe sigurisë.
Në fund, pasi shërbimi i parashikimit regjistron të gjitha të dhënat dhe të gjitha parashikimet ruhen, API-ja jonë e katalogut të të dhënave mund të kthejë të gjitha parashikimet e llojeve të të dhënave për burimin në kohë reale. Çdo ditë, sistemi publikon një set të dhënash që përmban të gjitha parashikimet e fundit për çdo aktiv.
Të dhëna të pasigurt
Pavarësisht se procesi i përshkruar më sipër është krijuar për asetet e ruajtura, trafiku i papërshkruar gjithashtu konsiderohet një pjesë e të dhënave të organizatës dhe mund të jetë i rëndësishëm. Për këtë arsye, sistemi ofron një API në kohë reale për gjenerimin e parashikimeve të klasifikimit për çdo trafik të pasigurt. Sistemi i parashikimit në kohë reale përdoret gjerësisht për klasifikimin e trafikut të dalshëm, trafikut të hyrshëm në modelet e mësimit automatik dhe të dhënat e reklamuesve.
Kyçi i API pranon dy argumente kryesore: çelësi i grupit dhe të dhënat e papërpunuara që duhet të parashikohen. Shërbimi kryen të njëjtin nxjerrje objektesh siç është përshkruar më sipër dhe grupon objektet së bashku për të njëjtin çelës. Këto karakteristika gjithashtu mbështeten në memorjen e ruajtur për rikthim pas dështimit. Shërbimi garanton për çdo çelës grupimi se para thirrjes së shërbimit të parashikimit ka parë mjaft mostra përkatëse me procesin e përshkruar më lart.
Optimizimi
Për skanimin e disa depozita ne përdorim biblioteka dhe metoda optimizimi për leximin nga depozita e nxehtë [2] dhe garantojmë se nuk ka ndodhur ndonjë dështim nga përdoruesit e tjerë që po aksesojnë të njëjtën depozitë.
Për tabela jashtëzakonisht të mëdha (50+ petabajt), pavarësisht nga të gjitha optimizimet dhe efikasiteti i memories, sistemi punon për skanimin dhe llogaritjen e gjithçkaje para se të mbarojë memoria. Në fund, skanimi llogaritet plotësisht në memory dhe nuk ruhet për gjatë skanimit. Nëse tabelat e mëdha përmbajnë mijëra kolona me grumbuj të dhënash të pa strukturuara, detyra mund të dështojë për shkak të mungesës së resurseve të memories gjatë realizimit të parashikimeve për tërë tabelën. Kjo do të sjellë një zvogëlim të mbulimit. Për të luftuar këtë, ne e kemi optimizuar sistemin që të përdorë shpejtësinë e skanimit si një ndërmjetës për sa mirë e përballon sistemi ngarkesën aktuale. Ne përdorim shpejtësinë si një mekanizëm parashikues për të parë problemet me memorien dhe gjatë llogaritjes parashikuese të hartës së objekteve. Kështu, ne përdorim më pak të dhëna se zakonisht.
Sinjalet e të dhënave
Sistemi i klasifikimit është sa më i mirë sa sinjalet nga të dhënat. Këtu do të shqyrtojmë të gjitha sinjalet që përdoren nga sistemi i klasifikimit.
- Bazuar në përmbajtje: natyrisht, sinjali i parë dhe më i rëndësishëm është përmbajtja. Kryhet një mostër Bernoulli për çdo aset të dhënash, që ne e skanojmë dhe nxjerrim karakteristika lidhur me përmbajtjen e të dhënave. Shumica e karakteristikave vijnë nga përmbajtja. Mund të ketë çdo numër objektesh të lëvizshme që përfaqësojnë llogaritjet e numrit të herëve që është vërejtur një tip i caktuar i mostër. Për shembull, mund të kemi shenja të numrit të email-eve që janë parë në mostër, apo karakteristika të numrit të emotikonëve të vërejtur në mostër. Këto llogaritje të karakteristikave mund të normalizohen dhe aggregohen për skanime të ndryshme.
- Origjina e të dhënave: një sinjal i rëndësishëm që mund të ndihmojë kur përmbajtja ka ndryshuar nga tabela prind. Një shembull i zakonshëm janë të dhënat e heshura. Kur të dhënat në tabelën fëmijë heshur, ato shpesh vijnë nga tabela prind, ku mbeten të hapura. Të dhënat mbi origjinën ndihmojnë në klasifikimin e tipeve të caktuara të të dhënave, kur ato nuk lexohen qartë ose janë transformuar nga tabela lart në gjenezë.
- Annotationet: një tjetër sinjal me cilësi të lartë, që ndihmon në identifikimin e të dhënave jo-strukturuara. Në fakt, annotationet dhe të dhënat e origjinës mund të punojnë së bashku për të shpërndarë atribute midis aktiveve të ndryshme të të dhënave. Annotationet ndihmojnë në identifikimin e burimit të të dhënave jo-strukturuara, ndërkohë që të dhënat mbi origjinën mund të ndihmojnë në ndjekjen e rrjedhës së këtyre të dhënave në të gjithë depo.
- Injektimi i të dhënave është një metodë, ku qëllimisht futen simbole speciale, të padukshme në burime të njohura me lloje të njohura të të dhënave. Pastaj, çdo herë që ne skanojmë përmbajtjen me të njëjtin rend të padukshëm të simboleve, mund të konkludohet se përmbajtja e buron nga ky tip i njohur të dhënash. Ky është një sinjal tjetër cilësor i të dhënave, të ngjashëm me annotationet. Përveç kësaj, zbulimi mbi bazën e përmbajtjes ndihmon në zbulimin e të dhënave të dhëna.
Matja e metrikeve
Një komponent i rëndësishëm është metodologjia rigoroze e matjes së metrikeve. Metriket kryesore të iterimit për përmirësimin e klasifikimit janë saktësia dhe kujdesi i çdo etiketë, ndërsa vlerësimi F2 është më i rëndësishëm.
Për të llogaritur këto tregues, është e nevojshme një metodologji e pavarur për etiketimin e aktiveve të të dhënave, e cila nuk varet nga vetë sistemi, por mund të përdoret për krahasime të drejtpërdrejta me të. Më poshtë ne do të përshkruajmë se si e mbledhim të vërtetën bazë nga Facebook dhe e përdorim për të trajnuar sistemin tonë të klasifikimit.
Mbledhja e të dhënave të besueshme
Ne akumulojmë të dhëna të besueshme nga çdo burim të listuar më poshtë, në tabelën e tij përkatëse. Çdo tabelë përgjigjet për agregimin e vlerave të fundit të vëzhguara nga ky burim të veçantë. Çdo burim ka një kontroll të cilësisë së të dhënave për t'u siguruar që vlerat e vëzhguara për çdo burim janë të larta në cilësi dhe përfshijnë etiketat më të fundit të llojeve të të dhënave.
- Konfigurimet e platformës së logimit: fushat e caktuara në tabelat e koshit plotësohen me të dhëna që i përkasin një lloji të caktuar. Përdorimi dhe shpërndarja e këtyre të dhënave shërben si një burim i besueshëm i të dhënave të besueshme.
- Etiketimi me dorë: zhvilluesit që mbështesin sistemin dhe gjithashtu etiketuesit e jashtëm janë të trajnuar për të etiketuar kolonat. Kjo zakonisht funksionon mirë për të gjitha llojet e të dhënave në depo, dhe mund të jetë burimi kryesor i besueshmërisë për disa të dhëna jo-strkturuara, siç janë të dhënat e mesazheve ose përmbajtja e përdoruesve.
- Kolonat nga tabelat prind mund të etiketohen ose annotohen si përmbajnë të dhëna të caktuara, dhe ne mund t'i ndjekim këto të dhëna në tabelat nënka.
- Konsultimi i rrjedhave të ekzekutimit: rrjedhat e ekzekutimit në Facebook mbajnë të dhëna të një lloji të caktuar. Duke përdorur skanerin tonë si një arkitekturë shërbimi, ne mund të konsultojmë rrjedhat që kanë lloje të njohura të të dhënave dhe t’i dërgojmë ato përmes sistemit. Sistemi premton të mos ruajë këto të dhëna.
- Tabelat e konsultimit: tabelat e mëdha të koshit, të cilat janë të njohura për të përmbajtur të gjithë korpusin e të dhënave, gjithashtu mund të përdoren si të dhëna trajnuese dhe të dërgohen përmes skanerit si shërbim. Kjo është e shkëlqyer për tabelat me një gamë të plotë llojesh të dhënash, kështu që konsultimi i një colonne rastësisht është ekuivalente me konsultimin e të gjithë setit të këtij lloji të dhënash.
- Të dhënat sintetike: ne mund të përdorim edhe biblioteka që gjenerojnë të dhëna në kohë reale. Kjo funksionon mirë për lloje të thjeshta, publikohet të dhënash si adresa ose GPS.
- Menaxherët e të dhënave: programet e privatësisë shpesh përdorin menaxherë të të dhënave për të bashkangjitur manualisht politika për pjesët e të dhënave. Kjo shërben si një burim shumë i saktë besueshmërie.
Ne bashkojmë çdo burim kryesor të të dhënave të besueshme në një korp tjetër me të gjitha këto të dhëna. Problemi më i madh me besueshmërinë është të sigurohemi se ajo është përfaqësuese e depozitës së të dhënave. Përndryshe, motorët e klasifikimit mund të stërviten më shumë. Në luftën me këtë, të gjithë burimet e mësipërme përdoren për të siguruar një ekuilibër gjatë trajnimit të modeleve ose llogaritjes së matjeve. Për më tepër, njerëzit etiketues përzgjidhen në mënyrë të barabartë nga kolona të ndryshme në depozitë dhe etiketojnë përkatësisht të dhënat, në mënyrë që mbledhja e vlerave të besueshme të mbetet e paanshme.
Integrimi i vazhdueshëm
Për të siguruar iterim të shpejtë dhe përmirësim, është e rëndësishme të matet gjithmonë performanca e sistemit në kohë reale. Ne mund të masim çdo përmirësim të klasifikimit në krahasim me sistemin e sotëm, në mënyrë që taktikisht të orientojmë të dhënat në përmirësimet e ardhshme. Këtu do të shqyrtojmë se si sistemi përfundon ciklin e feedback-ut, i cili mundësohet nga të dhënat e besueshme.
Kur sistemi i planifikimit përballet me një aktiv që ka një etiketë nga një burim të besueshëm, ne planifikojmë dy detyra. E para përdor skanerin tonë prodhues dhe, kështu, kapacitetet tona prodhuese. Detyra e dytë përdor skanerin e versionit më të fundit me tiparet më të fundit. Çdo detyrë shkruan rezultatin e saj në tabelën përkatëse, duke treguar versionet me rezultatet e klasifikimit.
Kështu, ne krahasojmë rezultatet e klasifikimit të kandidatëve të lëshimit dhe modelit prodhues në kohë reale.
Ndërsa grupet e të dhënave krahasojnë cilësitë RC dhe PROD, regjistrohen shumë variante të motorit të klasifikimit të shërbimit të parashikimit ML. Modeli më i fundit i ndërtuar i mësimit të makinerive, modeli aktual në prodhim dhe çdo model eksperimental. Të njëjtin qasje na lejon "ta ndajmë" versionet e ndryshme të modelit (agnostikë të klasifikuesve tanë të rregullave) dhe të krahasojmë metrikat në kohë reale. Është shumë e lehtë të përcaktohet kur eksperimenti me ML është gati për t'u integruar në prodhim.
Çdo natë, karakteristikat RC, të llogaritura për atë ditë, dërgohen në tubin mësimor të ML, ku modeli trajnohet me karakteristikat më të fundit RC dhe vlerëson performancën e tij në krahasim me një grup të dhënash të besueshëm.
Çdo mëngjes, modeli përfundon trajnimet dhe publikohet automatikisht si eksperimental. Ai automatikisht përfshihet në listën e eksperimentaleve.
Disa rezultate
Diku më shumë se 100 lloje të ndryshme të të dhënave etiketohen me saktësi të lartë. Llojet e strukturuara mirë, si email-et dhe numrat e telefonit, klasifikohen me vlerësim f2 më shumë se 0.95. Llojet e lirshme të të dhënave, si përmbajtja e përdoruesit dhe emrat, gjithashtu funksionojnë shumë mirë, me pikë f2 më shumë se 0.85.
Çdo ditë, një numër i madh kolonash të dhënash të qëndrueshme dhe të paqëndrueshme klasifikohen në të gjitha depozitë. Më shumë se 500 terabajt skanohen çdo ditë në më shumë se 10 depozita të dhënash. Mbulimi i shumicës së këtyre depozitave është më shumë se 98%.
Me kalimin e kohës, klasifikimi është bërë shumë efikas, pasi detyrat e klasifikimit në rrjedhën autonome të ruajtur zgjasin mesatarisht 35 sekonda nga skanimi i aktivës deri në llogaritjen e parashikimeve për secilën kolonë.
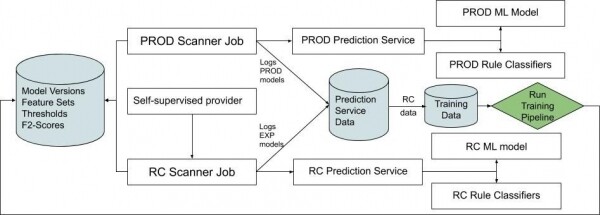
Fig. 2. Një diagram që përshkruan rrjedhën e vazhdueshme të integrimit, për të kuptuar si objektet RC gjenerohen dhe dërgohen në model.
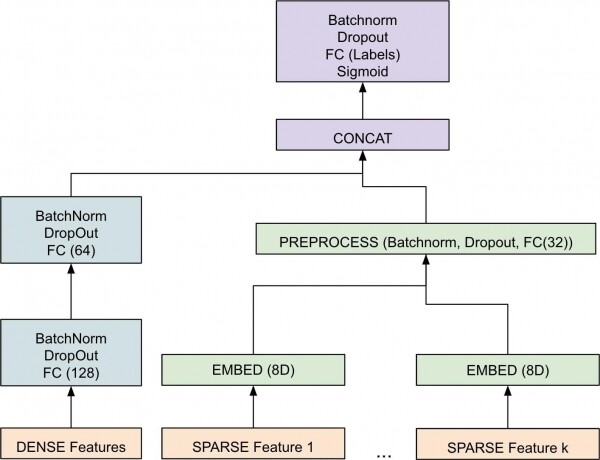
Figura 3. Një diagram i nivelit të lartë të komponentit të mësimit të makinerive.
Komponenti i sistemit të mësimit të makinerive
Në kapitullin e mëparshëm, ne thellësisht hulumtuam arkitekturën e gjithë sistemit, duke theksuar shkallën, optimizimin dhe rrjedhat e të dhënave në modalitetin autonom dhe online. Në këtë kapitull, ne do të shqyrtojmë shërbimin e parashikimit dhe do të përshkruajmë sistemin e mësimit të makinerive që siguron funksionimin e shërbimit të parashikimit.
Me më shumë se 100 lloje të dhënash dhe disa përmbajtje jo-strukturore, siç janë të dhënat e mesazheve dhe përmbajtja e përdoruesit, përdorimi ekskluziv i heurisë manuale rezulton në saktësi klasifikimi nënparimetrike, veçanërisht për të dhënat jo-strukturore. Për këtë arsye, ne gjithashtu kemi zhvilluar një sistem të mësimit automat për të trajtuar kompleksitetet e të dhënave jo-strukturore. Përdorimi i mësimit automat lejon të fillojmë të largohemi nga heuristika manuale dhe të punojmë me karakteristikat dhe sinjalet shtesë të dhënash (p.sh., emrat e kolonave, origjina e të dhënave) për të rritur saktësinë.
Modeli i realizuar mëson përfaqësimet vektoriale [3] mbi objekte të dendura dhe të holluara veçmas. Pas kësaj, ato bashkohen për të formuar një vektor që kalon nëpër një seri fazash normalizimi të grupit [4] dhe jo-lineariteti për të arritur rezultatin përfundimtar. Rezultati përfundimtar është një numër me pikë të lundrueshme midis [0-1] për çdo etiketë, që tregon probabilitetin që shembulli i përket një lloji të caktuar ndjeshmërie. Përdorimi i PyTorch për modelin na lejoi të lëviznim më shpejt, duke u ofruar zhvilluesve jashtë ekipit mundësinë për të bërë dhe testuar shpejt ndryshime.
Gjatë projektimit të arkitekturës, ishte e rëndësishme të modeloheshin objektet e holluara (p.sh., tekstuale) dhe ato të dendura (p.sh., numerike) veçmas për shkak të dallimeve të brendshme. Për arkitekturën përfundimtare, ishte gjithashtu e rëndësishme të realizohej zbërthimi i parametrave për të gjetur vlerën optimale të normës së të mësuarit, madhësisë së grupit dhe parametrave të tjerë hipermetricë. Zgjedhja e optimizuesit gjithashtu ishte një parametr hipermetrik i rëndësishëm. Ne zbuluam se optimizuesi i njohur Adamshpesh çon në mbifitim, ndryshe nga modeli me SGD më të qëndrueshme. Kishte aspekte të tjera që ne duhej t’i përfshimë direkt në model. Për shembull, rregulla statike që garantonin se modeli bënte një parashikim deterministik kur një karakteristikë kishte një vlerë të caktuar. Këto rregulla statike janë të definuara nga klientët tanë. Ne zbuluam se përfshirja e tyre direkt në model çoi në krijimin e një arkitekture më të vetë-pavarur dhe të besueshme, në vend të implementimit të një faze postprocesimi për të trajtuar këto raste speciale të kufizuara. Po ashtu, vëreni se gjatë stërvitjes këto rregulla janë çaktivizuar për të mos e penguar procesin e stërvitjes së rënies gradienti.
Problemet
Një nga problemet ishte mbledhja e të dhënave të besueshme me cilësi të lartë. Modeli ka nevojë për besueshmëri për çdo kategori, në mënyrë që të mund të studiojë asociacionet midis objekteve dhe etiketave. Në seksionin e mëparshëm kemi diskutuar metodat e mbledhjes së të dhënave si për matjen e sistemit ashtu edhe për stërvitjen e modeleve. Analiza tregoi se klasa të tilla të dhënash si numrat e kartave të kreditit dhe numrat e llogarive bankare nuk janë shumë të përhapura në ruajtjen tonë. Kjo e vështirëson mbledhjen e volumeve të mëdha të të dhënave të besueshme për stërvitjen e modeleve. Për të zgjidhur këtë problem, zhvilluam procese për të krijuar të dhëna sintetike të besueshme për këto klasa. Ne krijojmë të dhëna të tilla për tipe të ndjeshme, duke përfshirë SSN, numrat e kartave të kreditit dhe IBAN-numrat për të cilët modeli nuk mund të parashikonte më parë. Ky qasje lejon trajtimin e tipeve të dhënash konfidenciale pa rrezikun e privatesisë, i lidhur me fshehjen e të dhënave reale konfidenciale.
Përveç problemeve të të dhënave të besueshme, ka probleme të hapura arkitekturore mbi të cilat ne po punojmë, të tilla si izolimi i ndryshimeve dhe ndalimi i hershëm. Izolimi i ndryshimeve është i rëndësishëm për të siguruar që, kur bëhen ndryshime të ndryshme në pjesë të ndryshme të rrjetit, ndikimi të jetë i izoluara në kategori specifike dhe të mos ketë një ndikim të gjerë në performancën e përgjithshme të parashikimit. Përmirësimi i kritereve për ndalimin e hershëm gjithashtu ka rëndësi jetike për ne që të mund të ndalojmë procesin e stërvitjes në një pikë të qëndrueshme për të gjitha kategoritë, jo në atë pikë ku disa kategori janë mbiparashikuar dhe të tjera jo.
Rëndësia e veçorisë
Kur një veçori e re përfshihet në model, ne duam të dimë ndikimin e saj të përgjithshëm mbi modelin. Gjithashtu, ne duam të sigurohemi që parashikimet të jenë interpretuese nga njerëzit, në mënyrë që të kuptohet plotësisht se cilat veçori përdoren për çdo tip të dhënash. Për këtë, ne kemi zhvilluar dhe futur për klasat rëndësinë e veçorive për modelin PyTorch. Vlen të theksohet se kjo është ndryshe nga rëndësia e përgjithshme e veçorisë, e cila zakonisht mbështetet, sepse nuk na tregon se cilat veçori janë të rëndësishme për një klasë të caktuar. Ne e matim rëndësinë e objektit duke llogaritur rritjen e gabimit të parashikimit pas përzierjes së objektit. Një veçori është "e rëndësishme" kur përzierja e vlerave rrit gabimin e modelit, sepse në këtë rast modeli u mbështet në veçorinë në parashikimin. Një veçori është "e parëndësishme" kur përzierja e vlerave të saj lë gabimin e modelit të pandryshuar, sepse në këtë rast modeli e injoroi atë [5].
Rëndësia e veçorisë për secilën klasë e bën modelin interpretuese, në mënyrë që ne të mund të shohim në çfarë vëmendjeje i kushton modeli gjatë parashikimit të etiketës. Për shembull, kur analizojmë ADDR, ne sigurohemi që veçoria e lidhur me adresën, siç është CountLinesAddress, zë një vend të lartë në tabelën e rëndësisë së veçorive për secilën klasë, në mënyrë që intuicioni ynë njerëzor të përputhet mirë me atë që ka mësuar modeli.
Vlerësimi
Është e rëndësishme të përcaktohet një metrikë e vetme suksesi. Ne zgjodhëm F2 - një balancë midis rikthimit dhe saktësisë (me një shpërbërje të vogël të rikthimit). Rikthimi është më i rëndësishëm për rastin e përdorimit të privatësisë sesa saktësia, sepse për ekipin është jashtëzakonisht e rëndësishme të mos humbasë asnjë të dhënë të ndjeshme (duke siguruar gjithashtu një saktësi të arsyeshme). Të dhënat reale të vlerësimit të performancës F2 të modelit tonë kalojnë përtej këtij artikulli. Megjithatë, me një optimizim të kujdesshëm, ne mund të arrijmë një pikë të lartë (0,9+) F2 për klasat më të ndjeshme.
Puna e lidhur
Ka there shumë algoritme për klasifikimin automatik të dokumenteve të pa strukturuara duke përdorur metoda të ndryshme, si përputhja e modele, kërkimi i ngjashmërive të dokumenteve dhe metoda të ndryshme të mësimit të makinerisë (bayesiane, pemët e vendimeve, fqinjët më të afërt dhe shumë të tjera) [6]. Çdo njëra prej tyre mund të përdoret si pjesë e klasifikimit. Megjithatë, problemi është në shkallëzueshmëri. Qasja për klasifikimin në këtë artikull është orientuar drejt fleksibilitetit dhe performancës. Kjo na lejon të mbështesim klasat e reja në të ardhmen dhe të mbajmë një vonesë të ulët.
Ekziston gjithashtu një sasi e madhe punimesh për marrjen e gjurmëve nga të dhënat. Për shembull, autorët në [7] përshkruan një zgjidhje që përqendrohet në problemin e kapjes së rrjedhjeve të të dhënave të ndjeshme. Supozimi kryesor është mundësia e gjurmës nga të dhënat, për ta përputhur atë me një grup të njohur të dhënash të ndjeshme. Autorët në [8] përshkruajnë një problem të ngjashëm të rrjedhjes së privatësisë, por zgjidhja e tyre bazohet në një arkitekturë specifike Android dhe klasifikohet vetëm kur veprimet e përdoruesit rezultojnë në dërgimin e informacionit personal ose nëse ka një rrjedhje të të dhënave të përdoruesve në aplikacionin bazë. Situata këtu është disa herë e ndryshme, pasi të dhënat e përdoruesve gjithashtu mund të jenë shumë të pa strukturuara. Prandaj, na nevojitet një teknikë më komplekse sesa marrja e gjurmëve.
Në fund, për të përballuar mungesën e të dhënave për disa lloje të të dhënave të ndjeshme, ne e kemi futur përdorimin e të dhënave sintetike. Ekziston një volum i madh literaturë mbi augmentimin e të dhënave, për shembull, autorët në [9] kanë studiuar rolin e injeksionit të zhurmës gjatë mësimit dhe kanë vërejtur rezultate pozitive në mësimin e kontrolluar. Qasja jonë ndaj privatësisë është e ndryshme, sepse introduktimi i të dhënave të zhurmuara mund të jetë kontraproduktive, dhe në vend të kësaj përqendrohemi në të dhëna sintetike me cilësi të lartë.
Përfundim
Në këtë artikull paraqesim një sistem që mund të klasifikojë fragmentet e të dhënave. Kjo na lejon të krijojmë sisteme për të siguruar ndjekjen e politikave të privatësisë dhe sigurisë. Ne treguam se infrastruktura e shkallëzueshme, integrimi i vazhdueshëm, mësimi përmes makinerive dhe të dhënat e besueshmërisë së larte luajnë një rol kyç në suksesin e shumë iniciativave tona në fushën e privatësisë.
Ka shumë drejtime për punën e ardhshme. Ajo mund të përfshijë sigurimin e mbështetjes për të dhëna të papërcaktuara (skedarë), klasifikimin jo vetëm të llojit të të dhënave, por edhe të nivelit të ndjeshmërisë, si dhe përdorimin e mësimit të vetëk kontrolluar gjatë trajnimit përmes gjenerimit të shembujve sintetikë të saktë. Këta, nga ana e tyre, do të ndihmojnë modelin të ulë humbjet në maksimum. Puna e ardhshme mund të përqendrohet gjithashtu në procesin e hetimit, ku ne dalim përtej zbulimit dhe ofrojmë analizë të shkakut të ndryshimeve të ndryshme të privatësisë. Kjo do të ndihmojë në raste të tilla si analiza e ndjeshmërisë (dmth, a është ndjeshmëria e privatësisë e llojit të të dhënave e lartë (p.sh. IP e përdoruesit) apo e ulët (p.sh. IP e brendshme e Facebook).
Bibliografia
- David Ben-David, Tamar Domany, dhe Abigail Tarem. Klasifikimi i të dhënave të ndërmarrjeve duke përdorur teknologjitë e rrjetit semantik. Në Peter F.İ Patel-Schneider, Yue Pan, Pascal Hitzler, Peter Mika, Lei Zhang, Jeff Z. Pan, Ian Horrocks, dhe Birte Glimm, redaktorë, Rrjeti Semantik – ISWC 2010, fq. 66–81, Berlin, Heidelberg, 2010. Springer Berlin Heidelberg.
- Subramanian Muralidhar, Wyatt Lloyd, Sabyasachi Roy, Cory Hill, Ernest Lin, Weiwen Liu, Satadru Pan, Shiva Shankar, Viswanath Sivakumar, Linpeng Tang, dhe Sanjeev Kumar. f4: Sistemi i ngrohjes BLOB të Facebook. Në Simpoziumi i 11-të USENIX mbi Dizajnin dhe Zbatimin e Sistemeve Operative (OSDI 14), fq. 383–398, Broomfield, CO, tetor 2014. Asociata USENIX.
- Tomas Mikolov, Ilya Sutskever, Kai Chen, Greg S Corrado, dhe Jeff Dean. Pëfaqësime të shpërndara të fjalëve dhe frazave dhe kompozicionaliteti i tyre. Në C. J. C. Burges, L. Bottou, M. Welling, Z. Ghahramani, dhe K. Q. Weinberger, redaktorë, Përmirësimet në Sistemet e Informacionit Neural 26, fq. 3111–3119. Curran Associates, Inc., 2013.
- Sergey Ioffe dhe Christian Szegedy. Normalizimi i grupeve: Shtyrja përpara e trajnimit të rrjeteve të thella duke reduktuar zhvendosjen e brendshme të variablit. Në Francis Bach dhe David Blei, redaktorë, Aktet e Konferencës Ndërkombëtare të Mësimit të Makinerisë të 32-të, vëllimi 37 i Aktet e Kërkimit të Mësimit të Makinerisë, fq. 448–456, Lille, Francë, 07–09 Korrik 2015. PMLR.
- Leo Breiman. Pyjet Rastësore. Mës. Mës., 45(1):5–32, tetor 2001.
- Thair Nu Phyu. Anketa e teknikave të klasifikimit në minierat e të dhënave.
- X. Shu, D. Yao, dhe E. Bertino. Zbulimi i mbrojtur i ekspozitës së të dhënave të ndjeshme. Transaksionet IEEE mbi Forensicën e Informacionit dhe Sigurinë, 10(5):1092–1103, 2015.
- Zhemin Yang, Min Yang, Yuan Zhang, Guofei Gu, Peng Ning, dhe Xiaoyang Wang. Appintent: Analizimi i transmetimit të të dhënave të ndjeshme në android për zbulimin e rrjedhjes së privatësisë. faqet 1043–1054, 11 2013.
- Qizhe Xie, Zihang Dai, Eduard H. Hovy, Minh-Thang Luong, dhe Quoc V. Le. Rritja e të dhënave të pa mbikëqyrura.
Merrni detaje se si të fitoni një profesion të kërkuar nga fillimi ose të përmirësoni aftësitë dhe pagën tuaj duke kaluar nëpër kurset online SkillFactory:
- (12 muaj)
- (12 javë)
- (20 javë)
- (20 javë)
Kurse të tjera
- (9 muaj)
- (8 muaj)
- (9 muaj)
- (12 muaj)
- (18 muaj)
- (12 muaj)
- (9 muaj)
- (7 muaj)
Burimi: habr.com
