

Në raport përshkruhen disa qasje që lejojnë të monitoroni performancën e kërkesave SQL kur ato janë miliona në ditë, ndërsa serverët e kontrolluar PostgreSQL — qindra.
Cilat zgjidhje teknike na lejojnë të përpunojmë në mënyrë efikase një volum të tillë informacioni, dhe si e lehtëson kjo jetën e zhvilluesve të zakonshëm.
Kush është i interesuar për analizimin e problemeve specifike dhe teknikat e ndryshme të optimizimit të kërkesave SQL dhe zgjidhjet e problemeve tipike të DBA-ve në PostgreSQL — gjithashtu mund të në lidhje me këtë temë.
Unë quhem Kirill Borovikov, përfaqësoj . Konkretisht, unë specializohem në punën me bazat e të dhënave në kompaninë tonë.
Sot do t'ju tregoj se si merremi me optimizimin e kërkesave, kur ju duhet të zgjidhni një problem masiv, dhe jo të "shkoni thellë" në performancën e një kërkese të vetme. Kur ka miliona kërkesa, dhe ju duhet të gjeni disa qasje në zgjidhjen e këtij problemi të madh.
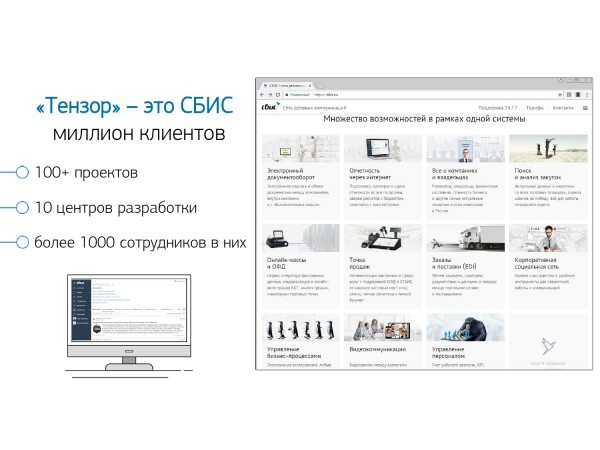
Në përgjithësi, "Tensor" për një milion klientët tanë është : rrjeti social korporativ, zgjidhjet për videokonferenca, për qarkullimin e dokumenteve të brendshme dhe të jashtme, sistemet e kontabilitetit dhe magazinës,… Pra, një "megakompleks" për menaxhimin e integruar të biznesit, ku ka më shumë se 100 projekte të brendshme të ndryshme.
Që të gjitha ato të funksionojnë dhe zhvillohen normalisht — kemi 10 qendra zhvillimi në të gjithë vendin, me më shumë se 1000 zhvillues.
Ne punojmë me PostgreSQL qysh nga viti 2008 dhe kemi akumuluar një volum të madh të informacionit që përpunojmë — të dhënat e klientëve, statistikat, analizat, të dhënat nga sistemet e jashtme informative — më shumë se 400TB. Vetëm në "prodhim" kemi rreth 250 servera, ndërsa gjithsej për serverat e DB që monitorojmë — rreth 1000.
SQL është një gjuhë deklarative. Ju e përshkruani jo "si" duhet të funksionojë diçka, por "çfarë" dëshironi të merrni. SGBD-ja e di më mirë se si të bëjë JOIN — si të bashkojë tabelat tuaja, çfarë kushteve të aplikoni, çfarë do të shkojë sipas indeksit, çfarë jo…
Disa SGBD pranojnë sugjerime: "Jo, bashkë ato dy tabela në këtë rend", por PostgreSQL nuk e bën kështu. Kjo është një pozita e vetëdijshme e zhvilluesve kryesorë: "Më mirë do ta përmirësojmë optimizuesin e kërkesës sesa të lejojmë zhvilluesit të përdorin disa hint."
Megjithatë, pavarësisht se PostgreSQL nuk lejon që të menaxhohet "nga jashtë", ai ofron mundësinë për të shihni se çfarë ndodhet "brenda", kur ju ekzekutoni kërkesën tuaj, dhe ku hasen problemet.
Në përgjithësi, me cilat probleme klasike vjen zhvilluesi [tek DBA] zakonisht? "Ja, ne kemi ekzekutuar kërkesën, dhe gjithçka është ngadalë, gjithçka ngec, diçka ndodh... Është një bështjtje!"
Shkaktarët zakonisht janë të njëjtë:
- algoritmi joefikas i kërkesës
Zhvilluesi: "Aktualisht kam 10 tabela në SQL të bashkuara me JOIN..." - dhe pret që kushtet e tij të shndërrohen mrekullishëm në mënyrë efikase, dhe ai të marrë gjithçka shpejt. Por mrekulli nuk ndodhin, dhe çdo sistem në këtë variabilitet (10 tabela në një FROM) gjithmonë jep një saktësi të caktuar. [] - statistika joaktuale
Ky moment është shumë i rëndësishëm për PostgreSQL, kur ju keni "derdhur" një dataset të madh në server, bëni një kërkesë - dhe ai "bënë sekscan" në tabelë. Sepse dje kishte 10 regjistrime, ndërsa sot 10 milion, por PostgreSQL ende nuk është në dijeni, dhe duhet ta informoni për këtë. [] - "bllokim" në burime
Keni instaluar një bazë të madhe dhe të ngarkuar në një server të dobët, me mungesë disku, memorie dhe performancë të procesorit. Dhe gjithçka... Diku ka një kufi performancë, më lart se sa nuk mund të shkoni më. - e bllokimeve
Një moment i komplikuar, por ato janë më të rëndësishme për kërkesat që modifikojnë (INSERT, UPDATE, DELETE) - kjo është një temë e madhe e veçantë.
Marrja e planit
... Dhe për gjithçka tjetër na nevojitet një plan! Na nevojitet të shohim se çfarë ndodh brenda serverit.
Plani i ekzekutimit të kërkesës për PostgreSQL është një pemë algoritmi e ekzekutimit të kërkesës në paraqitje tekstuale. Ky është algoritmi që pas analizës nga planifikuesi është konsideruar si më efikas.
Çdo nyje e pemës është një operacion: nxjerrja e të dhënave nga tabela ose indeksi, ndërtimi i një harta bitore, bashkimi i dy tabelave, bashkimi, kryqëzimi ose përjashtimi i mostrave. Ekzekutimi i kërkesës është kalimi nëpër nyjet e kësaj peme.
Për të marrë planin e kërkesës, mënyra më e thjeshtë është të ekzekutoni operatorin EXPLAIN. Për të marrë me të gjitha atributet reale, pra në të vërtetë të ekzekutoni kërkesën mbi bazën - EXPLAIN (ANALYZE, BUFFERS) SELECT ....
Moment i keq: kur e kryeni atë, ndodh "këtu dhe tani", prandaj është i përshtatshëm vetëm për debugim lokal. Nëse merrni ndonjë server me ngarkesë të lartë, që është nën një fluks të fortë të ndryshimeve të të dhënave, dhe shihni: "Ah! Këtu kemi një kërkesë të ngadaltë"ndodh kërkesa." Një gjysmë ore, një orë më parë - ndërsa ju ishit duke e nxjerrë këtë kërkesë nga logjet, duke e sjellë përsëri në server, të gjithë dataset-i juaj dhe statistikat kishin ndryshuar. E kryeni atë për të debuguar - dhe ajo ekzekutohet shpejt! Dhe nuk mund ta kuptoni "pse", pse ka qenë ngadalë.
Për të kuptuar se çfarë ndodhi pikërisht në momentin kur kërkesa ekzekutohet në server, njerëzit e mençur shkruan . Ai është prezent pothuajse në të gjitha shpërndarjet më të njohura të PostgreSQL, dhe mund të aktivizohet thjesht në skedarin e konfigurimit.
Nëse ai kupton se ndonjë kërkesë po ekzekutohet më gjatë se kufiri që i keni thënë, bën "një snapshot" të planit të kësaj kërkese dhe i shkruan ato së bashku në log.
Duket gjithçka tani mirë, shkojmë në log dhe shohim aty... [portjanka tekst]. Por nuk mund të themi asgjë për të, përveç faktit se është një plan i shkëlqyer, sepse u ekzekutua për 11 ms.
Duket gjithçka mirë - por nuk kuptojmë asgjë, çfarë ndodhi në të vërtetë. Përveç kohës totale, në veçanti asgjë nuk shohim. Sepse të shikosh një "latuh" plain text është krejtësisht e paqartë.
Por madje, le të jetë e paqartë, le të jetë e papërshtatshme, por ekzistojnë probleme më thelbësore:
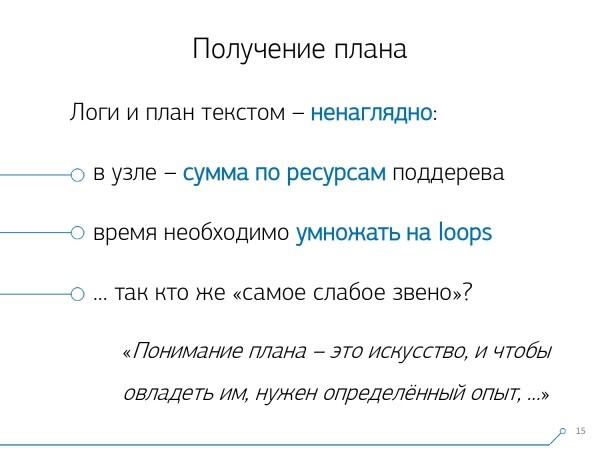
- Në nyje tregohet shuma e burimeve të të gjitha nënpjesëve nën të. Kështu që thjesht të dini se sa kohë është shpenzuar këtu konkretisht në këtë Index Scan - nuk është e mundur, nëse nën të ka ndonjë kusht të brendshëm. Duhet të shikojmë dinamikisht, nëse nuk ka "fëmijë" brenda dhe variabla kushtore, CTE - dhe ta heqim këtë gjithçka "në mendje".
- Çështja e dytë: koha e cila është e shënuar në nyjë, është koha e ekzekutimit të vetëm një herë të nyjes. Nëse kjo nyje ekzekutohej si rezultat, për shembull, i një cikli për regjistrimet e tabelës, disa herë, atëherë në plan rritet numri i loops - cikleve të kësaj nyje. Por vetë koha e ekzekutimit atomik mbetet në plan të njëjtë. Pra, për të kuptuar sa herë është ekzekutuar kjo nyje në total, duhet ta shumëzojmë një gjë me një tjetër - përsëri "në mendje".
Në këto kushte, të kuptosh "Kush është lidhja më e dobët?" praktikisht është e pamundur. Prandaj, edhe vetë zhvilluesit në "manual" shkruajnë se "Kuptimi i planit është një art që duhet mësuar, përvojë...".
Por ne kemi 1000 zhvillues, dhe këtë përvojë nuk mund t'ia kalosh secilit. Unë, ti, ai — e dinë, por ndonjë që është andej — ndoshta nuk e di. Ndoshta do të mësojë, ndoshta jo, por duhet të punojë tani — nga t'ia marrë këtë përvojë.
Vizualizimi i planit
Prandaj, ne kuptuam — për të kuptuar këto probleme, na duhet një vizualizim i mirë i planit.
Ne filluam "në treg" — le të kërkojmë në internet për atë që ekziston.
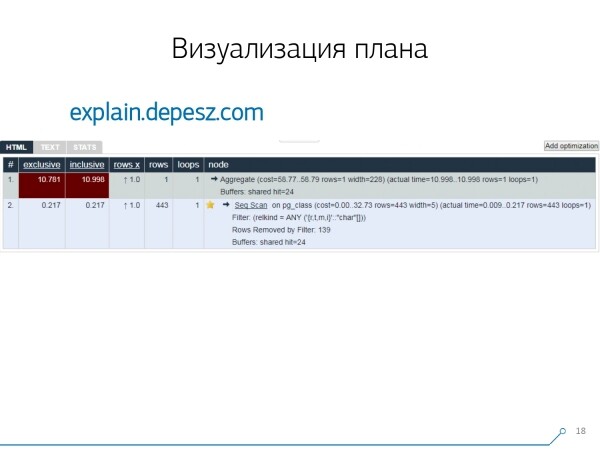
Por, doli se lidhur me zgjidhjet "e gjalla", që janë disi në zhvillim, ka shumë pak — praktikisht, një: nga Hubert Lubaczewski. Në hyrje, në fushën "ngasmë" tekstin e prezentimit të planit, ai të tregon një tabelë me të dhënat e analizuar:
- koha personale e punës së nyjës
- koha totale për tërë nëngrupin
- numri i regjistrimeve që janë nxjerrë dhe që ishin statistiksht të pritura
- trupi i nyjës
Po ashtu, ky shërbim ka mundësinë për të ndarë arkivën e lidhjeve. E hedh atje planin tënd dhe thua: "Hey, Vasia, këtu është lidhja, diçka nuk shkon."
Por ka edhe disa probleme të vogla.
Së pari, një numër i madh i "kopipastës". Merr një copë logu, e fut atje, dhe përsëri e përsërit.
Së dyti, nuk ka analizë të numrit të të dhënave të lexuara - ato buffers që del EXPLAIN (ANALYZE, BUFFERS), këtu nuk e shohim. Ai thjesht nuk di si t'i analizojë, kuptojë dhe të punojë me to. Kur lexoni shumë të dhëna dhe kuptoni se mund të mos me rregulloni saktë në disk dhe cache në memorie, kjo informacion është shumë e rëndësishme.
Momenti i tretë negativ - zhvillimi shumë i dobët i këtij projekti. Komitetet janë shumë të vogla, mirë është nëse herë në gjashtë muaj, dhe kodi në Perl.
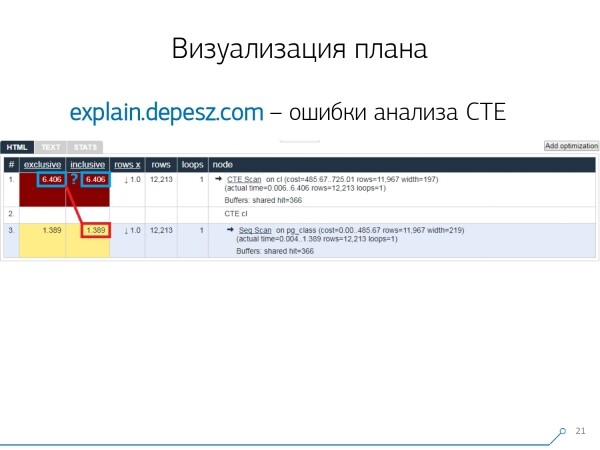
Por gjithçka është "lirike", mund të jetojë ndonjë si kjo, por ka një gjë që na ka larguar shumë nga ky shërbim. Këto janë gabimet e analizës së Common Table Expression (CTE) dhe nyjeve të ndryshme dinamikë si InitPlan/SubPlan.
Nëse besojmë se kjo figurë, atëherë koha totale e ekzekutimit të çdo nyjeje të veçantë është më e madhe se koha totale e ekzekutimit të tërë kërkesës. E thjeshtë — nga nyja CTE Scan nuk u zgjidh koha e gjenerimit të kësaj CTEPrandaj tani nuk e dimë më përgjigjen e saktë, sa ka zgjatur skanimi i CTE vetë.
Këtu kuptuam se ishte koha të shkruanim tonën — urra-urra! Çdo zhvillues thotë: «Tani do shkruajmë tonën, do jetë super e thjeshtë!»
Morrëm një grumbull tipik për shërbimet web: bërthama në Node.js + Express, përdorëm Bootstrap dhe për diagramet e bukura — D3.js. Dhe pritjet tona ishin plotësisht të justifikuara — prototipi i parë e morëm për 2 javë:
- parserin tonë të planit
Do të thotë tani ne mund të analizojmë çdo plan që gjeneron PostgreSQL. - analizën e saktë të nodëve dinamikë — CTE Scan, InitPlan, SubPlan
- analizën e shpërndarjes së buffers — ku faqet e të dhënave lexohen nga memoria, ku nga cache lokal, ku nga disku
- pothuajse e kemi bërë vizuale
Që të mos "gërmojmë" në log, por të shohim "gjendjen më të dobët" menjëherë në pamje.
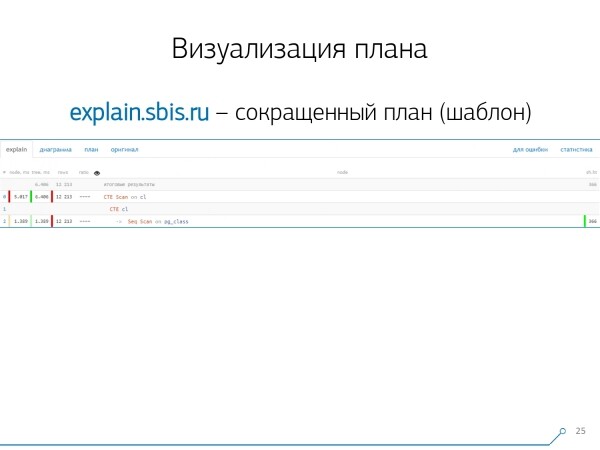
Kemi marrë diçka si kjo — menjëherë me ndriçimin e sintaksës. Por zakonisht zhvilluesit tanë nuk punojnë më me një paraqitje të plotë të planit, por me atë që është më e shkurtër. Sepse të gjitha numrat i kemi analizuar dhe i kemi hedhur majtas-djathtas, ndërsa në mes kemi lënë vetëm rreshtin e parë, çfarë është ky nod: CTE Scan, gjenerimi i CTE ose Seq Scan për ndonjë tabelë.
Këtë paraqitje të shkurtuar e quajmë shablloni i planit.
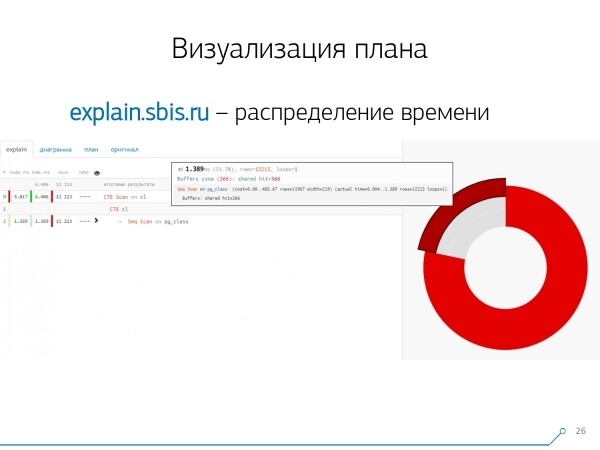
Çfarë do të ishte e dobishme? Do të ishte e dobishme të shihnim se çfarë peshe ka çdo nod në kohën totale që kemi shpenzuar — dhe thjesht "e ngjitëm" përkrah diagramin e tortës.
I japim listës dhe shohim — në fakt, Seq Scan nga gjithë koha, zuri më pak se një të katërtën, ndërsa 3/4 të tjera i zë CTE Scan. Horrible! Ky është një vërejtje e vogël për "shpejtësinë" e CTE Scan, nëse i përdorni aktivisht në kërkesat tuaja. Ato nuk janë shumë të shpejta — ato humbin madje përballë skanimit normal të tabelave.
Por zakonisht këto diagrame janë më interesante dhe më të komplikuara, kur ne menjëherë shohim një segment dhe shohim, për shembull, që më shumë se gjysma e kohës së gjithë ndonjë Seq Scan është "hamë". Dhe brenda ka pasur ndonjë Filter, shumë të dhëna janë hequr për të... Mund ta dërgojmë këtë imazhin direkt tek zhvilluesi dhe të themi: "Vasja, këtu çdo gjë është keq! Merru me këtë, shiko — diçka nuk është në rregull!"
Natyrisht, pa "gabime" nuk u shmangëm.
Gjëja e parë që hasëm ishte problemi i përkryerjes. Koha e nodit për çdo element në plan shënohet me precizion deri në 1μs. Dhe kur numri i cikleve të nodit kalon, për shembull, 1000 — pas përfundimit PostgreSQL e ndan "me precizion deri në", kështu që gjatë llogaritjes së anasjellë ne marrim kohën totale "dikush midis 0.95ms dhe 1.05ms". Kur numri është në mikrosekonda — nuk është faji, por kur arrin në [mili]sekonda — përfshihet që, gjatë "çlirimit" të burimeve sipas nodit të planit "kush sa konsumoi" duhet ta marrim parasysh këtë informacion.
Momenti i dytë, më i komplikuar, është shpërndarja e burimeve (ato buffers) në nodet dinamike. Kjo na kushtoi, në dy javët e para për prototipin, edhe katër javë të tjera.
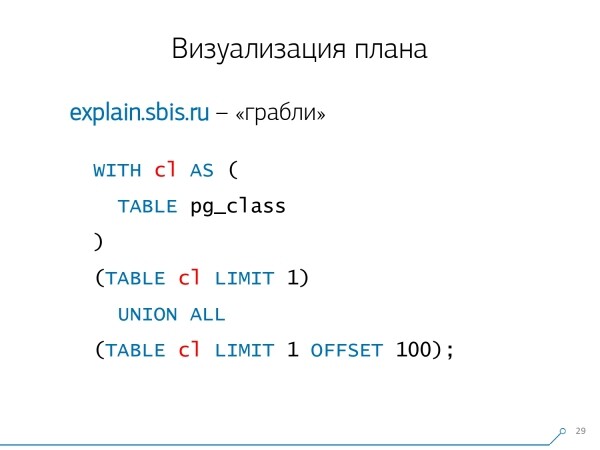
Të krijosh një problem të tillë është mjaft e lehtë — bëjmë CTE dhe aty lexojmë diçka supozuese. Në të vërtetë, PostgreSQL është "i mençur" dhe nuk do të lexojë asgjë atje direkt. Më pas marrim regjistrimin e parë nga ajo, dhe për të — të njëqindat e parë nga e njëjta CTE.
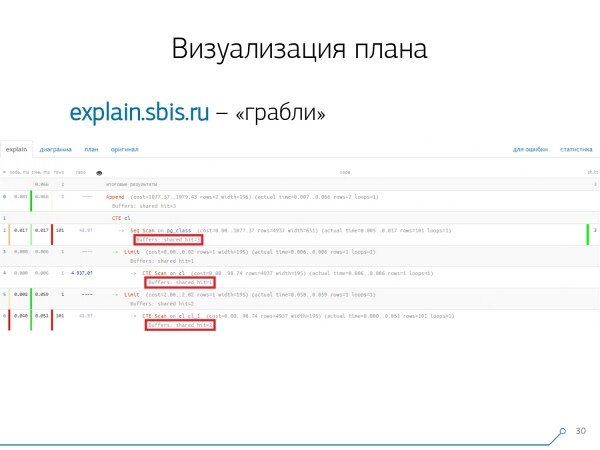
Shikojmë planin dhe kuptojmë — është e çuditshme, kemi 3 buffers (fqinj të të dhënave) që ishin "konsumuar" në Seq Scan, 1 tjetër në CTE Scan, dhe 2 të tjera në CTE Scan të dytë. Pra, nëse thjesht i përmbledhim, na rezulton 6, megjithatë në tabelë lexuam vetëm 3! CTE Scan nuk lexon asgjë nga askund, por punon direkt me memorjen e procesit. Pra, këtu është qartë se diçka nuk shkon!
Në të vërtetë ndodh që këto 3 fqinj të të dhënave, të cilat ishin kërkuar nga Seq Scan, së pari 1 i kërkoi 1 CTE Scan, e më pas 2, dhe atij i lexuan edhe 2 të tjera. Pra, gjithsej ishin lexuar 3 fqinj të të dhënave, jo 6.
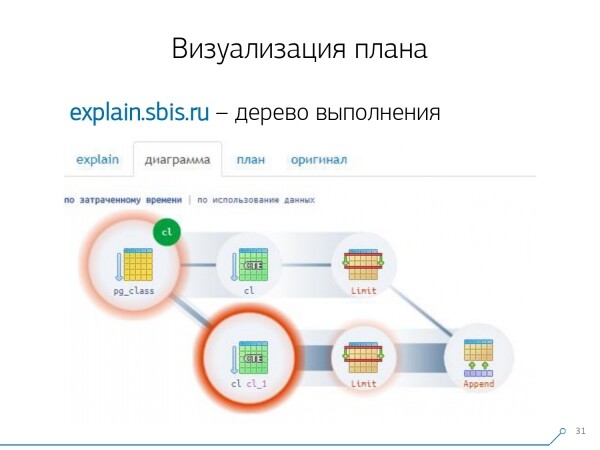
Dhe kjo pamje na çoi në kuptimin se ekzekutimi i planit nuk është më një pemë, por thjesht një grafik aciklik. Kështu që kemi marrë një diagram të tillë, për të kuptuar "çfarë-er dhe nga e ardhura“. Pra, këtu krijuam CTE nga pg_class, dhe e kërkuam dy herë, dhe pothuajse e gjithë koha shpenzuar ishte në degë, kur e kërkuam për herë të dytë. Është e qartë se të lexosh regjistrimin e 101-të është shumë më e shtrenjtë se thjesht të lexosh të parin nga tabela.

Ne morëm frymë për një kohë. Themë: "Tani, Neo, ti e di kung-fu! Tani eksperienca jonë është direkt në ekranin tënd. Tani mund ta përdorësh atë."
Konsolidimi i logeve
1000 zhvilluesve tanë bëjnë një frymë lehtësuese. Por ne e kuptonim që kishim vetëm qindra serverë "luftarakë", dhe ky "kopipast" nga ana e zhvilluesve nuk ishte aspak i përshtatshëm. Kuptuam se duhej ta përgatisnim vetë.
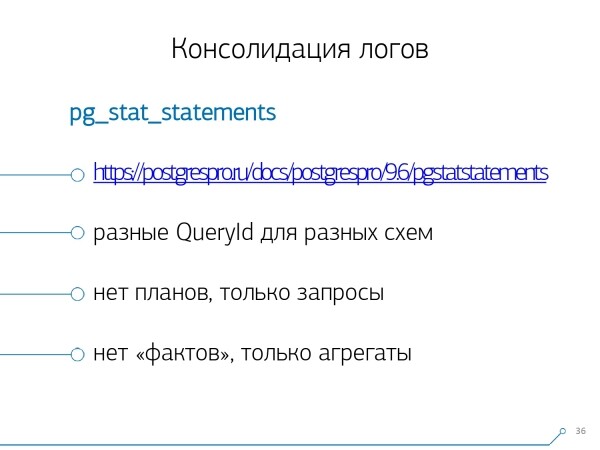
Në të vërtetë, ka një modul të brendshëm që di të mbledhë statistika, megjithatë, duhet po ashtu ta aktivizoni në konfigurim — ky është . Por ne nuk u kënaqëm me të.
Së pari, ai i jep QueryId të ndryshmepër kërkesa të njëjta në skema të ndryshme brenda një baze. Do të thotë, nëse fillimisht bëni SET search_path = '01'; SELECT * FROM user LIMIT 1;, dhe pastaj SET search_path = '02'; dhe një kërkesë të tillë, atëherë në statistikën e këtij moduli do të ketë regjistrime të ndryshme, dhe nuk do të mund të mbledh statistika të përgjithshme në lidhje me këtë profil kërkese, pa pasur parasysh skemat.
Moment i dytë, që na pengoi ta përdorim — mungesa e planeve. Do të thotë, nuk ka plan — vetëm vetë kërkesa. Ne shohim se çfarë e ngadalësonte, por nuk kuptojmë se pse. Dhe këtu kthehemi në problemin e dataset-it në shpejtësi të lartë.
Dhe momenti i fundit — mungesa e "fakteve". Do të thotë, nuk mund të adresoheni në një instancë të caktuar të ekzekutimit të kërkesës — nuk ekziston, ka vetëm statistikë të agreguar. Edhe nëse mund të punoni me këtë, është thjesht shumë e komplikuar.
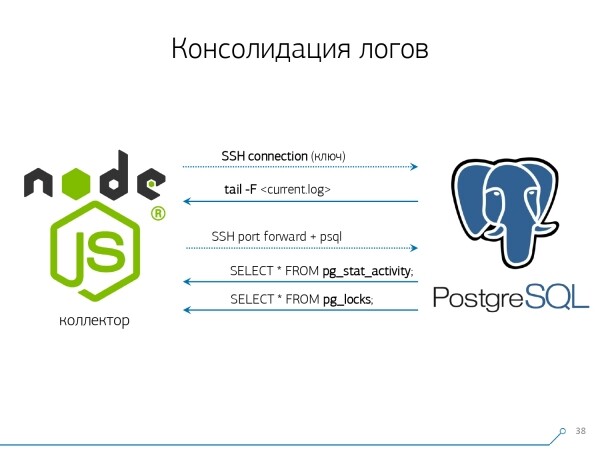
Prandaj ne vendosëm të luftojmë me "kopipastën" dhe filluam të shkruajmë kollektorin.
Kolektorja lidhet përmes SSH, "ngjitet" me ndihmën e një certifikate në një lidhje të mbrojtur deri në serverin me bazën dhe tail -F "kap" në të në skedarin e log-ut. Në këtë mënyrë, në këtë sesion ne marrim një "pasqyrë" të plotë të gjithë skedarit të log-ut, që gjeneron shërbimi. Ngarkesa në vetë serverin është minimale, sepse ne nuk po analizojmë asgjë, thjesht po pasqyrojmë trafikun.
Duke qenë se ne tashmë kishim filluar të shkruanim ndërfaqen në Node.js, ne vazhduam ta shkruanim kolektorin gjithashtu në të. Dhe kjo teknologji u justifikua, sepse për të punuar me të dhëna tekstuale të formatuara dobët, të cilat janë log, është shumë e përshtatshme të përdoret JavaScript. Ndërsa infrastruktura e Node.js si platformë backend lejon të punoni lehtë dhe me shpejtësi me lidhjet rrjet dhe në përgjithësi me disa rrjedha të dhënash.
Pra tega, ne "stretchojmë" dy lidhje: e para, për të "dëgjuar" logun dhe për ta marrë atë, dhe e dyta - për të pyetur periodikisht bazën. "Ja, në log u kalua që tabelën me oid 123 është bllokuar", por kjo nuk i thotë asgjë zhvilluesit, dhe do të ishte mirë të pyesnim bazën "Çfarë është OID = 123?" Kështu ne periodikisht pyesim bazën për ato që nuk i dimë ende.
"Vetëm një gjë nuk e kishe parasysh, ekziston një lloj bletësh në formë elefanti!..." Ne filluam të zhvillojmë këtë sistem kur donim të monitoronim 10 serverë. Ata që ishin më kritikë në mendimin tonë, mbi të cilët kishin ndodhur disa probleme të vështira për t'u zgjidhur. Por brenda tremujorit të parë morëm për monitorim njëqind - sepse sistemi "u mesua", të gjithë deshën, ishte e lehtë për të gjithë.
Të gjitha këto duhet të grumbullohen, fluksi i të dhënave është i madh dhe aktiv. Në fakt, atë që monitorojmë, me çfarë dimë të merremi - atëherë e përdorim. E përdorim si një depo të dhënash gjithashtu PostgreSQL. Dhe nuk ka asgjë më të shpejtë për të "derdhur" të dhënat në të, sesa operatori COPY nuk ka.
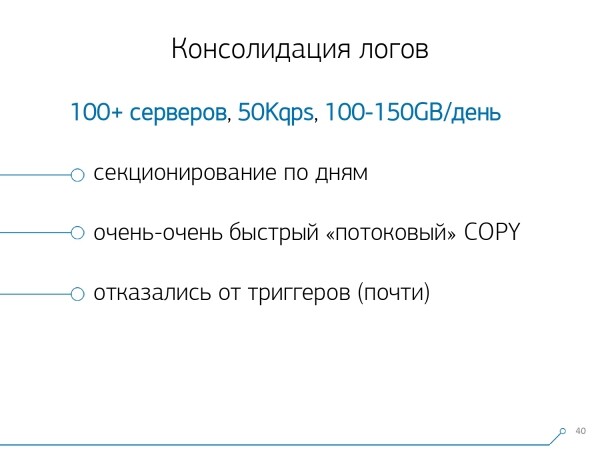
Por thjesht "derdhur" të dhënat - nuk është pikërisht teknologjia jonë. Sepse nëse në njëqind serverë kanë ndodhur rreth 50k kërkesa në sekondë, atëherë këtë ju gjeneron 100-150GB logësh në ditë. Prandaj na duhej ta "prishnim" bazën me kujdes.
Së pari, ne bëmë seksionimin sipas ditëve, për shkak se, në thelb, askujt nuk i intereson korrelacioni midis ditëve. Cila është dallimi çfarë keni patur dje, nëse sonte keni lëshuar një version të ri të aplikacionit - dhe tashmë keni një statistikë të re.
Së dyti, mësuam (ishim detyruar të) shkruajmë shumë shpejt me ndihmën e COPY. Pra, jo thjesht COPY, sepse është më i shpejtë se SHTO, por edhe më i shpejtë.
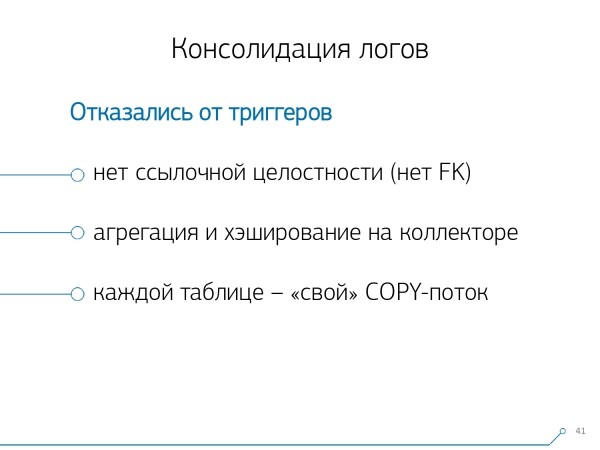
Momentin e tretë - duhej të heqim dorë nga trigget, kështu që edhe nga Foreign Keys. Pra, ne s'kemi fare integritet referencial. Sepse nëse keni një tabelë, mbi të cilën ekziston një çift FK, dhe ju thoni në strukturën e DB, që "këtu është një regjistrim i logut që referon me FK, për shembull, në një grup regjistrimesh", atëherë kur e vendosni, PostgreSQL nuk ka tjetër veçse të marrë dhe ta ekzekutojë me ndershmëri SELECT 1 FROM master_fk1_table WHERE ... me identifikuesin që po përpiqeni të vendosni - thjesht për të kontrolluar se ky regjistrim është aty, që ju nuk po "thyesh" këtë Foreign Key me vendosjen tuaj.
Ne marrim jo vetëm një regjistrim në tabelën e synimit dhe indekset e saj, por gjithashtu lexojmë nga të gjitha tabelat që lidhen me të. Dhe ne nuk kemi nevojë për këtë - detyra jonë është të shkruajmë sa më shumë dhe sa më shpejt me sa më pak ngarkesë. Pra, FK - larg!
Pika tjetër është agregimi dhe hashimi. Fillimisht ato ishin realizuar në DB - sepse është e përshtatshme që sapo arrin një regjistrim, të bësh diçka në një tabelë. "plus një" direkt në trigger.. E mira është se është e përshtatshme, por e keqja është se - futni një regjistrim, por jeni të detyruar të lexoni dhe shkruani diçka tjetër nga një tabelë tjetër. Për më tepër, jo vetëm që duhet të lexoni dhe shkruani - por gjithashtu ta bëni këtë çdo herë.
Tani imagjinoni se keni një tabelë ku thjesht numëroni sasinë e kërkesave që kalojnë përmes një hosti të caktuar: +1, +1, +1, ..., +1. Dhe kjo për ju, në thelb, nuk është e nevojshme - mund ta shumoni në memorien e kolektorit dhe ta dërgoni në bazë një herë. +10.
Po, në rast të ndonjë problemi mund të "shkatërrohet" integriteti logjik, por ky është një rast praktikisht i pamundur - sepse keni një server normal, me një bateri në kontrollues, keni një gazetë transaksionesh, një gazetë në sistemin e skedarëve... Pra, nuk e meriton. Nuk e justifikon humbjen e performancës që merrni për shkak të punës së triggers/FK, atyre shpenzimeve që keni në këtë rast.
E njëjta gjë është me hashimin. Ju vjen një kërkesë, ju llogaritni një identifikues në DB, e shkruani në bazë dhe më pas të gjithë e thoni atë. Është mirë, derisa në momentin e regjistrimit, ju vjen një person tjetër që dëshiron ta regjistrojë të njëjtin - dhe do të keni një bllokim, dhe kjo nuk është mirë. Prandaj, nëse mund ta bëni gjenerimin e disa ID-ve në klient (për sa i përket bazës), është më mirë ta bëni atë.
Na erdhi perfekt të përdorim MD5 të tekstit - kërkesa, plani, shablloni,... Ne e llogarisim atë në anën e kolektorit dhe "derdhim" në bazë ID-në e gatshme. Gjatësia e MD5 dhe ndarja e përditshme na lejojnë të mos shqetësohemi për kolizionet e mundshme.
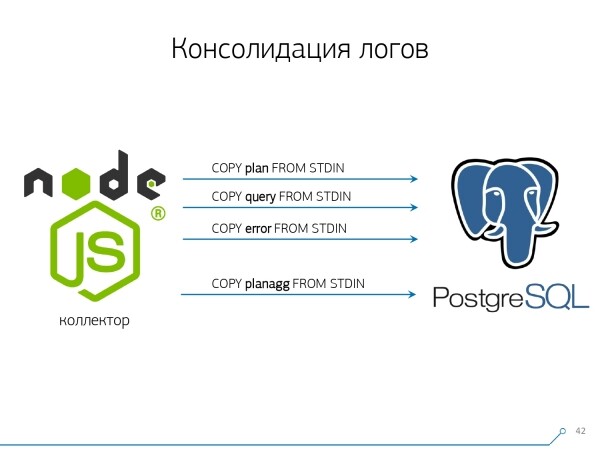
Por për ta shkruar të gjitha këto shpejt, na duhej të modifikonim procedurën e vetë regjistrimit.
Si si zakonisht shkruhen të dhënat? Ne kemi një dataset, e ndanojme atë në disa tabelat, dhe pastaj COPY - fillimisht në të parën, pastaj në të dytën, në të tretën... E pakëndshme, sepse duket se po shkruajmë një rrjedhë të dhënash në tre hapa radhazi. E pakëndshme. A është e mundur të bëjmë më të shpejtë? Po!
Për këtë mjafton të ndajmë këto rrjedha paralelisht me njëra-tjetrën. Pra, bëhet që ne kemi gabimet, kërkesat, shabllonat, bllokimet... që fluturojnë në rrjedha të veçanta, dhe ne i shkruajmë të gjitha paralelisht. Mjafton të mbajmë gjithmonë të hapur një kanal COPY për çdo tabelë të veçantë të destinacionit.
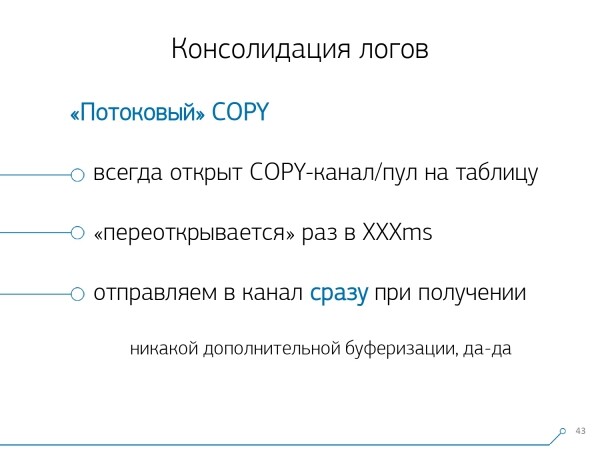
Kështu që kolektori ka gjithmonë një stream, në të cilin mund të shkruaj të dhënat që më nevojiten. Por që baza të shohë këto të dhëna, dhe askush të mos ngecë në bllokim duke pritur që këto të dhëna të shkruhen, COPY duhet të ndërpritet me një periodicitet të caktuar. Për ne, periudha më efikase rezultoi të jetë rreth 100ms - e mbyllim dhe menjëherë e hapim përsëri për të njëjtën tabelë. Dhe nëse një rrjedhë e vetme nuk është e mjaftueshme gjatë pikave të caktuara, atëherë bëjmë polling deri në një kufi të caktuar.
Për më tepër, ne zbuluam se për këtë profil ngarkese, çdo agregatë, kur të dhënat mblidhen në paketa - është e keqe. E keqja klasike është INSERT ... VALUES dhe më pas 1000 regjistrime. Sepse në atë moment do t'ju shfaqet një pikë shkrimi në mbajtësin, dhe të gjithë të tjerët që përpiqen të shkruajnë në disk, do të presin.
Për të eliminuar këto anomali, thjesht mos agregoni asgjë, mos e bufëroni fare. Dhe nëse ndodhin ende buffering në disk (me fat, Stream API në Node.js e lejon të dini këtë) - shtyni këtë lidhje. Atëherë kur t'ju vijë një ngjarje që ajo është përsëri e lirë - shkruani në të nga radhat e akumuluara. Dhe për sa kohë që ajo është e zënë - merrni nga pool-i të ardhshëm të lirë dhe shkruani në të.
Para zbatimit të këtij qasje për shkruajtjen e të dhënave, ne kishim rreth 4K write ops, dhe me këtë metodë e kemi reduktuar ngarkesën në 4 herë. Tani u rritëm edhe 6 herë falë bazave të reja të vëzhgueshme - deri në 100MB/s. Dhe tani ruajmë log-et për muajt e fundit 3 në vëllimin e rreth 10-15TB, duke shpresuar që për tre muaj të paktën çdo problem çdo zhvillues është i aftë ta zgjidhë.
E kuptojmë problemet
Porosinë e thjeshtë e të gjitha këtyre të dhënave është e mirë, e dobishme dhe e përshtatshme, por është e pamjaftueshme — ato duhet të kuptohen. Sepse janë miliona plane të ndryshme në një ditë.
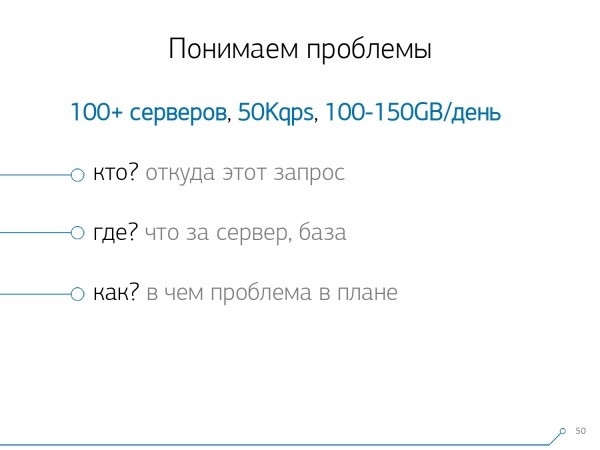
Por miliona është një situatë e pakontrollueshme, fillimisht duhet të bëjmë "më pak". Dhe, mbi të gjitha, duhet të vendosim se si do ta organizojmë këtë "më pak".
Ne kemi identifikuar tre pika kyçe:
- kush ky kërkesë është dërguar nga
Pra, nga cila aplikacion ai "ka ardhur": ndërfaqja web, backend, sistemi i pagesave ose diçka tjetër. - ku kjo ndodhi
Në cilin server konkret. Sepse nëse keni disa serverë nën një aplikacion, dhe papritur një "ngadalëson" (për shkak se "disku është prishur", "memoria është humbur", ndonjë tjetër problem), duhet të drejtohemi konkretisht te serveri. - si problemi shfaqej saktësisht në këtë apo atë plan
Për të kuptuar "kush" na dërgoi kërkesën, ne përdorim mjetin standard — caktimin e një variabli seance: SET application_name = '{bl-host}:{bl-method}'; — ne regjistrojmë emrin e hostit të logjikës së biznesit nga i cili vjen kërkesa dhe emrin e metodës ose aplikacionit që e inicoi atë.
Pasi ne transferojmë "pronarin" e kërkesës, ajo duhet të regjistrohet në log — për këtë ne konfigurim variablin log_line_prefix = ' %m [%p:%v] [%d] %r %a'. Ata të interesuar mund , çfarë do të thotë kjo. Kështu, në log ne shohim:
- kohë
- identifikuesit e procesit dhe transaksionit
- emri i bazës
- IP e atij që dërgoi këtë kërkesë
- dhe emrin e metodës
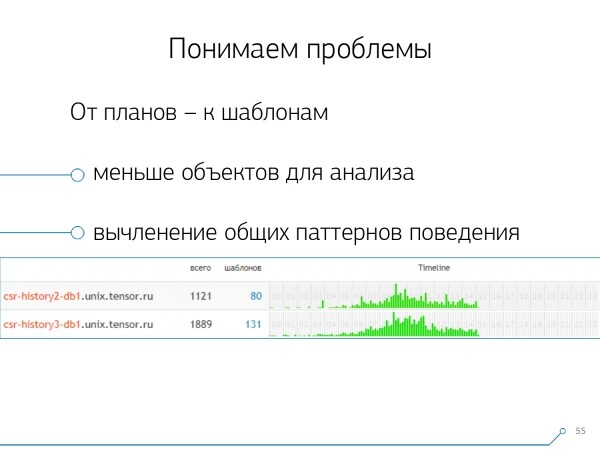
Më pas kuptuam se nuk është shumë interesante të shohim korrelacionin e një kërkese midis serverave të ndryshëm. Nuk ndodhin shpesh situata kur një aplikacion ka të njëjtën "problematikë" këtu dhe atje. Por edhe nëse është e njëjtë — shikoni çfarëdo nga këta serverë.
Pra, prerja "një server — një ditë" na rezultoi të ishte e mjaftueshme për çdo analizë.
Prerja e parë analitike — është ai "model" — një formë e shkurtuar e paraqitjes së planit, e pastruar nga të gjitha shifrat. Prerja e dytë — aplikacioni ose metoda, dhe e treta — ky është një nyje konkret i planit që na shkaktoi probleme. Kur ne kaluam nga ekzemplarët konkretë në modelet, fituam menjëherë dy avantazhe:
reduktim dramatik i numrit të objekteve për analizë
- Tani duhet të analizojmë problemin jo nga mijëra kërkesa ose plane, por nga dhjetëra modele.
kohëlinja - kohëline
Pra të përmbledhim "faktet" brenda një scope, mund të shfaqim shfaqjen e tyre gjatë ditës. Dhe këtu mund të kuptoni se nëse një model ndodh, për shembull, një herë në orë, kur duhet të ndodhte një herë në ditë, duhet të mendoni se çfarë ka shkuar keq - kush e ka shkaktuar dhe përse, ndoshta nuk duhet të jetë këtu. Ky është një tjetër mënyrë analize që nuk është numerike, thjesht vizuale.
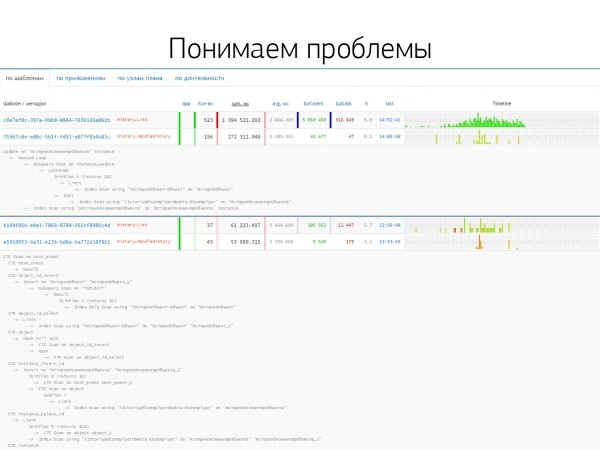
Mënyrat e tjera bazohen në ato tregues që nxjerrim nga plani: sa herë ndodhi një model i tillë, koha totale dhe mesatare, sa të dhëna janë lexuar nga disku dhe sa nga memoria...
Sepse, për shembull, vini në faqen e analitikës për hostin, shikoni - diçka po fillon të lexojë shumë nga disku. Disku në server nuk po e përballon - por kush po lexon nga ai?
Dhe mund të rendisni sipas çfarëdo kolone dhe të vendosni se me çfarë do të merret tani - me ngarkesën e procesorit ose të disku, ose me numrin e përgjithshëm të kërkesave... Keni renditur, shikuar "top"-et, i keni riparuar - keni lëshuar një version të ri të aplikacionit.
Dhe menjëherë mund të shihni aplikacione të ndryshme që ndjekin të njëjtin model nga kërkesa e tipit SELECT * FROM users WHERE login = 'Vasya'. Frontend, backend, procesimi... Dhe filloni të mendoni, përse frontendi duhet të lexojë përdoruesin, nëse ai nuk po ndërvepron me të.
Mënyra tjetër - është të shihni drejtpërdrejt nga aplikacioni se çfarë po bën. Për shembull, frontend - kjo, kjo, kjo, dhe gjithashtu kjo një herë në orë (ashtu siç ndihmon timeline). Dhe menjëherë lind pyetja - duket se nuk është puna e frontendit të bëjë diçka një herë në orë...
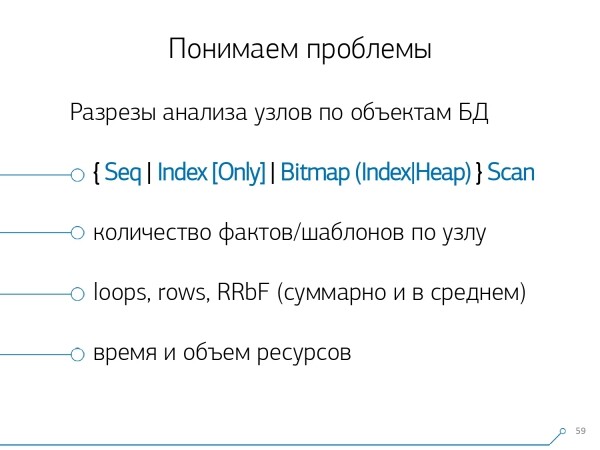
Pas një kohe, kuptuam se na mungonte statistikë e agreguar në kontekstin e nyjeve të planit.. Ne nxorrëm vetëm ato nyje nga planet që bëjnë diçka me të dhënat e vetë tabelave (i lexojnë/ shkruajnë ato sipas indeksit ose jo). Në thelb, në lidhje me imazhin e mëparshëm, i shtohet vetëm një aspekt - sa regjistra ky nyje na ka sjellë, dhe sa ka hedhur poshtë (Rreshtat e hequra nga Filtri).
Nuk keni një indeks të duhur në tabelë, bëni një kërkesë, ajo kalon përmes indeksit dhe bie në Seq Scan... të gjitha regjistrat, përveç njëit janë filtruar. Pse ju duhen 100M regjistrash të filtruar në 24 orë, a nuk është më mirë të vendosni një indeks?
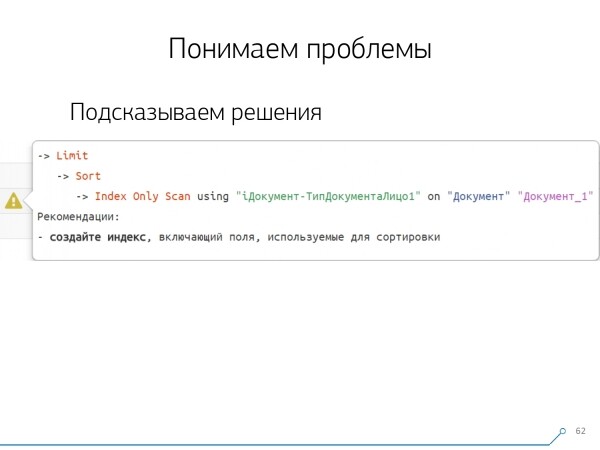
Pas shumë analize të planeve në nyje, ne kuptuam se ekzistojnë disa struktura tipike në planet, të cilat me shumë gjasa duken të dyshimtë. Dhe do ishte mirë të sugjerohej zhvilluesit: "Mik, këtu në fillim lexon sipas indeksit, pastaj rendit dhe më pas priton" — zakonisht aty ka një regjistrim.
Të gjithë ata që kanë shkruar kërkesa me një model të tillë, me siguri janë përballur: "Më jep porosinë më të fundit për Vasën, datën e tij". Dhe nëse nuk ke një indeks sipas datës, ose në indeksin e përdorur nuk ka datë, atëherë pikërisht në ato "gratë" do të shkelni.
Por ne e dimë se këto janë "gratë" — pra, pse të mos i sugjerojmë menjëherë zhvilluesit se çfarë duhet të bëjë. Prandaj, duke hapur tani planin, zhvilluesi ynë menjëherë sheh një pamje të bukur me sugjerime, ku i thuhet menjëherë: "Këtu ke probleme dhe këtu, dhe ato zgjidhen kështu e kështu."
Si rezultat, volumi i përvojës që ishte e nevojshme për zgjidhjen e problemeve në fillim dhe tani, ka rënë shumë. Kështu kemi krijuar një mjet të tillë.
Burimi: habr.com
