

Përshëndetje.
Vendosa me një zbulim — një frut mendimesh, provash dhe gabimesh.
Në thelb: kjo nuk është me të vërtetë një zbulim, sigurisht — këto duhet të jenë të njohura prej kohësh për ata që merremet me përpunimin e të dhënave praktike dhe optimizimin e ndonjë sistemi, jo domosdoshmërisht vetëm për DBMS.
Dhe: ata e dinë, shkruajnë artikuj tërheqës për kërkimet e tyre, (UPD.: në komentet theksuan një projekt shumë interesant: )
Nga ana tjetër: në një shikim të shpejtë nuk shoh një përmendje të gjerë, përhapje të këtij qasjeje, në internet, midis specialistëve të TI, DBA.
Pra, në thelb.
Le të supozojmë se kemi një detyrë: të konfigurojmë një sistem shërbimi për të trajtuar një punë të caktuar.
Për këtë punë — dihen: çfarë është ajo, si matet cilësia e kësaj pune dhe cili është kriteri për matjen e kësaj cilësie.
Gjithashtu le të supozojmë se, më shumë ose më pak, është e njohur: si realizohet puna në (ose me) këtë sistem shërbimi.
"Më shumë ose më pak" — do të thotë se ka mundësi të përgatitet (ose diku të merret) ndonjë mjet, utilitar, shërbim që mund të sintetizojë dhe të ofrojë në sistem një ngarkesë testuese mjaft adekuate në krahasim me atë që do të jetë në prodhim, në kushte mjaft adekuate për punën në prodhim.
Dhe le të supozojmë se është njohur grupi i parametrave rregullatorë të këtij sistemi shërbimi, të cilat mund të përdoren për të konfiguruar këtë sistem në lidhje me produktivitetin e punës së tij.
Dhe, cila është problemi — nuk ka një kuptim të mjaftueshëm të këtij sistemi shërbimi, një lehtësim i tillë që lejon që ekspertët të vendosin rregullimin e këtij sistemi nën ngarkesën e ardhshme, në këtë platformë dhe të arrijnë produktivitetin e nevojshëm të punës së sistemit.
Pra, kështu ndodh pothuajse gjithmonë.
Çfarë mund të bëhet këtu.
E para që më vjen në mendje: të shikojmë dokumentacionin për këtë sistem. Të kuptojmë — cilat janë диапазонet e pranuara për vlerat e parametrave rregullatorë. Dhe, për shembull, përmes metodës së zbritjes koordikuese, të zgjedhim vlera për parametrat e sistemit në teste.
Pra, të caktosh sistemit një konfigurim të caktuar, në formën e një grupi konkret të vlerave të parametrave të tij rregullatorë.
Të ofrojmë një ngarkesë testuese mbi të, me këtë mjet-utilitar, gjenerator ngarkese.
Dhe të shohim sasinë — përgjigjja, ose metrika e cilësisë së punës së sistemit.
Mendimi i dytë mund të jetë një përfundim se — kjo merr shumë kohë.
Pra rrjedh: nëse ka shumë parametra konfigurimi, nëse diapazonet e tyre të vlerave janë të mëdha, nëse çdo provë ngarkese zgjat për shumë kohë, atëherë: po, gjithçka mund të marrë një kohë të papranueshme.
Këtu mund të kuptohet dhe të kujtohet diçka.
Mund të mësohet për një grup vlerash parametrash konfigurimi të sistemit të shërbimit — një vektor, si një sekuencë e disa vlerave.
Çdo vektor i tillë, me kushte të barabarta (në atë që ky vektor nuk prek), ka një vlerë të përcaktuar metrikore — një tregues të cilësisë së punës së sistemit, nën ngarkesë testimi.
Kështu që.
Të caktuar vektorët e konfigurimit të sistemit, si  index
 ; Ku
 — numri i parametrave të konfigurimit të sistemit, sa janë, këta parametra.
Dhe vlera metrikore, përkatëse këtij  do ta quajmë si
 , pra, na del një funksion:

Kështu që, atëherë: gjithçka përfundimisht reduktohet në, në rastin tim: algorithmet për kërkimin e ekstremit të funksionit, të cilat pothuajse i kam harruar nga koha e studentëve.
Mirë, por këtu lind një pyetje organizative dhe praktike: cili algoritëm duhet të përdoret.
- Dhe në kuptimin — që të kesh sa më pak të bësh me kodin.
- Dhe të punojë, përkatësisht të gjejë ekstremet (nëse ka), të paktën — më shpejt se zbritja e koordinatave.
Pika e parë tregon se duhet të shikohet drejt disa mesave, në të cilat këta algoritma — janë tashmë të realizuar dhe janë, në ndonjë formë, të gatshëm për t'u përdorur në kod.
Tani, unë kam njohuri për python dhe cran-r
Pika e dytë tregon se duhet të lexojmë rreth algoritmave, cilat janë ata, cilat janë kërkesat, karakteristikat në punë.
Dhe çfarë ofrojnë ata, mund të ketë efekte anësore që janë të dobishme, ose direkt nga vetë algoritmi.
Ose ato mund të merren nga rezultatet e punës së algoritmit.
Këtu shumëçka varet nga kushtet hyrëse.
Për shembull, nëse, për disa arsye, duhet të merrni rezultatin më shpejt, duhet të shikoni drejt algoritmeve të shpërndarjes së gradientit, duke zgjedhur ndonjë nga ato.
Ose, nëse koha nuk është kaq e rëndësishme, mund të përdoren metodat e optimizimit stohastik, për shembull algoritmi gjenetik.
Propozoj të shqyrtojmë punën e këtij qasje, për përcaktimin e konfiguracionit të sistemit, duke përdorur algoritmin gjenetik, në punën e ardhshme, të ashtuquajturën: laborator.
Burimet:
- Le të ketë, si një sistem shërbimi:
oracle xe 18c - Le të shërbejë ajo për aktivitetin transaksional dhe qëllimi: të marrësh një kapacitet më të madh të mundshëm të subd, sipas transaksioneve/sekond.
- Transaksionet janë shumë të ndryshme, sipas karakterit të punës me të dhëna dhe kontekstit të punës.
Marrim përshtypje se këto janë transaksione që nuk përpunojnë një sasi të madhe të dhënash tabelore.
Në kuptimin se ato nuk gjenerojnë të dhëna të anuluara më shumë se të dhënat e rikthimit dhe nuk përpunojnë një përqindje të madhe rreshtash, të tabelave të mëdha.
Janë transaksione që ndryshojnë një rresht në një tabelë më shumë-më pak të madhe, me një numër të vogël indexesh mbi këtë tabelë.
Në këtë rast: produktiviteti i subd për përpunimin e transaksioneve do të përcaktohet, me kusht, nga cilësia e përpunimit të bazës së të dhënave të rikthimit.
Kushti - nëse flasim pikërisht mbi konfigurimet e subd.
Sepse, në rastin e zakonshëm, mund të ketë, për shembull, bllokime transaksionale mes seancave sql, për shkak të dizajnit të punës së përdoruesve me të dhënat tabelore dhe/ose modelit tabelar.
Të cilat, natyrisht, do të ndikojnë negativisht në metriken tps dhe kjo do të jetë një faktor egzogjen, në lidhje me subd: pra, kështu është dizajnuar modeli tabelar dhe puna me të dhënat në të që krijohen bllokime.
Prandaj, për pastërtinë e eksperimenteve, do ta përjashtojmë këtë faktor, më poshtë do të sqaroj si pikërisht.
- Supozoni, për saktësi, se 100% e komandave sql të plota në subd: janë komanda dml.
Le të jetë karakteristikat e punës së përdoruesit me subd: të njëjtat, në teste.
Pikërisht: numri i seancave sql, të dhënat tabelare, si punojnë me to seancat sql. - Subd funksionon në
FORCE LOGGING,ARCHIVELOGmodes. Mjeti i flashback-ndërtimit është i fikur, në nivelin e subd. - Të dhënat e rikthimit: ndodhen në një sistem të veçantë skedarësh, në një 'disk' të veçantë;
E gjithë pjesa tjetër e komponentit fizik të bd: në një fs tjetër, të veçantë, në një 'disk' të veçantë:
Më shumë, për strukturën e komponentit fizik të laboratorit bd
SQL> select status||' '||name from v$controlfile;
 /db/u14/oradata/XE/control01.ctl
SQL> select GROUP#||' '||MEMBER from v$logfile;
1 /db/u02/oradata/XE/redo01_01.log
2 /db/u02/oradata/XE/redo02_01.log
SQL> select FILE_ID||' '||TABLESPACE_NAME||' '||round(BYTES/1024/1024,2)||' '||FILE_NAME as col from dba_data_files;
4 UNDOTBS1 2208 /db/u14/oradata/XE/undotbs1_01.dbf
2 SLOB 128 /db/u14/oradata/XE/slob01.dbf
7 USERS 5 /db/u14/oradata/XE/users01.dbf
1 SYSTEM 860 /db/u14/oradata/XE/system01.dbf
3 SYSAUX 550 /db/u14/oradata/XE/sysaux01.dbf
5 MONITOR 128 /db/u14/oradata/XE/monitor.dbf
SQL> !cat /proc/mounts | egrep "/db/u[0-2]"
/dev/vda1 /db/u14 ext4 rw,noatime,nodiratime,data=ordered 0 0
/dev/mapper/vgsys-ora_redo /db/u02 xfs rw,noatime,nodiratime,attr2,nobarrier,inode64,logbsize=256k,noquota 0 0
Initially, I wanted to use this database under the load conditions of transactions
It has this wonderful feature, let me quote the author:
At the heart of SLOB is the “SLOB method.” The SLOB Method aims to test platforms
without application contention. One cannot drive maximum hardware performance
using application code that is, for example, bound by application locking or even
sharing Oracle Database blocks. That’s right—there is overhead when sharing data
in data blocks! But SLOB—in its default deployment—is immune to such contention.
This declaration: corresponds, so it is.
It is convenient to adjust the degree of parallelism of the SQL sessions, this is the key -t to launching the utility runit.sh of the SLOB composition
It regulates the percentage of DML commands, among the number of SQLs that each SQL session sends to the database, the parameter UPDATE_PCT
Separately and very conveniently: SLOB itself, before and after the load session — prepares statspack, or AWR snapshots (as specified to prepare).
However, it turned out that SLOB it does not support SQL sessions with a duration of less than 30 seconds.
Therefore, I first coded my own, a working-peasant version of the load generator, and then it just stayed in use.
Let me clarify about the load generator — what it does and how, for clarity.
Essentially, the load generator looks like this:
Worker code
function dotx()
{
local v_period="$2"
[ -z "v_period" ] && v_period="0"
source "/home/oracle/testingredotrace/config.conf"

$ORACLE_HOME/bin/sqlplus -S system/${v_system_pwd} << __EOF__
whenever sqlerror exit failure
set verify off
set echo off
set feedback off

define wnum="$1"
define period="$v_period"
set appinfo worker_&&wnum

declare
 v_upto number;
 v_key number;
 v_tots number;
 v_cts number;
begin
 select max(col1) into v_upto from system.testtab_&&wnum;
 SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 v_tots := &&period + v_cts;
 while v_cts <= v_tots
 loop
  v_key:=abs(mod(dbms_random.random,v_upto));
  if v_key=0 then
   v_key:=1;
  end if;
  update system.testtab_&&wnum t
  set t.object_name=translate(dbms_random.string('a', 120), 'abcXYZ', '158249')
  where t.col1=v_key
  ;
  commit;
  SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 end loop;
end;
/

exit
__EOF__
}
export -f dotx
Workers are launched in the following way:
Launching workers
echo "duke testi, durata: ${TEST_DURATION}" >> "$v_logfile"
for((i=1;i> "$v_logfile"
 dotx "$i" "${TEST_DURATION}" &
done
echo "po pritur..." >> "$v_logfile"
wait
Dhe tabelat për punëtorët përgatiten kështu:
Krijimi i tabelave
function createtable() {
source "\/home\/oracle\/testingredotrace\/config.conf"
$ORACLE_HOME\/bin\/sqlplus -S system\/${v_system_pwd} << __EOF__
whenever sqlerror continue
set verify off
set echo off
set feedback off

define wnum="\$1"
define ts_name="slob"

begin
 execute immediate 'drop table system.testtab_&&wnum';
exception when others then null;
end;
\/\

create table system.testtab_&&wnum tablespace &&ts_name as
select rownum as col1, t.*
from sys.dba_objects t
where rownum> "$v_logfile"
Pra, për çdo punëtor (praktikisht: një seancë të veçantë sql në databazë) krijohet një tabelë e veçantë, me të cilën punon punëtori.
Kësaj i arrihet duke evituar bllokimet tranzaksionale, midis seancave sql të punëtorëve.
Çdo punëtor: bën të njëjtën gjë me tabelën e tij, të gjithë tabelat janë të njëjta.
Të gjithë punëtorët kryejnë punën për një periudhë të njëjtë kohe.
Për më tepër, është mjaft kohë e gjatë, që, për shembull, të ndodhi me saktësi, dhe jo njëherë, kalimi i log-ut.
Dhe në këtë mënyrë, me të lidhur, shfaqen shpenzime dhe efekte të tilla.
Në rastin tim, kam konfigurimin e kohëzgjatjes së punës së punëtorëve në 8 minuta.
Një copë raporti statspak, me përshkrimin e punës së databazës nën ngarkesë
Database    DB Id    Instance     Inst Num  Startup Time   Release     RAC
~~~~~~~~ ----------- ------------ -------- --------------- ----------- ---
          2929910313 XE                  1 07-Sep-20 23:12 18.0.0.0.0  NO

Host Name             Platform                CPUs Cores Sockets   Memory (G)
~~~~ ---------------- ---------------------- ----- ----- ------- ------------
     billing.izhevsk1 Linux x86 64-bit           2     2       1         15.6

Snapshot       Snap Id     Snap Time      Sessions Curs/Sess Comment
~~~~~~~~    ---------- ------------------ -------- --------- ------------------
Begin Snap:       1630 07-Sep-20 23:12:27       55        .7
  End Snap:       1631 07-Sep-20 23:20:29       62        .6
   Elapsed:       8.03 (mins) Av Act Sess:       8.4
   DB time:      67.31 (mins)      DB CPU:      15.01 (mins)

Cache Sizes            Begin        End
~~~~~~~~~~~       ---------- ----------
    Buffer Cache:     1,392M              Std Block Size:         8K
     Shared Pool:       288M                  Log Buffer:   103,424K

Load Profile              Per Second    Per Transaction    Per Exec    Per Call
~~~~~~~~~~~~      ------------------  ----------------- ----------- -----------
      DB time(s):                8.4                0.0        0.00        0.20
       DB CPU(s):                1.9                0.0        0.00        0.04
       Redo size:        7,685,765.6              978.4
   Logical reads:           60,447.0                7.7
   Block changes:           47,167.3                6.0
  Physical reads:                8.3                0.0
 Physical writes:              253.4                0.0
      User calls:               42.6                0.0
          Parses:               23.2                0.0
     Hard parses:                1.2                0.0
W/A MB processed:                1.0                0.0
          Logons:                0.5                0.0
        Executes:           15,756.5                2.0
       Rollbacks:                0.0                0.0
    Transactions:            7,855.1
Duke u kthim në vendimin e punës laboratorike.
Do të varirojmë, me të tjera barazi, vlerat e parametrave të tilla të laboratorit të databazës:
- Madhësia e grupeve të regjistrimit të databazës. diapazoni i vlerave: [32, 1024] Mbyte;
- Numri i grupeve të regjistrimit të databazës. diapazoni i vlerave: [2,32];
log_archive_max_processesdiapazoni i vlerave: [1,8];commit_logginglejohet dy vlera:batch|immediate;commit_waitlejohet dy vlera:wait|nowait;log_bufferdiapazoni i vlerave: [2,128] Mbyte.log_checkpoint_timeoutdiapazoni i vlerave: [60,1200] sekondadb_writer_processesdiapazoni i vlerave: [1,4]undo_retentiondiapazoni i vlerave: [30;300] sekondatransactions_per_rollback_segmentdiapazoni i vlerave: [1,8]disk_asynch_iolejohet dy vlera:true|false;filesystemio_optionslejohet këto vlera:none|setall|directIO|asynch;db_block_checkinglejohet këto vlera:OFF|LOW|MEDIUM|FULL;db_block_checksumlejohet këto vlera:OFF|TYPICAL|FULL;
Një person me përvojë në mbështetje të databazave Oracle, padyshim, tani mund të thotë se cilat dhe në cilat vlera duhen vendosur, nga parametrat e përmendur dhe vlerat e pranuara, për të arritur një produktivitet më të lartë të databazës, për atë punë me të dhëna, e cila është shënuar, nga kodi aplikativ, këtu lart.
Por.
Qëllimi i punës laboratorike është të tregojë se algoritmi optimizues, vetë dhe në mënyrë relativisht të shpejtë, do ta sqarohet për ne.
Na mbetet të hidhim një sy në dokumentacionin për sistemin e konfiguruar, pikërisht aq sa nevojitet për të zbuluar: cilat parametra dhe në cilat intervale duhet të ndryshohen.
Nga ana tjetër, duhet të shkruajmë kodin me anë të të cilit do të realizohet puna me sistemin e konfiguruar të algoritmit të zgjedhur të optimizimit.
Pra, tani për kodin.
Siç thashë më lart, cran-r, dmth: të gjitha manovrat me sistemin e konfiguruar orchestruar në formën e një skenari R.
Pra, detyra, analiza, përzgjedhja sipas vlerësime të metrikave, vektorëve të gjendjes së sistemit: është paketi GA ()
Paketin, në këtë rast, nuk ia vlen shumë, në kuptimin se ai pret caktimin e vektorëve (kromozomëve, në terma të paketa) si numra të plotë me pjesë dekimale.
Dhe vektori im, nga vlerat e parametrave të konfiguruar: është 14 vlera - numra të plotë dhe vlera string.
Problemi, natyrisht, zgjidhjet lehtësisht duke u caktuar vlerave string - disa numra të caktuar.
Pra, në fund, pjesa kryesore e skenarit R duket kështu:
Thirja GA::ga
cat( "", file=v_logfile, sep="n", append=F)

pSize = 10
elitism_value=1
pmutation_coef=0.8
pcrossover_coef=0.1
iterations=50

gam=GA::ga(type="real-valued", fitness=evaluate,
lower=c(32,2, 1,1,1,2,60,1,30,1,0,0, 0,0), upper=c(1024,32, 8,10,10,128,800,4,300,8,10,40, 40,30),
popSize=pSize,
pcrossover = pcrossover_coef,
pmutation = pmutation_coef,
maxiter=iterations,
run=4,
keepBest=T)
cat( "GA-session is done" , file=v_logfile, sep="n", append=T)
gam@solution
Këtu, me ndihmën e lower dhe upper atributeve të nënprogramit ga caktuar, në thelb, zona e hapësirës së kërkimit, brenda së cilës do të kryhet kërkimi për një vektor (ose vektorë) për të cilat do të merret vlera maksimale e funksionit të fitnesit.
nënprogrami ga kryen kërkimin duke maksimizuar funksionin e fitnesit.
Pra, në këtë rast, është e nevojshme që funksioni i fitnesit, duke e kuptuar vektorin si një grup vlerash për disa parametra të DB-së, të merrte metrikën nga DB-ja.
DMth: sa, në këtë ndërlikim të DB-së dhe këtë ngarkesë mbi DB-në, DB-ja proceson transaksione në sekondë.
DMth, duke e zhvilluar, është e nevojshme që brenda funksionit të fitnesit të kryhet një shumëllojshmëri:
- Përpunimi i vektorit hyrës të numrave - transformimi i tij në vlera për parametrat e DB-së.
- Përpjekja për të krijuar numrin e caktuar të grupeve redo, të madhësisë së caktuar. Mënyra përpjekje mund të mos jetë e suksesshme.
Grupet e regjistrimit ekzistuese në sistemin e menaxhimit të bazave të të dhënave, në një sasi të caktuar dhe një përmasë të caktuar, për qëllime eksperimentale - duhet të fshihen. - Nëse pika e mëparshme arrin sukses: caktimi i bazës së vlerave të parametrave të konfigurimit (po ashtu: mund të ndodhi një dështim)
- Nëse pika e mëparshme arrin sukses: ndalimi i sistemit të menaxhimit të bazave të të dhënave, rinisja e sistemit për të bërë që vlerat e reja të parametrave - të hyjnë në fuqi. (po ashtu: mund të ndodhi një dështim)
- Nëse pika e mëparshme arrin sukses: kryerja e një testi ngarkese. marrja e metrikave nga sistemi i menaxhimit të bazave të të dhënave.
- Kthimi i sistemit të menaxhimit të bazave të të dhënave në gjendjen fillestare, domethënë fshirja e grupeve të regjistrimit shtesë, rikthimi në funksion të konfiguracionit fillestar të sistemit të menaxhimit të bazave të të dhënave.
Kodi i funksionit të fitnessit
vlerëso=function(p_par) {
v_moduli="vlerëso"
v_metrika=0
opn=NULL
opn$rg_size=round(p_par[1],digit=0)
opn$rg_count=round(p_par[2],digit=0)
opn$log_archive_max_processes=round(p_par[3],digit=0)
opn$commit_logging="BATCH"
if ( round(p_par[4],digit=0) > 5 ) {
 opn$commit_logging="IMMEDIATE"
}
opn$commit_logging=paste("'", opn$commit_logging, "'",sep="")

opn$commit_wait="WAIT"
if ( round(p_par[5],digit=0) > 5 ) {
 opn$commit_wait="NOWAIT"
}
opn$commit_wait=paste("'", opn$commit_wait, "'",sep="")

opn$log_buffer=paste(round(p_par[6],digit=0),"m",sep="")
opn$log_checkpoint_timeout=round(p_par[7],digit=0)
opn$db_writer_processes=round(p_par[8],digit=0)
opn$undo_retention=round(p_par[9],digit=0)
opn$transactions_per_rollback_segment=round(p_par[10],digit=0)
opn$disk_asynch_io="true"
if ( round(p_par[11],digit=0) > 5 ) {
 opn$disk_asynch_io="false"
}

opn$filesystemio_options="none"
if ( round(p_par[12],digit=0) > 10 && round(p_par[12],digit=0)  20 && round(p_par[12],digit=0)  30 ) {
 opn$filesystemio_options="asynch"
}

opn$db_block_checking="OFF"
if ( round(p_par[13],digit=0) > 10 && round(p_par[13],digit=0)  20 && round(p_par[13],digit=0)  30 ) {
 opn$db_block_checking="FULL"
}

opn$db_block_checksum="OFF"
if ( round(p_par[14],digit=0) > 10 && round(p_par[14],digit=0)  20 ) {
 opn$db_block_checksum="FULL"
}

v_vektori=paste(round(p_par[1],digit=0),round(p_par[2],digit=0),round(p_par[3],digit=0),round(p_par[4],digit=0),round(p_par[5],digit=0),round(p_par[6],digit=0),round(p_par[7],digit=0),round(p_par[8],digit=0),round(p_par[9],digit=0),round(p_par[10],digit=0),round(p_par[11],digit=0),round(p_par[12],digit=0),round(p_par[13],digit=0),round(p_par[14],digit=0),sep=";")
cat( paste(v_moduli," përpiqet të vlerësojë vektorin: ", v_vektori,sep="") , file=v_logfile, sep="n", append=T)

rc=make_additional_rgroups(opn)
if ( rc!=0 ) {
 cat( paste(v_moduli,"make_additional_rgroups dështoi",sep="") , file=v_logfile, sep="n", append=T)
 return (0)
}

v_rc=0
rc=set_db_parameter("log_archive_max_processes", opn$log_archive_max_processes)
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_logging", opn$commit_logging )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_wait", opn$commit_wait )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_buffer", opn$log_buffer )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_checkpoint_timeout", opn$log_checkpoint_timeout )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_writer_processes", opn$db_writer_processes )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("undo_retention", opn$undo_retention )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("transactions_per_rollback_segment", opn$transactions_per_rollback_segment )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("disk_asynch_io", opn$disk_asynch_io )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("filesystemio_options", opn$filesystemio_options )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checking", opn$db_block_checking )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checksum", opn$db_block_checksum )
if ( rc != 0 ) {  v_rc=1 }

if ( rc!=0 ) {
 cat( paste(v_moduli," nuk mund të startojmë db me atë vektor të parametrave",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("immediate")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=stop_db("immediate")
rc=start_db("")
if ( rc!=0 ) {
 cat( paste(v_moduli," nuk mund të startojmë db me atë vektor të parametrave",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("abort")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=run_test()
v_metrika=getmetric()

rc=stop_db("immediate")
rc=create_spfile()
rc=start_db("")
rc=remove_additional_rgroups(opn)

cat( paste("rezultati: ",v_metrika," ",v_vektori,sep="") , file=v_logfile, sep="n", append=T)
return (v_metrika)
}
Pra të gjitha punët: bëhen në funksionin e fitnesit.
nënprogrami ga, kryen përpunimin e vektorëve, ose më mirë të themi — kromozomëve.
Atje, na intereson më së shumti: selektimi i kromozomëve me gjenet të tillë, kur funksioni i fitnesit jep vlera të mëdha.
Në thelb, kjo është procedura e kërkimit të grupit optimal të kromozomëve me një vektor në hapësirën N-dimensional të kërkimit.
Mjaft e qartë, e detajuar , me shembuj të kodit R, të funksionit të algoritmit gjenetik.
Dua të theksoj dy aspekte teknik.
Thirrjet ndihmëse, nga funksioni evaluate, për shembull ndalimi-ngritja, caktimi i vlerës së parametrit të DB, kryhen në bazë të cran-r funksionit system2
Me anë të cilit: thirret ndonjë skript bash, ose komandë.
Për shembull:
set_db_parameter
set_db_parameter=function(p1, p2) {
v_module="set_db_parameter"
v_cmd="/home/oracle/testingredotracе/set_db_parameter.sh"
v_args=paste(p1," ",p2,sep="")

x=system2(v_cmd, args=v_args, stdout=T, stderr=T, wait=T)
if ( length(attributes(x)) > 0 ) {
 cat(paste(v_module," dështoi me: ",attributes(x)$status," ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (attributes(x)$status)
}
else {
 cat(paste(v_module," ok: ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (0)
}
}
Momenti i dytë — rreshti, evaluate i funksionit, me ruajtjen e vlerës specifike të metrikës dhe vektorit përkatës të konfigurimit, në skedarin e logut:
cat(paste("rezultati: ",v_metric," ",v_vector,sep=""), file=v_logfile, sep="n", append=T)Kjo është e rëndësishme, sepse nga ky array të dhënash, mund të marrim informacion shtesë se cilit nga komponentët e vektorit të konfigurimit i ndikon më shumë, ose më pak në vlerën e metrikës.
Domethënë: mund të realizojmë një analizë të rëndësisë së atributit.
Pra, çfarë mund të rezultojë.
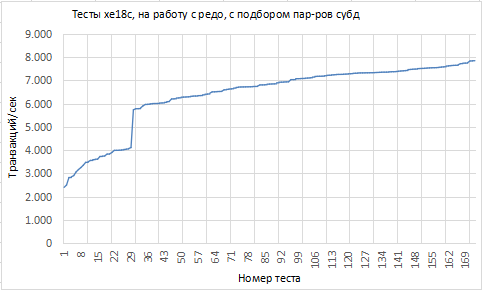
Në formën e një grafiku, nëse rendisim testet sipas rritjes së metrikës, pamja është kështu:
Disa të dhëna që përkojnë me vlerat ekstreme të metrikës:
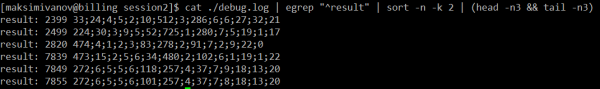
Këtu, në screenshot-in me rezultatet, sqaroj: vlerat e vektorit të konfigurimit — janë dhënë në terma të kodit të funksionit të fitnesit, jo në terma të listës numër parametrash/intervaleve të vlerave të parametrave që kam formulua më lart në tekst.
Pra. Kjo është shumë ose pak, ~8 mijë tps: është një çështje e veçantë.
Në kuadër të punës laboratorike — nuk ka rëndësi kjo shifër, rëndësishme është dinamika, si ndryshon kjo vlerë.
Dinamika këtu është e mirë.
Qartë, që, të paktën një faktor, që ndikon ndjeshëm në vlerën e metrikës, algoritmi ga, duke kaluar nëpër vektorët-kromozome: e mbuloi.
Duke me sa dinamika mjaft energjike të vlerave të kurbës, ka të paktën një faktor tjetër që, ndonëse duket më i vogël, ndikon.
Këtu nevojitet attribute-importance analizë për të kuptuar: cilat atribute (në këtë rast — komponentët e vektorit të konfiguar) dhe sa fort ndikon në vlerën e metrikës.
Dhe nga kjo informacion: kuptohet — cilat faktorë janë prekur nga ndryshimet e atributeve të rëndësishme.
Kryej attribute-importance mund të bëhet në mënyra të ndryshme.
Mua, për këto qëllime, më pëlqen algoritmi randomForest i paketës R me të njëjtin emër ()
randomForest, siç e kuptoj unë funksionimin e tij në përgjithësi dhe qasjen e tij për vlerësimin e rëndësisë së atributeve në veçanti, ndërt ton një model të varësisë mes variablit reagues dhe atributeve.
Në rastin tonë, variabli reagues është metrika e marrë nga bazat e të dhënave, në testet e ngarkesës: tps;
Dhe atributet janë komponentët e vektorit të konfiguar.
Pra, randomForest vlerëson rëndësinë e secilit atribut të modelit me dy numra: %IncMSE — si prania/ose mungesa e këtij atributi, në model, ndryshon cilësinë e MSE të këtij modeli (Mean Squared Error);
Dhe IncNodePurity — është një numër që tregon se sa mirë, sipas vlerave të këtij atributi, mund të ndahet grupi i të dhënave me vëzhgime, në mënyrë që në një pjesë të ishin të dhënat me një vlerë të caktuar të metrikës së shpjeguar, dhe në tjetrën me një tjetër vlerë të metrikës.
Pra, sa i klasifikueshëm është ky atribut (shpjegimi më i qartë në gjuhën ruse për random forest e kam parë ).
Kodi R për punimin me grupin e të dhënave të rezultateve të testeve të ngarkesës:
x=NULL
v_data_file=paste('\/tmp\/data1.dat',sep="")
x=read.table(v_data_file, header = TRUE, sep = ";", dec=",", quote = ""'", stringsAsFactors=FALSE)
colnames(x)=c('metric','rgsize','rgcount','lamp','cmtl','cmtw','lgbffr','lct','dbwrp','undo_retention','tprs','disk_async_io','filesystemio_options','db_block_checking','db_block_checksum')

idxTrain=sample(nrow(x),as.integer(nrow(x)*0.7))
idxNotTrain=which(! 1:nrow(x) %in% idxTrain )
TrainDS=x[idxTrain,]
ValidateDS=x[idxNotTrain,]

library(randomForest)
#mtry=as.integer( sqrt(dim(x)[2]-1) )
rf=randomForest(metric ~ ., data=TrainDS, ntree=40, mtry=3, replace=T, nodesize=2, importance=T, do.trace=10, localImp=F)
ValidateDS$predicted=predict(rf, newdata=ValidateDS[,colnames(ValidateDS)!="metric"], type="response")
sum((ValidateDS$metric-ValidateDS$predicted)^2)
rf$importance
Mund ta bëni drejtpërdrejt duke përcaktuar hiperparametrat e algoritmit dhe, duke u orientuar nga cilësia e modelit, të zgjidhni modelin që bën parashikime më të sakta në grupin validues.
Mund të shkruani një funksion për këtë punë (për shëmbull — përsëri, sipas një algoritmi optimizimi).
Mund të përdorni paketën R caret, nuk është çështje e rëndësishme.
Si rezultat, në këtë rast, merrni një rezultat të tillë për vlerësimin e rëndësisë së atributeve:
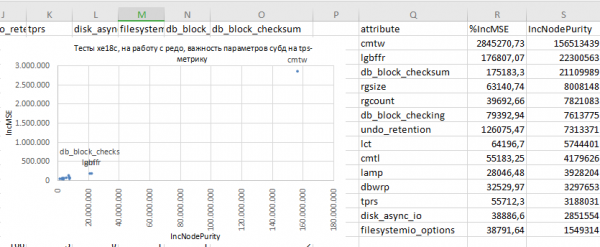
Pra, mund të fillojmë me kuptimet globale:
- Pra, rezulton se parametri më i rëndësishëm, në këto kushte testimi, është
commit_wait
Teknikisht, ai përcakton mënyrën e ekzekutimit të operacioneve io të shkruara të të dhënave redo, nga buffer-i log të bazës së të dhënave, në grupin aktual të revizimeve: sinkron ose asinkron.
Vleranowaitnën të cilat ndodh një rritje praktikisht vertikale dhe e shumëfishuar e metrikës tps: kjo përfshin aktivizimin e modit asinkron io në grupet redo.
Një çështje e veçantë është nëse duhen ose jo bërë kështu në databazën e prodhimit. Këtu, unë kufizohem vetëm në vërejtjen: ky është një faktor i rëndësishëm. - Logjikisht, madhësia e log-buffer-it të bazës së të dhënave: rezulton të jetë një faktor i rëndësishëm.
Sa më e vogël të jetë madhësia e log-buffer-it, aq më pak është kapaciteti i tij mbajtës, aq më shpesh ndodhin mbingarkesa dhe/ose pamundësia për të ndarë një hapësirë të lirë për një sasi të re të dhënash redo.
Dhe, pra: vonesat e lidhura me alokimin e hapësirës në log-buffer dhe/ose heqjen e të dhënave redo nga ai në grupet redo.
Këto vonesa, sigurisht, duhet të ndikojnë dhe ndikojnë në kapacitetin e bazës së të dhënave në transaksione. - Parametri
db_block_checksum: pra, gjithashtu, e gjithë kjo është e qartë — përpunimi i transaksioneve çon në formimin e blloqeve dirty në cache-in buffer të bazës së të dhënave.
Të cilat, me verifikimin e kontrollit të checksum-eve të blloqeve të të dhënave, bazohet në nevojën për t'i përpunuar — për të llogaritur këto checksum-e nga trupi i bllokut të të dhënave, dhe për të krahasuar ato me ato që janë shkruar në header-in e bllokut të të dhënave: përputhen/nuk përputhen.
Kjo punë, përsëri, nuk mund të mos vonojë përpunimin e të dhënave, dhe për rrjedhojë, parametri dhe mekanizmi që përcakton këtë parametrin — dalin të jenë të rëndësishëm.
Për këtë arsye, furnizuesi sugjeron, në dokumentacionin për këtë parametrin, vlera të ndryshme për të (parametrin) dhe thekson që — po, do të ketë ndikim, por, këtu, vlera të ndryshme, deri në "çaktivizuar" dhe ndikim të ndryshëm, mund të zgjidhni.
Dhe një përfundim global.
Qasja, në përgjithësi, rezulton të jetë mjaft funksionale.
Ajo lejon, në fazat e hershme të testimit të ngarkesës të ndonjë sistemi shërbimi, për të zgjedhur konfigurimin optimal të tij (sistemit) nën ngarkesë pa u thelluar shumë në veçoritë e konfigurimit të sistemit për ngarkesë.
Por më në fund nuk përjashton fare — të paktën në nivelin e kuptimit: "rregullat e rregullimit" dhe kufijtë e lejuar të rrotullimeve të këtyre rregullave, sistemi duhet të dijë.
Më pas, qasja mund të gjejë relativisht shpejt konfigurimin optimal të sistemit.
Dhe mund të marrim, në përfundim të testeve, informacion mbi natyrën e lidhjes midis metrikës së cilësisë së punës së sistemit dhe vlerave të parametrave të rregullimit të sistemit.
Kjo, natyrisht, duhet të ndihmojë në krijimin e këtij kuptimi të thellë të sistemit, punës së tij, së paku — nën këtë ngarkesë.
Praktikisht, kjo është: ndarja e kostove për të thelluar vëmendjen në sistemin e rregullueshëm, për kostot për përgatitjen e një testi të tillë të punës së sistemit.
Veçoj se në këtë qasje — është thelbësore rëndësia e përshtatshmërisë së testimit të sistemit ndaj kushteve të punës që do të ketë në përdorimin e tij në prodhim.
Faleminderit për vëmendjen tuaj, kohën.
Burimi: habr.com
