

Me databazën Apache Cassandra dhe nevojën për ta përdorur atë në infrastrukturën e bazuar në Kubernetes, ne shpesh përballemi. Në këtë material, do të ndajmë vështrimin tonë mbi hapat e nevojshëm, kriteret dhe zgjidhjet ekzistuese (përfshirë një përmbledhje të operatorëve) për migrimin e Cassandra në K8s.
«Kush mund të menaxhojë një grua, do të përballojë edhe me shtetin»
Kush është Cassandra? Ajo është një sistem i shpërndarë për ruajtjen e të dhënave, i destinuar për menaxhimin e volumit të madh të të dhënave, duke siguruar një disponibilitet të lartë pa një pikë të vetme dështimi. Projekti pothuajse nuk ka nevojë për një prezantim të gjatë, prandaj do të përmend vetëm veçoritë kryesore të Cassandra-s që do të jenë relevante për këtë artikull:
- Cassandra është shkruar në Java.
- Topologjia e Cassandra përfshin disa nivele:
- Nod — një instancë e shpërndarë e Cassandra-s;
- Rack — një grup instancash Cassandra, të bashkuara sipas një kriteri, që ndodhen në një qendër të të dhënave;
- Qendra e të Dhënave — një përmbledhje e të gjitha grupeve të instancave Cassandra që ndodhen në një qendër të të dhënave;
- Klastri — një përmbledhje e të gjitha qendrave të të dhënave.
- Për identifikimin e nodit, Cassandra përdor adresën IP.
- Për shpejtësinë e operacioneve të shkruarjes dhe leximit, një pjesë e të dhënave Cassandra ruan në memorie.
Tani, le të flasim për migrimin në Kubernetes.
Listë kontrolli për transferimin
Kur flasim për migrimin e Cassandra në Kubernetes, ne shpresojmë që me migrimin menaxhimi i saj do të bëhet më i lehtë. Çfarë është e nevojshme për këtë, çfarë do ta ndihmojë?
1. Ruajtja për të dhënat
Siç është theksuar, një pjesë e të dhënave Cassandra ruhet në memorie — në Memtable. Por ka edhe një pjesë tjetër të të dhënave, që ruhet në disk, — në formën e SSTable. Kësaj i shtohet entiteti Commit Log — regjistrime mbi të gjitha transaksionet, që gjithashtu ruhen në disk.
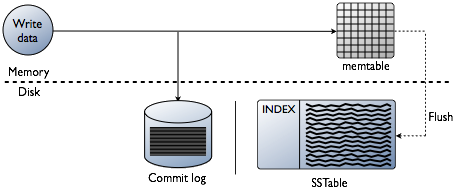
Schema e transaksioneve të shkruarjes në Cassandra
Në Kubernetes, ne mund të përdorim për ruajtjen e të dhënave PersistentVolume. Falë mekanizmave të provuar, të punuarit me të dhënat në Kubernetes bëhet gjithnjë e më e lehtë çdo vit.
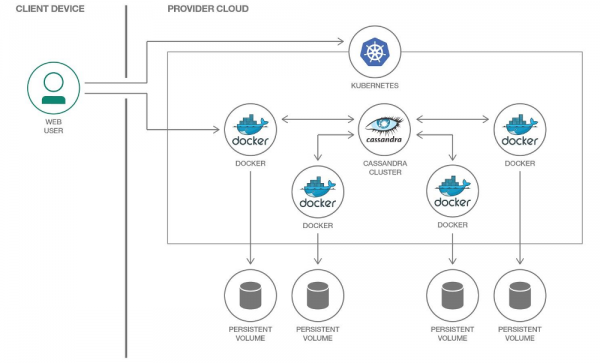
Çdo pod me Cassandra do t'i rezervojmë një PersistentVolume të vetin
Është e rëndësishme të theksohet se Cassandra në vetvete nënkupton replikimin e të dhënave, duke ofruar për këtë mekanizma të integruar. Prandaj, nëse po krijoni një grup Cassandra nga një numër të madh nyjesh, nuk ka nevojë të përdorni për ruajtjen e të dhënave sisteme të shpërndara si Ceph ose GlusterFS. Në këtë rast, do të ishte logjike të ruani të dhënat në diskun e nyjes duke përdorur ose montimin hostPath.
Një çështje tjetër është, nëse dëshironi të krijoni një mjedis të veçantë për çdo degë funksionaliteti për zhvilluesit. Në këtë rast, qasja e duhur do të ishte ngritja e një nyjeje Cassandra dhe ruajtja e të dhënave në një depo të shpërndarë, dmth, Ceph dhe GlusterFS të përmendura do të bëhen opsionet tuaja. Kështu, zhvilluesi do të jetë i sigurt se nuk do të humbasë të dhënat testuese madje edhe në rast se humbet një nga nyjet e grupit Kubernetes.
2. Monitorimi
Zgjedhja praktike e bezdisur për realizimin e monitorimit në Kubernetes është Prometheus (në detaje kemi folur për këtë në ). Si shkon me Cassandra për eksportuesit e metrikeve për Prometheus? Dhe, që ndoshta është më e rëndësishme, me dashboard-et e përshtatshme për to në Grafana?
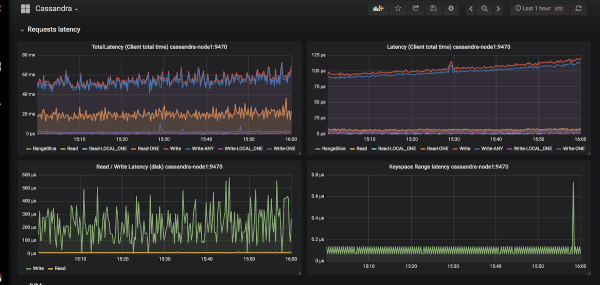
Shembujt e pamjes së grafikëve në Grafana për Cassandra
Ekspeditorët janë gjithsej dy: dhe .
Ne zgjodhëm të parin për vete, sepse:
- JMX Exporter po rritet dhe po zhvillohet, ndërsa Cassandra Exporter nuk arriti të marrë mbështetje të mjaftueshme nga komuniteti. Cassandra Exporter ende nuk mbështet shumicën e versioneve të Cassandra.
- Mund ta nisim si javaagent duke shtuar flamurin
-javaagent:emri-i-plugin-dir\/cassandra-exporter.jar=--listen=:9180. - Për të ka , i cili nuk është i përputhshëm me Cassandra Exporter.
3. Zgjedhja e primitiveve Kubernetes
Sipas strukturës së mësipërme të grupit Cassandra, le të përpiqemi të përkthim gjithçka që është përshkruar atje në terminologjinë Kubernetes:
- Cassandra Node → Pod
- Cassandra Rack → StatefulSet
- Cassandra Datacenter → një grup StatefulSets
- Cassandra Cluster → ???
Kështu, duket se na mungon ndonjë entitet shtesë për të menaxhuar tërë grupin Cassandra njëkohësisht. Por nëse mungon diçka, ne mund ta krijojmë atë! Në Kubernetes, për këtë është paraparë mekanizmi i përcaktimit të burimeve të personalizuara — .
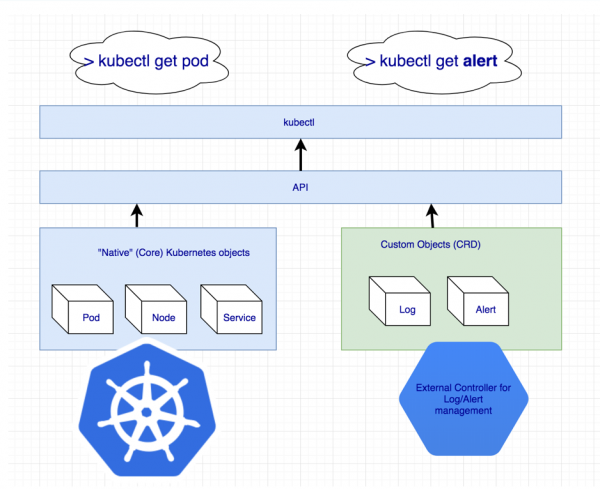
Deklarata e burimeve shtesë për logët dhe alarmet
Por vetë Custom Resource nuk ka asnjë kuptim: sepse për të nevojitet një kontroller. Ndoshta do të duhet të kërkojmë ndihmën e …
4. Identifikimi i pod’ave
Si e rënë në dakord më lart që një nyjë Cassandra do të barazohet me një pod në Kubernetes. Por adresat IP të pod’ave do të jenë çdo herë të ndryshme. Identifikimi i nyjës në Cassandra ndodh pikërisht mbi bazën e adresës IP... Kështu, pas çdo fshirjeje të një pod’i, klasteri i Cassandra do të shtojë një nyjë të re.
Ka një zgjidhje, dhe jo vetëm një:
- Mund të monitorojmë identifikuesit e hostëve (UUID’ave, që identifikojnë në mënyrë unike instancat e Cassandra) ose adresat IP dhe ta ruajmë këtë në struktura/tabela. Ky metod ka dy disavantazhe kryesore:
- Rreziku i shfaqjes së një kushti garues kur bien papritur dy nyje. Pasi të ngrihen, nyjet e Cassandra do të kërkojnë menjëherë një adresë IP nga tabela dhe do të konkurrojnë për të njëjtin burim.
- Nëse një nyjë Cassandra ka humbur të dhënat e saj, nuk do të mund ta identifikojmë më.
- Zgjidhja e dytë duket si një hile e vogël, por megjithatë: mund të krijojmë Shërbime me ClusterIP për secilën nyjë Cassandra. Problemet e kësaj zbatimi:
- Nëse klasteri i Cassandra ka shumë nyje, do na duhet të krijojmë shumë Shërbime.
- Mundësia e ClusterIP realizohet përmes iptables. Kjo mund të bëhet një problem, nëse në klasterin Cassandra ka shumë (1000… apo madje 100?) nyje. Megjithatë, mund ta zgjidhë këtë problem.
- Zgjidhja e tretë është të përdorim rrjetin e nyjeve për nyjet Cassandra në vend të një rrjeti të veçantë pod’ash duke aktivizuar parametrin
hostNetwork: true. Ky metod imponon disa kufizime:- Këto janë në lidhje me zëvendësimin e nyjeve. Nevojitet që një nyjë e re të ketë patjetër të njëjtën adresë IP si ajo e mëparshme (në shërbime si AWS, GCP, kjo është praktikisht e pamundur);
- Duke përdorur rrjetin e nyjeve të klasterit, fillojmë të konkurrojmë për burimet rrjetërore. Prandaj, është problematike të vendosim më shumë se një pod me Cassandra në një nyjë të klasterit.
5. Bëkaps
Dëshirojmë të ruajmë një version të plotë të të dhënave të një nyjeje Cassandra sipas një programi. Kubernetes ofron një mundësi të përshtatshme duke përdorur , por këtu Cassandra na pengon.
Të kujtojmë se një pjesë e të dhënave të Cassandra ruhet në memorie. Për të bërë një bëkap të plotë, është e nevojshme që të dhënat nga memoria (Memtables) të transferohen në disk (SSTables). Në këtë moment, nyja Cassandra ndalon së pranoni lidhje, duke u çaktivizuar krejtësisht nga klasteri.
Pas kësaj, bëkapi merret (snapshot) dhe ruhet skema (keyspace). Dhe këtu del se sa thjeshtë backup nuk na jep asgjë: është e nevojshme të ruajmë identifikuesit e të dhënave për të cilat përgjigjet nyja Cassandra, — këto janë toka speciale.
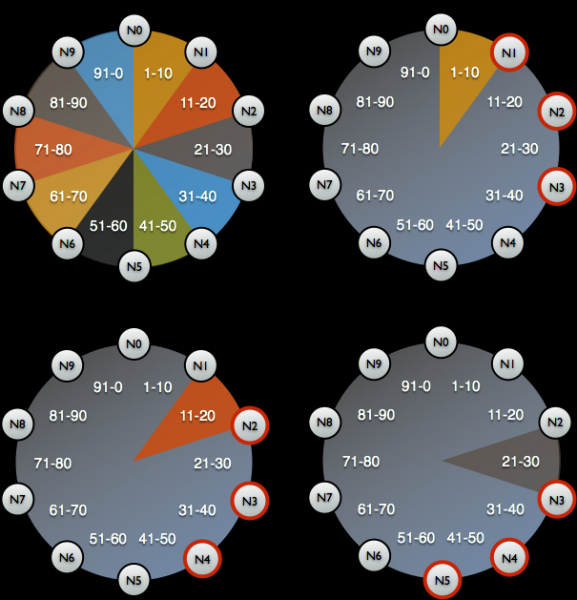
Shpërndarja e tokave për identifikimin e të dhënave për të cilat përgjigjen nyjet Cassandra
Një shembull skripti për marrjen e backup-it të Cassandra nga Google në Kubernetes mund të gjendet në . Një moment i vetëm që skripti nuk e merr parasysh është se duhen zeruar të dhënat në nyjë para se të bëhet snapshot. Kështu, backup bëhet jo për gjendjen aktuale, por për një gjendje pak më parë. Por kjo ndihmon që të mos e nxjerrim nyjën nga puna, që duket shumë logjike.
set -eu

if [[ -z "$1" ]]; then
  info "Ju lutemi jepni një keyspace"
  exit 1
fi

KEYSPACE="$1"

result=$(nodetool snapshot "${KEYSPACE}")

if [[ $? -ne 0 ]]; then
  echo "Gabim gjatë krijimit të snapshot"
  exit 1
fi

timestamp=$(echo "$result" | awk '"/Snapshot directory: / { print $3 }')

mkdir -p "/tmp/backup"

for path in $(find "/var/lib/cassandra/data/${KEYSPACE}" -name $timestamp); do
  table=$(echo "${path}" | awk -F "[/-]" '{print $7}')
  mkdir "/tmp/backup/$table"
  mv $path "/tmp/backup/$table"
done


tar -zcf "/tmp/backup.tar.gz" -C "/tmp/backup" .

nodetool clearsnapshot "${KEYSPACE}"
Një shembull bash-skripti për marrjen e backup-it nga një nyjë Cassandra
Zgjidhje të gatshme për Cassandra në Kubernetes
Çfarë përdorin aktualisht për implementimin e Cassandra në Kubernetes dhe çfarë nga këto është më e përshtatshme për kërkesat e vendosura?
1. Zgjidhjet e bazuara në StatefulSet ose Helm-charts
Përdorimi i funksioneve bazë të StatefulSets për të nisur një klaster Cassandra është një opsion i mirë. Me anë të Helm-chart dhe shablloneve Go, mund të ofrohet një ndërfaqe fleksibël për përdoruesin për implementimin e Cassandra.
Shpesh kjo funksionon mirë… derisa të ndodhë diçka e papritur — siç është dështimi i një nyje. Mjetet standarde të Kubernetes thjesht nuk mund të marrin parasysh të gjitha karakteristikat e përshkruara më sipër. Për më tepër, ky qasje është shumë e kufizuar në mënyrën se si mund të zgjerohet për përdorime më kompleks: zëvendësimi i nyjeve, backup, rikuperim, monitorim etj.
Përfaqësuesit:
- ;
- .
Të dy çartit janë po aq të mira, por janë të ndjeshme ndaj problemeve të përshkruara më sipër.
2. Zgjidhjet e bazuara në Kubernetes Operator
Këto opsione janë më interesante, sepse ofrojnë mundësi të shumta për menaxhimin e klasterit. Për projektuara operatorin Cassandra, si çdo bazë tjetër të dhënash, një model i mirë duket si Sidecar Controller CRD:
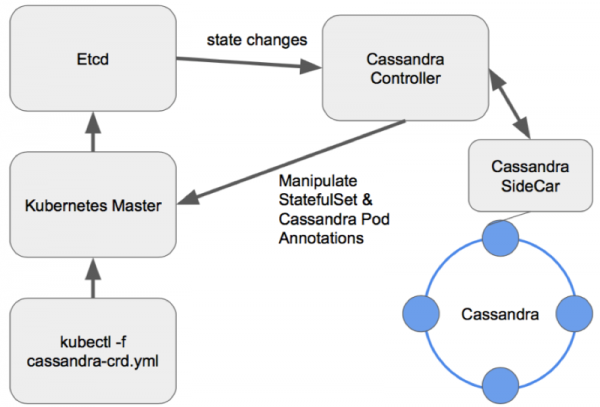
Schema e menaxhimit të nyjeve në një operator Cassandra të projektuara mirë
Le të shqyrtojmë operatorët ekzistues.
1. Cassandra-operator nga instaclustr
- Gatishmëri: Alpha
- Licenca: Apache 2.0
- I realizuar në: Java
Ky është vërtet një projekt shumë premtues dhe aktivisht në zhvillim nga një kompani që ofron implementime të menaxhuara të Cassandra. Ai, ashtu siç përshkruhet më lart, përdor një konteiner sidecar që merr komanda përmes HTTP. I shkruar në Java, ndaj ndonjëherë i mungon funksionaliteti më i avancuar i bibliotekës client-go. Gjithashtu, operatori nuk mbështet Rack të ndryshme për një Datacenter.
Sidoqoftë, operatori ka avantazhe si mbështetje për monitorimin, menaxhimin e nivelit të lartë të klasterit përmes CRD dhe madje dokumentacion mbi krijimin e kopjeve rezervë.
2. Navigator nga Jetstack
- Gatishmëri: Alpha
- Licenca: Apache 2.0
- I realizuar në: Golang
Operatori, i destinuar për shpërndarjen e DB-as-a-Service. Aktualisht mbështet dy baza të dhënash: Elasticsearch dhe Cassandra. Ka disa zgjidhje interesante, si kontrolli i qasjes në bazën e të dhënave përmes RBAC (për këtë ngrihet një navigator-apiserver i veçantë). Një projekt interesant, të cilin do të ishte e këshillueshme ta shqyrtojmë, megjithatë komiti i fundit u bërë një vit e gjysmë më parë, gjë që e ul qartë potencialin e tij.
3. Cassandra-operator nga vgkowski
- Gatishmëri: Alpha
- Licenca: Apache 2.0
- I realizuar në: Golang
Nuk e morëm atë «seriozisht», pasi komiti i fundit në repozitor u bë më shumë se një vit më parë. Zhvillimi i operatorit është braktisur: versioni më i fundit i Kubernetes, i shpallur si i mbështetur, është 1.9.
4. Cassandra-operator nga Rook
- Gatishmëri: Alpha
- Licenca: Apache 2.0
- I realizuar në: Golang
Operatori, zhvillimi i të cilit nuk po shkon aq shpejt sa do të dëshironim. Ka një strukturë të mirëmenduar CRD për menaxhimin e klasterit, zgjidh problemin me identifikimin e nyjeve përmes Shërbimit me ClusterIP (ai «hack»)... por deri tani kjo është gjithçka. Monitorimi dhe kopjet rezervë nga kutia aktualisht nuk janë aty (për të cilat, në fakt, ne ). Një pikë interesante, është se me këtë operator është gjithashtu e mundur të implementohet ScyllaDB.
NB: Ky operator, me disa përmirësime të vogla, e kemi përdorur në një nga projektet tona. Nuk janë vërejtur probleme në funksionimin e operatorit gjatë gjithkohëzgjatjes (~4 muaj punë).
5. CassKop nga Orange
- Gatishmëri: Alpha
- Licenca: Apache 2.0
- I realizuar në: Golang
Operatori më i ri në listë: komiti i parë u bë më 23 maj 2019. Tani ka tashmë një numër të madh funksionesh nga lista jonë, me të cilat mund të njihemi në repozitorin e projektit. Operatorishtë ndërtuar mbi bazën e operator-sdk të njohur. Mbështet monitorimin «nga kutia». Dallimi kryesor nga operatorët e tjerë është përdorimi , implementuar në Python dhe i përdorur për komunikim midis nyjeve Cassandra.
Përfundimet
Numri i afrove dhe mundësive të transferimit të Cassandra në Kubernetes flet vetë: tema është e kërkuar.
Në këtë fazë, mund të provoni diçka nga ajo që përmendet më sipër me rrezikun tuaj: asnjë nga zhvilluesit nuk garanton një punë 100%-sh në ambientin e prodhimit. Por tashmë shumë produkte duken premtuese për t'u provuar në stallat për zhvillim.
Mendoj se në të ardhmen, kjo grua në anije do të jetë në vendin e duhur!
P.S.
Lexoni gjithashtu në blogun tonë:
- «»;
- «»;
- «»;
- «».
Burimi: habr.com
