

Hyrje
Pak sa kohë më parë më është dhënë detyra për të zhvilluar një grup klaster të qëndrueshëm për , që punon në disa qendra të të dhënave të lidhura me fibra optike brenda një qyteti, dhe në gjendje të përballojë dështimin (p.sh., çmendje të energjisë) të një qendre të të dhënave. Si softuer që përgjigjet për qëndrueshmërinë, kam zgjedhur , sepse kjo është zgjidhja zyrtare nga RedHat për krijimin e grupeve klaster të qëndrueshme. Ajo është e mirë sepse RedHat ofron mbështetje për të, dhe sepse kjo zgjidhje është universale (modulare). Me ndihmën e saj do të jetë e mundur të sigurohet qëndrueshmëria jo vetëm për PostgreSQL, por edhe për shërbime të tjera, duke përdorur module standarde ose duke i krijuar ato për nevoja specifike.
Në këtë zgjidhje ka lindur një pyetje e arsyeshme: sa e qëndrueshme do të jetë klasteri i qëndrueshëm? Për ta shqyrtuar këtë, kam zhvilluar një platformë testuese që imiton dështime të ndryshme në nyjat e klasterit, pret rikthimin në funksionim, rikthen nyjën e dështuar dhe vazhdon testimin në cikël. Fillimisht ky projekt ishte quajtur hapgsql, por me kalimin e kohës më është bërë e mërzitshme emri, në të cilin kishte vetëm një zanore. Prandaj, bazat e të dhënave të qëndrueshme (dhe IP e peshkuar të cilat i tregojnë ato) fillova t'i quaj krogan (karakter nga një lojë kompjuterike, ku të gjithë organet e rëndësishme janë të dyfishuara), ndërsa nyjat, klasteret dhe vetë projekti janë quajtur tuchanka (planeti ku jetojnë kroganët).
Tani drejtuesit lejuan . README do të përkthhet në anglisht së shpejti (sepse pritet që konsumatorët kryesorë të jenë zhvilluesit e Pacemaker dhe PostgreSQL), dhe versioni i vjetër në rus të README e kam vendosur ta organizoj (pjesërisht) në formën e këtij artikulli.
Klasterët krijohen në virtualka . Në total do të krijohen 12 virtualka (në total 36GiB), të cilat do të formojnë 4 grupe klaster të qëndrueshme (versione të ndryshme). Dy klasterët e parë përbëhen nga dy servera PostgreSQL, të cilët vendosen në qendra të ndryshme të të dhënave, dhe një server i përbashkët witness c quorum device (i vendosur në një virtualke të lirë në qendrën e tretë të të dhënave), i cili zgjidh pasigurinë 50%/50%, duke i dhënë votën e tij njërit nga palët. Klasteri i tretë është në tre qendra të të dhënave: një master, dy skllavë, pa quorum device. Klasteri i katërt përbëhet nga katër serverë PostgreSQL, dy në çdo qendër të të dhënave: një master dhe të tjerët replika, dhe gjithashtu përdor witness c quorum device. Katri i katërt mbulon dështimin e dy serverëve ose të një qendre të të dhënave. Ky zgjidhje mund të zgjeroheshe në një numër më të madh replikash, nëse është e nevojshme.
Shërbimi i kohës së saktë gjithashtu është konfigurue për qëndrueshmëri, por atje përdoren metoda e vet ntpd (orphan mode). Serveri i përgjithshëm witness luan rolin e serverit qendror NTP, duke shpërndarë kohën e tij për të gjithë klasterët, duke sinkronizuar kështu të gjithë serverët mes tyre. Nëse witness dështon ose është i izoluar, atëherë një nga serverët e klasterit do të fillojë të shpërndajë kohën e tij (brenda klasterit). Një HTTP proxy gjithashtu është ngritur në witness, me ndihmën e të cilës virtualkat e tjera kanë qasje në depozitë Yum. Në realitet, shërbime të tilla si koha e saktë dhe proxy, me siguri do të vendosen në serverë të dedikuar, por në skenë ato janë vendosur në witness vetëm për kursimin e numrit të virtualkave dhe hapësirës.
Versionet
v0. Punon me CentOS 7 dhe PostgreSQL 11 në VirtualBox 6.1.
Struktura e klasterëve
Të gjitha klasterët janë të destinuar për t'u vendosur në disa qendra të të dhënave, të lidhura në një rrjet të sheshtë dhe duhet të mbështesin dështimin ose izolimin rrjetor të një qendre të të dhënave. Prandaj nuk është i mundur përdoret për të mbrojtur nga split-brain teknologji standarde Pacemaker, e quajtur STONITH (Shoqërimi i Një Njësie Tjetër në Kokë) ose fencing. Esenca e saj është: nëse nyjet në klaster fillojnë të dyshojnë se ndonjë nyje ka ndodhur diçka e çuditshme, nuk përgjigjet ose sillen në mënyrë jo korrekte, ato e çaktivizojnë atë përmes pajisjeve 'të jashtme', për shembull, kartën kontrolluese IPMI ose UPS. Por kjo do të funksionojë vetëm në rastet kur, në rast dështimi të vetëm të serverit, IPMI ose UPS vazhdojnë të funksionojnë. Këtu, gjithashtu parashikohet mbrojtja nga një dështim shumë më katastrofik, kur dështojnë (p.sh. dështojnë në energji) e gjithë qendra e të dhënave. Në rast të një dështimi të tillë, të gjitha stonith- pajisjet (IPMI, UPS etj.) gjithashtu nuk do të funksionojnë.
Në vend të kësaj, sistemi bazohet në idenë e kvorumit. Të gjitha nyjet kanë një zë, dhe mund të punojnë vetëm ato që shohin më shumë se gjysmë në të gjitha nyjet. Ky numër 'gjysmë+1' quhet kuorum. Nëse nuk arrin të arrihet kvorumi, atëherë nyja vendos se ndodhet në izolim rrjetor dhe duhet të çaktivizojë burimet e saj, pra është një mbrojtje nga split-brain. Nëse softi që përgjigjet për këtë sjellje nuk funksionon, atëherë duhet të aktivizohet watchdog, për shembull, në bazë të IPMI.
Nëse numri i nyjeve është çift (klaster në dy data center), atëherë mund të lindë një pasiguri e tillë e quajtur. 50%/50% (pesëdhjetë për pesëdhjetë), kur izolimi rrjetor ndan klasterin pikërisht në mes. Prandaj, për numër të barabartë nyjesh, shtohet. quorum device — një demon i padëshirueshëm, i cili mund të konceptohet në makinën virtuale më të lirë në data center e tretë. Ai i jep votën njërit prej segmenteve (që sheh) dhe kështu zgjidh pasigurinë 50%/50%. Serveri ku do të aktivizohet pajisja e quorum, unë e quajta. witness (terminologji nga repmgr, më pëlqeu).
Burimet mund të lëvizin nga një vend në tjetrin, për shembull, nga serverët e prishur në ato të rregullt, ose me urdhër nga administratoret e sistemeve. Që klientët të dinë se ku ndodhen burimet që u nevojiten (ku duhet të lidhen?), përdoren. IP të lëvizshme (float IP). Këto janë IP që Pacemaker mund t'i lëvizë mes nyjeve (të gjitha ndodhen në një rrjet të sheshtë). Çdora një prej tyre simbolizon një burim (shërbim) dhe do të jetë aty ku duhet të lidheni për të pasur qasje në këtë shërbim (në rastin tonë, DB).
Tuchanka1 (skema me ngjeshje)
Struktura
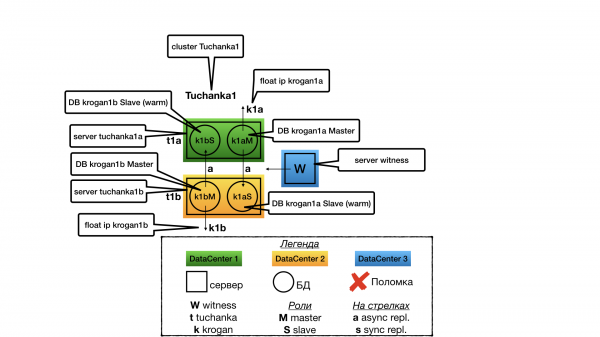
Ideja ishte që kishim shumë baza të vogla të dhënash me ngarkesë të ulët, për të cilat nuk është e leverdishme të mbash një server të dedikuar slave në modalitetin hot standby për transaksionet read only (nuk ka nevojë për një shpërdorim të tillë burimesh).
Në çdo qendër të të dhënave ka një server. Në çdo server ka dy instanca PostgreSQL (në terminologjinë e PostgreSQL ato quhen klastere, por për të shmangur konfuzionin do t'i quaj instanca (në përputhje me DB të tjera), ndërsa klastere do t'i quaj vetëm klasteret Pacemaker). Një instancë punon si master dhe vetëm ajo ofron shërbime (vetëm ajo ka IP flotante). Instanca tjetër punon si skllave për qendrën e dytë të të dhënave dhe do të ofrojë shërbime vetëm nëse masteri bie. Duke qenë se për të shumtën e kohës do të ofrohet shërbim (do të ekzekutohen kërkesa) vetëm nga një instancë nga dy (master), të gjitha burimet e serverit optimizohen për master (kapaciteti dedikohet për kesh shared_buffers etj.), por gjithashtu kur është e nevojshme, ka burime të mjaftueshme edhe për instancën tjetër (edhe nëse për një punë jo optimale përmes keshit të sistemit të skedarëve) për rastin e dështimit të njërit nga qendrat e të dhënave. Skllavi nuk ofron shërbime (nuk ekzekuton kërkesa vetëm për lexim) gjatë funksionimit normal të klasterit, për të shmangur luftën për burimet me masterin në të njëjtin server.
Në rastin e dy nyjave, qëndrueshmëria ndaj dështimeve është e mundur vetëm me replikim asinkron, sepse në rastin e replikimit sinkron, dështimi i skllavit do të çonte në ndalimin e masterit.
Dështimi i witness
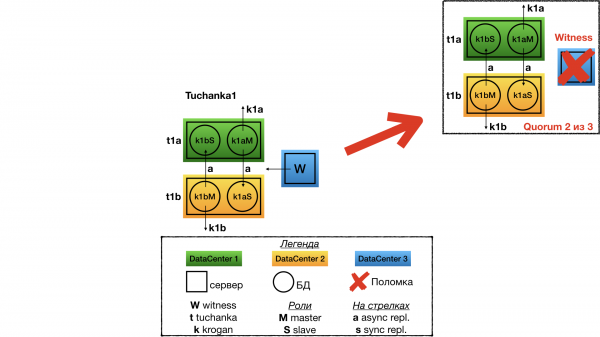
Dështimi i witness (quorum device) do ta shqyrtoj vetëm për klasterin Tuchanka1, me të gjitha të tjerët do të jetë e njëjta histori. Në rast dështimi të witness, struktura e klasterit nuk do të ndryshojë, gjithçka do të vazhdojë të funksionojë siç ka punuar. Por kvorumi do të bëhet 2 nga 3, dhe për këtë arsye çdo dështim tjetër do të bëhet fatal për klasterin. Sidoqoftë, do të duhet të riparoni urgjentisht.
Dështimi i Tuchanka1
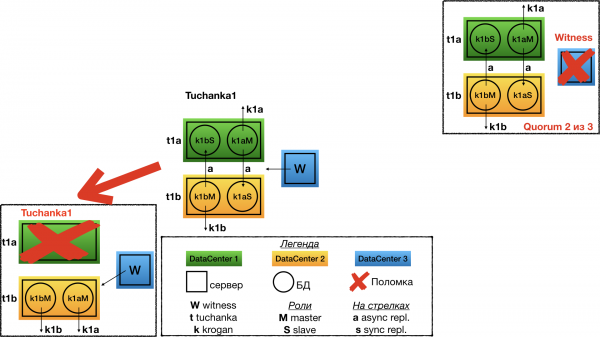
Dështimi i njërit nga qendrat e të dhënave për Tuchanka1. Në këtë rast witness i jep votën e tij nyjës së dytë në qendrën e dytë të të dhënave. Atje, skllavi i dikurshëm shndërrohet në master, si rezultat, të dy masterët punojnë në të njëjtin server dhe të dy IP-të e tyre flotante i drejtohen atyre.
Tuchanka2 (klasike)
Struktura
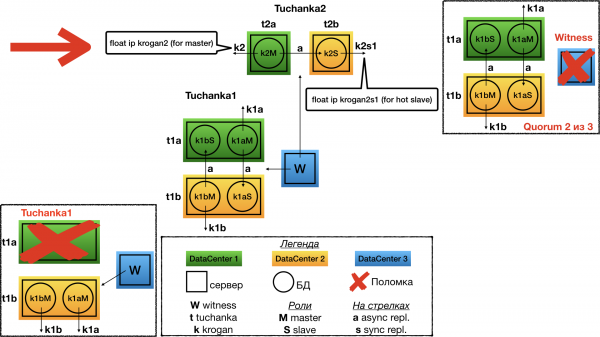
Schema klasike me dy nyja. Në një nyje punon masteri, në të tjerën skllavi. Të dy mund të ekzekutojnë kërkesa (skllavi vetëm kërkesa për lexim), ndaj të dy i drejtohen IP flotante: krogan2 — për master, krogan2s1 — për skllavin. Do të ketë qëndrueshmëri ndaj dështimeve për të dy, masterin dhe skllavin.
Në rastin e dy nyjave, qëndrueshmëria ndaj dështimeve është e mundur vetëm me replikim asinkron, sepse në rastin e replikimit sinkron, dështimi i skllavit do të çonte në ndalimin e masterit.
Dështimi i Tuchanka2
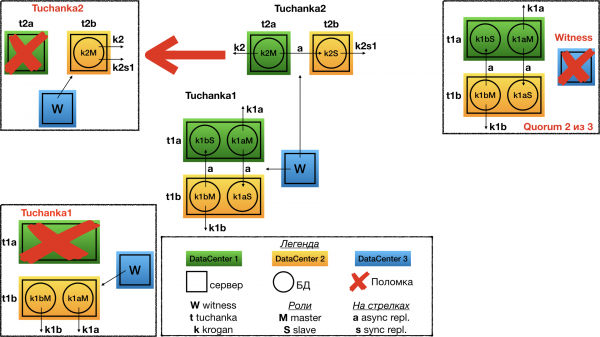
Në rastin e dështimit të njërit nga qendrat e të dhënave witness votimi për të dytin. Në qendrën e vetme funksionale të të dhënave do të ngrihet masteri, dhe të dy IP-të fluturues do të tregojnë në të: masteri dhe skllavi. Sigurisht, instance duhet të jetë e konfiguruar në një mënyrë që të ketë burime të mjaftueshme (për kufizimet nën lidhje etj.) për të pranuar në të njëjtën kohë të gjitha lidhjet dhe kërkesat nga masteri dhe skllavi. Prandaj, gjatë funksionimit normal, ai duhet të ketë një rezervë të mjaftueshme për kufizimet.
Tuchanka4 (shumë skllevër)
Struktura
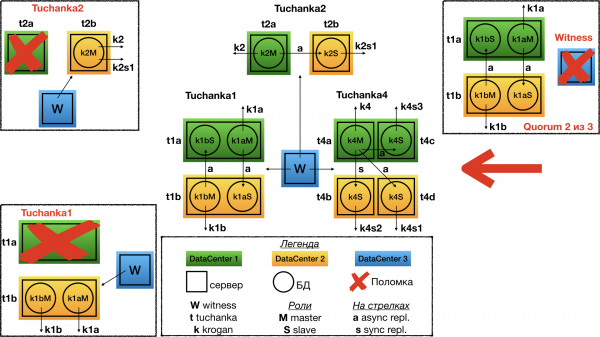
Kjo është një tjetër ekstrem. Ka Baza të Dhënash ku ka shumë kërkesa read-only (rasisti tipik i një uebi me ngarkesë të lartë). Tuchanka4 është situata kur skllevër mund të jenë tre ose më shumë për të trajtuar këto kërkesa, por për të mos pasur shumë. Kur ka një numër shumë të madh skllevër, do të duhet të shpikni një sistem hierarkik replikimi. Në rastin minimal (në figurë) në secilën prej dy qendrave të të dhënave ndodhen nga dy serverë, në secilin prej të cilëve ka nga një instance PostgreSQL.
Një veçori tjetër e kësaj skeme është se këtu mund të organizohet një replikim i njëanshëm. Ai është konfiguruar në mënyrë që të replikojë, sa më shumë të jetë e mundur, në një qendër të dhënash tjetër, dhe jo në një replikë në të njëjtën qendër të dhënash si masteri. Në master dhe në secilin skllav tregohet IP fluturuese. Në rastin ideal, mes skllevërve do të duhet të bëhet balancimi i kërkesave me ndonjë sql proxy, për shembull, në anën e klientit. Një lloj i ndryshëm klientësh mund të kërkojë një lloj të ndryshëm sql proxy, dhe vetëm zhvilluesit e klientëve e dinë se kujt i nevojitet çfarë. Kjo funksionalitet mund të realizohet si nga një demon të jashtëm, ashtu edhe nga një bibliotekë klienti (connection pool), etj. Të gjitha këto dalin jashtë kësaj teme të klasës së dhënash me tolerancë ndaj dështimit (tolerancë ndaj dështimit SQL proxy mund të realizohet në mënyrë të pavarur, së bashku me tolerancën e klientit).
Dështimi Tuchanka4
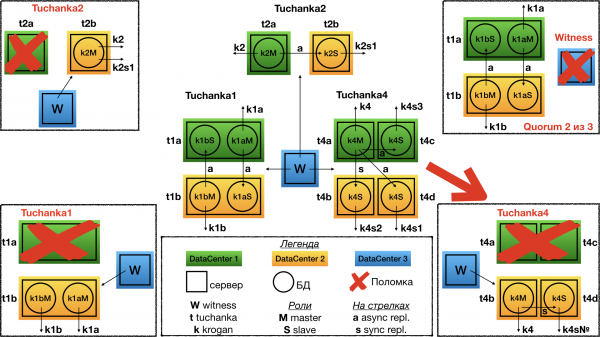
Kur ndodh dështimi i një qendre të dhënash (dmth. dy serverë), witness voton për të dytin. Si rezultat, në qendrën e dytë të të dhënave funksionojnë dy serverë: në një funksionon masteri, dhe në të tregohet IP fluturuese për masterin (për të pranuar kërkesa read-write); dhe në serverin e dytë funksionon skllavi me replikim të njëanshëm, dhe në të tregohet një nga IP-të flutruese të skllavit (për kërkesat read only).
E para që duhet të theksohet: IP fluturuese e skllavit do të jetë vetëm një, dhe për funksionim të duhur me të, do të nevojitet që sql proxy ka drejtonte të gjitha kërkesat në IP-në e mbetur float; dhe nëse sql proxy jo, mund të renditni të gjitha IP-të float të skllevërve me presje në URL për lidhje. Në këtë rast me libpq lidhja do të jetë me IP-në e parë punuese, ashtu siç është bërë në sistemin e testimit automatik. Ndoshta, në biblioteka të tjera, si JDBC, kjo nuk do të funksionojë dhe është e nevojshme sql proxy. Kjo është bërë sepse ka një ndalim për të ngritur njëkohësisht IP-të float për skllevërit në një server, për t'i shpërndarë ato në mënyrë të barabartë në serverët e skllevërve, nëse punohet me disa.
E dyta: madje në rastin e dështimit të qendrës së të dhënave, do të ruhet replikimi sinkron. Dhe madje nëse ndodh një dështim i dytë, domethënë në qendrën e mbetur, një nga dy serverët dështojnë, klasteri edhe pse do të ndalojë ofrimin e shërbimeve, do të ruajë informacionin për të gjitha transaksionet e angazhuara, për të cilat ai dha një konfirmim për angazhimin (nuk do të ketë humbje informacioni në rastin e dështimit të dytë).
Tuchanka3 (3 qendra të dhënash)
Struktura
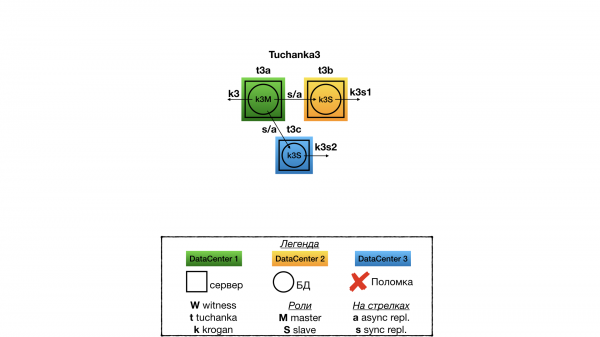
Ky është një klaster për një situatë kur ka tre qendra të plota të të dhënave në funksionim, në secilën prej të cilave ka një server të DB në funksionim. Në këtë rast quorum device nuk është e nevojshme. Në një qendër të të dhënave punon masteri, në dy të tjera janë skllevër. Replikimi është sinkron, lloji ANY (slave1, slave2), domethënë klienti do të marrë konfirmimin e angazhimit, kur ndonjë nga skllevërit e para të përgjigjet që ka pranuar angazhimin. Burimet indikojnë një IP float për masterin dhe dy për skllevërit. Ndryshe nga Tuchanka4, të gjitha tre IP-të float janë të disponueshme. Për balancimin e kërkesave SQL read-only mund të përdorin sql proxy (me disponueshmëri të veçantë), ose të caktuar një IP float skllevër për gjysmën e klientëve, ndërsa gjysmës tjetër një IP float tjetër.
Dështimi Tuchanka3
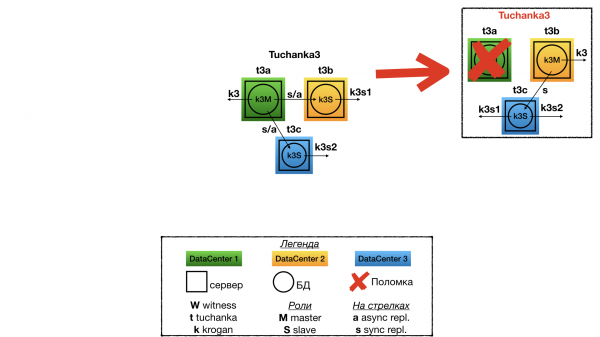
Në rastin e dështimit të një nga qendrat e të dhënave, mbeten dy. Njëra ka ngritur masterin dhe IP-në float nga masteri, në tjetrën ka skllevër dhe të dyja IP-të float të skllevërve (në instancë duhet të ketë rezervë dyfish për burimet, për të pranuar të gjitha lidhjet nga të dyja IP-të float të skllevërve). Ndërmjet masterëve dhe skllevërit ekziston replikimi sinkron. Gjithashtu klasteri do të ruajë informacionin për transaksionet e angazhuara dhe të konfirmuara (nuk do të ketë humbje informacioni) në rastin e shkatërrimit të dy qendrave të të dhënave (nëse ato janë shkatërruar jo njëkohësisht).
Unë vendosa të mos përfshij një përshkrim të detajuar të strukturës së skedarëve dhe shpërndarjes. Kush do të dojë të eksperimentojë, mund ta lexojë të gjithë këtë në README. Unë po jap vetëm përshkrimin e testimit automatik.
Sistemi i testimit automatizuar
Për të verifikuar qëndrueshmërinë e klasterëve me simuluar defekte të ndryshme u krijua një sistem testimi automatik. Aktivizohet me një skript test/failure. Skripti mund të pranojë si parametra numrat e klasterëve që dëshironi të testoni. Për shembull, kjo komandë:
test/failure 2 3do të testojë vetëm klasterin e dytë dhe të tretë. Nëse parametrat nuk janë të specifikuar, të gjitha klasterët do të testohen. Të gjitha klasterët testohen paralelisht, dhe rezultati shfaqet në panelin tmux. Tmux përdor një server të dedikuar tmux, kështu që skripti mund të aktivizohet nga tmux default, duke krijuar një tmux të brendshëm. Rekomandoj të përdorni terminalin në një dritare të madhe dhe me një shkronjë të vogël. Para fillimit të testimit, të gjitha virtualkat rikthehen në një snapshot në momentin kur skripti përfundon. setup.
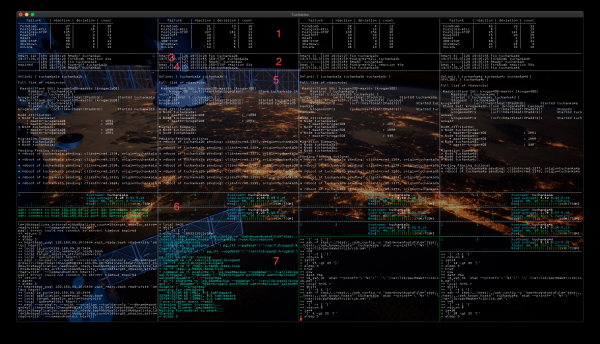
Terminali është ndarë në kolona në përputhje me numrin e klasterëve që po testohen, në parazgjedhje (në screenshot) ato janë katër. Unë do ta shqiptoj përmbajtjen e kolonave me shembullin Tuchanka2. Panelet në screenshot janë të numëruara:
- Këtu shfaqet statistika mbi testet. Kolonat:
- failure — emri i testit (funksioni në skript), i cili simulohet një defekt.
- reaction — koha mesatare aritmetike në sekonda, për të cilën klasteri ka rikuperuar funksionalitetin e tij. Matet nga fillimi i punës së skriptit që simuli një defekt, deri në momentin kur klasteri rikuperon funksionalitetin e tij dhe është në gjendje të vazhdojë ofrimin e shërbimeve. Nëse koha është shumë e vogël, për shembull, gjashtë sekonda (ndodh në klasterët me disa skllevër (Tuchanka3 dhe Tuchanka4)), kjo do të thotë se defekti ndodhi në një skllav asinkron dhe nuk ndikohet asgjë në funksionalitet, nuk pati ndërrime të gjendjes së klasterit.
- deviation — tregon shpërndarjen (saktësinë) e vlerës reaction me metodën "nënshkallë".
- count — sa herë është realizuar ky test.
- Një ditar i shkurtër lejon vlerësimin se çfarë po bën klasteri në momentin e tanishëm. Shfaqet numri i iteracionit (testit), marka e kohës dhe emri i operacionit. Një përfundim i tejet i gjatë (> 5 minuta) tregon për një problem.
- heart (zemra) — koha aktuale. Për vlerësim vizual të funksionimit majstori në tabelën e tij shkruhet vazhdimisht koha aktuale duke përdorur IP-në float të majstor. Në rast suksesi, rezultati shfaqet në këtë panel.
- rrahje (puls) — «koha aktuale», e cila më parë ishte regjistruar nga skripti heart në majstor, tani lexohët nga robi përmes IP-së së tij float. Lejon vlerësimin vizual të funksionimit të rob at dhe replikimi. Në Tuchanka1 nuk ka robër me IP float (nuk ka robër që ofrojnë shërbime), por aty ka dy instanca (DB), prandaj këtu do të shfaqet jo rrahje, ndërsa heart instancës së dytë.
- Monitorimi i gjendjes së klasterit duke përdorur utilitarin
pcs mon. Tregon strukturën, shpërndarjen e burimeve sipas nyjeve dhe informacion tjetër të dobishëm. - Këtu shfaqet monitorimi sistematik nga çdo virtuale e klasterit. Ka panele të tilla dhe më shumë — sa virtuale ka klasteri. Dy grafika Ngarkesa CPU (në virtuale janë dy procesorë), emri i virtuales, Ngarkesa e Sistemës (e quajtur si Ngarkesa Mesatare, sepse është e mesatarizuar për 5, 10 dhe 15 minuta), të dhënat për proceset dhe shpërndarja e memories.
- Gjurmimi i skriptit që kryen testet. Në rast të defektit — ndalimi papritur i punës ose një cikli të pafund pritjeje — këtu mund të shihni shkakun e një sjelljeje të tillë.
Testimi bëhet në dy etapa. Fillimisht, skripti kalon përmes të gjitha llojeve të testeve, duke zgjedhur rastësisht një virtuale, ku ky test aplikon. Pastaj kryhet një cikël të pafund testimi, virtualet dhe defekti zgjidhen çdo herë rastësisht. Ndalimi papritur i skriptit të testit (pjesa e poshtme) ose një cikël i pafund pritjeje për diçka (> 5 minuta koha e ekzekutimit të një operacioni, kjo është e dukshme në gjurmim) tregon se ndonjë test në këtë klaster ka dështuar.
Secili test përbëhet nga operacione të mëposhtme:
- Fillimi i funksionit, duke imituar defektin.
- Gati? — pritja për rikuperimin e funksionimit të klasterit (kur ofrohen të gjitha shërbimet).
- Shfaqet koha e pritjes për rikuperimin e klasterit (reaction).
- Riparo — klasteri "po riparohet". Pas kësaj, ai duhet të kthehet në një gjendje të plotë funksionimi dhe gatishmëri për defektin e ardhshëm.
Ja lista e testeve me përshkrimin se çfarë bëjnë:
- ForkBomb: krijon "Out of memory" me ndihmën e një bombë fork.
- OutOfSpace: mbush me të dhëna. Por testi, në fakt, është simbolik, duke pasur parasysh ngarkesën e vogël që krijohet gjatë testimit, në rastin e mbushjes së mbajtësit nuk ndodhin zakonisht dështime të PostgreSQL.
- Postgres-KILL: vret PostgreSQL me komandën
killall -KILL postgres. - Postgres-STOP: pezullon PostgreSQL me komandën
killall -STOP postgres. - PowerOff: „ndërron energjinë” e makinerisë virtuale me komandën
VBoxManage controlvm "makineri virtuale" poweroff. - Reset: riboton makinerinë virtuale me komandën
VBoxManage controlvm "makineri virtuale" reset. - SBD-STOP: pezullon demonin SBD me komandën
killall -STOP sbd. - ShutDown: dërgon komandën në makinerinë virtuale përmes SSH
systemctl poweroff, sistemi përfundon punën siç duhet. - UnLink: izolim rrjeti, komandë
VBoxManage controlvm "makineri virtuale" setlinkstate1 off.
Mbyllja e testit ose me komandën standarde tmux "kill-window" Ctrl-b &, ose me komandën "detach-client" Ctrl-b d: në këtë rast testi është mbyllur, tmux mbyllet, makineritë virtuale përfundojnë.
Problemet e zbuluara gjatë testimit
Në këtë moment demonin sbd përpunon ndalimin e demonëve të monitoruar, por jo ngjalljen e tyre. Dhe, si pasojë, dështimet e papërshtatshme trajtohen në mënyrë të pasaktë, duke çuar në ngjallje vetëm Corosync dhe Pacemaker, por pa i pezulluar sbd. Për verifikim Corosync veçse ekziston , miratuar në degën master. Premtuan (në PR#83), se do të ketë diçka të ngjashme edhe për Pacemaker, shpresojmë që në RedHat 8 të bëhet. Por këto "dështime" janë teorike, lehtë mund të imitohet në mënyrë artificiale duke përdorur, për shembull,
killall -STOP corosync, por nuk ndodhin kurrë në jetën reale.Me Pacemaker në versionin për CentOS 7 nuk është vendosur saktë sync_timeout i quorum device, si rezultat , në të cilën duhet të kalonte masteri. U zgjidh me rritjen sync_timeout i quorum device gjasave gjatë përgatitjes (në skriptin
setup/setup1). Ky korrigjim nuk u pranua nga zhvilluesit Pacemaker, përkundrazi ata premtuan të rishikojnë infrastrukturën në një mënyrë të tillë (në një të ardhme të paqartë), që ky kohëzgjatje të llogaritet automatikisht.Nëse gjatë konfigurimit të bazës së të dhënave, është treguar se në
LC_MESSAGES(mesazhet tekstuale) mund të përdoret Unicode, për shembull,ru_RU.UTF-8, atëherë gjatë aktivizimit postgres në një ambient ku locale nuk është UTF-8, le të themi, në një ambient të zbrazët (këtu pacemaker+pgsqlms(paf) aktivizon postgres), atëherë . Zhvilluesit e PostgreSQL nuk janë arritur që të bien dakord se çfarë të bëjnë në këtë rast. Kjo bën që duhet të vendosetLC_MESSAGES=en_US.UTF-8gjate konfigurimit (krijimit) të një instance të Baza e të Dhënave.Nëse është vendosur wal_receiver_timeout (në mënyrë të parazgjedhur është 60s), atëherë gjatë testit PostgreSQL-STOP në master në klasteret tuchanka3 dhe tuchanka4 . Replikimi atje është sinkron, prandaj ndalon jo vetëm punëtori, por edhe masteri i ri. Zgjidhet duke vendosur wal_receiver_timeout=0 gjatë konfigurimit të PostgreSQL.
Herë pas here kam vënë re pezullimin e replikimit në PostgreSQL gjatë testit ForkBomb (mbipakosja e memories). . Kam hasur një të tillë vetëm në klasteret tuchanka3 dhe tuchanka4, ku për shkak se replikimi është sinkron, masteri ka pezulluar. Problemi kaloi vetë, pas një kohe të gjatë (afër dy orësh). Kërkohet hetim shtesë për ta zgjidhur këtë. Nga simptomat duket si një gabim i mëparshëm, i shkaktuar nga një arsye tjetër, por me pasoja të ngjashme.
Imazhi i kroganit është marrë nga me lejen e autorit:
Burimi: habr.com
