

Dua të ndaj me ju përvoja ime e suksesshme e parë në rikthimin e plotë të funksionalitetit të bazës së të dhënave Postgres. Kam njohur me SGBD Postgres gjashtë muaj më parë, para kësaj nuk kisha fare përvojë në administrimin e bazave të dhënash.
Unë punoj si një inxhinier gjysmë DevOps në një kompani të madhe IT. Kompania jonë merret me zhvillimin e softuerit për shërbime me ngarkesë të lartë, ndërsa unë jam përgjegjës për funksionalitetin, mbështetje dhe vendosjen. Më është dhënë një detyrë standarde: të përUpdate një aplikacion në një server. Aplikacioni është shkruar në Django, gjatë përditësimit kryhen migrime (ndryshimi i strukturës së bazës së të dhënave), dhe përpara këtij procesi ne marrim një dump të plotë të bazës së të dhënave përmes programit standard pg_dump për çdo rast.
Gjatë marrjes së dump-it ndodhi një gabim i papritur (versioni Postgres – 9.5):
pg_dump: Shtypja e përmbajtjes së tabelës “ws_log_smevlog” dështoi: PQgetResult() dështoi.
pg_dump: Mesazhi i gabimit nga serveri: ERROR: faqe e pavlefshme në bllokun 4123007 të rel, base/16490/21396989
pg_dump: Urdhri ishte: COPY public.ws_log_smevlog [...]
pg_dump: [ndertimi paralel] një proces punues dështoi papritur
Gabim «faqe e pavlefshme në bllok» tregon për probleme në nivelin e sistemit të skedarëve, që është shumë e keqe. Në disa forume janë sugjeruar të bëhen FULL VACUUM me opsionin zero_damaged_pages për të zgjidhur këtë problem. Pra, të përpiqemi…
Përgatitja për rikuperim
KËSHILLË! Sigurohuni që të bëni një kopje rezervë të Postgres para çdo përpjekjeje për të rikuperuar bazën e të dhënave. Nëse keni një makinë virtuale, ndaloni bazën e të dhënave dhe bëni një snapshot. Nëse nuk keni mundësi të bëni një snapshot, ndaloni bazën dhe kopjoni përmbajtjen e direktoriumit Postgres (përfshirë skedarët wal) në një vend të besueshëm. Gjëja më e rëndësishme në këtë proces është të mos e përkeqësoni situatën. Lexoni .
Duke qenë se në përgjithësi baza funksiononte, u kufizova në marrjen e dump-it të zakonshëm të bazës, por përjashtova tabelën me të dhënat e dëmtuara (opsioni -T, —exclude-table=TABLE në pg_dump).
Serveri ishte fizik, nuk ishte e mundur të merrej një snapshot. Backup është bërë, tani po vazhdojmë.
Kontrolli i sistemit të skedarëve
Para se të përpiqemi për të rikuperuar bazën e të dhënave, duhet të sigurohemi që gjithçka është në rregull me sistemin e skedarëve. Në rast se ka gabime, ato duhet të korrigjohen, pasi përndryshe mund të përkeqësojmë gjendjen.
Në rastin tim, sistemi i skedarëve me bazën e të dhënave ishte i montuar në «/srv» dhe tipi ishte ext4.
Ndaloni bazën e të dhënave: systemctl stop postgresql@9.5-main.service dhe kontrollojmë që sistemi i skedarëve nuk po përdoret nga askush dhe mund të shkëputet me komandën lsof:
lsof +D /srv
Më duhej të ndaloja gjithashtu bazën e të dhënave redis, pasi ajo gjithashtu ishte duke e përdorur «/srv». Pastaj e shkëputa /srv (umount).
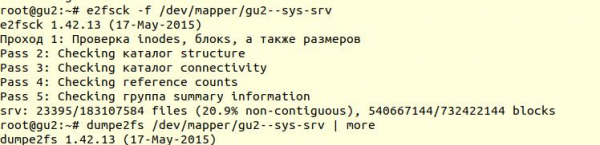
Kontrolli i sistemit të skedarëve u krye me ndihmën e utilitarit e2fsck me çelësin -f (Kontrolli i detyrueshëm edhe nëse sistemi i skedarëve është shënuar si i pastër):
Më pas, me ndihmën e utilitarit dumpe2fs (sudo dumpe2fs /dev/mapper/gu2—sys-srv | grep checked) mund të sigurohemi se kontrolli në të vërtetë është kryer:
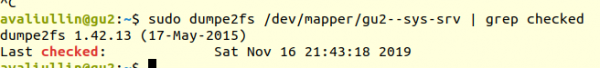
e2fsck thotë se nuk janë gjetur probleme në nivelin e sistemit të skedarëve ext4, që do të thotë se mund të vazhdojmë përpjekjet për të rikthyer bazën e të dhënave, më saktë të kthehemi në vacuum full (sigurisht, është e nevojshme të montoni përsëri sistemin e skedarëve dhe të rimarrni bazën e të dhënave).
Nëse keni një server fizik, sigurohuni të kontrolloni gjendjen e disqeve (nëpërmjet smartctl -a /dev/XXX) ose të kontrolluesit RAID, për të siguruar që problemi nuk është në nivelin harduerik. Në rastin tim, RAID doli të ishte 'metalik', prandaj kërkova nga administratori lokal të kontrollonte gjendjen e RAID (serveri ishte disa qindra kilometra larg meje). Ai tha se nuk kishte gabime, që do të thotë se me siguri mund të fillojmë rikthimin.
Përpjekja 1: zero_damaged_pages
Lidhem me bazën përmes psql me një llogari që ka të drejta superpërdoruesi. Na nevojitet pikërisht superpërdoruesi, pasi opsioni zero_damaged_pages mund të ndryshohet vetëm nga ai. Në rastin tim, ky është postgres:
psql -h 127.0.0.1 -U postgres -s [database_name]
Opcioni zero_damaged_pages nevojitet për të injoruar gabimet e leximin (nga faqja postgrespro):
Kur identifikohet një përmbajtje e dëmtuar e njësisë, Postgres Pro zakonisht njofton për gabimin dhe ndërpret transaksionin aktual. Nëse parametrin zero_damaged_pages është i aktivizuar, sistemi në vend të kësaj merr një paralajmërim, zero-n njësinë e dëmtuar në memory dhe vazhdon procesimin. Ky sjellje shkatërron të dhënat, domethënë të gjitha rreshtat në njësinë e dëmtuar.
Aktivizojmë opsionin dhe një përpiqemi të bëjmë full vacuum në tabelë:
VACUUM FULL VERBOSE 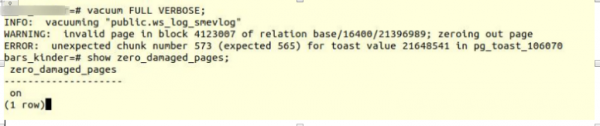
Fatkeqësisht, dështim.
Ne u përballëm me një gabim të ngjashëm:
INFO: vacuuming ""public.ws_log_smevlog"
WARNING: faqja e pavlefshme në bllokun 4123007 të marrëdhënies base/16400/21396989; duke e zero si faqen
ERROR: numri i papritur i copëzave 573 (pritej 565) për vlerën toast 21648541 në pg_toast_106070– mekanizmi i ruajtjes së 'të dhënave të gjata' në Postgres, nëse ato nuk bëhen brenda një faqe (në mënyrë të paracaktuar 8kb).
Përpjekja 2: reindex
Këshilla e parë nga google nuk ndihmoi. Pas disa minutash kërkimi, gjetja e dytë – për të bërë reindex tabelës së dëmtuar. Ky këshill e kam hasur në shumë vende, por nuk ishte i besueshëm. Le të bëjmë reindex:
reindex table ws_log_smevlog 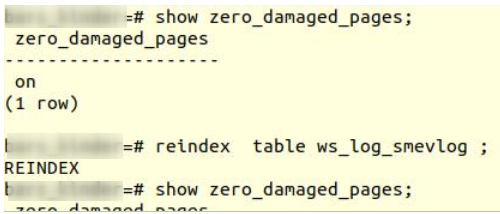
reindex u përfundua pa probleme.
Megjithatë, kjo nuk ndihmoi, VACUUM FULL u mbyll aksidentalisht me një gabim të ngjashëm. Duke qenë se isha mësuar me dështimet, fillova të kërkoj këshilla më tej në internet dhe takova një .
Përpjekja 3: SELECT, LIMIT, OFFSET
Në artikullin e mësipërm sugjerohej të shikohej tabela me radhë dhe të fshihej të dhënat problematike. Fillimisht duhej të shqyrtoja të gjitha radhët:
for ((i=0; i/dev/null || echo $i; doneNë rastin tim, tabela kishte 1 628 991 radhë! Rregullisht duhej të merreshim me , por ky është një temë për diskutim të veçantë. Ishte e shtunë, unë e nisja këtë komandë në tmux dhe shkoja për të fjetur:
for ((i=0; i/dev/null || echo $i; doneNë mëngjesu mora vendimin të kontrolloja si ishin punët. Për habinë time, zbuloj se për 20 orë ishin skanuar vetëm 2% të të dhënave! Nuk doja të prisja 50 ditë. Një dështim tjetër i plotë.
Por nuk u dorëzova. Më interesoi pse skanimi po zgjaste aq shumë. Nga dokumentacioni (prapë në postgrespro) mësova:
OFFSET tregon të anashkalosh numrin e tregjeve të specifikuara para se të fillosh të kthesh radhët.
Nëse janë të specifikuara si OFFSET, ashtu edhe LIMIT, sistemi së pari anashkalon radhët OFFSET, dhe pastaj fillon të numërojë radhët për kufizimin LIMIT.Duke e përdorur LIMIT, është e rëndësishme të përdoret gjithashtu propozimi ORDER BY, në mënyrë që radhët e rezultatit të kthenin në një rend të caktuar. Ndryshe do të kthehen në nëngrupe të papritura rreshtash.
E qartë, komanda e shkruar më sipër ishte e gabuar: së pari, nuk kishte order by, rezultati mund të ishte i gabuar. Për më tepër, Postgres fillimisht duhej të kishte skanuar dhe anashkaluar radhët OFFSET, dhe me rritjen OFFSET performanca do të binte akoma më shumë.
Përpjekja 4: të bëj një dump në format tekstual
Më pas, më erdhi në mendje një ide që dukej gjeniale: të bëj një dump në format tekstual dhe të analizoj radhën e fundit të regjistruar.
Por përpara, le të njohim strukturën e tabelës ws_log_smevlog:
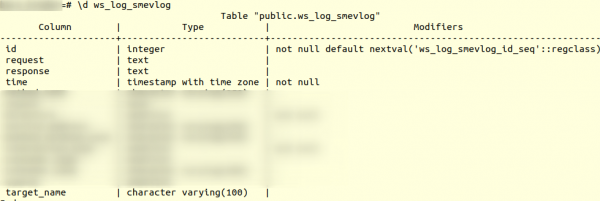
Në rastin tonë kemi një kolonë "id", e cila përmbante identifikues unik (numërues) të radhës. Plani ishte kështu:
- Fillojmë të bëjmë një dump në format tekstual (në formën e komandave sql)
- Në një moment të caktuar, procesi i nxjerrjes së dump-it do të ndërpritej për shkak të një gabimi, por skedari tekstual do të ruheshin ende në disk.
- Shikojmë fundin e skedarit tekstual, kështu gjejmë identifikuesin (id) të rreshtit të fundit që është nxjerrë me sukses.
Kam filluar të nxjerr dump-in në format tekstual:
pg_dump -U my_user -d my_database -F p -t ws_log_smevlog -f ./my_dump.dumpNxjerrja e dump-it, siç pritej, u ndërpre me të njëjtin gabim:
pg_dump: Mesazhi i gabimit nga serveri: ERROR: faqe e pavlefshme në bllokun 4123007 të bazës së të dhënave/16490/21396989 Më pas përmes tail shikova fundin e dump-it (tail -5 ./my_dump.dump) zbulova se dump-i u ndërpre në rreshtin me id 186 525. "Pra, problemi është në rreshtin me id 186 526, ai është i prishur, duhet ta ndërpresim!" – mendova. Por, duke bërë një pyetje në bazën e të dhënave:
«select * from ws_log_smevlog where id=186529"u zbulua që ky rresht është në rregull... Rreshtat me indekset 186 530 — 186 540 gjithashtu punuan pa probleme. Një "ide gjeniale" dështoi. Më vonë kuptova pse ndodhi kështu: kur fshin/modifikoni të dhënat nga tabela, ato nuk fshihen fizikisht, por shënohen si "tuaj të vdekur", më pas vjen autovacuum dhe i shënon këta rreshta si të fshirë dhe lejon përdorimin e këtyre rreshtave përsëri. Për ta kuptuar, nëse të dhënat në tabelë ndryshojnë dhe autovacuum është aktiv, ato nuk ruhen në rend.
Përpjekja 5: SELECT, FROM, WHERE id=
Dështimet na bëjnë të fortë. Asnjëherë nuk duhet të dorëzohesh, duhet të vazhdosh deri në fund dhe të besosh në vete dhe në aftësitë e tua. Prandaj vendosa të provoj një variant tjetër: thjesht të shikoj të gjitha regjistrimet në bazën e të dhënave një nga një. Duke ditur strukturën e tabelës time (shih më lart), kemi një fushë id, e cila është e veçantë (çelësi primar). Në tabelë kemi 1 628 991 rreshta dhe id ato shkojnë në rend, që do të thotë se mund të kalojmë thjesht një nga një:
for ((i=1; i/dev/null || echo $i; doneNëse dikush nuk kupton, komanda funksionon si më poshtë: shikon rresht pas rreshti tabelën dhe dërgon stdout në /dev/null, por nëse komanda SELECT dështon, atëherë shfaqet teksti i gabimit (stderr dërgohet në konsolë) dhe shfaqet rreshti që përmban gabimin (falë ||, i cili tregon se ka pasur probleme me seleksionin (kodi i rikthimit të komandës nuk është 0)).
Kam pasur fat, kisha krijuar indekse mbi fushën id:
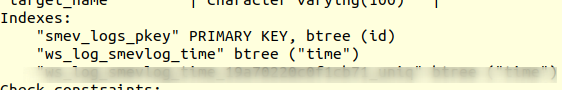
Pra, do të thotë që gjetja e rreshtit me id të kërkuar nuk duhet të marrë shumë kohë. Në teori duhet të funksionojë. Pra, le të fillojmë komandën në tmux dhe shkojmë për të fjetur.
Në mëngjes zbulova se ishin parë rreth 90,000 të dhëna, që përbën pak më shumë se 5%. Një rezultat të shkëlqyer, nëse e krahasojmë me metodën e mëparshme (2%)! Por nuk kisha dëshirë të prisja 20 ditë...
Përpjekja 6: SELECT, FROM, WHERE id >= and id <
Për klientin ishte caktuar një server i shkëlqyer për DB: me dy procese Intel Xeon E5-2697 v2, në konfigurimin tonë kishte plot 48 rrjedha! Ngarkesa në server ishte mesatare, ne pa ndonjë problem të veçantë mund të merrnim rreth 20 rrjedha. Edhe memorie e mjaftueshme: madje 384 gigabajt!
Prandaj ekipi duhej të përparonte:
for ((i=1; i/dev/null || echo $i; doneKëtu mund të shkruhej një skenar i bukur dhe elegant, por unë zgjodha mënyrën më të shpejtë të paralelizimit: të ndaj intervalin 0-1628991 në mënyrë manuale në intervale prej 100,000 të dhënash dhe të nisin veçmas 16 komanda të tipit:
for ((i=N; i/dev/null || echo $i; donePor kjo nuk është e gjitha. Idealisht, lidhja me bazën e të dhënave merr gjithashtu disa kohë dhe burime sistemore. Nuk ishte shumë e mençur të lidhej me 1,628,991, e kuptoni. Prandaj, le të nxjerrim 1000 rreshta në një lidhje përveç njërit. Në fund, komanda u transformua në këtë:
for ((i=N; i=$i and id/dev/null || echo $i; doneHapim 16 dritare në sesionin tmux dhe nisim komandat:
1) for ((i=0; i=$i and id/dev/null || echo $i; done
2) for ((i=100000; i=$i and id/dev/null || echo $i; done
…
15) for ((i=1400000; i=$i and id/dev/null || echo $i; done
16) for ((i=1500000; i=$i and id/dev/null || echo $i; done
Pas një dite, mora rezultatet e para! Konkretisht (vlerat XXX dhe ZZZ nuk janë mbajtur më):
ERROR:  chunk numri 0 për vlerën e toast 37837571 në pg_toast_106070
829000
ERROR:  chunk numri 0 për vlerën e toast XXX në pg_toast_106070
829000
ERROR:  chunk numri 0 për vlerën e toast ZZZ në pg_toast_106070
146000
Kjo do të thotë se kemi tre rreshta që përmbajnë gabim. id e dy shënimeve problematike ishin midis 829,000 dhe 830,000, id i tretë - midis 146,000 dhe 147,000. Më pas duhej vetëm të gjenim vlerën e saktë të id të shënimeve problematike. Për këtë, duke shqyrtuar intervalin tonë me shënimet problematike me hap 1 dhe identifikojmë id:
për ((i=829000; i<830000; i=$((i+1)) )); bëj psql -U my_user -d my_database -c "SELECT * FROM ws_log_smevlog where id=$i" >\/dev\/null || echo $i; bërë
829417
ERROR:  numri i papritur i copës 2 (pritej 0) për vlerën toast 37837843 në pg_toast_106070
829449
për ((i=146000; i<147000; i=$((i+1)) )); bëj psql -U my_user -d my_database -c "SELECT * FROM ws_log_smevlog where id=$i" >\/dev\/null || echo $i; bërë
829417
ERROR:  numri i papritur i copës ZZZ (pritej 0) për vlerën toast XXX në pg_toast_106070
146911
Finale e lumtur
Gjetëm rreshtat problematikë. Hyjmë në bazë përmes psql dhe provokojmë t’i fshijmë:
my_database=# fshi nga ws_log_smevlog ku id=829417;
Fshirë 1
my_database=# fshi nga ws_log_smevlog ku id=829449;
Fshirë 1
my_database=# fshi nga ws_log_smevlog ku id=146911;
Fshirë 1
Për habinë time, regjistrimet u fshinë pa asnjë problem madje edhe pa opsionin zero_damaged_pages.
Pastaj u lidhëm në bazë, bëra VACUUM FULL (mendoj se ishte e panevojshme), dhe, në fund, me sukses bëra një kopje rezervë me ndihmën e pg_dump. Dumpi u bë pa asnjë gabim! Problemi u zgjidh në këtë mënyrë të thjeshtë. Gëzimi ishte i pakufishëm, pas kaq shumë dështimesh arrita të gjej një zgjidhje!
Falënderime dhe përfundim
Kjo ishte përvoja ime e parë në rikuperimin e një baze të dhënash të vërtetë Postgres. Do ta mbaj mend këtë përvojë për një kohë të gjatë.
Dhe në fund, do doja të falënderoja kompaninë PostgresPro për dokumentacionin e përkthyer në gjuhën ruse dhe për , të cilat më ndihmuan shumë gjatë analizës së problemit.
Burimi: habr.com
