

Ne filluam të mendojmë për krijimin e një sistemi monitorimi në fazën e formimit të grupeve produktive. U bë e qartë se aktiviteti ynë – operimi – nuk bënte aspak pjesë e këtyre grupeve. Pse ndodhi kështu?
Çështja është se të gjitha grupet tona janë ndërtuar rreth sistemeve të veçanta informacioni, mikro shërbimeve dhe front-end, prandaj ekipi nuk e sheh gjendjen e shëndetit të gjithë sistemit si një tërësi. Për shembull, ata mund të mos dinë se si një pjesë e vogël në backend e ndikon pjesën front-end. Rrethi i interesave të tyre kufizohet me sistemet me të cilat është integruar sistemi i tyre. Nëse ekipi dhe shërbimi A nd almost nuk janë të lidhur me shërbimin B, atëherë një shërbim i tillë për ekipin është pothuajse i padukshëm.
Ekipi ynë, nga ana tjetër, punon me sisteme që janë shumë të integruara me njëra-tjetrën: ka shumë lidhje mes tyre, është një infrastrukturë e madhe. Dhe nga të gjithë këto sisteme (për t’u thënë, kemi një numër të madh), varet funksionimi i dyqanit online.
Kështu që del se departamenti ynë nuk i përket asnjë ekipi, por është paksa në anë. Në të gjithë këtë histori, detyra jonë është të kuptojmë në mënyrë gjithëpërfshirëse si funksionojnë sistemet informative, funksionaliteti i tyre, integrimet, softueri, rrjeta, hardueri dhe se si e gjithë kjo lidhet me njëra-tjetrën.
Platforma, në të cilën funksionojnë dyqanet tona online, duket kështu:
- front
- middle-office
- back-office
Sa do që të dëshirojmë, nuk ka asnjë rast ku të gjitha sistemet të funksionojnë pa probleme dhe në mënyrë perfekte. Çështja është, përsëri, në numrin e sistemeve dhe integrimeve - në rastin tonë, ndodhin incidente të tilla, pavarësisht cilësisë së testimit. Kjo ndodh si brenda një sistemi të veçantë, ashtu edhe në aspektin e integrimeve të tyre. Është e nevojshme të ndjekim gjendjen e gjithë platformës në mënyrë gjithëpërfshirëse, e jo një pjese të saj.
Idealisht, monitorimi i shëndetit të gjithë platformës duhet automatizuar. Dhe ne arritëm te monitorimi si një pjesë e pashmangshme e këtij procesi. Fillimisht, ai u ndërtua vetëm për pjesën front-end, ndërkohë që ekzistojnë sisteme monitorimi nga shtresa për administratorët e rrjetit, softuerit dhe harduerit. Të gjithë këta njerëz e ndoqën monitorimin vetëm në nivelin e tyre, askush nuk kishte një kuptim gjithëpërfshirës.
Për shembull, nëse një makinë virtuale bie, në shumicën e rasteve, vetëm administratori që është përgjegjës për harduerin dhe makinën virtuale e di këtë. Ekipi i front-end-it në këto raste sheh vetëm faktin e rënies së aplikacionit, por nuk kishte të dhëna për rënien e makinës virtuale. Ndërsa administratori mund të dijë se kush është klienti dhe të ketë një ide se çfarë po ndodh në këtë makinë virtuale, me kusht që të jetë një projekt i madh. Nëse është i vogël, ndoshta nuk e di. Në çdo rast, administratori duhet të shkojë te pronari dhe të pyesë se çfarë kishte në këtë makinë, se çfarë duhet të rikuperohet dhe se çfarë duhet ndërruar. Dhe nëse kishte një problem më serioz, fillonte një kërkim paniku — sepse askush nuk e shihte sistemin si një tërësi.
Në fund të fundit, këto tregime të shpërndara ndikojnë në të gjithë front-end-in, në përdoruesit dhe funksionin tonë kryesor të biznesit — shitjet online. Tani që ne nuk jemi pjesë e ekipeve dhe merremi me operimin e të gjitha aplikacioneve e-commerce brenda dyqanit online, morëm përsipër detyrën për të krijuar një sistem kompleks monitorimi për platformën e-commerce.
Struktura e sistemit dhe stek
Filluam duke ndarë disa nivele monitorimi për sistemet tona, përmes të cilave do të na duhej të mbledhim metrika. Dhe gjithçka duhej të ndërmerrej, gjë që e bëmë në fazën e parë. Tani për këtë fazë ne po përmirësojmë mbledhjen sa më cilësore të metricave në të gjitha nivelet tona, për të ndërtuar korelacionin dhe për të kuptuar si sistemet ndikojnë njëra-tjetrën.
Mungesa e një monitorimi të kompleks në fazat e hershme të nisjes së aplikacioneve (pasi filluam ta ndërtojmë atë, kur shumica e sistemeve ishin në funksion) çoi në një borxh teknik të konsiderueshëm për konfigurimin e monitorimit të gjithë platformës. Nuk mund të fokusoheshim në konfigurimin e monitorimit për një sistem të vetëm dhe ta zhvillonim në detaje, pasi sistemet e tjera do të mbeteshin pa monitorim për një periudhë të caktuar. Për të adresuar këtë çështje, ne identifikuam një listë të metricave më të nevojshme për vlerësimin e gjendjes së sistemit informatik sipas niveleve dhe filluam ta implementonim atë.
Prandaj, vendosëm ta hamë elefantin me pjesë.
Sistemi ynë përbëhet nga:
- hardueri;
- sistemi operativ;
- softueri;
- Pjesët e UI në aplikacionin e monitorimit;
- metrikat e biznesit;
- aplikacionet e integrimit;
- siguria informative;
- rrjetet;
- balancuesi i trafikut.
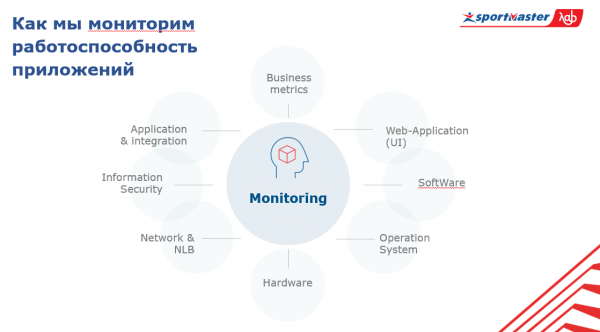
Qendra e këtij sistemi është pikërisht monitorimi. Për të kuptuar gjendjen e përgjithshme të sistemit, është e rëndësishme të dimë se çfarë po ndodh me aplikacionet në të gjitha këto nivele dhe në përmasat e të gjitha aplikacioneve.
Kështu, për stek.
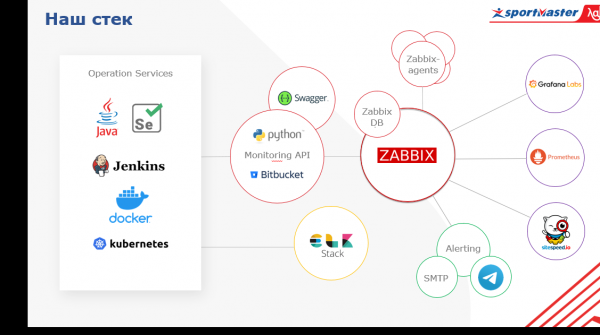
Ne përdorim softuer me burim të hapur. Në qendër kemi Zabbix-in, të cilin e përdorim kryesisht si sistem alarmimi. Të gjithë e dinë se ai është ideal për monitorimin e infrastrukturës. Çfarë nënkuptohet këtu? Pikërisht ato metrika të nivelit të ulët që ka çdo kompani që ka qendrën e vet të të dhënave (dhe Sportmaster ka qendrat e veta) — temperatura e serverit, gjendja e memories, RAID-it, metrikat e pajisjeve të rrjetit.
Ne integrojmë Zabbix-in me mesazherin Telegram dhe Microsoft Teams, të cilat përdoren aktivisht në ekipet. Zabbix mbulon nivelin e rrjetit aktual, harduerit dhe pjesërisht softuerit, por kjo nuk është një zgjidhje universale. Ne pasurojmë këto të dhëna nga disa shërbime të tjera. Për shembull, në nivelin e harduerit ne lidhemi drejtpërdrejt përmes API-së në sistemin tonë të virtualizimit dhe marrim të dhëna.
Çfarë tjetër. Përveç Zabbix-it, ne përdorim Prometheus-in, i cili lejon monitorimin e metrikave në aplikacionin e mjedisit dinamik. Pra, ne mund të marrim metrikat e aplikacionit përmes endpoint-it HTTP dhe të mos shqetësohemi për ato metrika që duhet të ngarkojmë në të dhe ato që jo. Në bazë të këtyre të dhënave, mund të zhvillojmë kërkesa analitike.
Burimet e të dhënave për nivelet e tjera, për shembull, metrikat e biznesit, ndahen në tri komponentë.
Së pari, këto janë sistemet e biznesit të jashtëm, Google Analytics, ne mbledhim metrika nga log-et. Nga ato marrim të dhëna për përdoruesit aktivë, konvertimin dhe gjithçka tjetër që lidhet me biznesin. Së dyti, është sistemi i monitorimit të UI. Për këtë do të flasim më në detaje.
Dikur ne filluam me testimin manual dhe ky proces u zhvillua në testet automatike për funksionalitetin dhe integrimet. Nga kjo ne krijuam monitorimin, duke lënë vetëm funksionalitetin kryesor dhe duke u ndërlidhur me treguesit, të cilët janë sa më të qëndrueshëm dhe nuk ndryshojnë shpesh me kalimin e kohës.
Struktura e re e ekipeve nënkupton që të gjitha aktivitetet në lidhje me aplikacionet janë të përqendruara në ekipet produktore, prandaj ne kemi ndaluar të angazhohemi me testimin e pastër. Në vend të kësaj, ne kemi krijuar një monitorim UI, të shkruar në Java, Selenium dhe Jenkins (përdoret si sistem për nisjen dhe gjenerimin e raporteve).
Kishim shumë teste, por në fund vendosëm të fokusoheshim në më të rëndësishmen, një metrikë mbi nivelin. Dhe nëse kemi shumë teste specifike, do të ishte e vështirë të ruanim të dhënat në përditësim. Çdo lëshim i mëpasshëm do të thyejë ndjeshëm tërë sistemin, dhe ne do të merreshim vetëm me riparimin e tij. Prandaj, ne kemi treguar interes për gjëra themelore, që ndryshojnë rrallë, dhe monitorojmë vetëm ato.
Së fundmi, siç e përmenda, burimi i të dhënave është një sistem centralizues i regjistrimit. Për regjistrimet përdorim Elastic Stack, dhe më pas mund t'i transferojmë këto të dhëna në sistemin tonë të monitorimit të metrikave biznesore. Përveç kësaj, funksionon shërbimi ynë Monitoring API, i shkruar në Python, i cili pyet përmes API të gjitha shërbimet dhe merr të dhëna për to në Zabbix.
Një atribut tjetër i pazëvendësueshëm i monitorimit është vizualizimi. Kjo e fundit ndihmon të ndërtojmë në bazë të Grafana. Ndër sistemet e tjera të vizualizimit, ajo veçohet për faktin se në dashboard mund të vizualizojmë metrika nga burime të ndryshme të të dhënave. Mund të mbledhim metrika mbi nivelin e internet dyqanit, për shembull, numrin e porosive të kryera gjatë orës së fundit nga baza e të dhënave, metrika të performancës së OS-së mbi të cilën funksionon ky internet dyqani nga Zabbix, dhe metrika të instancave të këtij aplikacioni nga Prometheus. Të gjitha këto do të jenë në një dashboard. Qartë dhe në dispozitë.
Dua të theksoj në lidhje me sigurinë — tani jemi duke përmirësuar sistemin, të cilin përfundimisht do ta integrojmë me sistemin global të monitorimit. Sipas mendimit tim, problemet kryesore me të cilat përballet e-commerce në fushën e sigurisë informative janë të lidhura me robotët, parserët dhe brute force. Këto duhet të monitorohen, sepse ato mund të kenë një ndikim kritik në funksionimin e aplikacioneve tona, si dhe në reputacionin tonë nga pikëpamja e biznesit. Dhe me stack-un e zgjedhur, ne i mbulojmë këto detyra me sukses.
Një moment tjetër i rëndësishëm është niveli i aplikacioneve që mblidhet nga Prometheus. Ai është gjithashtu i integruar me Zabbix. Po ashtu kemi sitespeed, një shërbim që na lejon të shikojmë parametrat si shpejtësia e ngarkimit të faqeve tona, pengesat, renderimi i faqeve, ngarkimi i skripteve dhe të tjera, gjithashtu është i integruar përmes API. Pra, metrikat mblidhen në Zabbix dhe alarmin e kemi gjithashtu nga aty. Të gjitha alarmin deri tani shkojnë përmes metodave kryesore të dërgimit (deri tani janë email dhe telegram, po ashtu kemi lidhur kohët e fundit MS Teams). Në planet tona është të zhvillojmë alarmin në një gjendje ku robotët e mençur funksionojnë si shërbim dhe ofrojnë informacion mbi monitorimin për të gjithë ekipet produktive që kërkojnë.
Për ne janë të rëndësishme metrikat jo vetëm të sistemeve të informacionit të veçanta, por edhe metrikat e përgjithshme për gjithë infrastrukturën që aplikacionet përdorin: grupe serverësh fizikë, mbi të cilat funksionojnë makinat virtuale, balancuesit e trafikut, balancuesit e ngarkesës në rrjet, vetë rrjeti, shfrytëzimi i kanaleve të komunikimit. Plus metrikat për qendrat tona të të dhënave (ne kemi disa dhe infrastruktura është mjaft e madhe).
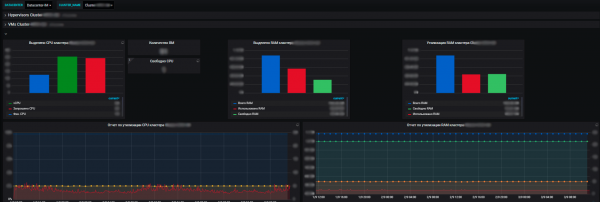
Avantazhi i sistemit tonë të monitorimit është se me ndihmën e tij ne shohim gjendjen e funksionimit të të gjitha sistemeve, mund të vlerësojmë ndikimin e tyre mbi njëri-tjetrin dhe mbi burimet e përgjithshme. Dhe në fund të fundit, ajo na lejon të merremi me planifikimin e burimeve, që gjithashtu bën pjesë në përgjegjësinë tonë. Ne menaxhojmë burimet e serverëve — një grup brenda e-commerce, nxjerrim nga përdorimi pajisje të reja, blejmë të tjera, bëjmë auditimin e shfrytëzimit të burimeve dhe të tjera. Çdo vit ekipet planifikojnë projekte të reja, zhvillojnë sistemet e tyre, dhe na nevojitet që t'u sigurojmë atyre burime.
Dhe me ndihmën e metrikave ne shohim tendencën e konsumit të burimeve nga sistemet tona të informacionit. Dhe tashmë mbi këtë bazë mund të planifikojmë diçka. Në nivelin e virtualizimit ne mbledhim të dhëna dhe shohim informacionin mbi numrin e burimeve të disponueshme sipas qendrave të të dhënave. Dhe brenda qendrës së të dhënave shihet gjithashtu shfrytëzimi dhe shpërndarja reale, konsumimi i burimeve. Ndërkohë si me serverët standalone, ashtu edhe me makinat virtuale dhe grupet e serverëve fizikë, mbi të cilat këto makina virtuale funksionojnë me ritëm të shkëlqyer.
Perspektivat
Tani është kernel i sistemit në përgjithësi i gatshëm, por ka shumë aspekte mbi të cilat duhet të punojmë ende. Të paktën, ky është shtresa e sigurisë së informacionit, por është e rëndësishme gjithashtu të arrijmë në rrjet, të zhvillojmë alerturnin dhe të zgjidhim çështjen e korelacionit. Ne kemi shumë shtresa dhe sisteme; në çdo shtresë ka shumë metrika. Kështu, kemi një matryoshka në shkallë të matryoshkes.
Detyra jonë është të krijojmë alertra të sakta në fund. Për shembull, nëse ndodh një problem me pjesën harduerike, përsëri, me makinën virtuale, dhe aty kishte një aplikacion të rëndësishëm, dhe shërbimi nuk ishte rezervuar. Ne do të kuptojmë që makina virtuale ka vdekur. Pastaj do të alertojë metrikat e biznesit: përdoruesit janë zhdukur, nuk ka konvertime, UI në ndërfaqe është i paaksesueshëm, gjithashtu edhe softueri dhe shërbimet kanë vdekur.
Me një situatë të tillë, ne do të marrim spam nga alertrat, dhe kjo nuk përputhet me standardet e një sistemi monitorimi të saktë. Ngrihet çështja e korelacionit. Prandaj, në mënyrë ideale, sistemi ynë i monitorimit duhet të thotë: "Djem, makina fizike ka vdekur, dhe së bashku me të këtë aplikacion dhe këto metrika", me ndihmën e një alertri, në vend që të na mbushin me njëqind alertra. Ai duhet të raportojë për gjërat kryesore - për shkakun, i cili ndihmon në shpejtësinë e zgjidhjes së problemit përmes lokalizimit të tij.
Sistemi ynë i njoftimit dhe përpunimi i alertrave është ndërtuar rreth një shërbimi të linjës së nxehtë 24/7. Të gjitha alertrat që konsiderohen si të domosdoshme dhe janë përfshirë në listën e kontrollit, dërgohen atje. Çdo alertr duhet patjetër të ketë një përshkrim: çfarë ka ndodhur, çfarë do të thotë kjo, çfarë ndikon. Dhe gjithashtu një lidhje me panelin e kontrollit dhe një udhëzim për atë që duhet të bëjmë në këtë rast.
Këto janë të gjitha kërkesat për ndërtimin e alertrave. Situata mund të zhvillohet në dy drejtime - ose problemi ekziston dhe duhet zgjidhur, ose ka ndodhur një defekt në sistemin e monitorimit. Por në çdo rast, duhet të shkojmë dhe të kuptojmë.
Në mesatare, tani na bien rreth njëqind alertra në ditë, kjo është duke marrë parasysh se korelacioni i alertrave ende nuk është konfiguruar siç duhet. Dhe nëse është e nevojshme të kryhen punë teknike, dhe ne ndalojmë diçka me forcë, numri i ndonjëherë rritet shumë herë.
Përveç monitorimit të sistemeve që ne përdorim dhe mbledhjes së metrikeve që ne e shohim si të rëndësishme, sistemi i monitorimit lejon mbledhjen e të dhënave për ekipet produkti. Ato mund të ndikojnë në përbërjen e metrikeve brenda sistemeve informative që monitorohen nga ne.
Kolegët tanë mund të vijnë dhe të kërkojnë të shtojnë ndonjë metrikë që do të jetë e dobishme si për ne, ashtu edhe për ekipin. Ose, p.sh., ekipi mund të mos ketë mjaftueshëm metrika bazë që kemi, ata duhet të ndjekin diçka specifike. Në Grafana, krijojmë hapësira për secilin ekip dhe ofrojmë të drejta administratori. Po ashtu, nëse ekipi ka nevojë për dashboarde dhe ata vetë nuk mund / nuk dinë si ta bëjnë këtë, ne i ndihmojmë.
Duke qenë se ne jemi jashtë rrjedhës së krijimit të vlerave të ekipit, lëshimeve dhe planifikimit, gradualisht po arrijmë në përfundimin se lëshimet e të gjithë sistemeve janë pa pengesa dhe mund të dalin çdo ditë, pa u marrë parasysh me ne. Dhe është e rëndësishme të ndjekim këto lëshime, sepse potencialisht ato mund të ndikojnë në funksionimin e aplikacionit dhe të shqetësojnë diçka, që është kritike. Për menaxhimin e lëshimeve ne përdorim Bamboo, nga ku marrim të dhënat përmes API dhe mund të shohim se cilat lëshime janë bërë në cilat sisteme informative dhe statusin e tyre. Dhe më e rëndësishmja - në cilin kohë. Ne vendosim markat për lëshimet në metrike kritike kryesore, që vizualisht është shumë treguese në rast problemesh.
Kështu, ne mund të shohim korrelacionin midis lëshimeve të reja dhe problemeve që dalin. Ideja kryesore është të kuptojmë se si funksionon sistemi në të gjitha nivelet, të lokalizojmë shpejt problemin dhe ta korrigjojmë po aq shpejt. Sepse shpesh ndodh që më shumë kohë shpenzohet për të gjetur shkakun, sesa për të zgjidhur problemin.
Dhe për këtë drejtim në të ardhmen ne duam të fokusohemi në proaktivitetin. Ideali do të ishte të mësojmë paraprakisht për një problem në ardhje, e jo pas faktit, për të marrë masa parandaluese, jo për ta zgjidhur atë. Ndonjëherë ndodhin alarmet false të sistemit të monitorimit, si për shkak të gabimeve njerëzore, ashtu edhe për shkak të ndryshimeve në aplikacion. Ne po punojmë për këtë, e po e përmirësojmë sistemin dhe përpiqemi që para çdo manipulimi me sistemin e monitorimit të paralajmërojmë përdoruesit që e përdorin atë së bashku me ne, ose të kryejmë këto aktivitete në kohë teknike.
Pra, sistemi u aktivizua dhe funksionon me sukses që nga fillimi i pranverës... dhe tregon një fitim të vërtetë. Sigurisht, kjo nuk është versioni përfundimtar, ne do të implementojmë shumë shërbime të tjera të dobishme. Por pikërisht tani, me një numër të madh integrimesh dhe aplikacionesh, pa automatizimin e monitorimit, në të vërtetë nuk mund të kalojmë.
Nëse ju gjithashtu monitoroni projekte të mëdha me një sasi serioze integrimesh — shkruani në komentet, çfarë zgjidhjeje kërkuese keni gjetur për këtë.
Burimi: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish