

Le të shqyrtojmë konceptin e monitorimit të Kubernetes, të njihemi me mjetin Prometheus dhe të flasim për alarmin.
Tema e monitorimit është e gjerë; nuk mund të shqyrtohet në një artikull të vetëm. Qëllimi i këtij teksti është të ofrojë një pasqyrë të përgjithshme mbi veglat, konceptet dhe qasjet.
Materiali i artikullit është një përmbledhje nga . Nëse dëshironi të ndiqni një trajnim të plotë — regjistrohuni në kursin mbi .
Çfarë monitorohet në klasterin Kubernetes
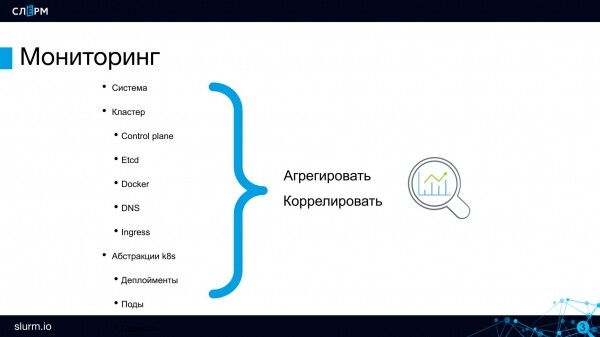
Serverat fizikë. Nëse klasteri i Kubernetes është instaluar në serverat tuaj, duhet të monitoroni shëndetin e tyre. Kjo detyrë përmbushet nga Zabbix; nëse punoni me të, nuk duhet të heqni dorë, nuk do të ketë konflikte. Zabbix e monitoron gjendjen e serverëve tanë.
Le të kalojmë në monitorimin në nivelin e klasterit.
Komponentët e Control Plane: API, Planifikuesi dhe të tjerë. Të paktën, duhet të monitoroni që numri i serverëve API ose etcd të jetë më shumë se 0. Etcd është në gjendje të ofrojë shumë metrika: për diskët që ai operon, për shëndetin e vet të klasterit etcd dhe të tjera.
Docker ka lindur prej kohe dhe problemet e tij janë të njohura për të gjithë: shumë konteinerë shkaktojnë ngadalësime dhe probleme të tjera. Prandaj, duhet gjithashtu të monitoroni vetë Dockerin, edhe për nga disponueshmëria.
DNS. Nëse në klaster dështon DNS, atëherë do të dështojë gjithashtu e gjithë shërbimi i Discovery, dhe komunikimet midis konteinerëve do të ndalojnë. Në praktiken time nuk kam hasur në probleme të tilla, por kjo nuk do të thotë se nuk duhet të monitoroni gjendjen e DNS. Mund të monitoroni vonesat në kërkesa dhe disa metrika të tjera në CoreDNS.
Ingress. Duhet të monitoroni disponueshmërinë e ingress-ëve (përfshirë Ingress Controller) si pika hyrëse në projekt.
Në kemi shqyrtuar komponentët kryesorë të klasterit — tani le të zhytemi më thellë, në nivelin e abstraksioneve.
Duket se aplikacionet ekzekutohen në konteinerë, prandaj duhet t'i kontrollojmë, por në të vërtetë jo. Konteinerët janë efemerë: sot punojnë në një server, nesër në një tjetër; sot janë 10, nesër 2. Prandaj, askush nuk monitoron thjesht konteinerët. Brenda arkitekturës mikro-shërbimesh, është më e rëndësishme të monitoroni disponueshmërinë e aplikacionit si një tërësi. Konkretisht, të kontrolloni disponueshmërinë e endpoint-eve të shërbimit: a funksionon ndonjë gjë? Nëse aplikacioni është i aksesueshëm, atëherë çfarë ndodh pas tij, sa replikat ka tani — këto janë pyetje të natyrave të dyta. Të monitorosh instancat e veçanta nuk është e nevojshme.
Në nivelin e fundit, duhet të kontrolloni funksionimin e aplikacionit vetë, të merren metrikat e biznesit: numri i porosive, sjellja e përdoruesve dhe të tjera.
Prometheus
Sistemi më i mirë për monitorimin e klasterit është . Nuk di asnjë mjet që mund të krahasohet me Prometheus për cilësi dhe lehtësi përdorimi. Ai është i përshtatshëm për infrastrukturë fleksibël, prandaj kur flitet për «monitorimin e Kubernetes», zakonisht nënkupton Prometheus.
Ka disa opsione për të filluar punën me Prometheus: me ndihmën e Helm mund të instaloni Prometheus tradicional ose Prometheus Operator.
- Prometheus tradicional. Ai funksionon mirë, por duhet të konfigurohet ConfigMap - në thelb, të shkruhen skedarë konfigurimi tekstual, siç bënim më parë, para arkitekturës mikroshërbimesh.
- Prometheus Operator është pak më kompleks, pak më i ndërlikuar në logjikën e brendshme, por është më e lehtë të punosh me të: ka objekte të veçanta, abstraksione që shtohen në klaster, prandaj është shumë më e lehtë t'i kontrollosh dhe t'i konfigurosh.
Për të kuptuar produktin, ju rekomandoj fillimisht të instaloni Prometheus tradicional. Do të duhet të gjithë ta konfiguroni përmes konfigurimit, por kjo do t'ju ndihmojë: do të kuptoni se çfarë lidhet me çfarë dhe si të konfigurohet. Në Prometheus Operator ju menjëherë ngjiteni në një abstraksion më të lartë, megjithatë, nëse dëshironi të thelloheni në thellësi, kjo gjithashtu do të jetë e mundur.
Prometheus është shumë i integruar me Kubernetes: mund të qaset në API Server dhe të ndërveprojë me të.
Prometheus është popullor, prandaj mbështetet nga shumë aplikacione dhe gjuhë programuese. Mbështetje nevojitet, pasi Prometheus ka formatin e vet të metrikave, dhe për ta dërguar atë nevojitet ose një bibliotekë brenda aplikacionit, ose një eksportues i gatshëm. Dhe ka shumë eksportues të tillë. Për shembull, ka një PostgreSQL Exporter: ai merr të dhënat nga PostgreSQL dhe i konverton ato në formatin Prometheus, në mënyrë që Prometheus të mund të punojë me to.
Arkitektura e Prometheus
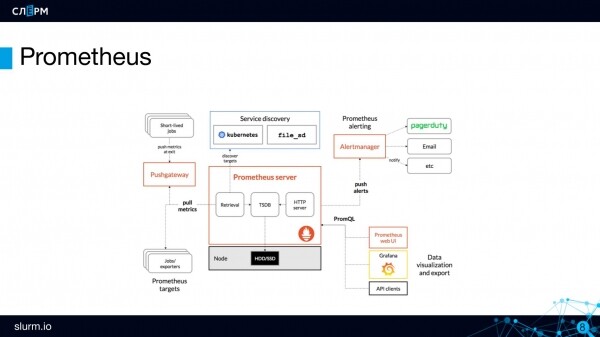
Prometheus Server — është pjesa serverike, truri i Prometheus. Këtu ruhen dhe përpunohen metrikat.
Metrikat ruhen në një bazë të të dhënave të serive të kohës (TSDB). TSDB nuk është një bazë e veçantë të dhënash, por një paketë në gjuhën Go, e cila është e integruar në Prometheus. Thënë thjesht, gjithçka ndodhet në një binar të vetëm.
Mos e ruhni të dhënat në TSDB për një kohë të gjatë
Infrastruktura Prometheus nuk është e përshtatshme për ruajtjen afatgjatë të metrikave. Sipas parazgjedhjes, periudha e ruajtjes është 15 ditë. Ky kufizim mund të tejkalohet, por duhet të keni parasysh: sa më shumë të dhëna të ruani në TSDB dhe sa më gjatë ta bëni këtë, aq më shumë burime do të konsumoni. Ruajtja e të dhënave historike në Prometheus konsiderohet praktikë e keqe.
Nëse keni trafik të madh, numri i metrikave matet me qindra mijëra në sekondë, atëherë është më mirë të kufizoni ruajtjen sipas volumit të diskut ose sipas kohës. Zakonisht në TSDB ruhen "të dhëna të nxehta", metrikat për disa orë. Për ruajtje më të gjatë përdoren depozita të jashtme në ato databaza që vërtet janë të përshtatshme për këtë, si InfluxDB, ClickHouse etj. Kam dëgjuar shumë komente pozitive për ClickHouse.
Prometheus Server punon sipas modelit pull: ai vetë shkon për metrikat në ato endpoint-e që i kemi dhënë. I thamë: «shko në API Server», dhe ai shkon aty çdo n sekonda dhe merr metrikat.
Për objektet me jetëgjatësi të shkurtër (job ose cron job), të cilat mund të shfaqen në mes të periudhave të skrapimit, ka një komponent Pushgateway. Në të dërgohen metrikat nga objektet afatshkurtra: job u ngrit, kryen veprimin, dërgon metrikat në Pushgateway dhe përfundohet. Pas një kohe, Prometheus në ritmin e tij shkon dhe merr këto metrikat nga Pushgateway.
Për konfiguracionin e njoftimeve në Prometheus ka një komponent të veçantë — Alertmanager. Dhe rregullat e alërtimit — rregullat e alerting. Për shembull, duhet të krijoni një alert në rast se API serverët janë 0. Kur ngjarja ndodh, alerti dërgohet në menaxherin e alerteve për dërgim të mëtejshëm. Në alert manager ka gjithashtu konfigurime të mira për rotimin: një grup alertrash mund të dërgohet në bisedën Telegram të adminëve, një tjetër në bisedën e zhvilluesve, një e tretë në bisedën e infrastrukturës. Njoftimet mund të vijnë në Slack, Telegram, me email dhe në kanale të tjera.
Dhe përfundimisht, do të flas për karakteristikën kryesore të Prometheus — Discovering. Kur punoni me Prometheus, nuk është e nevojshme të tregoni adresat specifike të objekteve për monitorim, është e mjaftueshme të përcaktoni tipin e tyre. Kështu, nuk është e nevojshme të shkruani «ja IP-adresa, ja porti — monitoroni», përkundrazi duhet të përcaktoni se sipas cilave parime duhet të gjenden këto objekte (targetet — qëllimet). Prometheus vetë, në varësi të objekteve që janë aktualisht aktive, tërheq ato të nevojshme dhe i shton në monitorim.
Ky kyq i përshtatet mirë strukturës së Kubernetes, ku gjithçka gjithashtu lëviz: sot 10 serverë, nesër 3. Në mënyrë që të mos tregoni çdo herë adresën IP të serverit, shkruani një herë se si ta gjeni – dhe Discovering do ta bëjë këtë.
Gjuha Prometheus quhet PromQL. Me këtë gjuhë mund të merrni vlera të metrikeve të caktuara dhe më pas t'i procesoni ato, duke ndërtuar analiza në bazë të tyre.
https://prometheus.io/docs/prometheus/latest/querying/basics/

Kërkesë e thjeshtë

    container_memory_usage_bytes

Operacione matematikore

    container_memory_usage_bytes / 1024 / 1024

Funksione të integruara

    sum(container_memory_usage_bytes) / 1024 / 1024

Sqarimi i kërkesës

    100 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]) * 100)
Ndërfaqja e web-it të Prometheus
Prometheus ka një ndërfaqe web-i mjaft minimaliste. Ajo është mëse e përshtatshme për debug ose demonstruar.
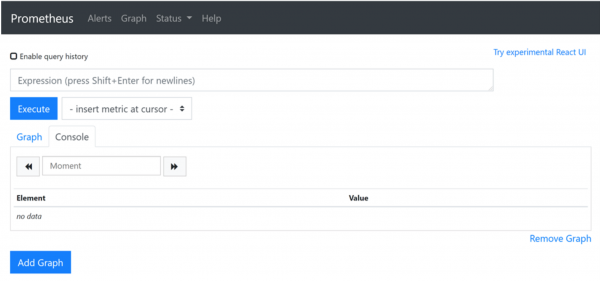
Në rreshtin Expression mund të shkruani kërkesë në gjuhën PromQL.
Në skedën Alerts ndodhen rregullat e alerteve – rregullat e alerteve, të cilat kanë tre status:
- inactive – nëse në momentin e tanishëm alerta nuk është aktiv, d.m.th. gjithçka është në rregull dhe nuk ka ndodhur;
- pending – kjo ndodh në rast se alerta ka ndodhur, por dërgimi ende nuk është kryer. Ka një vonesë, e cila vendoset për të kompensuar dridhjet e rrjetit: nëse në një minutë shërbimi i caktuar është rikthyer, atëherë alarmi nuk duhet të aktivizohet për momentin;
- firing – ky është statusi i tretë, kur alerta ndizet dhe dërgon njoftime.
Në menunë Status do të gjeni informacion mbi atë çfarë përfaqëson Prometheus. Aty ka gjithashtu kalime në qëllimet (targets), për të cilat folëm më sipër.
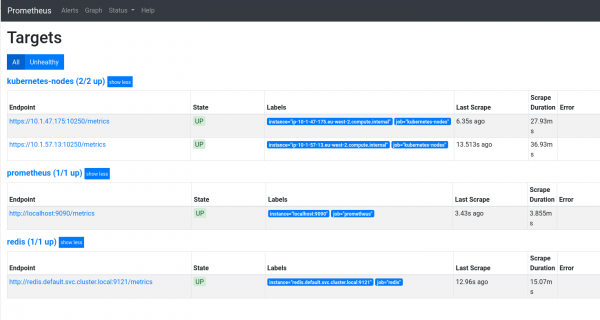
Për një shikim më të hollësishëm të ndërfaqes së Prometheus, shihni .
Integrimi me Grafana
Në ndërfaqen web të Prometheus nuk do të gjeni grafike të bukura dhe të kuptueshme, nga të cilat mund të nxirrni përfundime mbi gjendjen e klasterit. Për t'i ndërtuar ato, Prometheus integrohet me Grafana. Kështu krijohen këto tablo.
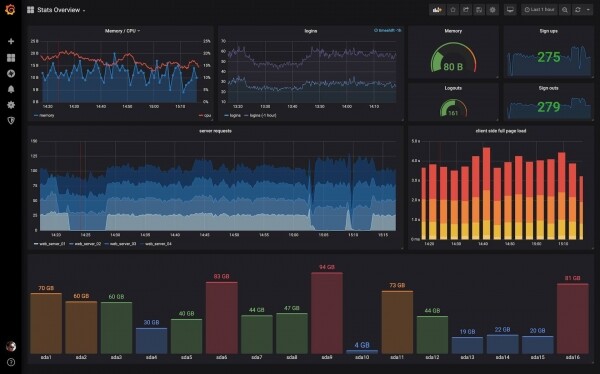
Të konfigurosh integrimin midis Prometheus dhe Grafana nuk është aspak e komplikuar, udhëzimet do t'i gjeni në dokumentacion: , dhe unë do ta përfundoj këtu.
Në artikujt e ardhshëm do të vazhdojmë temën e monitorimit: do të flasim për mbledhjen dhe analizën e logeve duke përdorur Grafana Loki dhe mjete alternative.
Autor: Marsel Ibraev, administrator i certifikuar Kubernetes, inxhinier praktik në kompaninë , folës dhe zhvillues kursesh të Slërm.
Burimi: habr.com
