

Historia e mëparshme
Ka janë automatë të zhvilluar vetë. Brenda kanë Raspberry Pi dhe pak rrethana në një pllakë të veçantë. Janë të lidhur me pranues monedhash, pranues bankar, terminal bankar… Një program i shkruar vetë menaxhon gjithçka. E gjithë historia e punës shkruhet në një gazetë në flash (MicroSD), e cila më pas transferohet përmes internetit (me një modem USB) në server, ku ruhet në një bazë të dhënash. Informacioni mbi shitjet ngarkohet në 1C, gjithashtu ka një ndërfaqe të thjeshtë web për monitorim etj.
Pra, gazeta është jetike — për regjistrimin (aty janë të ardhurat, shitjet etj.), monitorimin (çdo lloj defekti dhe rrethana të tjera shitore); kjo, mund të thuhet, është e gjithë informacioni që kemi për këtë automat.
Problemi
Flash-at tregojnë se janë pajisje shumë të pasigurta. Ato dështojnë me një rregullshmëri të admirueshme. Kjo çon në ndalesa të automatëve, si dhe (nëse për ndonjë arsye gazeta nuk mund të transferohet online) në humbje të dhënash.
Ky nuk është përvoja e parë me flash-at, më parë kishte një projekt tjetër me më shumë se njëqind pajisje, ku gazeta ruhej në flash USB, aty gjithashtu kishte probleme me besueshmërinë, ndonjëherë numri i pajisjeve të prishura në muaj arrinte dhjetëra. Provuan flash të ndryshme, duke përfshirë ato markë me memorie SLC, po disa modele janë më të besueshme se të tjerat, por zëvendësimi i flash-ave nuk zgjidhi problemin në mënyrë radikale.
Kujdes! Lexim i gjatë! Nëse nuk jeni të interesuar për "pse", por vetëm për "si", mund të shkoni menjëherë artikuj.
Zgjidhja
E para që më vjen në mend: të heqim dorë nga MicroSD, të përdorim, për shembull, SSD, dhe të ngarkohemi prej tij. Teoretikisht është e mundur, ndoshta, por relativisht e shtrenjtë, dhe nuk është ashtu shumë e besueshme (shtohet një adaptues USB-SATA; statistikat e dështimeve për SSD-të buxhetore nuk janë inkurajuese gjithashtu).
USB HDD gjithashtu nuk duken zgjidhje shumë tërheqëse.
Prandaj kemi arritur në këtë variant: të mbajmë ngarkimin nga MicroSD, por t'i përdorim ato në mënyrë read-only, dhe të ruajmë gazetën e punës (dhe informacionin tjetër unik për pajisjen — numrin e serisë, kalibrimet e sensorëve, etj.) diku tjetër.
Tema e FS read-only për Raspberry Pi është studiuar në thellësi, nuk do të ndalem në detajet e realizimit në këtë artikull (por nëse do të ketë interes — ndoshta do të shkruaj një mini-artikull mbi këtë temë). Një pikë e vetme që do të doja të theksoja: sipas eksperiencës personale dhe përmes komenteve të atyre që e kanë implementuar, ka përmirësim në besueshmëri. Po, është e pamundur të eliminosh plotësisht defektet, megjithatë, është mjaft e mundshme të zvogëlohet ndjeshëm frekuenca e tyre. Për më tepër, kartat bëhen uniformeshe, e cila dukshëm e lehtëson zëvendësimin për personelin e shërbimit.
Pjesa harduerike
Nuk kishte dyshime të veçanta për zgjedhjen e tipit të memories — NOR Flash.
Argumentet:
- lidhje e thjeshtë (zakonisht autobusi SPI, përvojë në përdorimin e tij ekziston, kështu që nuk parashikohen probleme 'hardware');
- çmim qesharak;
- protokoll standard i funksionimit (implementimi është tashmë në bërthamën Linux, nëse dëshirohet, mund të marrësh një të tretë, që gjithashtu ekziston, ose madje të shkruash tuajin, për të cilin gjithçka është e thjeshtë);
- besueshmëri dhe qëndrueshmëri:
nga një datasheet tipik: të dhënat ruhen për 20 vjet, 100000 cikle erase për secilin bllok;
nga burime të jashtme: BER jashtëzakonisht i ulët, postulohet se nuk është e nevojshme të përdoren kodet për korrigjimin e gabimeve (në disa punime shqyrtohet ECC për NOR, por zakonisht atje kanë parasysh MLC NOR, ka dhe të tilla).
Le të vlerësojmë kërkesat për vëllimin dhe qëndrueshmërinë.
Kemi dëshirë që të dhënat të ruhen me garanci për disa ditë. Kjo është e nevojshme për të siguruar që në rast ndonjë problemi me komunikimin historia e shitjeve të mos humbasë. Do të orientoheni në 5 ditë, gjatë kësaj periudhe (edhe duke marrë parasysh fundjavat dhe festat) mund të zgjidhet problemi.
Tani për tani, për një ditë grumbullohen rreth 100kB të journal-it (3-4 mijë regjistrime), megjithatë gradualisht kjo shifër po rritet — po rritet detajimi, po shtohen ngjarje të reja. Gjithashtu ndonjëherë ka shpërthime (ndonjë sensor fillon të dërgojë njoftime false, për shembull). Do të llogarisim mbi 10 mijë regjistrime me 100 byte — një megabajt në ditë.
Pra, gjithsej del 5MB të dhënash të pastra (të kompresueshme) përveç (vlerësim i shkrough) 1MB të dhënash shërbimi.
Pra, na nevojitet një çip 8MB nëse nuk përdorim kompresim, ose 4MB nëse e përdorim. Shifra mjaft reale për këtë lloj memorie.
Sa i përket qëndrueshmërisë: nëse planifikojmë që memoria të riprogramohet jo më shpesh se një herë në 5 ditë, atëherë gjatë 10 vjetëve të shërbimit ne do të kemi më pak se një mijë cikle riresh.
Kujtoj, prodhuesi premton njëqind mijë.
Pak për NOR vs NAND
Sot është e sigurt se sot memorie NAND është shumë më popullore, megjithatë për këtë projekt nuk do ta përdora: NAND, në krahasim me NOR, domosdoshmërisht kërkon përdorimin e kodave të korrigjimit të gabimeve, tabelës së bllokimeve të dështuar, etj., dhe këmbët e çipave NAND zakonisht janë shumë më të shumta.
Si disavantazhe të NOR mund të përmenden:
- vëllimi i vogël (dhe, për pasojë, çmimi i lartë për megabajt);
- shpejtësi e ulët e shkëmbimit (në masë të madhe për shkak se përdoret një ndërfaqe sekondare, zakonisht SPI ose I2C);
- fshirja e ngadalshme (në varësi të madhësisë së bllokut, zgjat nga disa pjesë të sekondës deri në disa sekonda).
Duket se nuk ka asgjë kritike për ne, kështu që vazhdojmë.
Nëse janë të interesuara për detajet, është zgjedhur çipi (megithatë, kjo është e parëndësishme, në treg ka shumë analoge, të përshtatshme sipas pinout dhe sistemit të komandave; madje edhe nëse dëshirojmë të vendosim një çip të prodhuesit tjetër dhe/ose me një vëllim të ndryshëm, gjithçka do të funksionojë pa ndryshuar kodin).
Unë përdor driver-in e ndërtuar në bërthamën Linux, në Raspberry falë mbështetjes së overlay-it të pemës së pajisjeve është shumë e thjeshtë — thjesht duhet të vendosësh overlay-në e kompiluar në /boot/overlays dhe të modifikosh pak /boot/config.txt.
Shembulli i skedarit dts
Sinqerisht, nuk jam i sigurt se është shkruar pa gabime, por funksionon.
/*
 * Device tree overlay for at25 at spi0.1
 */

/dts-v1/;
/plugin/;

/ {
    compatible = "brcm,bcm2835", "brcm,bcm2836", "brcm,bcm2708", "brcm,bcm2709";

    /* disable spi-dev for spi0.1 */
    fragment@0 {
        target = <&spi0>;
        __overlay__ {
            status = "okay";
            spidev@1{
                status = "disabled";
            };
        };
    };

    /* the spi config of the at25 */
    fragment@1 {
        target = <&spi0>;
        __overlay__ {
            #address-cells = <1>;
            #size-cells = <0>;
            flash: m25p80@1 {
                    compatible = "atmel,at25df321a";
                    reg = <1>;
                    spi-max-frequency = <50000000>;

                    /* default to false:
                    m25p,fast-read ;
                    */
            };
        };
    };

    __overrides__ {
        spimaxfrequency = <&flash>,"spi-max-frequency:0";
        fastread = <&flash>,"m25p,fast-read?";
    };
};
Dhe një rresht tjetër në config.txt
dtoverlay=at25:spimaxfrequency=50000000Përshkrimi i lidhjes së çipit me Raspberry Pi, e lë për anash. Nga njëra anë, nuk jam specialist në elektronikë, ndonjëherë — kjo është shumë e thjeshtë edhe për mua: çipi ka vetëm 8 ngjyrë, nga të cilat na nevojitet toka, energjia, SPI (CS, SI, SO, SCK); nivelet përputhen me ato të Raspberry Pi, nuk kërkohet ndonjë përbërje shtesë — thjesht lidhni këto 6 kontakte të shënuara.
Formulimi i detyrës
Si zakonisht, formulimi i detyrës kalon në disa iteracione, mendoj se ka ardhur koha për një tjetër. Kështu që të ndalojmë, të mbledhim së bashku atë që është shkruar tashmë dhe të sqarojmë detajet që mbeten në hije.
Pra, ne kemi vendosur që revista do të ruhet në SPI NOR Flash.
Çfarë është NOR Flash për ata që nuk e dinë
Kjo është memorie që nuk humb energjinë, me të cilën mund të bëjmë tre operacione:
- Leximi:
Leximi më i zakonshëm: dërgojmë adresën dhe lexojmë aq byte sa na nevojitet; - Shkrimi:
Në NOR flash, shkrimi duket si zakonisht, por ka një karakteristikë: mund të ndryshoni vetëm 1 në 0, por jo e kundërta. Për shembull, nëse në qelizën e memories ishte 0x55, pasi të shkruajmë 0x0f atje do të ruhet 0x05. (shih tabelën pak më poshtë); - Fshi:
Natyrisht, na nevojitet të bëjmë edhe operacionin e kundërt — të ndryshojmë 0 në 1, për këtë arsye ekziston operacioni fshi. I ndryshëm nga dy të parët, ai punon me blloqe (blloku minimal i fshirjes në çipin përkatës është 4kb). Fshirja shkatërron të gjithë bllokun si një njësi dhe kjo është mënyra e vetme për të ndryshuar 0 në 1. Prandaj, kur punoni me flash memory shpesh duhet të rregulloni strukturat e të dhënave në kufirin e bllokut të fshirjes.
Shkrimi në NOR Flash:
Të dhëna binarë
Ishte
01010101
E shkruam
00001111
U bë
00000101
Dhe libri i regjistrimeve është një varg shkrimesh me gjatësi të ndryshueshme. Gjatësia tipike e një shkrimi është rreth 30 byte (ndërsa ndonjëherë ndodhin edhe shkrime me gjatësi disa kilobajt). Në këtë rast, ne punojmë me to thjesht si një grup byte-esh, por, nëse jeni të interesuar, brenda shkrimeve përdoret CBOR.
Përveç regjistrit, na nevojitet të ruajmë disa informacione 'në konfigurim', si ato që përditësohen ashtu edhe jo: një ID të pajisjes, kalibrimet e sensorëve, një flamur 'pajisja është përkohësisht e çaktivizuar', etj.
Këto informacione përbëjnë një grup shkrimesh key-value, gjithashtu ruhet në CBOR. Këto informacione nuk janë shumë (maksimalisht disa kilobajt), dhe ato përditësohen jo shpesh.
Më vonë do t'i referohemi si konteksti.
Nëse kujtojmë nga e filluam këtë artikull, është shumë e rëndësishme të sigurohet besueshmëria e ruajtjes së të dhënave dhe, sa më shumë të jetë e mundur, puna e ndërprerë edhe në rast të papërfundimeve/humbjeve të të dhënave.
Cilat burime problemesh mund të shqyrtojmë?
- Çaktivizimi i energjisë gjatë operacioneve të shkrimit/fshirjes. Kjo është një nga ato situata për të cilat nuk ka zgjidhje.
Informacioni nga në stackexchange: gjatë çaktivizimit të energjisë në momentin e punës me flash, si fshirja (vendosja në 1), ashtu edhe shkrimi (vendosja në 0) çojnë në një sjellje të papërcaktuar: të dhënat mund të shkruhen, të shkruhen pjesërisht (duke thënë, ne i dërguam 10 byte/80 bit, por arritëm të shkruajmë vetëm 45 bit), është e mundshme që disa bitët të jenë në një gjendje 'ndërmjetëse' (leximi mund të japë si 0, ashtu edhe 1); - Gabime të flash memory vet.
BER, ndonëse shumë i ulët, nuk mund të jetë zero; - Gabime në autobusin
Të dhënat që transmetohen përmes SPI nuk janë aspak të mbrojtura, mund të ndodhin gabime të vetme bitesh, si dhe gabime sinkronizimi — humbja ose shtimi i bitëve (çka shkakton deformime masive të të dhënave); - Gabime / dështime të tjera
Gabime në kod, “bug-e” të Raspberry, ndërhyrje alienësh…
Kam formuluar kërkesat, plotësimi i të cilave, sipas mendimit tim, është i domosdoshëm për sigurimin e qëndrueshmërisë:
- shënimet duhet të kalojnë menjëherë në memorjen flash, shënimi i vonuar nuk konsiderohet; - nëse ndodh një gabim, duhet të zbulohet dhe trajtohet sa më shpejt të jetë e mundur; - sistemi duhet, sa të jetë e mundur, të rikuperojë funksionimin pas gabimeve.
(një shembull nga jeta “si nuk duhet të jetë”, me të cilin, mendoj, të gjithë jemi përballur: pas një rinisjeje emergjente, sistemi i skedarëve u prish dhe sistemi operativ nuk ngarkohet)
Ide, mënyra, reflektime
Kur fillova të mendoj për këtë detyrë, në mendjen time kalonin një mori idesh, për shembull:
- përdorimi i kompresimit të të dhënave;
- përdorimi i strukturave të sofistikuara të të dhënave, për shembull, ruajtja e titujve të shënimeve ndaras nga vetë shenimet, në mënyrë që nëse ndodhi një gabim në ndonjë shënim, mund të lexohet pa probleme pjesa tjetër;
- përdorimi i fushave bit për kontrollimin e përfundimit të shënimeve në rast ndalimi të energjisë;
- ruajtja e kontrolleve sumative për gjithçka;
- përdorimi i ndonjë lloji të kodimit të qëndrueshëm ndaj ndërhyrjeve.
Pjesa më e madhe e këtyre ideve u përdor, disa u vendosën të braktiseshin. Le të shkojmë radhazi.
Kompresimi i të dhënave
Ngjarjet që kemi regjistruar në ditar janë mjaft të ngjashme dhe përsëritëse (“hedhëm monedhën 5 lekë”, “shtypëm butonin për të marrë kthimin”, …). Prandaj, kompresimi duhet të rezultojë mjaft efektiv.
Shpenzimet për kompresim janë të papërfillshme (procesori ynë është mjaft i fuqishëm, madje edhe në Pi-në e parë kishte një bërthamë me frekuencë 700MHZ, në modelet aktuale disa bërthama me frekuencë mbi një gigaherz), shpejtësia e komunikimit me magazinën nuk është e lartë (disa megabajt në sekondë), madhësia e shënimeve është e vogël. Për një rezultat, nëse kompresimi do të ketë ndonjë ndikim në performancë, do të jetë vetëm pozitiv (absolutisht e parëndësishme, thjesht po konstaton). Po të gjithë e dimë se nuk është embedded i vërtetë, por një Linux i zakonshëm — kështu që implementimi nuk duhet të kërkojë shumë përpjekje (mjafton të lidhim bibliotekën dhe të përdorim disa funksione prej saj).
Ishte marrë një pjesë e logut nga një pajisje në funksionim (1.7Mb, 70 mijë regjistra) dhe fillimisht u kontrollua për kompresion duke përdorur gzip, lz4, lzop, bzip2, xz, zstd që ishin në kompjuter.
- gzip, xz, zstd treguan rezultate të ngjashme (40Kb).
Më habit që xz i modës u tregua këtu në nivelin e gzip ose zstd; - lzip me cilësimet e paracaktuara dha një rezultat pak më të keq;
- lz4 dhe lzop treguan një rezultat jo shumë të mirë (150Kb);
- bzip2 tregoi një rezultat për habi të mirë (18Kb).
Pra, të dhënat kompresohen shumë mirë.
Kështu që (nëse nuk gjejmë disavantazhe fatale) kompresimi do të jetë! Thjesht sepse më shumë të dhëna do të mund të ruhen në të njëjtën flash.
Le të mendojmë për disavantazhet.
Problemi i parë: ne tashmë u dakorduam se çdo regjistër duhet të shkojë menjëherë në flash. Zakonisht, arkivatori grumbullon të dhëna nga rrjedha hyrëse derisa të vendosë se është koha të shkruajë në dalëse. Ne na nevojitet menjëherë një bllok i compruar të dhënash dhe ta ruajmë atë në memorie që nuk humbet energjinë.
Unë shoh tre rrugë:
- Të kompresojmë çdo regjistër me ndihmën e kompresionit me fjalor në vend të algoritmeve të shqyrtuara më sipër.
Një opsion mjaft funksional, por nuk më pëlqen. Për të siguruar një nivel të pranueshëm kompresioni, fjalori duhet të jetë ‘i aftë’ për të dhënat specifike, çdo ndryshim do të çonte në një rënie katastrofike të nivelit të kompresionit. Po, problemi zgjidhet me krijimin e një versioni të ri të fjalorit, por kjo është një dhimbje koke — na nevojitet të ruajmë të gjitha versionet e fjalorit; në çdo regjistër duhet të tregojmë se me cilin version të fjalorit është kompresuar… - Të kompresojmë çdo regjistër me algoritme 'klasike', por në mënyrë të pavarur nga të tjerët.
Algoritmet e shqyrtuara për kompresion nuk janë të dizajnuara për të punuar me regjistra të tillë në këtë madhësi (disa dhjetëra byte), koeficienti i kompresionit do të jetë dukshëm më i vogël se 1 (dmth, rritje e volumit të të dhënave në vend të kompresimit); - Të bëjmë FLUSH pas çdonjë regjistri.
Në shumë biblioteka të kompresionit ka mbështetje për FLUSH. Kjo është një komandë (ose një parametër për procedurën e kompresionit), dhe duke e marrë, arkivatori formon një rrjedhë të kompresuar në mënyrë që të mund të rikthejë të gjithë të dhënat e pakompresuar, të cilat tashmë ishin marrë. Një analog i tillësyncnë sistemet e skedarëve osecommitnë sql.
Çfarë është e rëndësishme, operacionet e ardhshme të kompresimit do të jenë në gjendje të përdorin fjalorin e akumuluar dhe shkalla e kompresimit nuk do të vuajë aq shumë si në variantin e mëparshëm.
Mendoj se është e qartë që kam zgjedhur opsionin e tretë, le të ndalemi pak më shumë te ai.
U gjet për FLUSH në zlib.
Bëra një test të ngarkesës në frymëzim të një artikulli, mora 70 mijë regjistrime të logarit nga një pajisje reale, me një madhësi faqe prej 60KB (për madhësinë e faqes do të kthehemi më vonë) mora:
Të dhënat burimore
Kompresimi gzip -9 (pa FLUSH)
zlib me Z_PARTIAL_FLUSH
zlib me Z_SYNC_FLUSH
Vëllimi, KB
1692
40
352
604
Në pamje të parë, çmimi që sjell FLUSH është tepër i lartë, megjithatë në të vërtetë kemi një zgjedhje të varfër - ose të mos kompresojmë fare, ose të kompresojmë (dhe shumë efektivisht) me FLUSH. Nuk duhet të harrojmë se kemi 70 mijë regjistrime, teprica që sjell Z_PARTIAL_FLUSH është vetëm 4-5 byte për regjistrim. Ndërsa koeficienti i kompresimit rezultoi të ishte pothuajse 5:1, që është më shumë se një rezultat i shkëlqyer.
Mund të duket e papritur, por në të vërtetë Z_SYNC_FLUSH është një mënyrë më efikase për të bërë FLUSH
Në rastin e përdorimit të Z_SYNC_FLUSH, katër byte të fundit të çdo regjistrimi do të jenë gjithmonë 0x00, 0x00, 0xff, 0xff. Dhe nëse i dimë ata - mund t'i heqim, kështu që madhësia përfundimtare rezulton të jetë vetëm 324KB.
Në artikullin që citoj, ka një shpjegim:
Një bllok i ri i tipit 0 me përmbajtje bosh është shtuar.
Një bllok i tipit 0 me përmbajtje bosh përbëhet nga:
- kryesori i bllokut me tre bit;
- 0 në 7 bit të barabartë me zero, për të arritur përputhshmërinë e bajtëve;
- sekuenca katër bajtëshe 00 00 FF FF.
Siç është e lehtë për t'u vërejtur, në bllokun e fundit para këtyre 4 bajtëve ndodhin nga 3 deri në 10 bit zero. Megjithatë, praktika ka treguar se bitët zero në të vërtetë janë minimalisht 10.
Ajo që zbulohet, këto blloqe kaq të shkurtra të të dhënave zakonisht (përgjithësisht?) kodohen me një bllok të tipit 1 (bllok i caktuar), i cili domosdoshmërisht përfundon me 7 bit zero, kështu që marrim 10-17 bit zero me siguri (dhe bitët e tjerë do të jenë zero me një probabilitet rreth 50%).
Pra, në të dhënat e testit, në 100% të rasteve para 0x00, 0x00, 0xff, 0xff vjen një bajt zero, ndërsa më shumë se një të tretën e rasteve - dy bajtë zero (ndoshta, shkaku është që unë po përdor CBOR binar, ndërsa gjatë përdorimit të JSON-it tekstual do të haseshin më shumë blloqe të tipit 2 - bllok dinamik, përkatësisht do të haseshin blloqe pa bajtë zero shtesë para 0x00, 0x00, 0xff, 0xff).
Prandaj, në të dhënat e testit të disponueshme mund të arrijmë të qëndrojmë nën 250KB të të dhënave të kompresuara.
Mund të kurseni pak më shumë duke u angazhuar në hedhjen e bitëve: tani po injorojmë praninë e disa bitëve zero në fund të bllokut, disa bita në fillim të bllokut gjithashtu nuk ndryshojnë...
Por këtu mora një vendim të fortë për të ndalur, ndryshe mund të arrija deri te zhvillimi i arkivuesit tim.
Në përgjithësi, unë nga të dhënat e mia testuese mora 3-4 byte në shkrim, faktori i kompresimit rezultoi më shumë se 6:1. Do të jem i sinqertë: nuk kisha pritur një rezultat të tillë, për mendimin tim, gjithçka që është më mirë se 2:1 është tashmë një përfitim që justifikon përdorimin e kompresimit.
Gjithçka është perfekte, por zlib (deflate) përfundimisht është një algoritëm kompresimi i njohur dhe disi i modës së vjetër. Një ndihmë e vetme që përdor si fjalor 32Kb të fundit nga rrjedha e të dhënave të pakompresuara, sot duket e çuditshme (do të thotë se nëse ndonjë bllok të dhënash është shumë i ngjashëm me atë që ishte në rrjedhën hyrëse 40Kb më parë, ai do të fillojë të arkivohet përsëri, dhe nuk do të referohet në hyrjen e kaluar). Në arkivuesit modernë të modës, madhësia e fjalorit më shpesh matet në megabajtë, jo në kilobajtë.
Prandaj, vazhdojmë hulumtimin tonë të vogël për arkivuesit.
Tjetri që u provua ishte bzip2 (më kujtohet, pa FLUSH tregoi një gradë fantastike kompresimi, gati 100:1). Fatkeqësisht, me FLUSH, ai tregoi performancë shumë të dobët, madhësia e të dhënave të kompresuara rezultoi më e madhe se e pakompresuar.
Hipotezat e mia për arsyet e dështimit
Libbz2 ofron vetëm një opsion flush, i cili, duket, pastron fjalorin (analogu i Z_FULL_FLUSH në zlib), nuk mund të flasim për ndonjë kompresim efektiv pas kësaj.
Dhe i fundit që u provua ishte zstd. Në varësi të parametrave, ai kompreson ose në nivele gzip, por shumë më shpejt, ose më mirë se gzip.
Fatkeqësisht, me FLUSH dhe ai tregoi vetë 'jo shumë': madhësia e të dhënave të kompresuara doli rreth 700Kb.
Unë në faqen e projektit në github, mora përgjigje që duhej të pritej deri në 10 byte të dhënash shërbimi për çdo bllok të dhënash të kompresuara, që është afërt me rezultatet e marra, nuk mund të arrijë deflate në asnjë mënyrë.
Në këtë pikë vendosa të ndalem me eksperimentet me arkivuesit (ndërsa xz, lzip, lzo, lz4 nuk u treguan mirë ende në fazën e testimit pa FLUSH, dhe nuk do të shqyrtoj algoritme kompresimi më ekzotike).
Kthehemi te problemet e arkivimit.
Problemi i dytë (siç thuhen sipas rendit, dhe jo sipas kuptimit) është se të dhënat e shkurtra përbëjnë një rrjedhë të vetme, në të cilën vazhdimisht ka referenca për pjesët e mëparshme. Kështu, në rast se ndonjë pjesë e të dhënave të shkurtra dëmtohet, ne humbasim jo vetëm blokun e papërpunuar të lidhur me të, por edhe të gjithë pasuesit.
Ka dy qasje për zgjidhjen e këtij problemi:
- Parandaj shfaqjen e problemit — duke shtuar në të dhënat e shkurtra tepricë, e cila do të lejojë identifikimin dhe korrigjimin e gabimeve; për këtë do të flasim më vonë;
- Minimizoni pasojat në rastin e shfaqjes së problemit
Kemi thënë më parë se mund të kompresojmë çdo blok të dhënash në mënyrë të pavarur, në të njëjtën kohë problemi do të zhduket nga vetë. (Dëmtimi i të dhënave të një bloku do të rezultojë në humbjen e të dhënave vetëm të atij bloku). Megjithatë, kjo është një rast ekstrem, ku kompresimi i të dhënave do të ishte joefektiv. Ekstremi tjetër: përdorimi i të gjithë 4Mb të çip-it tonë si një arkiv të vetëm, që do të na jepte një kompresim të shkëlqyer, por pasojat katastrofike në rast se ndodhte ndonjë dëmtim i të dhënave.
Po, është e nevojshme një kompromis nga pikëpamja e besueshmërisë. Por duhet kujtuar se ne po zhvillojmë një format ruajtjeje të të dhënave për memorie të pavarur nga energjia me BER jashtëzakonisht të ulët dhe një periudhë ruajtjeje të deklaruar prej 20 vjetësh.
Në procesin e eksperimenteve, zbulova se humbjet më të dukshme në nivelin e kompresimit fillojnë në blloqet e dhënave të shkurtra me madhësi më të vogël se 10Kb.
Më parë u përmend se memoria e përdorur ka një organizim me faqe, nuk shoh arsyet për të mos përdorur përputhjen «një faqe — një bllok të dhënash të shkurtra».
Pra, madhësia minimale e arsyeshme e faqes është 16Kb (me rezerva për informacionin shërbim). Megjithatë, një madhësi kaq e vogël e faqes vendos kufizime të rëndësishme mbi madhësinë maksimale të regjistrimit.
Edhe pse deri më tani nuk parashikohet regjistrime më të mëdha se një kilobajt në formë të kompresuar, vendosa të përdor faqe me madhësi 32Kb (në total, kjo rezulton në 128 faqe për çip).
Përmbledhje:
- Të dhënat i ruajmë të kompresuara me zlib (deflate);
- Për çdo regjistrim vendosim Z_SYNC_FLUSH;
- Për çdo regjistrim të kompresuar, shkurtojmë bajtat përfundimtarë (p.sh., 0x00, 0x00, 0xff, 0xff); në titull tregojmë sa shumë bajta kemi prerë;
- Të dhënat ruhen në faqe me 32KB; brenda faqes ka një rrjedhë të vetme të dhënash të kompresuara; çdo herë që fillojmë kompresimin në një faqe, e bëjmë atë nga e para.
Dhe, para se të përfundojmë me kompresimin, dëshiroj të theksoj se të dhënat e kompresuara rezultojnë në disa byte për regjistrim, prandaj është jashtëzakonisht e rëndësishme të mos e fryj në informacionin shërbyes, çdo byte ka rëndësi.
Ruajtja e titujve të të dhënave
Duke qenë se regjistrimet tona kanë gjatësi të ndryshueshme, na nevojitet një mënyrë për të përcaktuar vendndodhjen/kuotat e regjistrimeve.
Unë njoh tre qasje:
- Të gjitha regjistrimet ruhen në një rrjedhë të vazhdueshme, fillimisht vjen titulli i regjistrimit, që përmban gjatësi, dhe pastaj regjistrimi vetë.
Në këtë variant, si titujt, ashtu dhe të dhënat mund të kenë gjatësi të ndryshueshme.
Në thelb, kemi një listë të lidhur njëdrejtim, e cila përdoret shpesh; - Titujt dhe regjistrimet ruhen në rrjedha të veçanta.
Duke përdorur tituj me gjatësi të vazhdueshme, ne sigurojmë që dëmtimi i një titulli nuk ndikon në të tjerët.
Një qasje e tillë përdoret, për shembull, në shumë sisteme skedarësh; - Regjistrimet ruhen në një rrjedhë të vazhdueshme, kufiri i regjistrimit përcaktohet nga një tregues të caktuar (simboli/ose sekuenca e simboleve, e cila është e ndaluar brenda blloqeve të të dhënave). Nëse brenda regjistrimit haset një tregues, ne e zëvendësojmë atë me një sekrecion (e shfrytëzojmë atë).
Një qasje e tillë përdoret, për shembull, në protokollin PPP.
Le të ilustroj.
Opsioni 1:
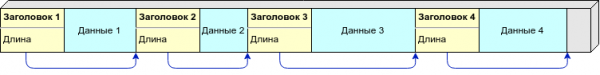
Këtu është shumë e thjeshtë: duke ditur gjatësi e regjistrimit, ne mund të llogarisim adresën e titullit të ardhshëm. Kështu ne lëvizim përmes titujve derisa të hasim një zonë që është e mbushur me 0xff (zonë e lirë) ose fundin e faqes.
Opsioni 2:
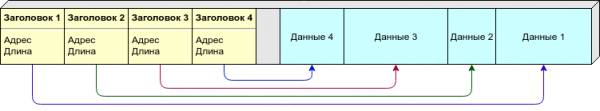
Për shkak të gjatësi së ndryshueshme të regjistrimeve, ne nuk mund ta themi paraprakisht sa shumë regjistrime (dhe tituj) na nevojiten për një faqe. Mund të ndajnë titujt dhe vetë të dhënat në faqe të ndryshme, por më pëlqen një qasje tjetër: dhe titujt, dhe të dhënat vendosen në të njëjtën faqe, megjithatë titujt (me gjatësi të vazhdueshme) fillojnë nga fillimi i faqes, ndërsa të dhënat (me gjatësi të ndryshueshme) - nga fundi. Sa herë që ata "takohen" (nuk ka mjaft vend për një regjistrim të ri) - e konsiderojmë këtë faqe të plotë.
Varianti 3:

Nuk e është e nevojshme të ruani në titull gjatësi ose ndonjë informacion tjetër mbi vendndodhjen e të dhënave, mjafton të keni shënjues që tregojnë kufijtë e regjistrimeve. Megjithatë, të dhënat duhet të përpunohen gjatë shkruajtjes/leximit.
Si shënjues do të përdorja 0xff (me të cilin mbushet pagina pas fshirjes), në këtë mënyrë zona e lirë saktësisht nuk do të interpretohet si të dhëna.
Tabela krahasuese:
Varianti 1
Varianti 2
Varianti 3
Qëndrueshmëria ndaj gabimeve
—
+
+
Kompaktësia
+
—
+
Sfidat e realizimit
*
**
**
Opsioni 1 ka një mangësi fatale: nëse ndonjë nga titujt dëmtohet, ne humbasim të gjithë zinxhirin që pason. Opsionet e tjera lejojnë rikuperimin e një pjese të të dhënave, madje edhe në raste dëmtimi masiv.
Por këtu është e përshtatshme të kujtojmë se kemi vendosur të ruajmë të dhënat në formë të kompresuar, kështu që edhe nëse tabela ka një minus, ne nuk e marrim parasysh.
Kompaktësia:
- në opsionin e parë na nevojitet të ruajmë në titull vetëm gjatësi, nëse përdorim variabla me gjatësi të ndryshueshme, në shumicën e rasteve mund të përdorim vetëm një byte;
- në opsionin e dytë na nevojitet të ruajmë adresën fillestare dhe gjatësi; regjistrimi duhet të ketë një madhësi të vazhdueshme, e vlerësoj në 4 byte për regjistrim (dy byte për zhvendosjen dhe dy byte për gjatësi);
- në opsionin e tretë, ne nevojiten vetëm një karakter për të treguar fillimin e regjistrimit, plus regjistrimi do të rritet për shkak të ekranizimit me 1-2%. Në përgjithësi, një barazi e afërt me opsionin e parë.
Fillimisht e konsiderova opsionin e dytë si një opsion kryesor (madje shkrova një realizim). E braktisa atë vetëm kur vendosa përfundimisht të përdor kompresim.
Ndoshta, ndonjëherë do ta përdor atë opsion. Për shembull, nëse duhet të merrem me ruajtjen e të dhënave për një anije që lundron mes Tokës dhe Marsit — kërkesa krejtësisht të tjera për besueshmëri, rrezatimi kozmik, …
Sa i përket opsionit të tretë: i kam dhënë dy yje për kompleksitetin e realizimit thjesht sepse nuk e pëlqej të merrem me ekranizimin, ndryshimin e gjatësi gjatë procesit, etj. Po, ndoshta, jam i njëanshëm, por kodi do të shkruhet nga unë — pse të detyroj veten të bëj atë që nuk më pëlqen.
Përmbledhje: zgjidhim opsionin e ruajtjes në formën e zinxhirëve "titulli me gjatësi - të dhëna me gjatësi të ndryshueshme" për shkak të efikasitetit dhe thjeshtësisë së realizimit.
Përdorimi i fushave të bitëve për të kontrolluar suksesin e operacioneve të shkruarjes
Tani nuk e mbaj mend se ku e pashë idenë, por duket gjithçka më shumë kështu:
Për çdo regjistrim, përzgjedhim disa bita për të ruajtur flamujt.
Siç diskutuam më parë, pas erase të gjithë bitët janë të mbushur me 1, dhe ne mund të ndryshojmë 1 në 0, por jo përkundrazi. Pra, për 'flamuri nuk është vendosur' përdorim 1, për 'flamuri është vendosur' - 0.
Ja se si mund të duket vendosja e regjistrimeve me gjatësi të ndryshueshme në flash:
- Vendosim flamurin 'regjistrimi i gjatë filloi';
- Regjistrojmë gjatësi;
- Vendosim flamurin 'regjistrimi i të dhënave filloi';
- Regjistrojmë të dhënat;
- Vendosim flamurin 'regjistrimi u përfundua'.
Përveç kësaj, do të kemi një flamur 'ndodhi një gabim', kështu që do të kemi gjithsej 4 flamuj bitësh.
Në këtë rast, kemi dy gjendje të qëndrueshme '1111' - regjistrimi nuk ka filluar dhe '1000' - regjistrimi kaloi me sukses; në rast të një ndërprerjeje të papritur të procesit të regjistrimit, do të kemi gjendje ndërlikuese, të cilat më pas do t'i zbulojmë dhe të trajtojmë.
Qasja është interesante, por ajo mbron vetëm nga ndëprerja e papritur e energjisë dhe çështje të ngjashme, që sigurisht është e rëndësishme, por kjo nuk është as e vetmja (dhe as kryesorja) arsye për mundësitë e dështimeve.
Përmbledhje: Le të vazhdojmë në kërkim të një zgjidhjeje të mirë.
Kontrolluar e shumave
Kontrolluar e shumave gjithashtu ofron mundësinë për të siguruar (me një probabilitet të mjaftueshëm) që ne po lexojmë pikërisht atë që duhej të ishte regjistruar. Dhe, për dallim nga fushat e bitëve të shqyrtuara më parë, ato funksionojnë gjithmonë.
Nëse shqyrtojmë listën e burimeve potenciale të problemeve, për të cilat folëm më parë, kontrolli i shumave është në gjendje të njohë gabimin pavarësisht nga origjina e tij (përveç, ndoshta, alienëve qëllim keq — ata mund të falsifikojnë edhe kontrollin e shumave).
Pra, nëse qëllimi ynë është të kontrollojmë se të dhënat janë në rregull, kontrolli i shumave është një ide e shkëlqyer.
Zgjedhja e algoritmit për llogaritjen e kontrollit të shumave nuk ngjalli pyetje - CRC. Nga njëra anë, pronat matematikore lejojnë që të kapen 100% gabimet e disa llojeve, nga ana tjetër - në të dhëna të rastësishme zakonisht ky algoritëm tregon probabilitetin e kolizionit jo shumë më të lartë se kufiri teorik.  Le të mos jetë algoritmi më i shpejtë, nuk është gjithmonë minimal për numrin e kolizionëve, por ai ka një cilësi shumë të rëndësishme: në testet që kam përjetuar, nuk kam hasur në modele ku ai dështonte qartë. Stabiliteti është cilësia kryesore në këtë rast.
Shembuj i një studimi të gjerë: , (linket në narod.ru, më vjen keq).
Megjithatë, detyra e zgjedhjes së kontrollit të shumës nuk është përmbyllur, CRC është një familje e tërë kontrollesh shumash. Duhet të përcaktohemi për gjatësi, e pastaj të zgjedhim polinom.
Zgjedhja e gjatësi së kontrollit të shumës nuk është një çështje aq e thjeshtë siç duket në shikimin e parë.
Le të ilustrojmë:
Le të themi se kemi probabilitet gabimi në çdo bajt  dhe një kontroll të përsosur të shumës, llogaritim numrin mesatar të gabimeve në një milion regjistrime:
Të dhënat, bajt
Kontrolli i shumës, bajt
Gabime të pa zbuluara
E zbuluar gabime false
Në total, ndodhitë e gabuara
1
0
1000
0
1000
1
1
4
999
1003
1
2
≈0
1997
1997
1
4
≈0
3990
3990
10
0
9955
0
9955
10
1
39
990
1029
10
2
≈0
1979
1979
10
4
≈0
3954
3954
1000
0
632305
0
632305
1000
1
2470
368
2838
1000
2
10
735
745
1000
4
≈0
1469
1469
Duket se gjithçka është e thjeshtë — zgjidh në përputhje me gjatësi e të dhënave të mbrojtura gjatësi e kontrollit të shumës me minimumin e ndodhitëve të gabuara — dhe puna është e lehtë.
Megjithatë, me kontroll të shkurtër të shumës, lind problemi: ato, ndonëse zbulojnë mirë gabimet e vetme të bitëve, mund të pranojnë rastësisht të dhëna krejtësisht të rastësishme me një probabilitet të mjaftueshëm. Në Habra kishte një artikull që përshkruante .
Prandaj, për ta bërë përputhjen rastësore të kontrollit të shumës praktikisht të pamundur, duhet të përdorim kontrolle të shumës me gjatësi 32 bit ose më shumë (për gjatësi më të mëdha se 64 bit zakonisht përdoren funksione kriptografike të hash-it).
Pavarësisht se më herët kam thënë se duhet të kursejmë hapësirë me çdo mënyrë të mundshme, do të përdorim kontroll të shumës 32-bit (16 bit është pak, probabiliteti i kolizionit është më shumë se 0.01%; dhe 24 bit, siç thonë, ashtu dhe këndej).
Këtu mund të lindë një kundërshtim: a ishim ne duke kursyer çdo bajt gjatë zgjedhjes së kompresimit, për të dhënë tani 4 bajta menjëherë? nuk do të ishte më mirë të mos kompresonim dhe nuk shtonim kontrollin e shumës? Sigurisht që jo, mungesa e kompresimit nuk do të thotë, që kontrolli i integritetit nuk na nevojitet.
Për zgjedhjen e polinomit nuk do të shpikim biçikletën, por do të marrim CRC-32C që është popullor tani.
Ky ky do zbulo 6 gabime bitësh në paketa deri në 22 byte (ndoshta rasti më i zakonshëm për ne), 4 gabime bitësh në paketa deri në 655 byte (gjithashtu një rast i zakonshëm për ne), 2 ose ndonjë numër të çuditshëm gabimesh bitësh në paketa të çdo gjatësie të arsyeshme.
Nëse dikujt i interesojnë detajet
për CRC.
në — ndoshta, specialisti kryesor për CRC në planet.
Në është , që ofron parametro pak më të mira për gjatësitë e paketave të rëndësishme për ne, por nuk e kam konsideruar ndryshimin si substancial, dhe jam i mjaftueshëm kompetent për të zgjedhur një kod të personalizuar në vend të një standaardi dhe të mirëstudiuar.
Një tjetër, pasi të dhënat tona janë të kompresuara, lind pyetja: a duhet të llogarisim checksum-in për të dhëna të kompresuara ose të pakompresuara?
Argumentet "pro" llogaritjes së checksum-it për të dhëna të pakompresuara:
- në fund na nevojitet të kontrollojmë integritetin e ruajtjes së të dhënave — pra, kjo është ajo që po kontrollojmë direkt (në të njëjtën kohë do të kontrollohen gjithashtu gabimet e mundshme në realizimin e kompresionit/dekompresionit, dëmtimet e shkaktuara nga memorie të korruptuara etj.);
- algoritmi deflate në zlib ka një realizim mjaft të pjekur dhe nuk duhet të dështojë me të dhënat hyrëse "të gabuara", madje, shpesh është në gjendje të zbulojë vetë gabimet në rrjedhën hyrëse, duke reduktuar kështu probabilitetin e përgjithshëm të moszbulimit të gabimeve (kam kryer teste duke invertuar një bit të vetëm në një regjistrim të shkurtër, zlib zbuloi gabimin në rreth një të tretën e rasteve).
Argumentet "kundër" llogaritjes së checksum-it për të dhëna të pakompresuara:
- CRC "është i dizajnuar" pikërisht për gabime bitësh të pakta, të cilat janë tipike për memorjen flash (një gabim bitësh në një rrjedhë të kompresuar mund të shkaktojë ndryshime masive në rrjedhën e daljes, në të cilën, teorikisht, mund të "kapim" një kolizion);
- nuk më pëlqen shumë ideja të dërgoj të dhëna potencialisht të dëmtuara për dekompresorin, , si do të reagojë ai.
Në këtë projekt, vendosa të largohem nga praktika e zakonshme të ruajtjes së checksum-it për të dhëna të pakompresuara.
Përmbledhje: përdorim CRC-32C, llogaritjen e checksum-it e bëjmë nga të dhënat në formën në të cilën regjistrohen në flash (pas kompresimit).
Shkalla e tepërt
Përdorimi i kodimit të tepërt nuk e përjashton, sigurisht, humbjen e të dhënave, megjithatë, ai mund të zvogëlojë ndjeshëm (shpesh me shumë rendi) probabilitetin e humbjes së pa rikuperueshme të të dhënave.
Ne mund të përdorim lloje të ndryshme të tepërtisë për të korrigjuar gabimet.
Kodet e Hamming-ut mund të korrigjojnë gabime të vetme bitësh, kodet e Reed-Solomon janë simbolike, disa kopje të të dhënave bashkë me shuma kontrolli ose kodimi si RAID-6 mund të ndihmojnë në rikuperimin e të dhënave edhe në rastin e dëmtimeve të mëdha.
Në fillim isha i përshtatur për përdorimin e gjerë të kodimit të qëndrueshëm ndaj shqetësimeve, por pastaj kuptova se së pari duhet të kemi një ide se nga cilat gabime duam të mbrohemi, dhe pastaj të zgjedhim kodimin.
Kemi folur më parë që gabimet duhet të identifikohen sa më shpejt të jetë e mundur. Kur mund të përballemi me gabime?
- Regjistrimi i papërfunduar (për arsye të ndryshme, energjia u ndal gjatë regjistrimit, Raspberry ngriti, …)
Fatkeqësisht, në rastin e tillë gabimi duhet vetëm të injorohet dhe të konsiderohen të dhënat të humbura; - Gabimet e regjistrimit (për arsye të ndryshme, në memorjen flash u regjistrua diçka që nuk ishte regjistruar)
Gabime të tilla mund të zbulojmë menjëherë, nëse pas regjistrimit bëjmë një lexim kontrollues; - Të dhënat e dëmtuara në memorie gjatë ruajtjes;
- Gabimet e leximit
Për të korrigjuar mjafton në rast mosmarrëveshje të shumës kontrolluese të përsërisim leximin disa herë.
Pra, vetëm gabimet e tipit të tretë (dëmtimi spontan i të dhënave gjatë ruajtjes) nuk mund të korrigjohen pa kodim të qëndrueshëm ndaj shqetësimeve. Mendoj se gabime të tilla janë akoma jashtëzakonisht të pakta.
Përmbledhje: U vendos të heqim dorë nga kodimi i tepërt, por nëse funksionimi tregoi se ky vendim ishte i gabuar, atëherë do të kthehemi në shqyrtimin e çështjes (me statistikën tani të grumbulluar mbi defektet, e cila do të lejojë zgjedhjen e llojit optimal të kodimit).
Të tjera
Natyrisht, formati i artikullit nuk lejon të argumentohet çdo bit në formatin (dhe unë tashmë kam shteruar forcën), prandaj do të kaloj shpejt mbi disa çështje që nuk janë prekur më parë.
- U vendos të bëjmë të gjitha faqet "të barabarta"
Do të thotë se nuk do të ketë ndonjë faqe speciale me metadatash, rrjedha të veçanta etj., në vend të kësaj një rrjedhë e vetme që shkruan të gjitha faqet njëpasnjërisht.
Kjo siguron një konsum të barabartë të faqeve, mungesën e një pikë të vetme dështimi, dhe thjesht pëlqehet; - Duhen parashikuar patjetër versionet e formatit.
Formati pa numrin e versionit në titull është e keqe!
Mjafton të shtoni në titullin e faqes një fushë me një Magic Number (nëshkrim), e cila do të tregojë versionin e përdorur të formatit. (nuk besoj se në praktikë do të ketë edhe dhjetëra të tillë); - Përdorni një titull me gjatësi variabël për shënimet (të cilat janë shumë të shumta), duke u përpjekur që për shumicën e rasteve ta bëni atë me gjatësi 1 byte;
- Për kodimin e gjatësi së titullit dhe gjatësi së pjesës së prerë të regjistrimit të kompresuar përdorni kode binare me gjatësi variabël.
Kjo ndihmoi shumë i kodit Huffman. Dosido për pak minuta arrita të gjej kodet e nevojshme me gjatësi variabël.
Përshkrimi i formatit të ruajtjes së të dhënave
Rendi i byte-ve
Fushat me një madhësi superiore se një byte ruhen në formatin big-endian (renditja e byte-ve në rrjet), që do të thotë se 0x1234 ruhet si 0x12, 0x34.
Ndarja në faqe
I gjithë memorja flash është e ndarë në faqe me një madhësi të barabartë.
Madhësia e faqes përfundohet në 32KB, por jo më shumë se 1/4 e madhësisë totale të çipit të memories (për një çip prej 4MB rezulton 128 faqe).
Çdo faqe ruan të dhëna indipendent nga të tjerat (do të thotë se të dhënat e një faqe nuk referojnë në të dhënat e një faqe tjetër).
Të gjitha faqet janë të numëruara në rendin e natyrshëm (në rendin e rritjes së adresave), duke filluar nga numri 0 (faqa zero fillon në adresën 0, e para në 32KB, e dyta në 64KB etj.)
Çipi i memories përdoret si një buffer ciklik (ring buffer), që do të thotë se së pari shkrimi bëhet në faqen me numër 0, pastaj në faqen me numër 1, …, kur mbushim faqen e fundit, fillon një cikël i ri dhe shkrimi vazhdon nga faqja zero.
Brenda faqes
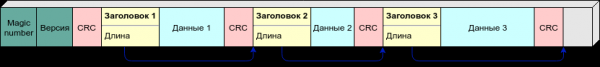
Në fillim të faqes ruhet një titull 4-byte të faqes, pastaj një kontrolle checksum të titullit (CRC-32C), më pas ruhen regjistrimet në formatin "titulli, të dhënat, checksum".
Titulli i faqes (në skemë me ngjyrë të gjelbër të errët) përbëhet nga:
- një fusht me dy byte Magic Number (ai është gjithashtu – shenja e versionit të formatit)
për versionin aktual të formatit e konsiderohet si0xed00 ⊕ numri i faqes; - i numëruesit dy-bajtësh 'Versioni i faqes' (numri i ciklit të ripërsëritjes së memories).
Të dhënat në faqe ruhen në format të kompresuar (përdoret algoritmi deflate). Të gjitha të dhënat në një faqe kompresohen në një rrjedhë (përdoret një fjalor i përbashkët), në çdo faqe të re kompresimi fillon nga e para. Kështu që për dekodimin e çdo të dhëne kërkohen të gjitha të dhënat e mëparshme nga kjo faqe (dhe vetëm nga kjo).
Çdo të dhënë kompresohet me flamurin Z_SYNC_FLUSH, ndërsa në fund të rrjedhës së kompresuar gjenden 4 byte 0x00, 0x00, 0xff, 0xff, të paraprirë ndoshta nga një ose dy byte të zeros.
Këtë sekuencë (të gjatë 4, 5 ose 6 byte) e heqim gjatë shkrimit në memorien flash.
Krye-headeri i të dhënës përbëhet nga 1, 2 ose 3 byte, që ruajnë:
- një bit (T), që tregon tipin e të dhënës: 0 — kontekst, 1 — log;
- një fushë me gjatësi variable (S) nga 1 deri në 7 bit, që përcakton gjatësi e headerit dhe "bishtin" që duhet të shtohet në të dhënën për dekompresim;
- gjatësinë e të dhënës (L).
TABELA E VLERAVE S:
S
Gjatësia e headerit, byte
Hiqet gjatë shkrimit, byte
0
1
5 (00 00 00 ff ff)
10
1
6 (00 00 00 00 ff ff)
110
2
4 (00 00 ff ff)
1110
2
5 (00 00 00 ff ff)
11110
2
6 (00 00 00 00 ff ff)
1111100
3
4 (00 00 ff ff)
1111101
3
5 (00 00 00 ff ff)
1111110
3
6 (00 00 00 00 ff ff)
Përdora për të ilustruar, nuk e di sa qartë doli:
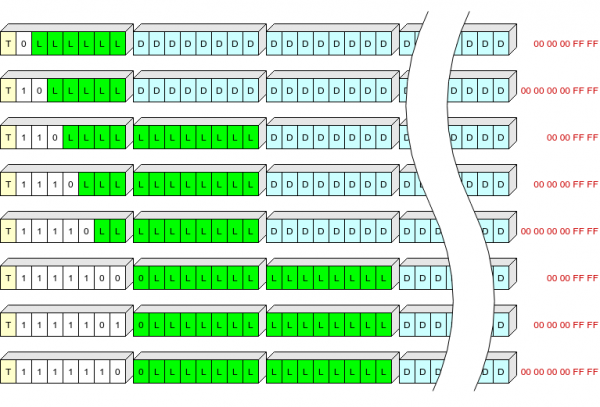
E verdha këtu tregon fushën T, e bardha fushën S, e gjelbra L (gjatësia e të dhënave të kompresuara në byte), e kaltërta të dhënat e kompresuara, e kuqja — byte përfundimtarë të të dhënave të kompresuara, që nuk shkruhen në memorien flash.
Pra, headerat e të dhënave me gjatësi më të zakonshme (deri në 63+5 byte në format të kompresuar) do t'i shkruajmë me një byte.
Pas çdo të dhëne ruhet një kontrolle CRC-32C, ku si vlerë fillestare (init) përdoret vlera e invertuar e kontrolles së mëparshme.
CRC ka pronën e 'vazhdimësisë', funksionon (plus-minus inverzimi i biteve në proces) një formulë e tillë:  .
Pra, në fakt, ne llogarisim CRC-në e të gjithë byte-ve të headerave dhe të dhënave në këtë faqe.
Menjëherë pas kontrollit të kontrolles ndodhet headeri i të dhënes të ardhshme.
Headeri është ndërtuar në një mënyrë që byte-i i tij i parë të jetë gjithmonë ndryshe nga 0x00 dhe 0xff (nëse përballë byte-it të parë të headerit hasim 0xff, atëherë kjo është një zonë që nuk është përdorur; 0x00 sinjalizon një gabim).
Algoritmet e përafërta
Leximi nga memorja flash
Çdo lexim bëhet me kontrollin e kontrolles.
Nëse suma e kontrollit nuk përputhet, leximet përsëriten disa herë me shpresën për të lexuar të dhënat e sakta.
(kjo ka kuptim, Linux nuk e ruan leximin nga NOR Flash, është provuar)
Shkruaj në memorjen flash
Po shkruajmë të dhënat.
Po i lexojmë ato.
Nëse të dhënat e lexuara nuk përputhen me ato të shkruara, plotësojmë zonën me zero dhe sinjalizojmë një gabim.
Përgatitja e çipës së re për punë
Për inicializim, në faqen e parë (më saktë, faqja e zero) shkruhet një titull me versionin 1.
Pas kësaj, në këtë faqe shkruhet konteksti fillestar (përmban UUID të automatikut dhe konfigurimet default).
Tani, memorja flash është e gatshme për punë.
Ngarkimi i automatikut
Në ngarkim, lexohen 8 byte të parë të çdo faqeje (titulli + CRC), faqet me numrin magjik të panjohur ose CRC të gabuar injorohen.
Nga faqet "e sakta" zgjidhen faqet me versionin maksimal, nga të cilat merret faqja me numrin më të madh.
Lexohet regjistrimi i parë, kontrollohet korrektësia e CRC, pranueshmëria e flamurit "kontekst". Nëse gjithçka është në rregull, kjo faqe konsiderohet e tanishme. Nëse jo, kthehemi në faqen e mëparshme derisa të gjejmë një faqe "aktive".
dhe në faqen e gjetur lexojmë të gjitha regjistrimet, ato me flamurin "kontekst" i aplikojmë.
Ruajmë fjalorin zlib (do të nevojitet për shkruajtur përsëri në këtë faqe).
Tani, ngarkimi përfundoi, konteksti u rikuperua, mund të punojmë.
Shtimi i regjistrimit në jurnal
Shtypim regjistrimin me fjalorin e duhur, duke treguar Z_SYNC_FLUSH. Shikojmë nëse regjistrimi i kompresuar ndodhet në faqen aktuale.
Nëse nuk ndodhet (ose në faqe kishte gabime CRC) fillojmë një faqe të re (shih më poshtë).
Shkruajmë regjistrimin dhe CRC. Nëse ndodhi një gabim, fillojmë një faqe të re.
Faqja e re
Zgjidhim një faqe të lirë me numrin minimal (faqja e lirë është ajo me kontroll të gabuar në titull ose me version më pak se aktuali). Nëse nuk ka faqe të tilla, zgjidhim faqen me numrin minimal nga ato që kanë versionin e njëjtë me aktualin.
Bëjmë që faqja e zgjedhur të fshihet. Kontrollojmë përmbajtjen me 0xff. Nëse diçka nuk është në rregull, marrim faqen e ardhshme të lirë, etj.
Në faqen e fshirë shkruajmë titullin, regjistrimi i parë është gjendja aktuale e kontekstit, regjistrimi tjetër është regjistrimi i pa shkruar i jurnalit (nëse ka).
Pranueshmëria e formatit
Sipas mendimit tim, ka dalë një format mjaft i mirë për ruajtjen e çdo lloj fluksi informacioni që mund të kompresohet (tekst i thjeshtë, JSON, MessagePack, CBOR, ndoshta protobuf) në NOR Flash.
Sigurisht, formati është ‘i përshtatur’ për SLC NOR Flash.
Nuk duhet përdorur me mbajtës me BER të lartë, si NAND ose MLC NOR. (a ekziston ndonjëherë një memorje e tillë në treg? kam parë përmendje vetëm në punimet mbi kodet e korrigjimit).
Për më tepër, nuk duhet përdorur me pajisje që kanë FTL të tyre: USB flash, SD, MicroSD, etj. (për një memorje të tillë, unë kam bërë një format me madhësi faqeje 512 byte, me një nënshkrim në fillim të çdo faqeje dhe numra unike regjistrimesh – ndonjëherë, nga një flash i ‘ngrirë’ arrija të rikuperoja të dhënat duke lexuar në mënyrë të thjeshtë radhazi).
Në varësi të detyrave, formati mund të përdoret pa ndryshime në flash nga 128 Kbit (16 Kb) deri në 1 Gbit (128 Mb). Nëse dëshiron, mund të përdoret edhe në çipe më të mëdha, vetëm, ndoshta, duhet të përshtatet madhësia e faqes. (Por këtu lind pyetja e qëllimshmërisë ekonomike, çmimi i NOR Flash-it të madh nuk është për t’u ngushëlluar).
Nëse ndonjë i interesuar mendon që formati është interesant dhe dëshiron ta përdorë në një projekt të hapur – shkruani, do të përpiqem të gjej kohë, ta përmirësoj kodin dhe ta publikoj në github.
Përfundim
Siç e shohim, përfundimisht formati ishte i thjeshtë. dhe edhe mjaft i mërzitshëm..
Në artikull është e vështirë të pasqyrohet evolucioni i pikëpamjes time, por besoni: në fillim dëshiroja të krijoja diçka të sofistikuar, të pandashme, që të mund të mbijetonte edhe pas një shpërthimi bërthamor në afërsi. Megjithatë, arsyetimi (shpresoj) përfundimisht fitoi dhe përparësitë u zhvendosën drejt thjeshtësisë dhe kompaktesës.
A mund të ndodhi që të kem qenë gabim? Po, natyrisht. Mund të ndodhë, për shembull, që kemi blerë një grup çipesh të papërshtatshme. Ose për ndonjë arsye tjetër, pajisjet nuk do të plotësojnë pritshmëritë për besueshmëri.
A kam unë një plan për këtë rast? Mendoj se pas leximit të artikullit, nuk keni dyshime se unë kam një plan. Dhe madje jo vetëm një.
Nëse flasim pak më seriozisht, formati është zhvilluar njëkohësisht si një variant funksional dhe si një ‘provë’.
Momentalisht, gjithçka funksionin normalisht në tryezë, për një kohë të shkurtër zgjidhja do të zbatohet. (rreth) në qindra pajisje, do të shohim se çfarë do të ndodhë në 'shfrytëzim' (shpresoj, formati lejon të detektojmë defektet në një mënyrë të besueshme; kështu që do të mund të mbledhim statistikë të plotë). Pas disa muajsh do të mund të dalim me përfundimet (dhe nëse nuk e kemi fat, atëherë edhe më herët).
Nëse gjatë përdorimit zbulohen probleme serioze dhe nevojiten përmirësime, patjetër që do të shkruaj për këtë.
Literatura
Nuk doja të hartoja një listë të gjatë të punimeve të përdorura, përfundimisht Google e kanë të gjithë.
Këtu vendosa të lë një listë gjetjesh që më dukeshin veçanërisht interesante, megjithatë gradualisht ato u përfshinë në tekstin e artikullit, dhe në listë mbeti vetëm një pikë:
- Mjeti nga autori zlib. Shton në një format të kuptueshëm përmbajtjen e arkivave deflate/zlib/gzip. Nëse duhet të merresh me strukturën e brendshme të formatit deflate (ose gzip) - e rekomandoj me ngulm.
Burimi: habr.com
