

Përshëndetje të gjithëve! Quhem Nikolai Golov. Më parë kam punuar në Avito dhe për gjashtë vjet kam drejtuar Data Platform, që do të thotë se kam punuar me të gjitha bazat: analitike (Vertica, ClickHouse), rrjedhëse dhe OLTP (Redis, Tarantool, VoltDB, MongoDB, PostgreSQL). Gjatë kësaj kohe kam mësuar shumë për bazat e të dhënave - nga më të ndryshmet dhe të çuditshmet, dhe për raste të pazakonta të përdorimit të tyre.
Tani punoj në ManyChat. Në thelb, është një start-up - i ri, ambicioz dhe në rritje të shpejtë. Dhe kur sapo fillova në kompaninë, u shfaq pyetja klasike: "Cfarë duhet të zgjedhë një start-up të ri nga tregu i DBMS dhe bazat e të dhënave?".
Në këtë artikull, i cili është i bazuar në fjalimin tim në , do të përgjigjem në këtë pyetje. Versioni në video të fjalimit është i disponueshëm në .
Baza të njohura të të dhënave të vitit 2020
Jemi në vitin 2020, shqyrtova rreth meje dhe pashë tre tipe DB.
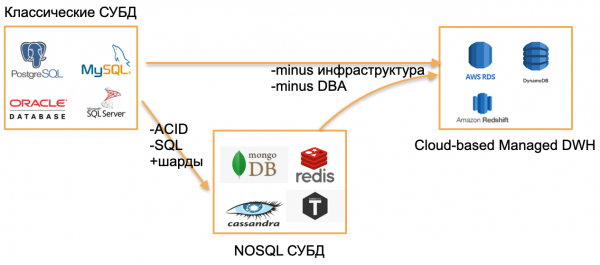
Tipi i parë - bazat OLTP klasike: PostgreSQL, SQL Server, Oracle, MySQL. Ato janë shkruar kohë përpara, por përmbajnë ende rëndësi, sepse janë të njohura mirë nga komuniteti i zhvilluesve.
Tipi i dytë - bazat e 'viteve të zero'. Ato përpiqeshin të iknin nga shabllonat klasike përmes heqjes dorë nga SQL, strukturat tradicionale dhe ACID, përmes shtimit të ndarjes së brendshme dhe karakteristika të tjera tërheqëse. Për shembull, kjo është Cassandra, MongoDB, Redis ose Tarantool. Të gjitha këto zgjidhje donin të ofronin diçka krejtësisht të re për tregun dhe zuri pozita të veçanta, sepse u treguan jashtëzakonisht të dobishme në disa detyra. Këto bazat do t'i quaj me termin e përgjithshëm NOSQL.
'Vitet e zero' përfunduan, u mësuam me bazat NOSQL, dhe bota, nga pikëpamja ime, bëri hapin e ardhshëm - në bazat e menaxhuara. Këto baza kanë thelbin e njëjtë si bazat OLTP klasike ose NoSQL të reja. Por ato nuk kanë nevojë për DBA dhe DevOps dhe funksionojnë në hardware të menaxhuar në cloud. Për një zhvillues, kjo është 'thjesht një bazë', që punon diku, dhe si është instaluar në server, kush e ka konfiguruar serverin dhe kush e përditëson atë, askujt nuk i intereson.
Shembuj të tillë të bazave janë:
- AWS RDS - një mbështetje e menaxhuar mbi PostgreSQL/MySQL.
- DynamoDB - analogja AWS e bazës së dhënave të tipit document, ngjan me Redis dhe MongoDB.
- Amazon Redshift - një bazë analitike e menaxhuar.
Në thelb janë bazat e vjetra, por të ngritura në një mjedis të menaxhuar, pa nevojën për të punuar me hardware.
Shënim. Shembujt janë të marrë për mjedisin AWS, por analogët e tyre ekzistojnë gjithashtu në Microsoft Azure, Google Cloud, ose Yandex.Cloud.
Cilët janë të rinjtë për këtë? Në vitin 2020, asgjë nga kjo.
Koncepsioni Serverless
Vërtet një e re në tregun e vitit 2020 — janë zgjidhjet pa serverë.
Do të përpiqem të shpjegoj se çfarë do të thotë kjo me shembuj nga një shërbim i zakonshëm ose aplikacion backend.
Për të implementuar një aplikacion backend të zakonshëm, blejmë ose marrim me qira një server, kopjojmë kodin aty, publikojmë një endpoint dhe paguajmë rregullisht për qiranë, elektricitetin dhe shërbimet e qendrës së të dhënave. Kjo është skema standarde.
A mund të bëhet ndryshe? Me shërbimet pa serverë, po.
Cila është magjia e këtij qasja: nuk ka server, as edhe qira për një instance virtuale në re. Për të implementuar një shërbim, kopjojmë kodin (funksionet) në një depo dhe publikojmë një endpoint. Më pas, thjesht paguajmë për çdo thirrje të kësaj funksioni, duke injoruar krejtësisht harduerin ku ekzekutohet.
Do të përpiqem ta ilustroj këtë qasje me pamje.
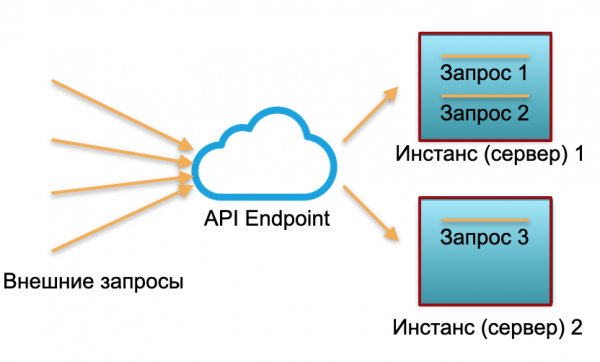
Implementimi klasik. Ne kemi një shërbim me një ngarkesë të caktuar. Aktivizojmë dy instance: serverë fizikë ose instanca në AWS. Këto instance drejtojnë kërkesat e jashtme që trajtohen aty.
Siç duket në figurë, serverët janë të shfrytëzuar në mënyrë të ndryshme. Njëri është shfrytëzuar në 100%, aty ka dy kërkesa, ndërsa një tjetër vetëm në 50% — është pjesërisht në pritje. Nëse vijnë jo tre kërkesa, por 30, atëherë e gjithë sistemi nuk do të përballojë ngarkesën dhe do të fillojë të ngadalësohet.
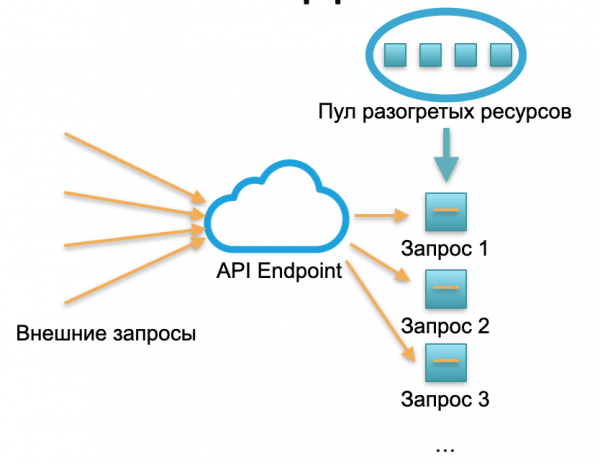
Implementimi pa serverë. Në një ambient pa serverë, ky shërbim nuk ka as instanca dhe as serverë. Ka një pool të caktuar burimesh të përgatitura — kontejnerë të vegjël Docker të përgatitur me kodin e funksionit. Sistemi merr kërkesa të jashtme dhe për secilën prej tyre, framework-u pa serverë aktivizon një kontejner të vogël me kodin: e trajton këtë kërkesë dhe shkatërron kontejnerin.
Një kërkesë — një kontejner i aktivizuar, 1000 kërkesa — 1000 kontejnerë. Dhe implementimi në serverët fizikë është punë e ofruesit të shërbimeve në re. Kjo është plotësisht e fshehur nga framework-u pa serverë. Në këtë koncept, ne paguajmë për çdo thirrje. Për shembull, nëse vjen një thirrje në ditë — ne paguajmë për një thirrje, nëse vijnë një milion në minutë — paguajmë për një milion. Ose në sekondë, kjo ndodh gjithashtu.
Koncepcioni i publikimit të funksioneve pa server përkon me një shërbim stateless. Por nëse keni nevojë për një shërbim statefull, atëherë i shtojmë një bazë të dhënash shërbimit. Në këtë rast, kur arrihet puna me state, çdo funksion statefull thjesht shkruan dhe lexon nga baza e të dhënave. Dhe mund të jetë nga çdo lloj base, nga ato tre lloje të përmendura në fillim të artikullit.
Cili është kufizimi i përgjithshëm për të gjitha këto baza? Këto janë shpenzimet për një server të përhershëm në cloud ose një server fizik (apo disa servera). Nuk ka rëndësi nëse përdorim një bazë klasike apo të menaxhuar, nëse ka DevOps dhe administratorë apo jo, gjithsesi paguajmë 24 orë në ditë për pajisjet, elektricitetin dhe qiranë e qendrës së të dhënave. Nëse kemi një bazë klasike, paguajmë për master dhe slave. Nëse është një bazë e ngarkuar me sharding — paguajmë për 10, 20 ose 30 servera, dhe paguajmë vazhdimisht.
Prania e serverave të rezervuar përherë në strukturën e shpenzimeve përpara perceptohej si një e keqe e paevitueshme. Baza të zakonshme kanë edhe vështirësi të tjera, të tilla si kufizimet e numrit të lidhjeve, kufizimi i shkallëzimit, konsensusi gjeo-distribuese — këto mund të zgjidhen në disa baza, por jo të gjitha njëherësh dhe jo në mënyrë të përsosur.
Baza e të dhënave pa server — teori
Pyetja e vitit 2020: a mund të bëjmë një bazë të dhënash gjithashtu pa server? Të gjithë kanë dëgjuar për backend pa server... le të provojmë ta bëjmë gjithashtu bazën e të dhënave pa server.
Kjo duket e çuditshme, sepse një bazë e të dhënave është një shërbim statefull, që nuk është shumë i përshtatshëm për infrastrukturën pa server. Për më tepër, gjithashtu, state-i në bazën e të dhënave është shumë i madh: gigabajtë, terabajtë, dhe në bazat analitike madje edhe petabajtë. Nuk është aq e lehtë ta ngritni atë në kontejnerë të lehtë Docker.
Nga ana tjetër, pothuajse të gjitha bazat moderne — janë një sasi e madhe logjike dhe komponentësh: transaksionet, ruajtja e integritetit, procedurat, varësitë rrelacionale dhe shumë logjikë. Një pjesë e madhe e logjikës së bazës së të dhënave kërkon një state të vogël. Gigabajtë dhe terabajtë përdoren drejtpërdrejt vetëm nga një pjesë e vogël e logjikës së bazës së të dhënave, e lidhur me ekzekutimin e menjëhershëm të pyetjeve.
Prandaj, ideja është: nëse një pjesë e logjikës lejon ekzekutimin stateless, pse të mos e ndajmë bazën në pjesë Stateful dhe Stateless.
Serverless për zgjidhjet OLAP
Le të shikojmë se si mund të duket ndarja e bazës së të dhënave në pjesë Stateful dhe Stateless në shembuj praktikë.
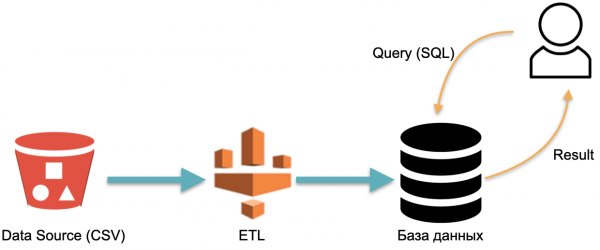
Për shembull, ne kemi një bazë të dhënash analitike: të dhënat e jashtme (cilindri i kuq në të majtë), procesi ETL që ngarkon të dhënat në bazë dhe analisti që dërgon kërkesat SQL në bazë. Kjo është një skemë klasike e funksionimit të magazinës së të dhënave.
Në këtë skemë, në një kuptim, ETL ekzekutohet një herë. Më pas duhet të paguash vazhdimisht për serverët, mbi të cilët punon baza me të dhënat e ngarkuara nga ETL, që të ketë ku të dërgosh kërkesat.
Të marrim parasysh një qasje alternative, të realizuar në bazën AWS Athena Serverless. Këtu nuk ka asnjë harduer të caktuar vazhdimisht, mbi të cilin ruhen të dhënat e ngarkuara. Në vend të kësaj:
- Përdoruesi dërgon një kërkesë SQL në Athena. Optimizuesi i Athena analizon kërkesën SQL dhe kërkon në depozitat e metadatos (Metadata) të dhënat specifike të nevojshme për përmbushjen e kërkesës.
- Optimizuesi, mbi bazën e të dhënave të grumbulluara, nxjerr të dhënat e nevojshme nga burimet e jashtme në një depozitë të përkohshme (baza e të dhënave temporale).
- Në depozitën e përkohshme ekzekutohet kërkesa SQL nga përdoruesi dhe rezultati i kthehet përdoruesit.
- Depozita e përkohshme pastron, burimet lirohen.
Në këtë arkitekturë, ne paguajmë vetëm për procesin e ekzekutimit të kërkesës. Nuk ka kërkesa — nuk ka shpenzime.
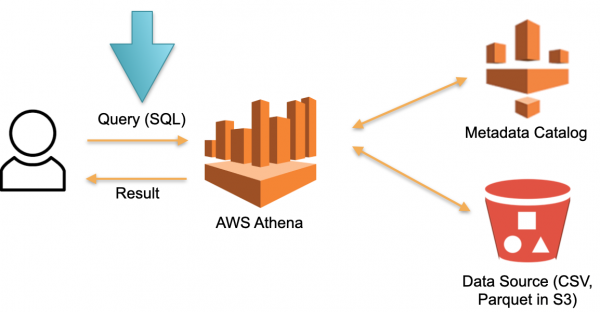
Kjo është një qasje funksionale dhe realizohet jo vetëm në Athena Serverless, por edhe në Redshift Spectrum (në AWS).
Në shembujt e Athena shihet se baza e të dhënave Serverless funksionon me kërkesa reale me dhjetëra dhe qindra Terabajt të dhënash. Për qindra Terabajt do të nevojiteshin qindra serverë, por ne nuk kemi nevojë të paguajmë për ta — ne paguajmë për kërkesat. Shpejtësia e çdo kërkese është (shumë) e ulët në krahasim me bazat e dhënash analitike të specializuara si Vertica, por për këtë arsye nuk paguajmë për periudhat e qëndrimit.
Një bazë e tillë e të dhënave është e përshtatshme për kërkesa analitike ad-hoc të ralla. Për shembull, kur ne spontanisht vendosim të verifikojmë një hipotezë mbi një volum të madh të të dhënash. Për këto raste Athena është ideale. Për kërkesat e rregullta, një sistem i tillë bëhet i shtrenjtë. Në këtë rast ruani të dhënat në ndonjë zgjidhje të specializuar.
Serverless për zgjidhjet OLTP
Në shembullin e mëparshëm u diskutuan detyrat OLAP (analitike). Tani do të shqyrtojmë detyrat OLTP.
Të imagjinoni një PostgreSQL ose MySQL në shkallëzueshme. Le të ngremë një instancë të menaxhuar të zakonshme PostgreSQL ose MySQL me burime minimale. Kur instanca të përballet me një ngarkesë më të madhe, ne do të lidhim replika të tjera, mbi të cilat do të shpërndajmë një pjesë të ngarkesës lexuese. Nëse nuk ka kërkesash dhe ngarkesash - çaktivizojmë replikat. Instanca e parë është master, ndërsa të tjerat janë replika.
Kjo ide është realizuar në një bazë të quajtur Aurora Serverless AWS. Parimi është i thjeshtë: kërkesat nga aplikacionet e jashtme pranohen nga flota proxy. Duke parë rritjen e ngarkesës, ai alokon burime llogaritëse nga instancat minimale të ngrira paraprakisht - lidhja realizohet sa më shpejt të jetë e mundur. Çaktivizimi i instancave ndodh po ashtu.
Brenda Aurora-s ekziston koncepti i Njësisë së Kapacitetit Aurora, ACU. Kjo është (në mënyrë të kushtezuar) - një instancë (server). Çdo ACU konkret mund të jetë master ose slave. Çdo Njësi Kapaciteti ka memorjen e saj të përkohshme, procesorin dhe një disk minimal. Prandaj, një master, ndërsa tjerat janë replika vetëm për lexim.
Numri i këtyre Njësive të Kapacitetit Aurora në funksion është një parameter i konfigurable. Numri minimal mund të jetë një ose zero (në këtë rast, baza nuk funksionon nëse nuk ka kërkesa).
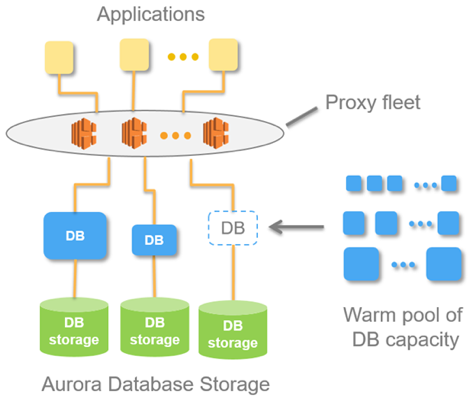
Kur baza merr kërkesa, flota proxy ngre Njësitë e Kapacitetit Aurora, duke rritur burimet e sistemit. Mundësia për të rritur dhe ulur burimet lejon sistemit të "llogarisë" burimet: automatikisht të tërheqë ACU të veçanta (në vend të tyre të reja) dhe të aplikojë të gjitha përditësimet aktuale mbi burimet e tërhequra.
Baza Aurora Serverless mund të shkallëzojë ngarkesën lexuese. Por në dokumentacion nuk thuhet drejtpërdrejt për këtë. Mund të krijohet ndjenja se ata mund të ngrejnë multi-master. Nuk ka ndonjë magji këtu.
Kjo bazë është shumë e përshtatshme për të shmangur shpenzimet e mëdha për sisteme me qasje të paqartë. Për shembull, kur krijojmë një MVP ose faqeshëngjyrash marketingu, zakonisht nuk presim një ngarkesë të qëndrueshme. Prandaj, në rast mos qasje, ne nuk paguajmë për instancat. Kur papritmas shfaqet ngarkesa, për shembull pas një konference ose fushate reklamimi, turmat e njerëzve hyjnë në faqe dhe ngarkesa rritet ndjeshëm; Aurora Serverless automatikisht pranon këtë ngarkesë dhe lidh shpejt burimet që mungojnë (ACU). Më pas, konferenca kalon, të gjithë e harrojnë prototipin, serverat (ACU) fikën dhe shpenzimet bien në zero - e përshtatshme.
Ky zgjidhje nuk është e përshtatshme për ngarkesë të lartë të qëndrueshme, sepse ajo nuk di të shkallëzojë ngarkesën e shkrimit. Të gjitha këto lidhje dhe çlodhje burimesh ndodhin në momentin e ashtuquajtur 'scale point' - momenti kur baza nuk mbahet nga transaksionet, as nga tabelat përkohshme. Për shembull, gjatë një jave mund të mos ndodhë scale point dhe baza punon me të njëjtat burime dhe thjesht nuk mund të zgjerë apo të ngushtohet.
Nuk ka magji - ky është PostgreSQL i zakonshëm. Por procesi i shtimit dhe çlodhjes të makinave është pjesërisht automatizuar.
Serverless by design
Aurora Serverless është një bazë e vjetër, e shkruar për në cloud, për të përdorur avantazhet specifike të Serverless. Tani do të flas për një bazë që është projektuar që nga fillimi për në cloud, me qasjen serverless - Serverless-by-design. Ajo është zhvilluar menjëherë pa supozuar se do të funksiononte në serverë fizikë.
Kjo bazë quhet Snowflake. Ajo ka tre blloqe kryesore.
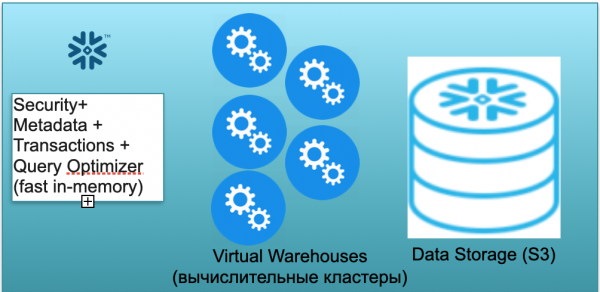
I pari - është blloku i metadatos. Ky është një shërbim i shpejtë në-memory, që zgjidh çështje sigurie, metadatash, transaksionesh dhe optimizimit të kërkesave (në ilustrimin nga e majta).
Blloku i dytë - është një numër i madh i klasterëve virtualë përllogaritës për llogaritjet (në ilustrimin - një grup topash blu).
Blloku i tretë - është sistemi i ruajtjes së të dhënave mbi bazën S3. S3 është një ruajtje objektesh e pandarë në AWS, diçka si një Dropbox i pandarë për biznes.
Le të shohim se si funksionon Snowflake, duke supozuar një fillim të ftohtë. Kështu që kemi bazën, të dhënat janë ngarkuar në të, por nuk ka kërkesa të ekzekutueshme. Prandaj, nëse nuk ka kërkesa për bazën, ne kemi ngritur një shërbim Metadata me shpejtësi të lartë në memorie (bloku i parë). Dhe kemi një depo S3, ku ruhen të dhënat e tabelave, të ndara në atë që quhet mikro-partita. Thjesht: nëse tabela përmban transaksione, mikro-partita janë ditët e transaksioneve. Çdo ditë është një mikro-partitë e veçantë, një skedar i veçantë. Dhe kur baza punon në këtë mod, ju paguani vetëm për hapësirën e zënë nga të dhënat. Çmimi për hapësirën është shumë i ulët (veçanërisht në marrëveshje me kompresimin e konsiderueshëm). Shërbimi i metadatave gjithashtu punon vazhdimisht, por për optimizimin e kërkesave nuk kërkon shumë burime dhe shërbimi mund të konsiderohet kushtimisht falas.
Tani imagjinoni se një përdorues i është afruar bazës sonë dhe ka dërguar një kërkesë SQL. Kërkesa SQL menjëherë procedohet në shërbimin Metadata. Pra, pasi merr kërkesën, ky shërbim analizon kërkesën, të dhënat e disponueshme, autorizimet e përdoruesit dhe, nëse gjithçka është në rregull, përgatit një plan për përpunimin e kërkesës.
Më pas, shërbimi iniciaton aktivizimin e grupit të llogaritjes. Grupi i llogaritjes është një grup serverësh që kryejnë llogaritjet. Kështu që ky grup mund të përmbajë 1 server, 2 serverë, 4, 8, 16, 32 — sa të dëshironi. Ju dërgoni kërkesën dhe menjëherë fillon aktivizimi i këtij grupi. Kjo vërtet merr disa sekonda.
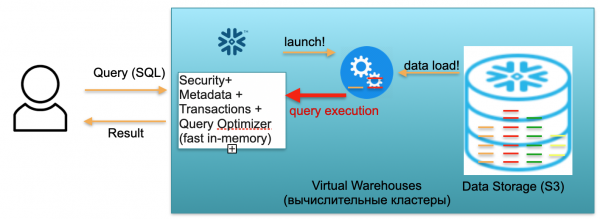
Më pas, pasi klasteri është nisur, mikro-particionet e nevojshme për trajtimin e kërkesës suaj fillojnë të kopjohen nga S3 në klaster. Kjo do të thotë që, le të supozojmë, për të ekzekutuar një kërkesë SQL, nevojiten dy partiçione nga një tabelë dhe një nga tjetra. Në këtë rast, në klaster do të kopjohen vetëm tre partiçione të nevojshme, dhe jo të gjitha tabelat. Pikerisht për këtë arsye dhe për shkak se gjithçka ndodhet brenda një qendre të dhënash dhe është e lidhur me kanale shumë të shpejta, tërë procesi i transferimit ndodh shumë shpejt: brenda sekondash, shumë rrallë — brenda minutash, nëse nuk bëhet fjalë për ndonjë kërkesë monstruoze. Për rrjedhojë, mikro-particionet kopjohen në klasterin llogaritës dhe, pas përfundimit, në këtë klaster ekzekutohet kërkesa SQL. Rezultati i kësaj kërkese mund të jetë një rresht, disa rreshta ose një tabelë — ato dërgohen jashtë për përdoruesin, në mënyrë që ai të mund t'i nxjerrë, t'i shfaqë në mjetin e BI, ose të përdorë ndonjë mënyrë tjetër.
Çdo kërkesë SQL nuk mund vetëm të llogarisë agregat nga të dhënat e ngarkuara më parë, por gjithashtu të ngarkojë/krijojë të dhëna të reja në bazë. Kjo do të thotë që mund të jetë një kërkesë që, për shembull, realizon një insertim në një tabelë tjetër të shënimeve të reja, e cila çon në shfaqjen e një partie të re në klasterin llogaritës, e cila, nga ana e saj, automatikisht ruhet në depozitën unike S3.
Skenari i përshkruar më sipër, nga ardhja e përdoruesit deri në ngritjes e klasterit, ngarkimi i të dhënave, ekzekutimi i kërkesave, marrja e rezultateve, paguhet sipas tarifës për minutat e përdorimit të klasterit të ngritur virtual, warehouse virtual. Tarifa varion në varësi të zonës AWS dhe madhësisë së klasterit, por, mesatarisht, është disa dollarë në orë. Klasteri me katër makina është dy herë më i shtrenjtë se ai me dy makina, dhe ai me tetë makina është edhe dy herë më i shtrenjtë. Janë të disponueshme variante nga 16, 32 makina, varësisht nga kompleksiteti i kërkesave. Por ju paguani vetëm për minutat kur klasteri është realisht në punë, sepse, kur nuk ka kërkesa, si të thuash, hiqni duar nga tastiera, dhe pas 5-10 minutash pritjeje (parametri i rregullueshëm), ai vetë do të fiket, do të çlirojë burimet dhe do të bëhet falas.
Një skenar absolutisht realist është ai ku ju dërgoni një kërkesë, klasteri shfaqet, mundësisht, për një minutë, dhe për një minutë tjetër ai llogaritet, më pas pesë minuta për të fikur, dhe në fund paguani për shtatë minuta funksionimi të këtij klasteri, dhe jo për muaj dhe vite.
Skenari i parë përshkruante përdorimin e Snowflake në një version për një përdorues. Tani le të imagjinojmë se ka shumë përdorues, që është më afër skenarit real.
Supozoni se kemi shumë analistë dhe raporte Tableau që vazhdimisht bombardojnë bazën tonë me shumë SQL-llogari analitike të thjeshta.
Përveç kësaj, le të supozojmë se kemi DSC (Shkencëtarë të Dhënash) shpikës që përpiqen të bëjnë gjëra të frikshme me të dhënat, duke operuar me dhjetëra Terabajt, analizuar miliarda e triliona rreshtash të dhënash.
Për dy llojet e ngarkesave të përshkruara më sipër, Snowflake lejon ngritjen e disa klasterësh të pavarur të llojeve të ndryshme të fuqisë. Këta klasterë të llogaritjes punojnë pavarësisht, por me të dhëna të përbashkëta të koherente.
Për një sasi të madhe kërkesash të lehta, mund të ngrini 2-3 klasterë të vegjël, me një përmasë, mundësisht, 2 makina secila. Ky veprim është i realizueshëm, gjithashtu, me anë të konfigurimeve automatike. Pra, ju thoni: "Snowflake, ngrit një klaster të vogël. Nëse ngarkesa rritet më shumë se një parametër të caktuar, ngrit një të dytë, të tretë të ngjashëm. Kur ngarkesa të fillojë të bjerë - fikni të tepërtit." Të siguroheni që, pavarësisht nga sa analistë vijnë dhe fillojnë të shikojnë raportet, të gjithë të kenë burime të mjaftueshme.
Në të njëjtën kohë, nëse analistët flenë, dhe raportet nuk shikohen nga askush - klasterët mund të fikën plotësisht dhe ju ndaloni pagesën për ta.
Në të njëjtën kohë, për kërkesa të rënda (nga DSC), mund të ngrini një klaster shumë të madh me një numër të supozuar prej 32 makinash. Ky klaster gjithashtu do të paguhet vetëm për minutat dhe orët kur atje funksionon kërkesa juaj gjigande.
Kjo mundësi e përshkruar më sipër lejon ndarjen sipas klasterëve jo vetëm dy, por edhe më shumë lloje ngarkesash (ETL, monitorim, materializim raporte, ...).
Të bëjmë një përmbledhje për Snowflake. Database kombinon një ide të bukur dhe një implementim funksional. Në ManyChat ne përdorim Snowflake për analitikën e të dhënave që kemi. Ne kemi më shumë se tre grupe, siç është shembulli, nga 5 në 9, me madhësi të ndryshme. Kemi grupe me 16 makinave, 2 makinash, dhe kemi edhe super-të vogla me 1 makinë për disa detyra. Ato shpërndajnë ngarkesën me sukses dhe na lejojnë të kursejmë shumë.
Database me sukses shkallëzon ngarkesën lexuese dhe shkruese. Ky është një ndryshim i Madh dhe një hap i madh përpara krahasuar me "Aurora", e cila trajtonte vetëm ngarkesën lexuese. Snowflake lejon që këto grupe kompjuterike të shkallëzojnë edhe ngarkesën shkruese. Pra, siç përmenda, ne në ManyChat përdorim disa grupe, grupe të vogla dhe super të vogla përdoren kryesisht për ETL, për ngarkimin e të dhënave. Dhe analistët punojnë në grupe mesatare, të cilat nuk preken nga ngarkesa ETL, prandaj punojnë shumë shpejt.
Meqenëse, database është e përshtatshme për detyra OLAP. Ndërkohë, me keqardhje, për ngarkesat OLTP nuk është ende e aplikueshme. Së pari, kjo bazë është kolonuese, me të gjitha pasojat që dalin nga kjo. Së dyti, vetë qasja, kur për çdo kërkesë rritni një grup kompjuterik sipas nevojës dhe e derdhni atë me të dhëna, për fat të keq, për ngarkesat OLTP ende nuk është e mjaftueshme e shpejtë. Sekondat e pritjes për detyrat OLAP janë normale, por për detyrat OLTP - është e papranueshme, do të ishte më mirë 100 ms, dhe akoma më mirë - 10 ms.
Përfundimi
Database pa server është e mundur përmes ndarjes së bazës së të dhënave në pjesë Stateless dhe Stateful. Ju ndoshta keni vënë re se në të gjitha shembujt e dhënë, pjesa Stateful - është, në terma të qartë, ruajtja e microparticioneve në S3, ndërsa Stateless - është optimizuesi, puna me metadat, trajtimi i pyetjeve të sigurisë, të cilat mund të ngrihen si shërbime të lehta dhe të pavarura Stateless.
Ekzekutimi i kërkesave SQL gjithashtu mund të perceptohet si shërbime me një gjendje të lehtë, të cilat mund të shfaqen në modalitet pa server, si grupet kompjuterike të Snowflake, duke shkarkuar vetëm të dhënat e nevojshme, duke ekzekutuar kërkesën dhe "dukur".
Baza pa serverless e nivelit prodhues është tashmë e disponueshme për t'u përdorur, ata po punojnë. Këto baza serverless janë gati të përballojnë detyrat OLAP. Fatkeqësisht, për detyrat OLTP ato aplikohen… me nuanca, sepse ka kufizime. Nga njëra anë, kjo është një disavantazh. Por, nga ana tjetër, kjo është një mundësi. Ndoshta ndonjë prej lexuesve do të gjejë një mënyrë për ta bërë një bazë OLTP plotësisht serverless, pa kufizime Aurora.
Shpresoj që ju ka interesuar. Për të ardhmen Serverless 🙂
Burimi: habr.com
