

Shën. përkth.: adaptimi i Kubernetes në GitLab konsiderohet si një nga dy faktorët kryesorë që kontribuojnë në rritjen e kompanisë. Megjithatë, deri përpara një kohe të shkurtër, infrastruktura e shërbimit online GitLab.com ishte ndërtuar mbi makina virtuale, dhe vetëm rreth një vit më parë filloi migrimi i saj në K8s, që ende nuk ka përfunduar. Na vjen mirë të prezantojmë përkthimin e një artikulli të fundit të inxhinierit SRE në GitLab në lidhje me se si po ndodh kjo dhe çfarë përfundimesh arrijnë inxhinierët që marrin pjesë në projekt.
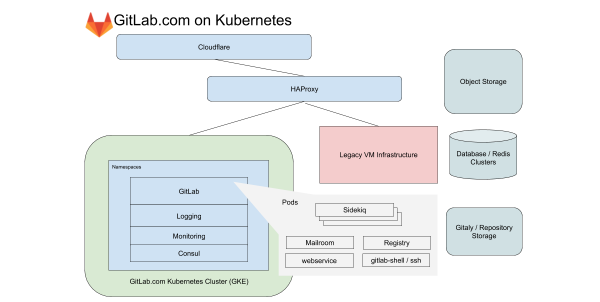
Që prej rreth një viti, departamenti ynë i infrastrukturës është angazhuar në migrimin e të gjithë shërbimeve që funksionojnë në GitLab.com në Kubernetes. Gjatë kësaj kohe, kemi hasur në probleme që lidhen jo vetëm me zhvendosjen e shërbimeve në Kubernetes, por gjithashtu me menaxhimin e një deployment-i hibrid gjatë kalimit. Për mësimet e çmuara që kemi marrë, do të flasim në këtë artikull.
Që në fillim, serverët e GitLab.com kanë punuar në cloud në makina virtuale. Këto makina virtuale menaxhohen nga Chef, ndërsa instalimi i tyre bëhet me ndihmën e . në rast se duhet të përditësohet aplikacioni, konsiston në përditësimin e parku serverëve në mënyrë të koordinuar dhe të renditur përmes një pipeline CI. Ky metodë — ndonjëherë e ngadaltë dhe pak — garanton që GitLab.com përdor të njëjtat metoda instalimi dhe konfiguroje si përdoruesit e instalicioneve autonomë (self-managed) të GitLab, që përdorin për këtë paketat tona Linux.
Ne e përdorim këtë metodë sepse është jashtëzakonisht e rëndësishme të ndiejmë të gjitha shqetësimet dhe gëzimet që përjetojnë anëtarët e zakonshëm të komunitetit kur instalojnë dhe konfigurojnë kopjet e tyre të GitLab. Ky qasje ka qenë efektive për një kohë të caktuar, megjithatë, kur numri i projekteve në GitLab kaloi 10 milion, kuptuam se ai më nuk përmbushte nevojat tona për zgjerim dhe ndërrim.
Hapat e parë drejt Kubernetes dhe GitLab cloud-native
Në vitin 2017, u krijua projekti përgatitjen e GitLab për përdorim në re, si dhe për t'u ofruar përdoruesve mundësinë për të instaluar GitLab në klasterë Kubernetes. Atëherë ne e dinim se kalimi i GitLab në Kubernetes do të rrisë kapacitetin e shkallëzimit të platformës SaaS, do ta thjeshtojë vendosjen dhe do të përmirësojë efikasitetin e përdorimit të burimeve kompjuterike. Në të njëjtën kohë, shumë funksione të aplikacionit tonë ishin të varura nga ndarje NFS të montuara, gjë që ngadalësoi kalimin nga makinat virtuale.
Dëshira për cloud native dhe Kubernetes i dha mundësi inxhinierëve tanë të planifikonin një kalim gradual, gjatë të cilit ne heqëm dorë nga disa varësi të aplikacionit nga magazinat rrjet, duke vazhduar të zhvillojmë funksione të reja. Që nga momenti kur filluam të planifikojmë migrimin verën e vitit 2019, shumë nga këto kufizime janë eliminuar, dhe procesi i kalimit të GitLab.com në Kubernetes tani po ecën me ritëm të plotë!
Karakteristikat e funksionimit të GitLab.com në Kubernetes
Për GitLab.com ne përdorim një klaster GKE rajonal unik, i cili trajton të gjithë trafikun e aplikacionit. Për të minimizuar kompleksitetin (që është tashmë i komplikuar) të migrimit, ne përqendrohemi te shërbimet që nuk varen nga ruajtja lokale ose NFS. GitLab.com përdor kryesisht një bazë të kodit monolitik në Rails, dhe ne drejtojmë trafik në varësi të karakteristikave të ngarkesës së punës në endpoint-e të ndryshme, të izoluara në pulo të veta nodale.
Në rastin e frontend-it, këto tipe ndahen në kërkesa për web, API, Git SSH/HTTPS dhe Registry. Në rastin e backend-it, ne e ndajmë punën në radhë sipas karakteristikave të ndryshme në varësi të , që na lejon të vendosim treguesit e nivelit të shërbimit (Service-Level Objectives, SLOs) për ngarkesa të ndryshme.
Të gjithë këta shërbime GitLab.com janë konfiguruar me një Helm-chart të Mtë pa modifikime. Konfigurimi bëhet në subchart-e, të cilat mund të përfshihen selektivisht ndërsa ne gradualisht kalojmë shërbimet në klaster. Edhe pse është vendosur që të mos përfshihen disa nga shërbimet tona me gjendje, si Redis, Postgres, GitLab Pages dhe Gitaly, përdorimi i Kubernetes lejon një reduktim radikal të numrit të VM-ve që aktualisht menaxhohen nga Chef.
Transparentësia dhe menaxhimi i konfigurimit në Kubernetes
Të gjitha konfigurimet menaxhohen nga vetë GitLab. Për këtë, përdoren tri projekte konfiguruese të bazuara në Terraform dhe Helm. Ne përpiqemi të përdorim GitLab-in sa më shumë të jetë e mundur për të vënë në operim GitLab-in vetë, por për detyrat operative, kemi një instalim të veçantë të GitLab-it. Kjo është e nevojshme për të mos u varur nga disponueshmëria e GitLab.com gjatë shpërndarjeve dhe përditësimeve të GitLab.com.
Megjithëse pipeline-t tona për klasterin Kubernetes funksionojnë në një instalim të veçantë të GitLab-it, repository-t e kodit kanë pasqyrat, të cilat janë publikisht të aksesueshme në adresat e mëposhtme:
- — lidhja konfiguruese e GitLab.com për chart-in e Helm;
- — përmban konfigurime për shërbime që nuk janë të lidhura drejtpërdrejt me aplikacionin GitLab. Në to përfshihen konfigurimet për regjistrimin dhe monitorimin e klasterit, si dhe për mjetet e integruara si PlantUML;
- — konfigurimi Terraform për Kubernetes dhe infrastrukturën e vjetër (legacy) VM. Këtu konfigurohen të gjitha burimet e nevojshme për të vënë në operim klasterin, përfshirë vetë klasterin, grupet e node-ve, llogaritë e shërbimeve, rezervimin e adresave IP.

Kur bëhen ndryshime, shfaqet një me një lidhje në ndryshimin e detajuar, i cili analizohet nga SRE para se të bëhen ndryshime në klaster.
Për SRE-në, linku çon në ndryshimin e detajuar në instalim të GitLab-it, i cili përdoret për operim dhe akses i kufizuar. Kjo lejon punonjësit dhe komunitetin pa akses në projektin operativ (i hapur vetëm për SRE) të shohin ndryshimet e propozuara në konfigurim. Duke kombinuar një instancë publike të GitLab-it për kodin me një instancë private për pipeline-t CI, ne ruajmë një proces të njëjtë pune, duke garantuar njëkohësisht pavarësinë nga GitLab.com gjatë përditësimeve të konfigurimit.
Çfarë kemi zbuluar gjatë migrimit
Gjatë procesit të zhvendosjes, është akumuluar përvoja që e aplikojmë në migrimet dhe shpërndarjet e reja në Kubernetes.
1. Rritja e shpenzimeve për shkak të trafikut midis zonave të disponueshmërisë
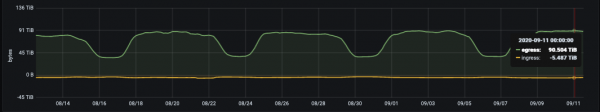
Statistika e përditshme e egress-it (byte në ditë) për grupin e depozitave Git në GitLab.com
Google ndan një përndarje të rrjetit të tij në regione. Këto, nga ana tjetër, ndahen në zona aksesibiliteti (AZ). Hostimi i Git-it është i lidhur me volumet e mëdha të të dhënave, prandaj është e rëndësishme për ne të kontrollojmë egress-in e rrjetit. Në rastin e trafikut të brendshëm, egress është falas vetëm nëse mbetet brenda kufijve të një zone aksesibiliteti. Në momentin e shkruarjes së këtij artikulli, ne ofrojmë rreth 100 TB të dhënash në një ditë normale pune (dhe kjo është vetëm për Git-repo). Shërbimet që në topologjinë tonë të vjetër, të bazuar në VM, ndodheshin në të njëjtat makina virtuale, tani funksionojnë në pod-e të ndryshme Kubernetes. Kjo do të thotë se një pjesë e trafikut, që më parë ishte lokale për VM, mund të dalë potencialisht përtej zonave të aksesibilitetit.
Klasterët rajonalë GKE lejojnë mbulimin e disa zonave të aksesibilitetit për rezervim. Ne po shqyrtojmë mundësinë për shërbimet që gjenerojnë volume të mëdha trafiku. Kjo do të ulë shpenzimet për egress duke mbajtur rezervimin në nivel klasteri.
2. Limit’ët, kërkesat për burime dhe shkallëzimi
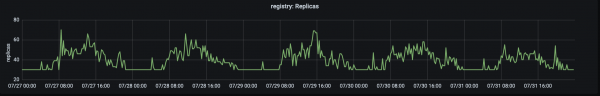
Numri i kopjeve që përpunojnë trafikun e prodhimit në registry.gitlab.com. Trafiku arrin kulmin në ~15:00 UTC.
Historia jonë me migrimin filloi në gusht 2019, kur ne transferuam shërbimin e parë - regjistri i konteinerëve GitLab (GitLab Container Registry) - në Kubernetes. Ky shërbim kritik me trafik të lartë ishte një kandidat i mirë për migrimin e parë, pasi përbën një aplikacion stateless me pak varësi të jashtme. Problemi i parë me të cilin përballëm ishte numri i madh i pod-ëve të dëbuar për shkak të mungesës së memories në nyje. Kjo na detyroi të ndryshojmë kërkesat dhe limitet.
U zbulua se në rastin e aplikacionit, konsumimi i memories rritet me kalimin e kohës, vlerat e ulta për kërkesat (rezervuese memories për çdo pod) së bashku me një limit të "bujar" për përdorim çonin në ngopje (saturation) të nyjeve dhe një nivel të lartë të dëbimeve. Për të përballuar këtë problem, u Kjo hoqi presionin nga nyjet dhe sigurtoi një cikël jetësor të pod'ave që nuk shkaktonte presion të lartë në nyje. Tani ne fillojmë migrimet me vlera bujare (dhe deri diku të barabarta) të kërkesave dhe kufijve, duke i rregulluar ato sipas nevojës.
3. Metrika dhe regjistrat
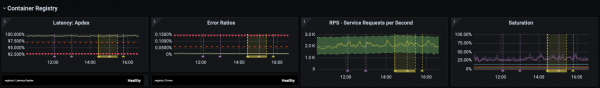
Njësia infrastrukturore fokusohet në vonesat, përqindjen e gabimeve dhe saturimin me qëllimet e vendosura (SLO), të lidhura me .
Gjatë vitit të kaluar, një nga ngjarjet kryesore në njësinë infrastrukturore ishin përmirësimet në monitorimin dhe punën me SLO. SLO na lejuan të vendosim qëllime për shërbime të veçanta, të cilat ne i ndjekim me kujdes gjatë migrimit. Por edhe me një përmirësim të tillë në vëzhgim, nuk është gjithmonë e mundur të shohim menjëherë problemet, duke përdorur metrikat dhe alarmin. Për shembull, duke u fokusuar në vonesat dhe përqindjen e gabimeve, ne nuk e përfshijmë plotësisht të gjitha skenarët e përdorimit të shërbimit që është në migrim.
Ky problem u zbulua pothuajse menjëherë pas transferimit të një pjese të ngarkesave në klaster. Ai u shfaq veçanërisht kur duhej të kontrolloheshin funksionet për të cilat numri i kërkesave është i vogël, por që kanë varësi konfigurimesh shumë specifike. Një nga mësimet e rëndësishme nga migrimi ishte nevoja për të marrë parasysh gjatë monitorimit jo vetëm metrikat, por edhe regjistrat dhe "bishtin e gjatë" (në një kuptim të shpërndarjes së tillë të gabimeve. Tani për çdo migrim ne përfshijmë një listë të detajuar të kërkesave për regjistra (log queries) dhe planifikojmë procedura të qarta rikthimi, të cilat në rast se ndodhin probleme, mund të kalojnë nga një ndërrim në tjetrin. Shërbimi paralel i të njëjtave kërkesa në infrastrukturën e vjetër VM dhe në të re, e bazuar në Kubernetes, përbënte një sfidë unike. Ndryshe nga migrimi i tipit lift-and-shift
(transfer i shpejtë i aplikacioneve "ashtu siç janë" në infrastrukturën e re; mund të lexoni më shumë, për shembull, – shën. përkth.) — shën. përkth.), puna e punës paralel me VM-të e "vjetra" dhe Kubernetes kërkon që mjetet për monitorim të jenë të pajtueshme me të dyja mjediset dhe të jenë në gjendje të bashkojnë metrikat në një pamje. Është e rëndësishme që ne të përdorim të njëjtat dashboard dhe kërkesa për log-et, për të arritur një vëzhgim të konsoliduar gjatë periudhës së kalimit.
4. Kalimi i trafikut në klasterin e ri
Për GitLab.com, një pjesë e serverëve i dedikohet . Parku kanarinë shërben për projektet tona të brendshme, si dhe mund . Por, në radhë të parë ai është i destinuar për të verifikuar ndryshimet e bëra në infrastrukturë dhe aplikacion. Shërbimi i parë i migruar filloi me pranimin e një volume të kufizuar të trafikut të brendshëm, dhe ne vazhdojmë të përdorim këtë metodë për të siguruar përmbushjen e SLO para se të drejtojmë të gjithë trafikun në klaster.
Në rastin e migrimit, kjo do të thotë që fillimisht kërkesat për projektet e brendshme drejtohen në Kubernetes, dhe pastaj ne gradualisht kalojmë trafikun e mbetur në klaster duke ndryshuar peshën për backendin përmes HAProxy. Gjatë kalimit nga VM në Kubernetes u bë e qartë se ishte shumë e dobishme të kishim një mënyrë të thjeshtë për të drejtuar trafikun mes infrastrukturës së vjetër dhe të re, dhe përkatësisht, të mbajmë infrastrukturën e vjetër gati për një rikthim në ditët e para pas migrimit.
5. Kapacitetet rezervë të podëve dhe përdorimi i tyre
Pak pas fillimit u identifikua problemi i mëposhtëm: podët për shërbimin Registry u nisën shpejt, megjithatë, nisja e podëve për Sidekiq merrte deri në . Nisja e prolonguar e podëve për Sidekiq u bë një problem kur filluam migrimin e ngarkesave të punës në Kubernetes për punëtorët që duan të përpunojnë punët shpejt dhe të shkallezojnë shpejt.
Në këtë rast, mësimi ishte se, megjithëse Horizontal Pod Autoscaler (HPA) në Kubernetes funksionon mirë për rritjen e trafikut, është e rëndësishme të merret parasysh karakteristikat e ngarkesave të punës dhe të alokohen kapacitetet rezervë të podëve (sidomos në kushte të shpërndarjes së pabarabartë të kërkesës). Në rastin tonë, u vu re një shpërthim i papritur i punëve, duke çuar në një shkallëzim të shpejtë, që rezultoi në saturimin e burimeve CPU përpara se ne të kishim mundësinë të shkallëzoheshim në grupin e nodave.
Ka siempre ka kaçsojnë të nxjerrim më shumë nga klasteri, megjithatë, pasi përballemi me probleme me performancën, tani fillojmë me një buxhet të bollshëm pod dhe e zvogëlojmë më vonë, duke e ndjekur me kujdes SLO. Nisja e pod-eve për shërbimin Sidekiq është ndjeshëm përshpejtuar dhe tani zgjat afërsisht 40 sekonda në mesatare. fituan si GitLab.com, ashtu edhe përdoruesit tanë të instalimeve self-managed, që punojnë me Helm chartin zyrtar të GitLab.
Përfundim
Pasi transferuam çdo shërbim, ne gëzuam përfitimet e përdorimit të Kubernetes në prodhim: një deploy më të shpejtë dhe më të sigurt të aplikacionit, përmasim dhe një shpërndarje më efektive të burimeve. Për më tepër, përfitimet e migrimit shkojnë përtej shërbimit GitLab.com. Çdo përmirësim në chartin zyrtar të Helm përfiton edhe përdoruesit e tij.
Shpresoj t'ju ketë pëlqyer historia mbi aventurat tona me migrimin në Kubernetes. Ne vazhdojmë të transferojmë gjithnjë e më shumë shërbime në klaster. Informacione shtesë mund të merrni nga publikimet e mëposhtme:
- «»;
- «»;
- .
P.S. nga përkthyesi
Lexoni gjithashtu në blogun tonë:
- «»;
- «»;
- «»;
- «».
Burimi: habr.com
