

Është e njohur se kompetenca e CTO-së kontrollohet vetëm pas një kohe të dytë në këtë rol. Sepse është një gjë të punosh për disa vite në një kompani, të evolosh bashkë me të dhe, duke qenë në të njëjtin kontekst kulturor, gradualisht të marrësh më shumë përgjegjësi. Dhe krejt ndryshe — të vish menjëherë në pozitat e CTO-së në një kompani me një bagazh trashëgimie dhe një mori problemesh, të cilat janë fshehur me kujdes nën qilim.
Në këtë kuptim, përvoja e Leon Fairer, e cila ai e ndau në , nuk është domosdoshmërisht unike, por, e mbledhur për të gjithë përvojën dhe numrin e roleve të ndryshme që ai është përballur gjatë 20 viteve, është shumë e dobishme. Nën këtë, diagrama e ngjarjeve për 90 ditë dhe shumë tregime që janë të këndshme të qeshura, kur ato ndodhin me dikë tjetër, por me të cilat nuk është aq argëtuese të përballesh personalisht.
Leon thonë se tregon me shumë kolor me rusisht, kështu që nëse keni 35-40 minuta, e rekomandoj të shikoni videon. Versioni tekstual për të kursyer kohën është më poshtë.
Versioni i parë i raportit ishte një përshkrim i mirëstrukturuar i punës me njerëzit dhe proceset, duke përfshirë rekomandime të dobishme. Por ai nuk e përçonte gjithë surprizat që ishin ndeshur gjatë rrugës. Prandaj, unë e ndërruar formatin dhe i paraqita problemet që shfaqeshin para meje në kompaninë e re, si djalli nga kutia, dhe metodat e zgjidhjes së tyre në një rend kronologjik.
Një muaj para
Siç ndodh me shumë histori të mira, kjo filloi me alkoolin. Ne ishim me njohës në një bar, dhe siç është zakon në mjedisin e teknologjisë, secili ankohej për problemet e tij. Njëri prej tyre sapo kishte ndryshuar punën dhe tregonte për problemet me teknologjitë, me njerëzit dhe me ekipin. Sa më gjatë e dëgjoja, aq më shumë kuptoja se ai veçse duhet të më angazhonin, sepse pikërisht këto probleme i kam zgjidhur gjatë 15 viteve të fundit. I thashë kështu dhe ditën tjetër ne u takuam në një ambient pune. Kompania quhej Teaching Strategies.
Teaching Strategies është lider në tregun e programeve edukative për fëmijë që nga lindja deri në tre vjeç. Kompania tradicionale "paper" ka ekzistuar për rreth 40 vjet, ndërsa versioni i saj dixhital SaaS ka 10. Më së fundmi ka filluar procesi i adaptimit të teknologjisë dixhitale në standardet e kompanisë. Versioni "i ri" u lançua në vitin 2017 dhe ishte pothuajse si i vjetri, vetëm se funksiononte më keq.
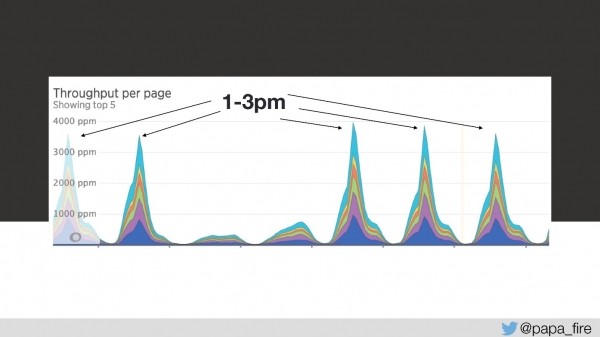
Gjëja më interesante është se trafiku i kësaj kompanie është shumë i parashikueshëm — çdo ditë, çdo vit, mund të parashikohet qartë se sa njerëz do të vijnë dhe kur. Për shembull, midis orës 13:00 dhe 15:00, të gjitha fëmijët në çerdhe shkojnë për të fjetur, dhe mësuesit fillojnë të fusin informacione. Dhe kështu ndodh çdo ditë, përveç fundjavave, sepse në fundjavë pothuajse askush nuk punon.
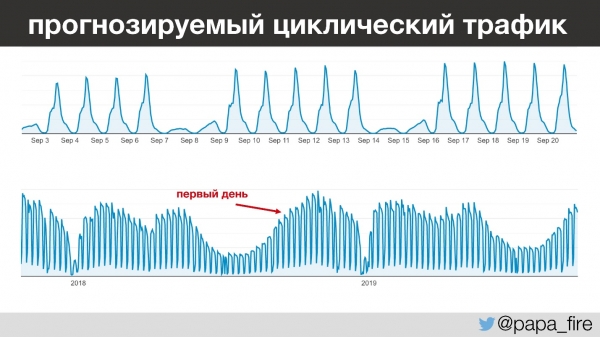
Duke ecur pak përpara, vërejtja ime është se unë fillova punën time në periudhën e trafikut më të madh vjetor, që është interesante për arsye të ndryshme.
Platforma, e cila kishte si duket vetëm 2 vjet, kishte një stack të veçantë: ColdFusion & SQL Server 2008. ColdFusion, nëse nuk e dini, dhe shumë mund të mos e dinë, është një lloj enterprise PHP që doli në mesin e viteve '90, dhe që prej asaj kohe nuk kam dëgjuar asgjë për të. Po ashtu, kishte: Ruby, MySQL, PostgreSQL, Java, Go, Python. Por monoliti kryesor punonte me ColdFusion dhe SQL Server.
Problemet
Sa më shumë flisja me punonjësit e kompanisë rreth punës dhe problemeve që haseshin, aq më shumë kuptoja se problemet nuk ishin vetëm teknike. E drejta, teknologjia është e vjetër — dhe kemi punuar me gjëra më të vështira, por kishte probleme me ekipin dhe me proceset, dhe kompania fillonte ta kuptonte këtë.
Tradicionalisht, teknikët qëndronin në cep dhe merreshin me ndonjë punë të vetën. Por gjithnjë e më shumë biznesi filloi të kalonte pikërisht përmes versionit digjital. Prandaj, në kompaninë në vitin përpara fillimit të punës sime, kishin dalë të reja: bordi i drejtorëve, CTO, CPO dhe drejtoresha e QA. Pra, kompania filloi të investonte në sferën teknologjike.
Njollat e trashëgimisë së rëndë nuk ishin vetëm në sisteme. Në kompani kishte procese legacy, njerëz legacy, kulturë legacy. Të gjitha këto duhej të ndryshonin. Mendova se nuk do të ishte e mërzitshme dhe vendosa të provoj.
Dy ditë para
Dy ditë para fillimit të punës së re, arrita në zyrë, plotësova dokumentet e fundit, u njoha me ekipin dhe zbulova se ekipi në atë kohë po luftonte me një problem. Ai përfshinte që koha mesatare e ngarkesës së faqeve ishte rritur në 4 s, që do të thotë dy herë më shumë.
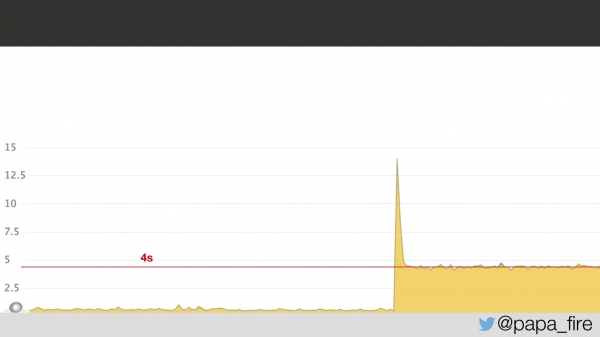
Sipas grafikëve, dukej se diçka kishte ndodhur, por nuk ishte e qartë se çfarë. Doli se problemi ishte në latencën e rrjetit në qendrën e të dhënave: 5 ms latencë në qendrën e të dhënave iu transformua në 2 s për përdoruesit. Pse ndodhi kështu, nuk e dija, por në çdo rast u bë e njohur se problemi ishte në qendrën e të dhënave.
Dita e parë
Duan kaloi, dhe në ditën time të parë të punës zbulova se problemi nuk kishte zhdukur.
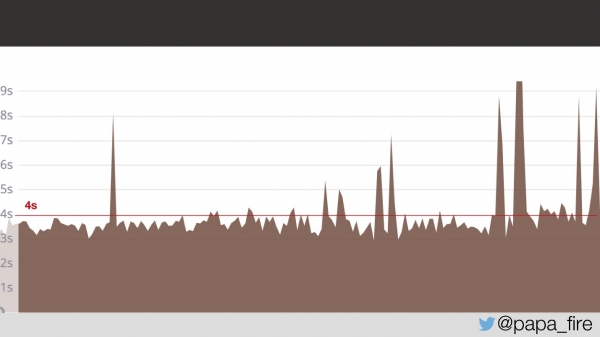
Të dy ditët, përdoruesit po ngarkonin faqet me një mesatare prej 4 sekondash. Pyeta, a gjetën se çfarë ishte problemi.
— Po, hapëm një tiket.
— Dhe?
— Epo, ata akoma nuk na kanë përgjigjur.
Atëherë kuptova se gjithçka që më kishin thënë deri tani ishte vetëm maja e ajsbergut, me të cilin duhej të luftoja.
Ka një citat të mirë që i përshtatet këtij rasti:
«Ndonjëherë për të ndryshuar teknologjinë, duhet të ndryshosh organizatën».
Por, duke pasur parasysh se fillova punë në kohën më të ngarkuar të vitit, duhej të shikoja të dy opsionet për zgjidhjen e problemit: atë të shpejtë dhe atë afatgjatë. Dhe të filloja nga ajo që ishte kritike tani.
Dita e tretë
Pra, ngarkesa zgjat 4 sekonda, dhe nga ora 13 deri në 15 janë kulmet më të mëdha.
Në ditën e tretë, në këtë segment të kohës, shpejtësia e ngarkesës dukej kështu:
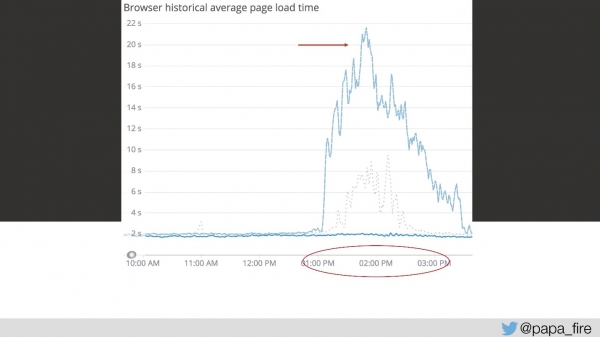
Nga këndvështrimi im, në të vërtetë asgjë nuk funksiononte. Nga këndvështrimi i të tjerëve, funksiononte pak më ngadalë se zakonisht. Por kështu thjesht nuk ndodh — kjo është një problem serioz.
Përpiqesha të bindja ekipin, por ata më përgjigjën se thjesht na duhen më shumë serverë. Kjo, sigurisht, është një zgjidhje për problemin, por jo gjithmonë e vetmja dhe më efektivja. Pyeta, pse na mungonin serverët, cila ishte vëllimi i trafikut. Ekstrapolova të dhënat dhe munda të thahem se kemi rreth 150 kërkesa në sekondë, që në fakt është brenda kufijve të arsyeshëm.
Por nuk duhet harruar se përpara se të marrësh një përgjigje të saktë, duhet të bësh një pyetje të saktë. Pyetja ime tjetër ishte: sa frontend-serverë kemi. Përgjigjja më 'tronditi pak' — kishim 17 frontend-serverë!
— Më vjen turp ta pyes, por 150 e ndarë me 17, do të rezultonte përafërsisht 8? Synoni të thoni se çdo server kalon 8 kërkesa në sekondë, dhe nëse nesër do të kemi 160 kërkesa në sekondë, na nevojiten edhe 2 serverë?
Sigurisht, nuk na duhen serverë të tjerë. Zgjidhja ndodhej në vetë kodin, dhe ishte në sipërfaqe:
var currentClass = classes.getCurrentClass();
return currentClass;
Ishte një funksion getCurrentClass(), sepse gjithçka në faqe funksionon në kontekstin e klasës — e drejtë. Dhe për këtë funksion në çdo faqe kishte 200+ kërkesa.
Zgjidhja kështu ishte shumë e thjeshtë, as nuk kishte nevojë të shkruhej ndonjë gjë: thjesht të mos kërkohej e njëjta informacion sërish.
if ( !isDefined("REQUEST.currentClass") ) {
    var classes = new api.private.classes.base();
   REQUEST.currentClass = classes.getCurrentClass();
}
return REQUEST.currentClass;
U gëzova shumë, sepse mendoja se pas ditës së tretë gjeta problemin kryesor. Sa naiv isha, kjo ishte thjesht një nga shumë probleme të tjera.
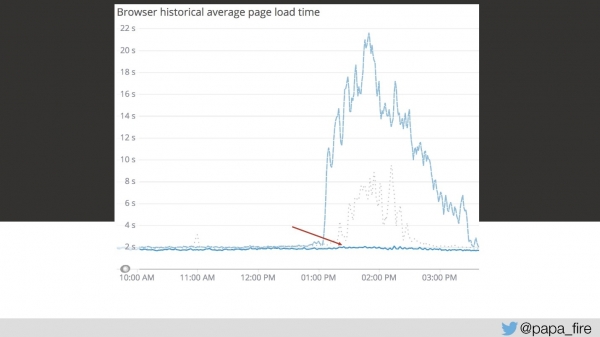
Por zgjidhja e këtij problemi të parë e ulte grafikën shumë më poshtë.
Në të njëjtën kohë, ne po merreshim me optimizime të tjera. Ishte shumë gjëra që mund të rregullohej përpara. Për shembull, në atë ditën e tretë zbulova se në sistem ishte një cache (fillimisht mendova se të gjitha kërkesat shkonin direkt nga baza e të dhënave). Kur mendoj për cache, paraqes standardet Redis ose Memcached. Por kjo mendim ishte vetëm im, sepse për caching në atë sistem u përdorën MongoDB dhe SQL Server — gjithashtu nga ku sapo ishin lexuar të dhënat.
Dita e dhjetë
Java e parë kalova duke u marrë me problemet që kishte nevojë për zgjidhje menjëherë. Diku në javën e dytë erdha herën e parë në stand-up për të biseduar me ekipin, për të parë se çfarë po ndodhte dhe si po shkonte i gjithë procesi.
Sërish doli diçka interesante. Ekipi ishte i përbërë nga: 18 zhvillues; 8 testues; 3 menaxherë; 2 arkitektë. Dhe të gjithë ata merrnin pjesë në ritualet e përbashkëta, pra më shumë se 30 njerëz vinin çdo mëngjes në stand-up dhe tregonin se çfarë kishin bërë. E kuptueshme, takimi nuk merrte 5 dhe as 15 minuta. Askush nuk dëgjonte tjetrin, sepse të gjithë punonin në sisteme të ndryshme. Në atë formë 2-3 bileta në orë në seancën e grooming ishte tashmë një rezultat i mirë.
E para që bëmë, ishte të ndanim ekipin në disa linja produktesh. Për seksionet dhe sistemet e ndryshme ndamë ekipe të veçanta, të cilat përfshinin zhvillues, testues, menaxherë produktesh, analistë biznesi.
Si rezultat morëm:
- Përshpejtim të stand-up dhe takimeve.
- Njohuri të thella mbi produktin.
- Ndjenjë pronësie. Kur më parë njerëzit gjithmonë rotacionin nëpër sisteme, ata e dinin që së pari ata do të duhej të punonin me gabimet e tyre, por jo vetë.
- Bashkëpunimi midis grupeve. Mund të mos thuhet se QA e zhvilluesit kishin folur shumë më parë, produkti bëri punën e vet, e kështu me radhë. Tani ata kanë një pikë të përbashkët përgjegjësie.
Kryesisht përqendruam në efikasitetin, performancën dhe cilësinë — këto ishin problemet që përpiqeshim të zgjidhnim duke transformuar ekipin.
Dita njëmbëdhjetë
Në procesin e ndryshimit të strukturës së ekipit, zbulova se si llogaritet HistoriaPikët. 1 SP ishte e barabartë me një ditë, dhe çdo tiket kishte SP për zhvillimin dhe për QA, domethënë të paktën 2 SP.
Si e zbulova këtë?
Gjetëm një gabim: në një nga raportet, ku futet data e fillimit dhe përfundimit të periudhës për të cilën kërkohet raporti, nuk merret parasysh dita e fundit. Domethënë, diku në kërkesë kishte jo <=, por thjesht <. Më thanë se kjo është tre Story Points, domethënë 3 ditë.
Pas kësaj ne:
- Rishikuam sistemin e vlerësimit të Story Points. Tani, rregullimi i gabimeve të vogla, të cilat mund të kalojnë shpejt përmes sistemit, arrin te përdoruesi më shpejt.
- Filluam të bashkojmë tiket të lidhura për zhvillim dhe testim. Më parë, çdo tiket, çdo gabim ishte një ekosistem i mbyllur, i papërkohshëm me ndonjë gjë tjetër. Të ndryshosh tre butona në një faqe mund të ishte tre tikete me tri procese të ndryshme QA në vend të një testi automatik në faqen.
- Filluam të punojmë me zhvilluesit mbi qasjen për vlerësimin e punës. Tre ditë për të ndërruar një buton — kjo nuk është qesharake.
Dita njëzet
Diku në mes të muajit të parë situata u pak stabilizua, kuptova se çfarë ndodhte kryesisht dhe fillova të shikoj përpara dhe të mendoj për zgjidhjet afatgjata.
Qëllimet afatgjata:
- Platformë e menaxhuar. Qindra kërkesa në çdo faqe — kjo nuk është serioze.
- Tendenca të parashikueshme. Ishin kulme periodike të trafikut, të cilat me sa duket nuk korrelacionoheshin me metrikat e tjera — duhej të kuptoja pse ndodhte kjo dhe të mësoja ta parashikoja.
- Zgjerimi i platformës. Biznesi vazhdon të rritet, po vijnë gjithnjë e më shumë përdorues, duke rritur trafikun.
Në të kaluarën shpesh thuhej: «Le të rishkruajmë gjithçka në [gjuhën/faqen], gjithçka do të funksionojë më mirë!»
Në shumicën e rasteve, kjo nuk funksionon, dhe është e mirë nëse ajo që është riartikuluar do të funksionojë ndonjëherë. Prandaj, na nevojitet të krijojmë një roadmap — një strategji konkrete që ilustron hap pas hapi se si do të arrihen objektivat e biznesit (çfarë do të bëjmë dhe përse), e cila:
- reflekton misionin dhe objektivat e projektit;
- prioritizon qëllimet kryesore;
- përmban një grafik për realizimin e tyre.
Derisa askush nuk kishte folur me ekipin përse po bëheshin ndryshime të tilla. Për këtë nevojiten tregues të duhur të suksesit. Për herë të parë në historinë e kompanisë, vendosëm KPI për grupin teknik, duke lidhur këto tregues me ata organizativë.
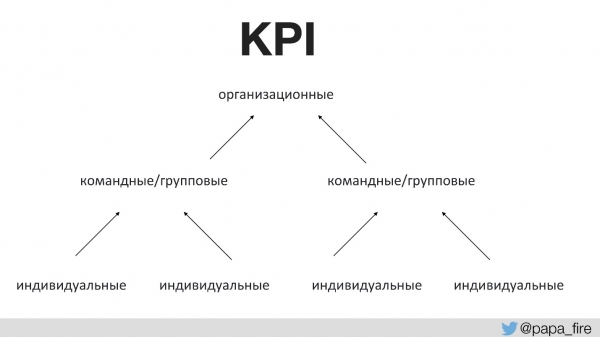
Pra, KPI-të organizative mbështeten nga ekipet, ndërsa KPI-të e ekipit mbështeten nga individët. Në të kundërt, nëse KPI-të teknologjike nuk përputhen me ato organizative, atëherë secili tërheq bllokun në vete.
Për shembull, një nga KPI-të organizative është rritja e pjesës së tregut përmes produkteve të reja.
Çfarë mund të mbështesë qëllimin për të pasur më shumë produkte të reja?
- Së pari, ne dëshirojmë të kalojmë më shumë kohë në zhvillimin e produkteve të reja në vend që të rregullojmë defektet. Kjo është një zgjidhje logjike e cila lehtë mund të matet.
- Së dyti, ne dëshirojmë të mbështesim rritjen e vëllimit të transaksioneve, sepse sa më shumë të jetë pjesa e tregut, aq më shumë përdorues dhe, për rrjedhojë, më shumë trafik.
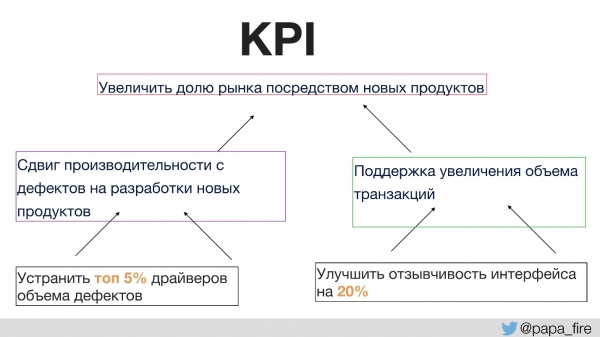
Kështu, KPI-të individuale që mund të realizohen brenda grupit do të jenë, për shembull, në atë vend nga vijnë defektet kryesore. Nëse përqendrohemi në këtë seksion, mund të sigurojmë një rënie të konsiderueshme të defekteve, dhe atëherë koha për zhvillimin e produkteve të reja do të rritet dhe gjithashtu për mbështetje të KPI-ve organizative.
Kështu, çdo vendim, përfshirë ri-shkrimin e kodit, duhet të mbështesë qëllimet konkrete që kompania na ka caktuar (rritja e organizatës, funksione të reja, angazhimi i personelit).
Gjatë këtij procesi doli një gjë interesante, e cila u bë lajm jo vetëm për teknikët, por për të gjithë në kompani: të gjitha biletat duhet të jenë të orientuara të paktën ndaj një KPI. Pra, nëse produkti thotë se dëshiron të krijojë një veçori të re, pyetja e parë duhet të jetë: "Cili KPI mbështetet nga kjo veçori?" Nëse asnjë, atëherë më vjen keq — duket se kjo është një veçori e panevojshme.
Dita e tridhjetë
Në fund të muajit, zbulova një tjetër detaj, që asnjë nga ekipi im i Ops-it nuk kishte parë ndonjëherë kontratat që lidhim me klientët. Mund të pyesni, pse t’i shohim kontratat.
- Së pari, sepse në kontrata janë përcaktuar SLA-të.
- Së dyti, SLA-të janë të ndryshme për secilin. Çdo klient erdhi me kërkesat e tij, ndërsa ekipi i shitjeve nënshkruante pa e parë.
Një detaj interesant - në kontratën me një nga klientët më të mëdhenj është shkruar që të gjitha versionet e softuerit që mbështet platforma duhet të jenë n-1, domethënë, jo versioni më i fundit, por versioni para fundit.
Është e qartë se sa larg ishim nga n-1, nëse platforma ishte në ColdFusion dhe SQL Server të vitit 2008, të cilin në korrik e ndaluan të mbështetet fare.
Dita e dyzet e pestë
Diku në mes të muajit të dytë, mu lirua mjaft kohë për të u ulur dhe bërë vleraNë modul stream është shtuar direktiva 'mapping plotësisht për të gjithë procesin. Këto janë hapat e nevojshme që duhet të merren, nga krijimi i produktit deri te dorëzimi i tij te konsumatori, siç duhet t’i përshkruash ato sa më hollësisht.
E ndani procesin në copëza të vogla dhe shikoni se çfarë zë shumë kohë, çfarë mund të optimizohet, përmirësohet, etj. Për shembull, sa kohë merr një kërkesë nga produkti, kalimi përmes grooming, kur do të arrijë në një biletë që zhvilluesi mund ta marrë, QA, etj. Shikoni aq hollësisht çdo hap të veçantë dhe mendoni se çfarë mund të optimizohet.
Kur e bëja këtë, dy gjëra më goditën:
- përqindja e lartë e kthimit të biletave nga QA përsëri te zhvilluesit;
- rishikimet e pull request-it zinin shumë kohë.
Problemi ishte se këto ishin përfundime si: duke u dukur se zinte shumë kohë, por nuk ishim të sigurt se sa saktësisht.
"Nuk mund të përmirësosh atë që nuk mund ta masësh."
Si ta justifikosh sa e rëndësishme është problemi? A humbasin ditë apo orë për shkak të tij?
Për ta matur këtë, shtuam disa hapa në procesin e Jira-s: "gatshëm për zhvillim" dhe "gatshëm për QA", për të matur sa kohë çdo biletë pret dhe sa herë kthehet në një hap të caktuar.
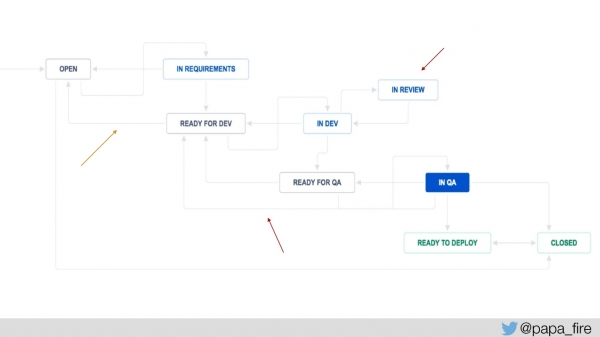
Po ashtu, shtuam "në rishikim", për të ditur sa mesatarisht biletat qëndrojnë në rishikim, dhe nga kjo të fillojmë. Ne kishim metrika sistemike, tani shtuam metrika të reja dhe filluam të matim:
- Efiçienca e procesit: produktiviteti dhe e planifikuar/dorëzuar.
- Cilësia e procesit: numri i defekteve, defektet nga QA.
Kjo vërtet ndihmon të kuptohet se çfarë shkon mirë dhe çfarë keq.
Dita e pesëdhjetë
Kjo është e gjitha, sigurisht, e mirë dhe interesante, por afër fundit të muajit të dytë ndodhi ajo që në parim ishte e parashikueshme, megjithatë nuk e prisja një shkallë të tillë. Njerëzit filluan të largoheshin, sepse mësynë në krye njerëz të rinj, të cilët filluan të ndryshonin gjithçka dhe të vjetrit u larguan. Dhe zakonisht në një kompani, e cila ka disa vite, të gjithë janë shokë dhe të gjithë e njohin njëri-tjetrin.
Kjo ishte e pritshme, por ajo që ishte e papritur ishte shkalla e largimeve. Për shembull, në një javë dy liderë të ekipeve dorëzuan njëkohësisht kërkesën për të dorëzuar vendin e punës për arsye personale. Prandaj, më duhej jo thjesht të harroja problemet e tjera, por të fokusohem në krijimin e një kolektivi. Kjo është një problem i gjatë dhe i vështirë për t'u zgjidhur, por duhej të merrej me të, sepse dëshiroja të ruaja njerëzit që kishin mbetur (apo shumicën e tyre). Duhej të reagoja në ndonjë mënyrë për atë që ndodhi, për të mbajtur moralin në ekip.
Në teori kjo është e mirë: vjen një person i ri, i cili ka një kartë të plotë, që mund të vlerësojë aftësitë e ekipit dhe të zëvendësojë kuadrot. Në të vërtetë nuk mund të sjellësh thjesht njerëz të rinj për shumë arsye. Gjithmonë nevojitet balanc.
- Mes të vjetrës dhe të reja. Duhet ruajtur njerëzit e vjetër, që mund të ndryshojnë dhe të mbështesin misionin. Por në të njëjtën kohë duhen sjellë gjak të ri, për të cilin do të flasim pak më vonë.
- Eksperiencës. Kam biseduar shumë me juniorë të mirë, që ishin të pasionuar dhe donin të punonin me ne. Por nuk mund t'i merrja, sepse nuk kishte mjaft të rritur që mund të mbështesnin juniorët dhe të ishin mentorë për ta. Duhej të mbushej fillimisht niveli i lartë dhe vetëm pastaj rinia.
- Dërrasë dhe karota.
Nuk kam një përgjigje të mirë për pyetjen se cili është balanci i duhur, si mund të mbështetet, sa njerëz të lihen dhe sa të shtyhen. Ky është një proces krejtësisht individual.
Dita e pesëdhjetë e parë
Kam filluar të shikoj ekipin tim, për të kuptuar se kush kam, dhe përsëri kujtova:
"Shumica e problemeve janë probleme me njerëzit."
Kam zbuluar se në ekip, si te zhvilluesit ashtu edhe në Ops, ka tri probleme të mëdha:
- Kënaqësia me situatën aktuale.
- Mungesa e përgjegjësisë — sepse askush kurrë nuk e ka lidhur rezultatin e punës së ekzekutorëve me ndikimin në biznes.
- Frika nga ndryshimi.
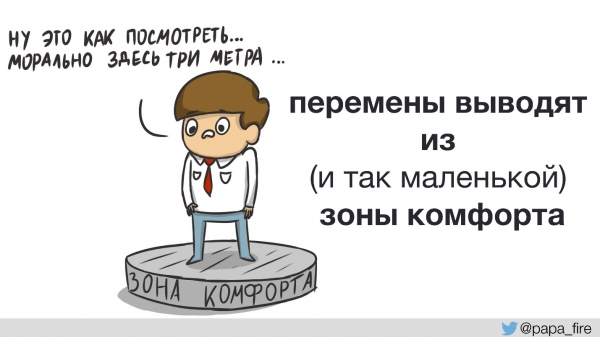
Ndryshimet gjithmonë na nxjerrin jashtë zonës së rehatshme, dhe më rininë, aq më shumë nuk i pëlqejnë ndryshimet, sepse nuk e kuptojnë pse dhe si. Përgjigjja më e zakonshme që kam dëgjuar është: "Ne kurrë nuk e kemi bërë këtë." Kjo arrinte deri në absurditet të plotë — ndonjë ndryshim i vogël nuk kalonte pa që dikush të protestonte. Ndërsa nuk kishte rëndësi se sa ndryshimi prek punën e tyre, ata thoshin: "Jo, përse? Kjo nuk do të funksionojë."
Por nuk mund të bëhesh më i mirë, pa bërë ndonjë ndryshim.
Kisha një bisedë krejtësisht absurde me një punonjës, po i tregoja idetë e mia për optimizimin, dhe ai më tha:
— Ah, ti nuk e di se çfarë kemi pasur vitin e kaluar!
— Po çfarë?
— Tani është shumë më mirë sesa ishte.
— Pra, nuk mund të jetë edhe më mirë?
— Pse jo?
Një pyetje e mirë — pse? Siç duket, nëse tani është më mirë se më parë, do të thotë që gjithçka është mjaft e mirë. Kjo çon në mungesë përgjegjësie, që në parim është krejtësisht normale. Siç thashë, grupi teknik ishte paksa në margjina. Në kompani e menduan se ata duhej të ishin, por askush kurrë nuk vendosi standarde. Në mbështetje teknike kurrë nuk panë SLA, prandaj për grupin ishte mjaft "e pranueshme" (dhe kjo më befasoi më shumë se gjithçka tjetër):
- 12 sekonda ngarkimi;
- 5-10 minuta kohë ndalimi për çdo lëshim;
- në zgjidhjen e çështjeve kritike merr ditë dhe javë;
- mungesë roje 24/7 / on-call.
Askush kurrë nuk përpiqej të pyeste, pse të mos e bëjmë këtë më mirë, dhe askush kurrë nuk e kuptonte se kjo nuk duhej të ishte ashtu.
Si një bonus, kishte edhe një tjetër problem: mungesa e përvojës. Seniorët ikën, dhe ekipi i ri që mbeti u rrit me mënyrën e vjetër dhe u helmohet nga ajo.
Përveç kësaj, njerëzit gjithashtu kishin frikë të dështonin, të duken të paafte. Kjo shprehet në atë se, në radhë të parë, në asnjë rrethanë nuk kërkonin ndihmë. Sa çfarë herësh kemi biseduar në grup dhe individualisht, dhe unë kam thënë: “Bëni pyetje nëse nuk e dini si të bëni diçka”. Jam i sigurt në vetvete dhe e di se mund të zgjidh çdo problem, por do të kërkojë kohë. Prandaj, nëse është e mundur të pyesësh dikë që di si ta zgjidhë për 10 minuta, do ta bëj atë. Sa më pak përvojë të kesh, aq më shumë ke frikë të pyesësh, sepse mendon se do të të konsiderojnë të paaftë.
Kjo frikë për të bërë pyetje shfaqet në forma interesante. Për shembull, pyet: “Si është puna me këtë detyrë?” — “Më mbeten disa orë, e përfundoj”. Ditën tjetër përsëri pyet, merr përgjigje se gjithçka është mirë, por ka dalë një problem i vogël, deri në fund të ditës do të jetë gati. Kalon një ditë tjetër dhe derisa të shtysh dikë për muri dhe ta detyrosh të bisedojë me dikë, kështu vazhdon. Njerëzit duan ta zgjidhin detyrën vetë, mendojnë se nëse nuk e zgjidhin vetë, do të jetë një dështim i madh.
Pikërisht për këtë programuesit e lartësojnë vlerësimet. Ishte një anekdotë e tillë, kur po diskutonim një detyrë të caktuar, më dhanë një numër që e çudit tërë. E m’u tha se në vlerësime programuesi përfshin edhe kohën që bileta do të kthehet nga QA, sepse ata do të gjejnë gabime atje, dhe kohën që do të marrë PR, dhe kohën derisa njerëzit që duhet ta shqyrtojnë atë janë të zënë — pra, çdo gjë që është e mundshme.
Përveç kësaj, njerëzit që kanë frikë të duken të paaftë, analizojnë tepër. Kur thua se çfarë saktësisht duhet të bëhet, fillon: “Jo, por çfarë nëse të mendojmë këtu?” Në këtë sens, kompania jonë nuk është unike, kjo është një problem standard i rinisë.
Në përgjigje, kam futur praktikat e mëposhtme:
- Rregulli 30 minuta. Nëse për gjysmë ore nuk mund të zgjidhni problemin, kërkoni ndihmën e dikujt. Kjo funksionon me sukses të ndryshueshëm, sepse njerëzit gjithsesi nuk kërkojnë, por së paku procesi ka filluar.
- Të përjashtosh gjithçka përveç esencës, në vlerësimin e afatit të përfundimit të detyrës, pra të llogaritësh vetëm se sa kohë do të kërkojë shkrimi i kodit.
- Mësimi i vazhdueshëm për ata që analizojnë tepër. Kjo është thjesht një punë e vazhdueshme me njerëzit.
Dita e seksdhetë
Ndërsa merresha me të gjitha këto, erdhi koha të merrem me buxhetin. Sigurisht, kam gjetur shumë interesante për ato ku i shpenzojmë paratë. Për shembull, kishim një raft të tërë në një qendër të veçantë të të dhënave, ku ishte një server FTP që përdorej nga një klient. Doli që "... ne po transferoheshim, dhe ai mbeti aty, nuk e ndryshuam." Kjo ndodhi 2 vjet më parë.
Një interes të veçantë kishte llogaria për shërbimet në re. Jam i sigurt se arsyeja kryesore për llogarinë e madhe për shërbimet në re është zhvilluesit, të cilët për herë të parë në jetë kanë qasje të pakufizuar në serverë. Ata nuk kanë nevojë të kërkojnë: "Më jepni, ju lutem, një server provë" - ata mund ta marrin vetë. Për më tepër, zhvilluesit gjithmonë dëshirojnë të ndërtojnë një sistem kaq të shkëlqyer sa që Facebook-u dhe Netflixi të ndiejnë xhelozi.
Por zhvilluesit nuk kanë përvojë në blerjen e serverëve dhe aftësinë për të përcaktuar madhësinë e duhur të serverëve, sepse nuk u nevojitej më parë. Dhe zakonisht ata nuk e kuptojnë plotësisht dallimin midis shkallueshmërisë dhe performancës.
Rezultatet e inventarizimit:
- Dola nga një qendër të dhënash.
- Shtypëm kontratën me 3 shërbime log. Sepse kishim 5 prej tyre - çdo zhvillues që fillonte të luante me diçka merrte një të re.
- Mbyllëm 7 sisteme AWS. Edhe një herë, projektet që kishin vdekur nuk i ndaloi askush, ato vazhduan të funksiononin.
- Kemi ulur shpenzimet për softin me 6 herë.
Dita e shtatëdhjetë e pestë
Koha kalonte, dhe pas dy muajsh e gjysmë duhej të takohesha me këshillin e drejtorëve. Këshilli ynë i drejtorëve nuk është më i mirë dhe as më keq se të tjerët, ai si të gjithë këshillat e drejtorëve dëshiron të di gjithçka. Njerëzit investojnë para dhe duan të kuptojnë sa mirë ajo që bëjmë përshtatet me KPI-të e caktuara.
Këshilli i drejtorëve merr shumë informacione çdo muaj: numrin e përdoruesve, rritjen e tyre, cilat shërbime po përdorin dhe si, përformancën dhe produktivitetin, në fund, shpejtësinë mesatare të ngarkesës së faqes.
Problemi vetëm është se unë mendoj se mesatarja është e pastër e keqe. Por është shumë e vështirë t'ua shpjegoj këshillit të drejtorëve. Ata janë të zakonshëm në të përdorin numra të agreguar, e jo për shembull, shpërndarjen e kohës së ngarkesës në sekonda.
Në lidhje me këtë, kishte momente interesante. Për shembull, thashë se duhet të ndanim trafikun midis serverëve të veçantë të websajteve në varësi të llojit të përmbajtjes.
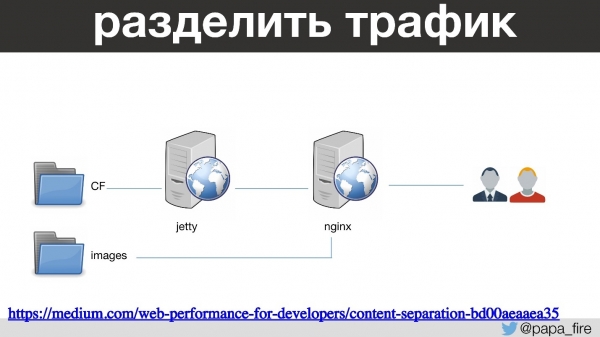
Prahtet që ColdFusion kalon përmes Jetty dhe nginx dhe nxjerr faqet. Pamjet, JS dhe CSS shkojnë përmes një nginx të veçantë me konfigurimet e tyre. Kjo është një praktikë mjaft standarde, për të cilën unë kisha folur disa vite më parë. Si rezultat, pamjet ngarkohen shumë më shpejt dhe … shpejtësia mesatare e ngarkimit është rritur me 200 ms.
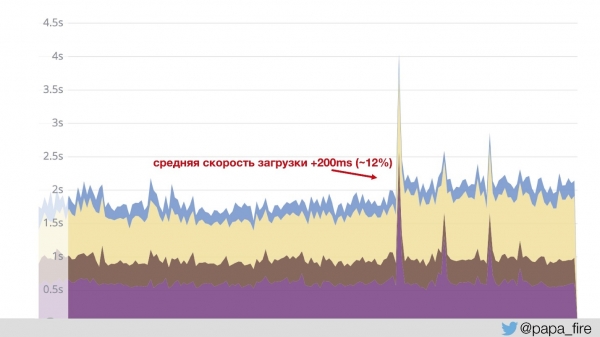
Kjo ndodhi sepse grafiku ndërtohet në bazë të të dhënave që vinë nga Jetty. Kështu që përmbajtja e shpejtë nuk përfshihet në llogaritje — niveli mesatar u rrit. Ne e kuptuam këtë, u qeshëm, por si ta shpjegojmë këshillit të drejtorëve pse kemi bërë diçka dhe rezultati u përkeqësua me 12%?
Dita e tre për të pesëdhjetë
Në fund të muajit të tretë kuptova se për një gjë nuk kisha llogaritur fare — është koha. Për gjithçka që kam folur, kërkohet kohë.
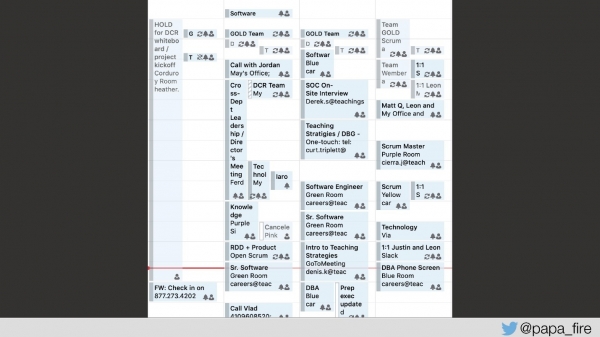
Këtu është kalendari im i vërtetë për javën — thjesht një javë pune, e cila nuk është shumë e ngarkuar. Koha nuk mjafton për gjithçka. Prandaj, përsëri, duhet të angazhojmë njerëz që do të ndihmojnë të përballojmë problemet.
Përfundim
Kjo nuk është gjithçka. Në këtë tregim, unë ende nuk kam arritur në atë sesi punuam me produktin dhe u përpoqëm të kalojmë në një valë të përbashkët, ose si integrojmë mbështetje teknike, ose si zgjidhim problema të tjera teknike. Për shembull, fatkeqësisht zbulova se në tabelat më të mëdha në bazën e të dhënave nuk e përdorim SEQUENCE. Ne kemi një funksion të shkruar vetë nextID, dhe nuk përdoret në transaksion.
Ishte edhe një milion gjëra të ngjashme, për të cilat mund të flitet gjatë. Por më e rëndësishmja që duhet thënë, është kultura.
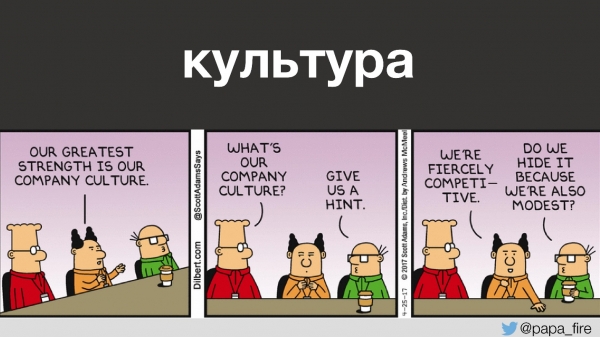
Pikërisht kultura ose mungesa e saj sjell problemet e tjera. Ne përpiqemi të ndërtojmë një kulturë ku njerëzit:
- nuk frikësohen nga dështimet;
- mësojnë nga gabimet;
- bashkëpunojnë me ekipe të tjera;
- shprehin iniciativa;
- marrin përgjegjësi për veten;
- miratojnë rezultatet si synim;
- festojnë suksesin.
Me këtë, çdo gjë tjetër do të vijë.
Leon Fajer , dhe në .
Në lidhje me trashëgiminë, ka dy strategji: të shmangim me çdo kusht punën me të, ose të përballojmë guximshëm vështirësitë e saj. Ne jemi në rrugën e dytë, duke ndryshuar proceset dhe qasjet. Bashkohuni me ne në , dhe , dhe le të implementojmë së bashku kulturën DevOps.
Burimi: habr.com
