

Përshëndetje, Habr!
Ju kujtojmë se pas librit për ne lëshuam një punim të pakrahasueshëm mbi bibliotekën .
Derisa komiteti vetëm po e shqyrton kufijtë e mundësive të këtij instrumenti të fuqishëm. Së fundmi, doli një artikull, me përkthimin e të cilit dëshirojmë t'ju njohim. Autori ndan përvojën e tij se si të shndërrohet Kafka Streams në një depo të shpërndarë të të dhënave. Lexim të këndshëm!
Biblioteka Apache përdoret në të gjithë botën në ndërmarrje për përpunimin e shpërndarë të rrjedhave mbi Apache Kafka. Një nga aspektet e nënvlerësuara të këtij framework është se ai lejon ruajtjen e gjendjes lokale, e cila krijohet mbi bazën e përpunimit të rrjedhave.
Në këtë artikull, do të flas për mënyrën se si në kompaninë tonë arritëm ta shfrytëzojmë me përfitim këtë mundësi në zhvillimin e një produkti për sigurinë e aplikacioneve në re. Me ndihmën e Kafka Streams, ne krijuam mikroshërbime me gjendje të ndarë, secili prej të cilëve na shërben si një burim i besueshëm dhe me disponueshmëri të lartë për informacionin e saktë mbi gjendjen e objekteve në sistem. Ky është një hap përpara për ne në lidhje me qëndrueshmërinë dhe lehtësinë e mbështetjes.
Nëse jeni të interesuar për një qasje alternative, e cila lejon përdorimin e një baze të dhënash qendrore për mbështetje të gjendjes formale të objekteve tuaja – lexoni, do të jetë interesante...
Pse e konsideruam se erdhi koha të ndryshojmë qasjet tona në punën me gjendjen e ndarë
Na nevojitej të mbështesim gjendjen e objekteve të ndryshme, duke u mbështetur në raportet e agjentëve (p.sh.: a ishte faqja në sulm)? Deri në kalimin në Kafka Streams, shpesh kemi mbështetur menaxhimin e gjendjes në një bazë të dhënash qendrore (+ API shërbimi). Ky qasje ka disa disavantazhe: në mbështetjeja e koherencës dhe sinkronizimit shndërrohet në një sfidë të vërtetë. Baza e të dhënave mund të bëhet një ngushticë, ose mund të përfundojë në dhe të vuajë nga parashikueshmëria.
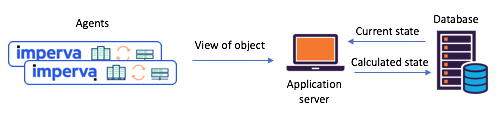
Ilustrimi 1: një skenar tipik i ndarjes së gjendjes, i hasur para kalimit në
Kafka dhe Kafka Streams: agjentët raportojnë përfaqësimet e tyre përmes API-së, gjendja e përditësuar llogaritet përmes bazës qendrore të të dhënave
Njoftohuni me Kafka Streams – tani është e lehtë të krijoni mikroshërbime me gjendje të ndarë
Rreth një vit më parë, ne vendosëm ta rishqyrtonim me kujdes skenarët tanë të punës me gjendjen e ndarë, për të zgjidhur disa probleme. Menjëherë vendosëm të provojmë Kafka Streams – është e njohur sa e shkallëzueshme, e disponueshme dhe rezistente ndaj dështimeve, dhe sa e pasur është funksionaliteti i saj për përpunimin e rrjedhave (përfshirë transformimet, duke ruajtur gjendjen). Pikërisht ajo që na duhej, pa përmendur se sa e pjekur dhe e besueshme është sistemi i ndërrimit të mesazheve që ndodhet në Kafka.
Çdo njëri nga mikroshërbimet që kemi krijuar me ruajtjen e gjendjes është ndërtuar mbi një instancë të Kafka Streams me një topologji mjaft të thjeshtë. Ai përbëhej nga 1) burimi 2) procesori me një depo të përhershme të çelësave dhe vlerave 3) skema:
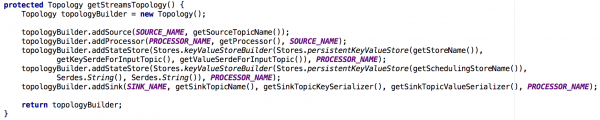
Ilustrimi 2: topologjia e parazgjedhur e instancave tona të rrjedhave për mikroshërbimet me ruajtjen e gjendjes. Vini re: këtu ka gjithashtu një depo që përmban metadatë mbi planifikimin.
Me këtë qasje të re, agjentët krijojnë mesazhe që dërgohen në topikun fillestar, ndërsa konsumatorët – le të themi, shërbimi i njoftimeve me postë – pranojnë gjendjen e ndarë të llogaritur përmes skemës (topikut të daljes).
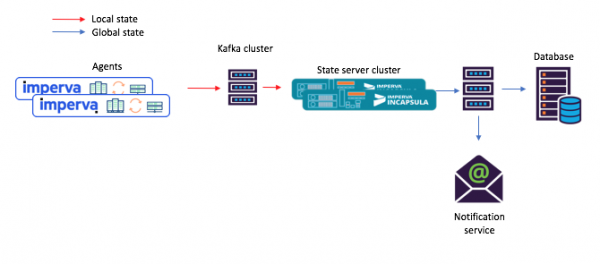
Ilustrimi 3: një shembull i ri i rrjedhës së detyrave për një skenar me mikroshërbime të ndara: 1) agjenti krijon një mesazh që dërgohet në topikun fillestar të Kafka; 2) mikroshërbimi me gjendjen e ndarë (duke përdorur Kafka Streams) e përpunon atë dhe regjistron gjendjen e llogaritur në topikun përfundimtar të Kafka; pas kësaj, 3) konsumatorët pranojnë gjendjen e re.
Hej, dhe kjo depo e integruar e çelësave dhe vlerave në të vërtetë është shumë e dobishme!
Siç u përmend më sipër, topologjia jonë me gjendjen e ndarë përmban një depo të çelësave dhe vlerave. Gjetëm disa opsione për ta përdorur atë, dhe dy prej tyre janë përshkruar më poshtë.
Opsioni #1: përdorimi i depos së çelësave dhe vlerave gjatë llogaritjeve
Depo i parë i çelësave dhe vlerave përmbante të dhëna ndihmëse që na duheshin për llogaritje. Për shembull, në disa raste, gjendja e ndarë përcaktohej në bazë të principit të "shumicës së votave". Në depo mund të mbaheshin të gjitha raportet e fundit të agentëve mbi gjendjen e një objekti të caktuar. Pastaj, duke marrë një raport të ri nga ndonjë agent, ne mund të ruanim atë, të nxirrnim nga depo raportet e të gjithë agjenteve të tjerë mbi gjendjen e të njëjtit objekt dhe të përsëritnim llogaritjen.
Në ilustrimin 4 më poshtë tregohet se si ne hapëm aksesin në depo të çelësave dhe vlerave për metodën e përpunimit të procesorit, në mënyrë që të mund të përprocessonim një mesazh të ri.
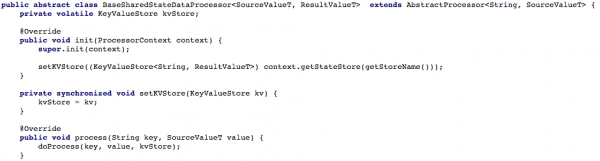
Ilustrimi 4: hapja e aksesit në depo të çelësave dhe vlerave për metodën e përpunimit të procesorit (pas kësaj, në çdo skenar që punon me gjendje të ndarë, nevojitet implementimi i metodës doProcess)
Varianti #2: krijimi i API CRUD mbi Kafka Streams
Pas vendosjes së rrjedhës sonë bazike të detyrave, filluam të provonim të shkruanim një API RESTful CRUD për mikro-shërbimet tona me gjendje të ndarë. Ne donim që të ishte e mundur të nxirrnim gjendjen e disa ose të gjithë objekteve, si dhe të vendosnim ose fshija gjendjen e një objekti (kjo është e dobishme për mbështetje në anën server).
Për të mbështetur të gjithë API Get State, sa herë që na nevojitej të ripërcaktonim gjendjen gjatë përpunimit, ne e ruanim atë në depo të integruar të çelësave dhe vlerave. Në këtë rast, bëhet mjaft e thjeshtë të implementosh një API të tillë duke përdorur një instancë të vetëm të Kafka Streams, siç tregohet në listimin e mëposhtëm:
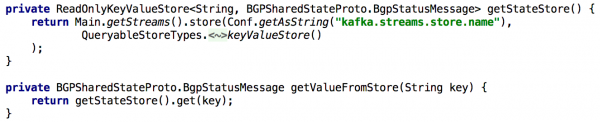
Ilustrimi 5: përdorimi i depo të integruar të çelësave dhe vlerave për marrjen e gjendjes paraprakisht të llogaritur të një objekti
Përditësimi i gjendjes së një objekti përmes API gjithashtu nuk është e vështirë të implementohet. Në thelb, për këtë nevojitet vetëm të krijosh një prodhues Kafka dhe me të të bësh një shkruarje, që përmban gjendjen e re. Kështu sigurohet që të gjitha mesazhet e gjeneruara përmes API do të përpunohen pikërisht ashtu si ato që vijnë nga prodhues të tjerë (p.sh., agjentëve).
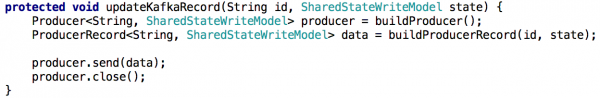
Ilustrimi 6: gjendjen e një objekti mund ta caktosh përmes një prodhuesi Kafka
Një komplikim i vogël: Kafka ka shumë parti
Më pas, donim të shpërndanim ngarkesën e përpunimit dhe të përmirësonim disponueshmërinë duke ofruar një grup mikroshërbimesh me gjendje të përbashkët për çdo skenar. Konfigurimi doli të ishte mjaft i thjeshtë: pasi e konfiguruan të gjithë instancat që të punonin me të njëjtin ID të aplikacionit (dhe me të njëjtin server të ngarkesës fillestare), pothuajse gjithçka tjetër u bë automatikisht. Ne gjithashtu caktuam që çdo temë burimi do të përbëhej nga disa pjesë, për t'i dhënë çdo instance një nën-grup të këtyre pjesëve.
Dëshiroj gjithashtu të përmend se këtu është e zakonshme të bëhet një kopje rezervë e magazinës së gjendjes, në mënyrë që, për shembull, në rast rikuperimi nga dështimi, të mund të transferohet kjo kopje në një instancë tjetër. Për çdo magazinë gjendjeje në Kafka Streams krijohet një temë e replikueshme me një regjistër të ndryshimeve (në të cilin ndjeken përditësimet lokale). Kështu, Kafka siguron vazhdimisht magazinën e gjendjes. Prandaj, në rast dështimi të një instancës së caktuar, magazina e gjendjes së Kafka Streams mund të rikuperohet shpejt në një instancë tjetër, ku do të transferohen pjesët përkatëse. Testet tona treguan se kjo bëhet në pak sekonda edhe nëse magazina përmban miliona regjistrime.
Duke kaluar nga një mikroshërbim me gjendje të përbashkët në një grup mikroshërbimesh, realizimi i Get State API bëhet një sfidë më e madhe. Në situatën e re, magazina e gjendjes për çdo mikroshërbim përmban vetëm një pjesë të panoramës së përgjithshme (ato objekte, çelësat e të cilave janë mapuar në një pjesë të caktuar). Duhej të përcaktonim se në cilën instancë ndodhej gjendja e objektit që na nevojitej, dhe ne e bëmë këtë mbi bazën e metadatave të rrjedhave, siç tregohet më poshtë:
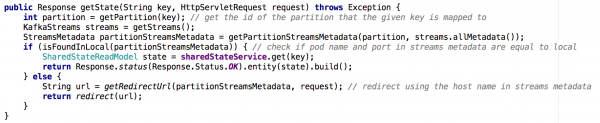
Ilustrimi 7: me ndihmën e metadatave të rrjedhave ne përcaktojmë se nga cilë instancë duhet të kërkojmë gjendjen e objektit në fjalë; një qasje e tillë është përdorur me GET ALL API.
Konkluzionet kryesore
Magazinën e gjendjeve në Kafka Streams de-facto mund të shërbejë si një bazë të dhënash të shpërndara,
- e cila është vazhdimisht e replikueshme në Kafka
- Mbi një sistem të tillë lehtë mund të ndërtohet një CRUD API
- Përpunimi i shumë pjesëve del të jetë pak më i komplikuar
- Është gjithashtu e mundur të shtoni një ose më shumë depo të gjendjeve në topologjinë e përpunimit të të dhënave për ruajtjen e të dhënave ndihmëse. Ky variant mund të përdoret për:
- Ruajtjen afatgjatë të të dhënave të nevojshme për llogaritjet gjatë përpunimit të të dhënave në rrjedhë
- Ruajtjen afatgjatë të të dhënave që mund të jenë të dobishme gjatë inicializimit të ardhshëm të instancës së rrjedhës
- shumë gjëra të tjera…
Me këto dhe nëntë të tjera, Kafka Streams është jashtëzakonisht e përshtatshme për të mbështetur gjendjen globale në një sistem të tillë të shpërndarë si i yni. Kafka Streams ka treguar stabilitet të shkëlqyer në prodhim (që nga vendosja e saj nuk kemi humbur praktikisht asnjë mesazh), dhe ne jemi të bindur se mundësitë e saj nuk kufizohen vetëm këtu!
Burimi: habr.com
