

Parathënie
Shumë shpesh përdoruesit, zhvilluesit dhe administratorët e DBMS MS SQL Server përballen me probleme të performancës së DB-së ose të DBMS-së në tërësi, prandaj monitorimi i MS SQL Server-it është shumë i rëndësishëm.
Ky artikull është një shtesë për artikullin dhe në të do të shqyrtohen disa aspekte të monitorimit të MS SQL Server, në veçanti: si të identifikohet shpejt mungesa e burimeve, si dhe rekomandime për konfigurimin e flamujve të gjurmimit.
Për të funksionuar skritet e mëposhtme, është e nevojshme të krijoni skemën inf në databazën e nevojshme në këtë mënyrë:
Krijimi i skemës inf
use ;
go
create schema inf;
Metoda për të identifikuar mungesën e memorjes operative
Të parën shenjë të mungesës së memorjes operative është rasti kur instanca e MS SQL Server merr të gjithë RAM-in e gjithanshëm të caktuar.
Për këtë, do të krijojmë pamjen e mëposhtme inf.vRAM:
Krijimi i pamjes inf.vRAM
CREATE view [inf].[vRAM] as
select a.[TotalAvailOSRam_Mb]						--sa është e lirë RAM-i në server në MB
		 , a.[RAM_Avail_Percent]					--përqindja e RAM-it të lirë në server
		 , a.[Server_physical_memory_Mb]				--sa është gjithsej RAM-i në server në MB
		 , a.[SQL_server_committed_target_Mb]			--sa është gjithsej RAM-i i caktuar për MS SQL Server në MB
		 , a.[SQL_server_physical_memory_in_use_Mb] 		--sa është gjithsej RAM-i që konsumon MS SQL Server në këtë moment në MB
		 , a.[SQL_RAM_Avail_Percent]				--përqindja e RAM-it të lirë për MS SQL Server në raport me gjithsej RAM-in të caktuar për MS SQL Server
		 , a.[StateMemorySQL]						--a ka mjaft RAM për MS SQL Server
		 , a.[SQL_RAM_Reserve_Percent]				--përqindja e RAM-it të caktuar për MS SQL Server në raport me gjithsej RAM-in në server
		 --a ka mjaft RAM për serverin
		, (case when a.[RAM_Avail_Percent]5 and a.[TotalAvailOSRam_Mb]<8192 then 'Warning' when a.[RAM_Avail_Percent]<=5 and a.[TotalAvailOSRam_Mb]<2048 then 'Danger' else 'Normal' end) as [StateMemoryServer]
	from
	(
		select cast(a0.available_physical_memory_kb/1024.0 as int) as TotalAvailOSRam_Mb
			 , cast((a0.available_physical_memory_kb/casT(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [RAM_Avail_Percent]
			 , a0.system_low_memory_signal_state
			 , ceiling(b.physical_memory_kb/1024.0) as [Server_physical_memory_Mb]
			 , ceiling(b.committed_target_kb/1024.0) as [SQL_server_committed_target_Mb]
			 , ceiling(a.physical_memory_in_use_kb/1024.0) as [SQL_server_physical_memory_in_use_Mb]
			 , cast(((b.committed_target_kb-a.physical_memory_in_use_kb)/casT(b.committed_target_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Avail_Percent]
			 , cast((b.committed_target_kb/casT(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Reserve_Percent]
			 , (case when (ceiling(b.committed_target_kb/1024.0)-1024)<ceiling(a.physical_memory_in_use_kb/1024.0) then 'Warning' else 'Normal' end) as [StateMemorySQL]
		from sys.dm_os_sys_memory as a0
		cross join sys.dm_os_process_memory as a
		cross join sys.dm_os_sys_info as b
		cross join sys.dm_os_sys_memory as v
	) as a;
Atëherë, për të përcaktuar se sa memorje të dedikuar konsumon instanca MS SQL Server, mund të përdorim këtë pyetje:
select  SQL_server_physical_memory_in_use_Mb,  SQL_server_committed_target_Mb
from [inf].[vRAM];
Nëse treguesi SQL_server_physical_memory_in_use_Mb nuk është vazhdimisht më i vogël se SQL_server_committed_target_Mb, është e nevojshme të kontrollojmë statistikat e pritjes.
Për të përcaktuar mungesën e memorjes së operativës përmes statistikave të pritjes, do të krijojmë një pamje inf.vWaits:
Krijimi i pamjes inf.vWaits
CREATE view [inf].[vWaits] as
WITH [Waits] AS
    (SELECT
        [wait_type], --emri i tipit të pritjes
        [wait_time_ms] / 1000.0 AS [WaitS],--Koha totale e pritjes për këtë tip në milisekonda. Kjo kohë përfshin signal_wait_time_ms
        ([wait_time_ms] - [signal_wait_time_ms]) / 1000.0 AS [ResourceS],--Koha totale e pritjes për këtë tip në milisekonda pa signal_wait_time_ms
        [signal_wait_time_ms] / 1000.0 AS [SignalS],--Dallimi midis kohës së sinjalizimit të procesit në pritje dhe kohës së fillimit të ekzekutimit të tij
        [waiting_tasks_count] AS [WaitCount],--Numri i pritjeve për këtë tip. Ky numër rritet çdo herë që fillon një pritje
        100.0 * [wait_time_ms] / SUM ([wait_time_ms]) OVER() AS [Percentage],
        ROW_NUMBER() OVER(ORDER BY [wait_time_ms] DESC) AS [RowNum]
    FROM sys.dm_os_wait_stats
    WHERE [waiting_tasks_count]>0
		and [wait_type] NOT IN (
        N'BROKER_EVENTHANDLER',         N'BROKER_RECEIVE_WAITFOR',
        N'BROKER_TASK_STOP',            N'BROKER_TO_FLUSH',
        N'BROKER_TRANSMITTER',          N'CHECKPOINT_QUEUE',
        N'CHKPT',                       N'CLR_AUTO_EVENT',
        N'CLR_MANUAL_EVENT',            N'CLR_SEMAPHORE',
        N'DBMIRROR_DBM_EVENT',          N'DBMIRROR_EVENTS_QUEUE',
        N'DBMIRROR_WORKER_QUEUE',       N'DBMIRRORING_CMD',
        N'DIRTY_PAGE_POLL',             N'DISPATCHER_QUEUE_SEMAPHORE',
        N'EXECSYNC',                    N'FSAGENT',
        N'FT_IFTS_SCHEDULER_IDLE_WAIT', N'FT_IFTSHC_MUTEX',
        N'HADR_CLUSAPI_CALL',           N'HADR_FILESTREAM_IOMGR_IOCOMPLETION',
        N'HADR_LOGCAPTURE_WAIT',        N'HADR_NOTIFICATION_DEQUEUE',
        N'HADR_TIMER_TASK',             N'HADR_WORK_QUEUE',
        N'KSOURCE_WAKEUP',              N'LAZYWRITER_SLEEP',
        N'LOGMGR_QUEUE',                N'ONDEMAND_TASK_QUEUE',
        N'PWAIT_ALL_COMPONENTS_INITIALIZED',
        N'QDS_PERSIST_TASK_MAIN_LOOP_SLEEP',
        N'QDS_CLEANUP_STALE_QUERIES_TASK_MAIN_LOOP_SLEEP',
        N'REQUEST_FOR_DEADLOCK_SEARCH', N'RESOURCE_QUEUE',
        N'SERVER_IDLE_CHECK',           N'SLEEP_BPOOL_FLUSH',
        N'SLEEP_DBSTARTUP',             N'SLEEP_DCOMSTARTUP',
        N'SLEEP_MASTERDBREADY',         N'SLEEP_MASTERMDREADY',
        N'SLEEP_MASTERUPGRADED',        N'SLEEP_MSDBSTARTUP',
        N'SLEEP_SYSTEMTASK',            N'SLEEP_TASK',
        N'SLEEP_TEMPDBSTARTUP',         N'SNI_HTTP_ACCEPT',
        N'SP_SERVER_DIAGNOSTICS_SLEEP', N'SQLTRACE_BUFFER_FLUSH',
        N'SQLTRACE_INCREMENTAL_FLUSH_SLEEP',
        N'SQLTRACE_WAIT_ENTRIES',       N'WAIT_FOR_RESULTS',
        N'WAITFOR',                     N'WAITFOR_TASKSHUTDOWN',
        N'WAIT_XTP_HOST_WAIT',          N'WAIT_XTP_OFFLINE_CKPT_NEW_LOG',
        N'WAIT_XTP_CKPT_CLOSE',         N'XE_DISPATCHER_JOIN',
        N'XE_DISPATCHER_WAIT',          N'XE_TIMER_EVENT')
    )
, ress as (
	SELECT
	    [W1].[wait_type] AS [WaitType],
	    CAST ([W1].[WaitS] AS DECIMAL (16, 2)) AS [Wait_S],--Koha totale e pritjes për këtë tip në milisekonda. Kjo kohë përfshin signal_wait_time_ms
	    CAST ([W1].[ResourceS] AS DECIMAL (16, 2)) AS [Resource_S],--Koha totale e pritjes për këtë tip në milisekonda pa signal_wait_time_ms
	    CAST ([W1].[SignalS] AS DECIMAL (16, 2)) AS [Signal_S],--Dallimi midis kohës së sinjalizimit të procesit në pritje dhe kohës së fillimit të ekzekutimit të tij
	    [W1].[WaitCount] AS [WaitCount],--Numri i pritjeve për këtë tip. Ky numër rritet çdo herë që fillon një pritje
	    CAST ([W1].[Percentage] AS DECIMAL (5, 2)) AS [Percentage],
	    CAST (([W1].[WaitS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgWait_S],
	    CAST (([W1].[ResourceS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgRes_S],
	    CAST (([W1].[SignalS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgSig_S]
	FROM [Waits] AS [W1]
	INNER JOIN [Waits] AS [W2]
	    ON [W2].[RowNum] <= [W1].[RowNum]
	GROUP BY [W1].[RowNum], [W1].[wait_type], [W1].[WaitS],
	    [W1].[ResourceS], [W1].[SignalS], [W1].[WaitCount], [W1].[Percentage]
	HAVING SUM ([W2].[Percentage]) - [W1].[Percentage] < 95 -- kufiri i përqindjes
)
SELECT [WaitType]
      ,MAX([Wait_S]) as [Wait_S]
      ,MAX([Resource_S]) as [Resource_S]
      ,MAX([Signal_S]) as [Signal_S]
      ,MAX([WaitCount]) as [WaitCount]
      ,MAX([Percentage]) as [Percentage]
      ,MAX([AvgWait_S]) as [AvgWait_S]
      ,MAX([AvgRes_S]) as [AvgRes_S]
      ,MAX([AvgSig_S]) as [AvgSig_S]
  FROM ress
  group by [WaitType];
Në këtë rast, mund të përcaktoni mungesën e memories RAM me këtë pyetje:
SELECT [Percentage]
      ,[AvgWait_S]
  FROM [inf].[vWaits]
  where [WaitType] in (
    'PAGEIOLATCH_XX',
    'RESOURCE_SEMAPHORE',
    'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Këtu duhet të vini re treguesit Percentage dhe AvgWait_S. Nëse ato janë të rëndësishme në përmbledhjen e tyre, ka një probabilitet të madh që instance e MS SQL Server i mungon memoria RAM. Vlerat e rëndësishme përcaktohen individualisht për çdo sistem. Megjithatë, mund të filloni me treguesin e mëposhtëm: Percentage >= 1 dhe AvgWait_S >= 0.005.
Për të nxjerrë treguesit në sistemin e monitorimit (p.sh., Zabbix), mund të krijoni këto dy pyetje:
- sa përqind zënë tipet e pritjeve për RAM (shuma e të gjitha këtyre llojeve të pritjeve):
select coalesce(sum([Percentage]), 0.00) as [Percentage] from [inf].[vWaits] where [WaitType] in ( 'PAGEIOLATCH_XX', 'RESOURCE_SEMAPHORE', 'RESOURCE_SEMAPHORE_QUERY_COMPILE' ); - sa në milisekonda zënë tipet e pritjeve për RAM (vlera maksimale nga të gjithë pritjet mesatare për të gjitha këto lloje pritjesh):
select coalesce(max([AvgWait_S])*1000, 0.00) as [AvgWait_MS]
from [inf].[vWaits]
       where [WaitType] in (
           'PAGEIOLATCH_XX',
           'RESOURCE_SEMAPHORE',
            'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Duke u bazuar në dinamikën e vlerave të marra për këto dy tregues, mund të konstatoni nëse mjafton RAM për instance e MS SQL Server.
Metoda për identifikimin e ngarkesës së tepërt në CPU
Për të identifikuar mungesën e kohës së procesorit, mjafton të përdorni pamjen sistemike sys.dm_os_schedulers. Këtu, nëse treguesi runnable_tasks_count është gjithmonë më i madh se 1, ka një probabilitet të madh që numri i bërthamave i mungon instance e MS SQL Server.
Për të nxjerrë treguesin në sistemin e monitorimit (p.sh., Zabbix), mund të krijoni këtë pyetje:
select max([runnable_tasks_count]) as [runnable_tasks_count]
from sys.dm_os_schedulers
where scheduler_id < 255;
Duke u bazuar në dinamikën e vlerave të marra për këtë tregues, mund të konstatoni nëse ka mjaft kohë procesori (numër bërthamash CPU) për instance e MS SQL Server.
Megjithatë, është e rëndësishme të mbani mend se vetë kërkesat mund të kërkojnë menjëherë disa procese. Dhe ndonjëherë optimizuesi nuk është në gjendje të vlerësojë saktësisht kompleksitetin e kërkesës. Në atë rast, kërkesa mund të marrë shumë procese, të cilat në atë moment nuk mund të përpunohen njëkohësisht. Kjo gjithashtu shkakton një lloj pritjeje që lidhet me mungesën e kohës së procesorit dhe rritjen e radhës për planifikuesit, të cilët përdorin bërthama të caktuara CPU, kështu që treguesi runnable_tasks_count në këto kushte do të rritet.
Në këtë rast, para se të rritet numri i bërthamave të CPU, është e nevojshme të konfigurohen saktësisht cilësitë e paralelizmit të instancës së MS SQL Server, dhe që nga versioni 2016, të konfigurohen saktësisht cilësitë e paralelizmit të bazave të dhënash të nevojshme:
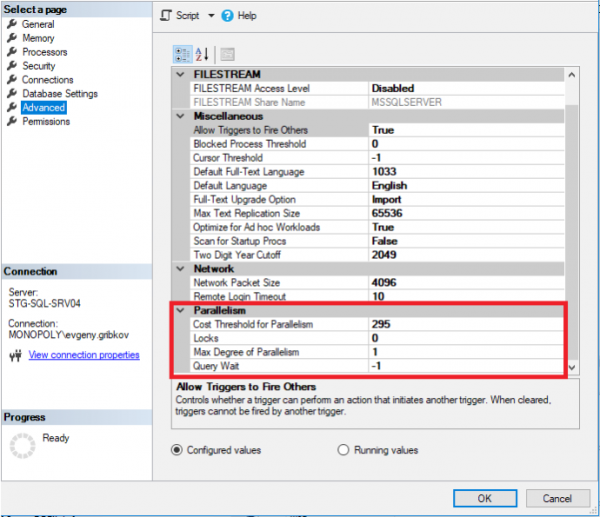
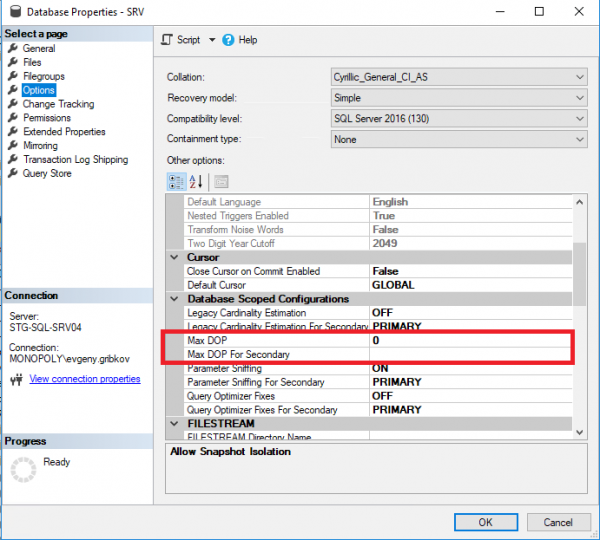
Këtu duhet të kushtohet vëmendje parametrave të mëposhtëm:
- Max Degree of Parallelism - përcakton numrin maksimal të proceseve që mund të jepen për çdo kërkesë (në parazgjedhje është 0 - kufizimi është vetëm i sistemit operativ dhe edicionit të MS SQL Server)
- Cost Threshold for Parallelism - vlera e kostos së vlerësimit për paralelizmin (në parazgjedhje është 5)
- Max DOP - përcakton numrin maksimal të proceseve që mund të jepen për çdo kërkesë në nivelin e bazës së dhënash (por jo më shumë se vlera e pronës "Max Degree of Parallelism") (në parazgjedhje është 0 - kufizimi është vetëm i sistemit operativ dhe edicionit të MS SQL Server, si dhe kufizimi nga prona "Max Degree of Parallelism" të gjithë instancës së MS SQL Server)
Këtu nuk është e mundur të jepet një recetë njësoj të mirë për të gjitha rastet, pra duhet të analizohet kërkesat e rënda.
Nga përvoja ime, rekomandoj algoritmin e mëposhtëm për sistemet OLTP për konfigurimin e pronave të paralelizmit:
- së pari, ndaloni paralelizmin duke vendosur në nivelin e gjithë instancës Max Degree of Parallelism në 1
- analizoni kërkesat më të rënda dhe zgjidhni numrin optimal të proceseve për to
- vendosni Max Degree of Parallelism në numrin optimal të proceseve të përcaktuar në pika 2, si dhe për bazat e dhënash të caktuara vendosni Max DOP vlerën e marrë nga pika 2 për çdo bazë të dhënash
- analizoni kërkesat më të rënda dhe identifikoni efektin negativ nga shumëprocësimi. Nëse ai ekziston, atëherë rritni Cost Threshold for Parallelism.
Për sisteme si 1C, Microsoft CRM dhe Microsoft NAV, në shumicën e rasteve do të jetë e përshtatshme ndalimi i shumëprocësimit.
Poashtu nëse përdoret edicioni Standard, në shumicën e rasteve do të jetë e përshtatshme ndalimi i shumëfishtë për shkak të faktit që ky edicion është i kufizuar në numrin e gjeneratorëve të CPU.
Për sistemet OLAP, algoritmi i përshkruar më sipër nuk është i përshtatshëm.
Nga përvoja ime personale, rekomandoj algoritmin e mëposhtëm për sistemet OLAP për konfigurimin e pronave të paralelizmit:
- analizoni kërkesat më të rënda dhe zgjidhni numrin optimal të proceseve për to
- vendosni Max Degree of Parallelism në numrin optimal të rrymave, i cili është përftuar nga pika 1, dhe për bazat e të dhënave specifike vendosni vlerën Max DOP, e marrë nga pika 1 për secilën bazë të të dhënave.
- analizoni kërkesat më të ngarkuara dhe identifikoni efektin negativ nga kufizimi i paralelizmit. Nëse ka, atëherë ulni vlerën e Cost Threshold for Parallelism, ose përsëritni hapat 1-2 të këtij algoritmi.
Kështu për sistemet OLTP, shkojmë nga një proces të vetëm në shumë procese, ndërsa për sistemet OLAP, përkundrazi, shkojmë nga shumë procese në një proces të vetëm. Kështu mund të përcaktohen cilësimet optimale të paralelizmit si për një bazë të dhënash specifike, ashtu edhe për të gjithë instancën e MS SQL Server.
Po ashtu është e rëndësishme të kuptoni se cilësimet e pronave të paralelizmit duhet të ndryshohen në përputhje me rezultatet e monitorimit të performancës së MS SQL Server me kalimin e kohës.
Rekomandime për konfigurimin e flagjeve të gjurmimit
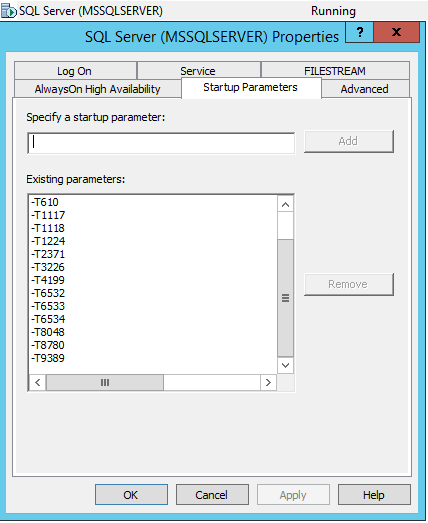
Nga përvoja ime dhe e kolegëve të mi, për funksionimin optimal rekomandoj vendosjen e flagjeve të gjurmimit në nivelin e nisjes së shërbimit MS SQL Server për versionet 2008-2016:
- 610 — Reduktimi i regjistrimit të futjeve në tabelat e indeksuara. Mund të ndihmojë me futjet në tabela me një numër të madh regjistrash dhe shumë transaksionesh, gjatë pritjeve të gjata WRITELOG për ndryshime në indekset.
- 1117 — Nëse një skedar në grupin e skedarëve përmbush kërkesat e pragut të rritjes automatike, të gjithë skedarët në grupin e skedarëve rriten.
- 1118 — Detyron të gjitha objektet të pozicionohen në ekstenta të ndryshme (ndalim i ekstentave të përziera), duke minimizuar nevojën për skanimin e faqes SGAM, e cila përdoret për të ndjekur ekstentet e përziera.
- 1224 — Çaktivizon grumbullimin e bllokimeve në bazë të numrit të bllokimeve. Megjithatë, përdorimi shumë aktiv i memories mund të aktivizojë grumbullimin e bllokimeve.
- 2371 — Ndryshon pragun e azhurnimit automatike të ngurtë të statistikave në pragun e azhurnimit automatike dinamik të statistikave. E rëndësishme për azhurnimin e planeve të kërkesave në lidhje me tabelat e mëdha, ku përcaktimi i gabuar i numrit të regjistrimeve çon në plane ekzekutimi të gabuara.
- 3226 — Shton ndalesat mbi mesazhet e suksesit në ekzekutimin e kopjimeve rezervë në regjistrin e gabimeve.
- 4199 — Aktivizon ndryshimet në optimizuesin e kërkesave, të lëshuara në paketat akumuluese të azhurnimit dhe paketat e azhurnimit të SQL Server.
- 6532-6534 — Aktivizon përmirësimin e performancës së operacioneve të kërkesës me lloje të dhënash hapësinore.
- 8048 — Transformon objektet e memories, të ndara sipas NUMA, në të ndara sipas CPU.
- 8780 — Aktivizon një ndarje shtesë kohe për përgatitjen e planit të kërkesës. Disa kërkesa pa këtë flamur mund të refuzohen, pasi nuk kanë një plan kërkese (një gabim shumë i rrallë).
- 8780 — 9389 — Aktivizon një tampon memoriesh dinamike të siguruar për operatorët e modit të paketimit, duke i dhënë mundësinë operatorit të modit të paketimit të kërkojë më shumë memorie dhe të shmangë transferimin e të dhënave në tempdb, nëse memoria shtesë është e disponueshme.
Po ashtu deri në versionin 2016 është e dobishme të aktivizohet flamuri i gjurmimit 2301, i cili aktivizon optimizimin e mbështetjes së zgjeruar të vendimmarrjes dhe kështu ndihmon në zgjedhjen e planeve më të përshtatshme të kërkesave. Megjithatë, duke filluar nga versioni 2016, ai shpesh ka efekt negativ në kohën e përgjithshme të ekzekutimit të kërkesave.
Po ashtu për sistemet me shumë indekse (p.sh., për databazat 1C), rekomandoj aktivizimin e flamurit të gjurmimit 2330, i cili çaktivizon mbledhjen e përdorimit të indekseve, që ka një efekt pozitiv në sistem në përgjithësi.
Për më shumë detaje rreth flamujve të gjurmimit mund të mësoni.
Në lidhjen e mësipërme është e rëndësishme të merren parasysh versionet dhe ndërtimet e MS SQL Server, pasi për versionet më të reja disa flamuj gjurmimi aktivizohen si parazgjedhje ose nuk kanë ndonjë efekt.
Të aktivizoni dhe çaktivizoni flamurin e gjurmimit mund të bëhet përmes komandave DBCC TRACEON dhe DBCC TRACEOFF përkatësisht. Shikoni më shumë detaje.
Të merrni gjendjen e flamujve të gjurmimit mund të realizohet përmes komandës DBCC TRACESTATUS:
Për të aktivizuar flamujt e gjurmimit në nisjen e shërbimit MS SQL Server, duhet të hyrni në SQL Server Configuration Manager dhe në pronësitë e shërbimit të shtoni këta flamuj gjurmimi nëpërmjet -T:
Përfundime
Në këtë artikull janë shqyrtuar disa aspekte të monitorimit të MS SQL Server, me të cilat mund të identifikoni në kohë mungesën e RAM-it dhe kohës së lirë të CPU-së, si dhe disa probleme të tjera më pak të dukshme. Janë shqyrtuar flamujt më të përdorur të gjurmimit.
Burimet:
»
»
»
»
»
»
»
Burimi: habr.com
