

Deri në kohët e fundit, në Odnoklassniki u ruajtën rreth 50 TB të dhënash që përpunoheshin në kohë reale në SQL Server. Për një volum të tillë, sigurimi i një qendra të të dhënave të shpejtë dhe të besueshme, për më tepër të qëndrueshme ndaj dështimeve, duke përdorur një DBMS SQL, është thuajse e pamundur. Në raste të tilla zakonisht përdoren një nga ruajtjet NoSQL, por nuk gjithçka mund të jetë e transferueshme në NoSQL: disa entitete kërkojnë garanci ACID për transaksionet.
Kjo na çoi në përdorimin e një ruajtje NewSQL, dmth një DBMS që ofron qëndrueshmëri, shkallëzueshmëri dhe shpejtësi të sistemeve NoSQL, por që ruan gjithashtu garancitë ACID që jemi mësuar të përdorim në sistemet tradicionale. Sistemet industriale që funksionojnë nga kjo klasë të re janë pak, prandaj ne realizuam një sistem të tillë vetë dhe e lançuam atë në prodhim.
Si funksionon dhe çfarë është arritur - lexoni më poshtë.
Sot, audienca mujore e "Odnoklassniki" kap më shumë se 70 milion vizitorë unikë. Ne rrjetet sociale më të mëdha në botë, dhe në dvigjithja më e madhe e faqeve në të cilat përdoruesit kalojnë më shumë kohë. Infrastrukturën e "OK" e përpunon ngarkesa shumë të larta: më shumë se një milion kërkesa HTTP/s në frontet. Pjesët e parkut të serverëve që përbëhen nga më shumë se 8000 njësi janë të vendosura afër njëri-tjetrit - në katër qendra të të dhënave në Moskë, çka lejon sigurimin e një vonese rrjeti më pak se 1 ms mes tyre.
Ne kemi përdorur Cassandra që nga viti 2010, duke filluar me versionin 0.6. Sot, në përdorim janë disa dhjetëra grupe. Grupi më i shpejtë përpunon më shumë se 4 milion operacione në sekondë, ndërsa grupi më i madh ruan 260 TB.
Megjithatë, të gjitha këto janë grupe të zakonshme NoSQL, që përdoren për ruajtjen e Ne dëshironim të zëvendësonim ruajtjen kryesore të konsistencës, Microsoft SQL Server, e cila është përdorur që nga themelimi i "Odnoklassniki". Ruajtja përbëhej nga më shumë se 300 makina SQL Server Standard Edition, të cilat mbajtën 50 TB të dhënash - entitete biznesi. Këto të dhëna modifikohen në kuadër të transaksioneve ACID dhe kërkojnë .
Për shpërndarjen e të dhënave mbi nodet SQL Server ne përdorëm si vertikalen ashtu edhe (shardimi). Historically, we used a simple data sharding scheme: each entity was assigned a token — a function of the entity's ID. Entities with the same token were placed on the same SQL server. The master-detail relationship was implemented so that the tokens of the primary and derived records always matched and were located on the same server. In a social network, almost all records are generated on behalf of the user — meaning all user data within one functional subsystem is stored on one server. Therefore, in business transactions, tables from the same SQL server were almost always involved, which allowed us to ensure data consistency using local ACID transactions without the need for distributed ACID transactions.
Thanks to sharding and to speed up SQL performance:
- We do not use Foreign key constraints, as with sharding the entity ID may reside on another server.
- We do not use stored procedures and triggers due to the additional load on the DBMS CPU.
- We do not use JOINs because of all the above and the numerous random disk reads.
- Outside of transactions, to reduce deadlocks, we use the Read Uncommitted isolation level.
- We only execute short transactions (on average shorter than 100 ms).
- We do not use multi-row UPDATE and DELETE due to the high number of deadlocks — we update only one record at a time.
- Queries are always executed only using indexes — a query with a full table scan plan means an overload of the DB and its failure.
These steps allowed us to extract almost maximum performance from SQL servers. However, the problems kept increasing. Let's take a look at them.
Problems with SQL
- Since we used custom sharding, adding new shards was performed manually by administrators. During this time, scalable data replicas did not handle queries.
- As the number of records in the table increases, the speed of inserts and modifications decreases; adding indexes to an existing table drastically reduces speed, and creating and recreating indexes comes with downtime.
- Having a small number of Windows for SQL Server in production complicates infrastructure management.
But the main problem is —
Qëndrueshmëri
Klasik SQL server ka një qëndrim të dobët ndaj dështimeve. Le të themi se keni vetëm një server databaze, dhe ai dështon një herë çdo tre vjet. Gjatë këtij kohe, faqja e internetit nuk funksionon për 20 minuta, kjo është e pranueshme. Nëse keni 64 serverë, faqja e internetit nuk funksionon një herë çdo tri javë. Dhe nëse keni 200 serverë, faqja e internetit nuk funksionon çdo javë. Kjo është një problem.
Çfarë mund të bëhet për të rritur qëndrueshmërinë e SQL serverit? Wikipedia na sugjeron të ndërtojmë : ku në rastin e dështimit të ndonjë komponenti, ka një kopje rezervë.
Kjo kërkon një park të pajisjeve të shtrenjta: shumë kopje, fibra optike, depozita të përbashkëta, dhe madje edhe aktivizimi i rezervës funksionon në mënyrë të pasigurt: rreth 10% e aktivizimeve përfundojnë me dështimin e nodës rezervë duke e ndjekur nodën kryesore.
Por disavantazhi kryesor i një klasteri me disponueshmëri të lartë është se nuk ka disponueshmëri në rastin e dështimit të qendrës së të dhënave ku ndodhet. ‘Odnoklassniki’ ka katër qendra të të dhënave, dhe është e nevojshme të sigurojmë funksionimin në një dështim të plotë në një prej tyre.
Për këtë, mund të aplikojmë replikimin e integruar në SQL Server. Ky zgjidhje është shumë më e shtrenjtë për shkak të kostos së softuerit dhe vuan nga problemet e njohura të replikimit - vonesa të paparashikueshme të transaksioneve gjatë replikimit sinkron dhe vonesa në aplikimin e replikimeve (dhe, si rrjedhojë, modifikime të humbura) gjatë replikimit asinkron. Nënkuptimi i e bën këtë variant plotësisht të papranueshëm për ne.
Të gjitha këto probleme kërkonin një zgjidhje radikale dhe ne filluam analizën e tyre të detajuar. Këtu, duhet të njohim atë që kryesisht bën SQL Server - transaksionet.
Transaksioni i thjeshtë
Le të shqyrtojmë një transaksion të thjeshtë, në mënyrë të thjeshtë për programuesin SQL: shtimi i një fotografie në album. Albumet dhe fotografitë ruajten në tabela të ndryshme. Albumi ka një numërator për fotografitë publike. Atëherë ky transaksion ndahet në hapat e mëposhtëm:
- Bllokojmë albumin sipas çelësit.
- Krijojmë një rekord në tabelën e fotografive.
- Nëse fotografia ka status publik, rrisim numëratorin për fotografitë publike në album, përditësojmë regjistrin dhe konfirmojmë transaksionin.
Ose në formën e pseudokodit:
TX.start("Albums", id);
Album album = albums.lock(id);
Photo photo = photos.create(…);

if (photo.status == PUBLIC ) {
    album.incPublicPhotosCount();
}
album.update();

TX.commit();
Ne e çuditshme që skenari më i zakonshëm i transaksioneve të biznesit — të lexosh të dhënat nga DB në memorien e serverit të aplikatave, të bësh disa ndryshime dhe të ruash vlerat e reja përsëri në DB. Zakonisht, në një transaksion të tillë ne përditësojmë disa entitete, disa tabela.
Gjatë kryerjes së transaksionit mund të ndodhë modifikimi kompetitiv i të njëjtave të dhëna nga një sistem tjetër. Për shembull, Antispam mund të vendosë se përdoruesi është i dyshimtë dhe prandaj të gjitha fotografitë e përdoruesit nuk duhet të jenë më publike, ato duhet të dërgohen për moderim, që do të thotë se statusi i fotos duhet të ndryshohet në një vlerë tjetër dhe të kthjellohen numëruesit përkatës. Është e qartë se nëse kjo operacion ndodh pa garanci për atomizmin e aplikimit dhe izolimin e modifikimeve konkuruese, si në , atëherë rezultati do të jetë ai që nuk është i nevojshëm — ose numëruesi i fotove do të tregojë një vlerë të gabuar, ose jo të gjitha fotografitë do të dërgohen për moderim.
Një kod i tillë, që manipulat me entitete të ndryshme biznesi brenda një transaksioni, është shkruar shumë gjatë ekzistencës së Odnoklassnikov. Nga përvoja e migrimeve në NoSQL me ne e dimë se problemet më të mëdha (dhe kostot e kohës) shkaktohen nga nevoja për të zhvilluar kod që mban konsistencën e të dhënave. Prandaj, kërkesa kryesore për magazinën e re ishte të ofronte për logjikën aplikative transaksione të vërteta ACID.
Kërkesat e tjera, po aq të rëndësishme, ishin:
- Në rast të dështimit të qendrës së të dhënave, duhet të jenë të disponueshme si leximi ashtu edhe shkrimi në magazinën e re.
- Ruajtja e shpejtësisë aktuale të zhvillimit. Kjo do të thotë se punën me magazinën e re duhet të ketë një sasi të ngjashme kodi, nuk duhet të shfaqet nevoja për të shkruar diçka të re në magazinë, të zhvillosh algoritme për zgjidhjen e konflikteve, ruajtjen e indekseve sekondare, etj.
- Shpejtësia e funksionimit të magazinës së re duhet të jetë mjaft e lartë, si për leximin e të dhënave ashtu edhe për përpunimin e transaksioneve, çka do të thotë se zgjidhjet akademike të sakta, universale, por të ngadalshme, si për shembull, .
- Skalimi automatikisht në kohë reale.
- Përdorimi i serverëve të zakonshëm të lirë, pa pasur nevojë të blihen pajisje ekzotike.
- Mundësia për të zhvilluar ruajtjen nga zhvilluesit e kompanisë. Në fjalë të tjera, prioriteti i është dhënë zgjidhjeve të brendshme ose atyre me kod të hapur, preferohet në Java.
Zgjidhjet, zgjidhjet
Duke analizuar mundësitë e zgjidhjeve, ne arritëm në dy mundësi për arkitekturën:
E para — të marrim çdo server SQL dhe të realizojmë qëndrueshmërinë e nevojshme, mekanizmin e масштабированиë, klasterin e qëndrueshëm, zgjidhjen e konfliktëve dhe transaksionet ACID të shpërndara, të besueshme dhe të shpejta. Ne e vlerësuam këtë variant si mjaft të ndërlikuar dhe të punës intensive.
Varianti i dytë — të marrim një ruajtje NoSQL të gatshme me skalim të implementuar, një klaster të qëndrueshëm, zgjidhje konfliktesh dhe të realizojmë transaksionet dhe SQL vetë. Me sa duket, edhe detyra e implementimit të SQL, për të mos përmendur transaksionet ACID, duket si një sfidë për disa vite. Por më pas kuptuam se grupi i mundësive të SQL që ne përdorim në praktikë është shumë larg nga ANSI SQL ashtu si është e largët nga ANSI SQL. Duke e shqyrtuar më nga afër CQL, kuptuam se është mjaft i afërt me atë që na nevojitet.
Cassandra dhe CQL
Pra, çfarë e bën Cassandra interesante, cilat janë mundësitë e saj?
Së pari, këtu mund të krijoni tabela me mbështetje për lloje të ndryshme të të dhënave, mund të bëni SELECT ose UPDATE sipas çelësit primar.
CREATE TABLE photos (id bigint KEY, owner bigint,…);
SELECT * FROM photos WHERE id=?;
UPDATE photos SET … WHERE id=?;
Për të siguruar qëndrueshmërinë e të dhënave të replikave, Cassandra përdor Në rastin më të thjeshtë, kjo do të thotë se kur vendosim tre replika të të njëjtit rresht në nodet e ndryshme të klasterit, regjistrimi konsiderohet i suksesshëm nëse shumica e nodave (dmth dy nga tre) konfirmojnë suksesin e këtij operacioni të regjistrimit. Të dhënat e rreshtit konsiderohen të koordinuara nëse gjatë leximit shumica e nodave janë pyetur dhe kanë konfirmuar ato. Kështu, me tre replika, garanton një konsistencë të plotë dhe të menjëhershme të të dhënave në rast se një nod dështonte. Ky qasje na lejon të realizojmë një skemë edhe më të besueshme: gjithmonë dërgojmë kërkesa në të gjitha tre replikat, duke pritur përgjigjen nga dy më të shpejtat. Përgjigja e ngadaltë e tretë të replikes në këtë rast përjashtohet. Noda me përgjigjen e ngadaltë mund të ketë probleme serioze — ngadalësime, grumbullim mbetjeje në JVM, rikuperim të memories direkte në kernelin linux, dështim të harduerit, çëputje nga rrjeti. Megjithatë, kjo nuk ndikon aspak në operacionin e klientit dhe në të dhëna.
Qasja kur ne i drejtohemi tre nodave, dhe marrim përgjigje nga dy, quhet : kërkesa për replika të panevojshme dërgohet edhe para se të "shkëputet".
Një tjetër përparësi e Cassandra është Batchlog — mekanizmi që garanton ose aplikimin e plotë, ose mosaplikimin e plotë të paketës së ndryshimeve që ju bëni. Kjo na lejon të zgjidhim A në ACID — atomiku nga kutia.
Ajo që i ngjan transaksioneve në Cassandra është ajo që quhet "". Por ato janë shumë të largëta nga transaksionet "të vërteta" ACID: në të vërtetë, kjo është mundësia për të bërë në të dhënat e vetëm një regjistrimi, duke përdorur konsensusin nga protokolli i rëndë Paxos. Prandaj, shpejtësia e këtyre transaksioneve është e vogël.
Çfarë na mungoi në Cassandra
Pra, ne duhet të realizojmë në Cassandra transaksione të vërteta ACID. Me përdorim të cilave mund të realizonim lehtësisht dy mundësi të tjera të favorshme të DBMS klasik: indekse konsistente të shpejta, që do të na lejonin të bënim kërkesa të dhënash jo vetëm sipas çelësit primar dhe një gjenerator të zakonshëm të ID-ve monotone auto-increment.
C*One
Kështu lindi një DBMS e re C*One, e bërë nga tre lloje nodash serverësh:
- Marrësit — serverë (gati) standardë Cassandra, të cilët janë përgjegjës për ruajtjen e të dhënave në disqet lokale. Ndërsa rritet ngarkesa dhe sasia e të dhënave, numri i tyre mund të shkallëzohet lehtësisht në dhjetëra e qindra.
- Koordinatorët e transaksioneve - sigurojnë realizimin e transaksioneve.
- Klientët - serverët e aplikacioneve që realizojnë operacione biznesi dhe iniciatativat e transaksioneve. Mund të ketë mijëra klientë të tillë.
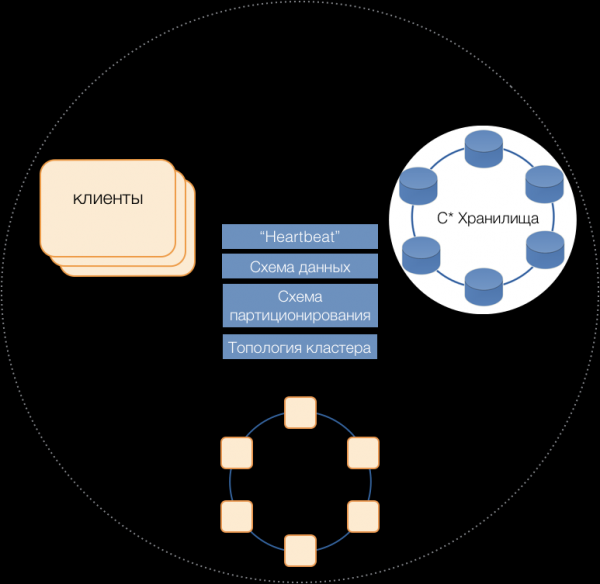
Serverët e të gjitha llojeve janë të lidhur në një klasër të përbashkët, përdorin protokollin e brendshëm të mesazheve Cassandra për komunikim mes tyre dhe për shkëmbimin e informacionit të klasit. Me ndihmën e Heartbeat, serverët mësojnë për dështimet e ndërsjella, mbajnë një skemë të përbashkët të të dhënave - tabelat, strukturën dhe replikimin e tyre; skemën e ndarje, topologjinë e klasit, etj.
Klientët
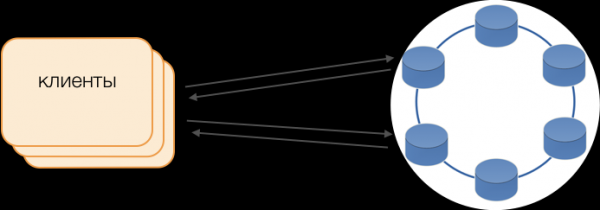
Në vend të drejtuesve standardë, përdoret modaliteti Fat Client. Ky nod nuk ruan të dhëna, por mund të funksionojë si koordinator i realizimit të kërkesave, pra Klienti vetë kryen funksionin e koordinatës së kërkesave të tij: shqyrton replikat e magazinës dhe zgjidh konfliktet. Ky modalitet jo vetëm që është më i besueshëm dhe më i shpejtë se drejtuesi standard, që kërkon komunikim me një koordinator të largët, por gjithashtu lejon menaxhimin e përcjelljes së kërkesave. Përveçse për transaksionin e hapur në klient, kërkesat drejtohen në magazina. Nëse klienti ka hapur një transaksion, të gjitha kërkesat brenda transaksionit drejtohen në koordinatorin e transaksioneve.
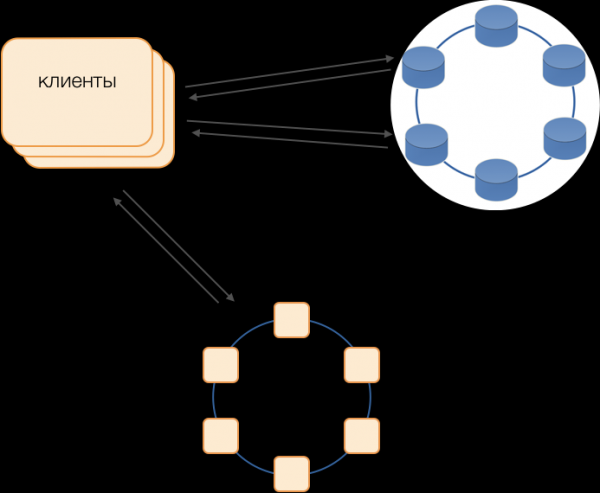
Koordinatori i transaksioneve C*One
Koordinator - kjo është ajo që e kemi realizuar për C*One nga zero. Ai është përgjegjës për menaxhimin e transaksioneve, bllokimeve dhe rendit të aplikimit të transaksioneve.
Për çdo transaksion që shërbehet, koordinator gjeneron një vulë të përkohshme: çdo e ardhshme është më e madhe se e mëparshmja. Duke qenë se në sistemin Cassandra, sistemi i zgjidhjes së konflikteve bazohen në vulat e kohës (nga dy regjistrime konfliktuale, e sakta konsiderohet ajo me vulë më të vonshme), konflikti gjithmonë do të zgjidhet në favor të transaksionit të ardhshëm. Kështu e realizuam – një mënyrë e lirë për zgjidhjen e konflikteve në një sistem të shpërndarë.
Bllokimet
Për të siguruar izolimin, ne vendosëm të përdorim mënyrën më të thjeshtë - bllokimet pesimiste sipas çelësit primar të regjistrimit. Në fjalë të tjera, brenda transaksionit, regjistrimi duhet fillimisht të bllokohet, pastaj të lexohet, modifikohet dhe të ruhet. Vetëm pas një komitimi të suksesshëm, regjistrimi mund të përshtatet, në mënyrë që transaksionet kompetuese të mund ta përdorin atë.
Zbatimi i një bllokimi të tillë është i thjeshtë në një ambient jo të shpërndarë. Në një sistem të shpërndarë ka dy rrugë kryesore: ose të realizohet një bllokim i shpërndarë në klaster, ose të shpërndahen transaksionet në mënyrë që transaksionet që përfshijnë një rekord të caktuar gjithmonë të shërbehen nga i njëjti koordinatori.
Pasi që në rastin tonë të dhënat janë tashmë të shpërndara në grupe lokalësh transaksionesh në SQL, u vendos që t'u caktohet koordinatorëve grupet e transaksioneve lokale: një koordinator kryen të gjitha transaksionet me numër token nga 0 në 9, tjetri nga 10 në 19, dhe kështu me radhë. Si rezultat, çdo njësi e koordinatorit bëhet master e grupit të transaksioneve.
Atëherë bllokimet mund të zbatohen si një HashMap e thjeshtë në memorie të koordinatorit.
Dështimet e koordinatorëve
Pasi që një koordinator shërben ekskluzivisht një grup transaksionesh, është shumë e rëndësishme të përcaktohet shpejt fakti i dështimit të tij, në mënyrë që përpjekja për të rinisur transaksionin të përfshihet në afatin e përcaktuar. Qëllimi është që kjo të jetë e shpejtë dhe e besueshme, prandaj ne përdorëm një protokoll qorrheti të lëvizshëm me kvorum:
Në çdo qendër të të dhënave vendosen të paktën dy nyje koordinatorësh. Periodikisht, çdo koordinator dërgon një mesazh heartbeat te koordinatorët e tjerë dhe i informon ata për funksionimin e tij, si dhe për cilat mesazhe heartbeat nga koordinatorët e tjerë në klaster ka marrë për herë të fundit.
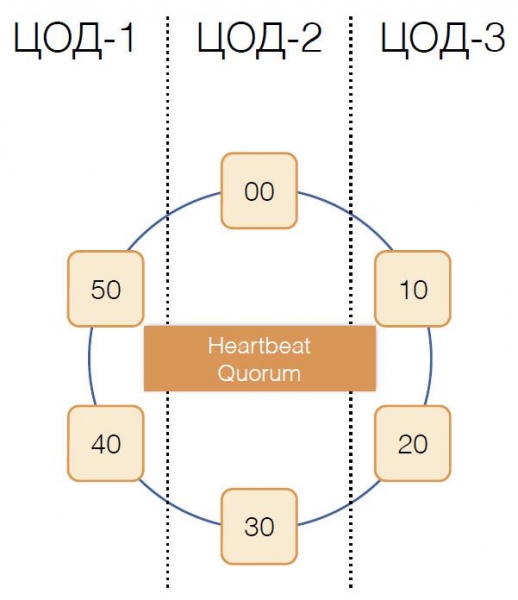
Duke marrë informacion të ngjashëm nga të tjerët në mesazhet e tyre heartbeat, çdo koordinator vendos vetë se cilat nyje të klasterit janë funksionale dhe cilat jo, duke u drejtuar nga parimi i kvorumit: nëse nyja X ka marrë nga shumica e nyjeve në klaster informacionin për marrjen normale të mesazheve nga nyja Y, atëherë Y është funksionale. Dhe anasjelltas, sapo shumica të njoftojë për humbjen e mesazheve nga nyja Y, atëherë Y ka dështuar. Është interesante se nëse kvorumi i thotë nyjës X se nuk po merr më mesazhe prej saj, atëherë vetë nyja X do ta konsiderojë veten si të dështuar.
Mesazhet e heartbeat dërgohet me një frekuencë të lartë, rreth 20 herë në sekondë, me një periudhë prej 50 ms. Në Java është e vështirë të garantosh reagimin e aplikacionit brenda 50 ms për shkak të gjatëzisë krahasuese të ndalimeve që shkaktohen nga mbledhësi i plehrave. Kemi arritur të kemi këtë kohë reagimi duke përdorur mbledhësin e plehrave G1, i cili lejon përcaktimin e një objekti për gjatësi ndalimi të GC. Megjithatë, ndonjëherë, mjaft rrallë, ndalimet e mbledhësit kalojnë 50 ms, gjë që mund të çojë në zbulim të rremë të dështimit. Për të shmangur këtë, koordinatori nuk njofton për dështimin e nodit të largët me humbjen e mesazhit të parë heartbeat prej tij, vetëm nëse humbasin disa radhazi. Kështu, kemi arritur të zbulojmë dështimin e nodit koordinues brenda 200 ms.
Por është e pamjaftueshme të kuptosh shpejt se cili nod ka pushuar së funksionuari. Duhet të bëjmë diçka për këtë.
Rezervimi
Skema klasike parashikon që në rast dështimi të masterit të fillohen zgjedhjet e reja me një nga Megjithatë, këtyre algoritmeve u njihen mirë problemet e konvergjencës në kohë dhe gjatësi të procesit të zgjedhjeve. Këto vonesa shtesë ia kemi arritur të shmangim duke përdorur një skemë zëvendësimi për koordinatoret në një rrjet të plotë:
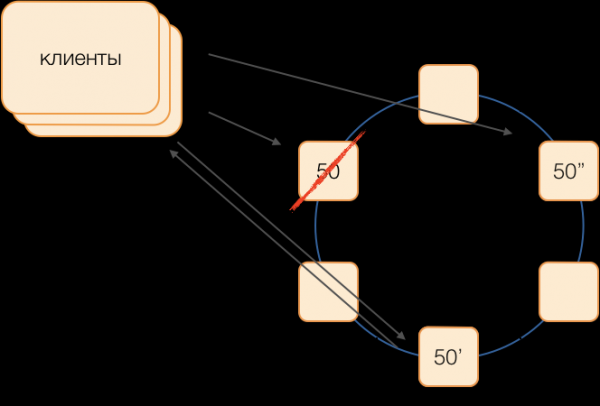
Le të supozojmë se duam të kryejmë një transaksion në grupin 50. Në mënyrë paraprake përcaktojmë skemën e zëvendësimit, duke përcaktuar se cilat nod do të kryejnë transaksionet e grupit 50 në rast dështimi të koordinatoret kryesor. Qëllimi ynë është të ruajmë funksionalitetin e sistemit në rastin e dështimit të datacenter-it. Le të përcaktojmë se rezevarti i parë do të jetë një nod nga një datacenter tjetër, dhe rezevarti i dytë do të jetë një nod nga një datacenter të tretë. Kjo skemë zgjidhet një herë dhe nuk ndryshon derisa të ndryshohet topologjia e klasterit, që do të thotë derisa të hyjnë nodet e reja (gjë që ndodh shumë rrallë). Rendi i zgjedhjes së një masteri aktiv të ri në rast dështimi të një të vjetri do të jetë gjithmonë ky: masteri aktiv do të bëhet rezevarti i parë dhe nëse ai ka pushuar gjithashtu së funksionuari - rezevarti i dytë.
Kjo skemë është më e besueshme se algoritmi universal, pasi për aktivizimin e një masteri të ri mjafton të përcaktohet fakti i dështimit të atij të vjetër.
Por si si e kuptojne klientet, cili nga mjeshtrit po punon tani? Në 50 ms është e pamundur të dërgosh informacion në mijëra klientë. Mund të ndodhi që një klient dërgon një kërkesë për hapjen e një transaksioni, pa e ditur ende se ky mjeshtër nuk po funksionon më, dhe kërkesa do të ngecë në një skadim kohor. Për të parandaluar këtë, klientët dërgojnë spekulativisht kërkesën për hapjen e transaksionit përkatës në grupin e mjeshtrit dhe në dy rezervat e tij, por do të përgjigjet vetëm ai që është mjeshtër aktiv në atë moment. Të gjithë komunikimet e mëtejshme brenda transaksionit do t'i kryejë klienti vetëm me mjeshtrin aktiv.
Mjeshtrit rezervë që marrin kërkesat për transaksione që nuk janë të tyre i vendosin ato në një radhë të transaksioneve të paralindura, ku ato ruhen për një kohë të caktuar. Nëse mjeshtri aktiv vdes, atëherë mjeshtri i ri merr kërkesat për hapjen e transaksioneve nga radhë e tij dhe i përgjigjet klientit. Nëse klienti tashmë ka hapur një transaksion me mjeshtrin e vjetër, atëherë përgjigja e dytë injorohet (dhe, natyrisht, një transaksion i tillë nuk do të përfundojë dhe do të përsëritet nga klienti).
Si funksionon transaksioni
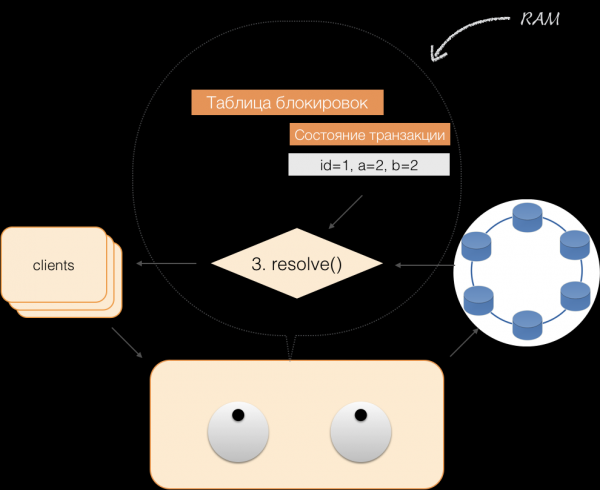
Supozoni se klienti i ka dërguar koordinatorit një kërkesë për hapjen e një transaksioni për një entitet të caktuar me një çelës primar të caktuar. Koordinatori e bllokon këtë entitet dhe e vendos në tabelën e bllokimeve në memorjen e tij. Nëse është e nevojshme, koordinatori e lexon këtë entitet nga depoja dhe ruan të dhënat e marra në gjendjen e transaksionit në memorjen e koordinatorit.
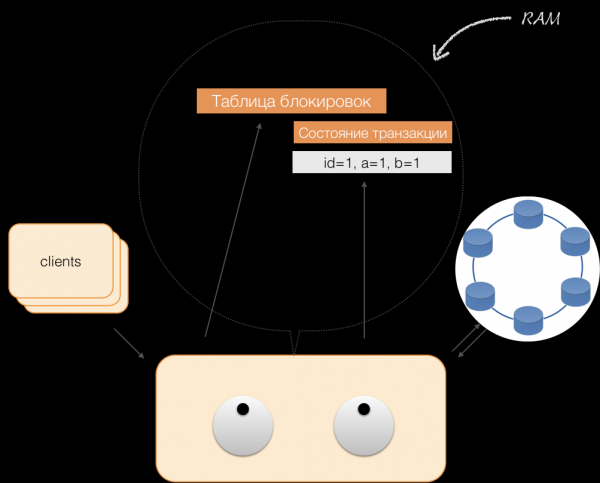
Kur klienti dëshiron të ndryshojë të dhënat brenda transaksionit, ai dërgon një kërkesë për modifikimin e entitetit te koordinatori, dhe ai vendos të dhënat e reja në tabelën e gjendjes së transaksioneve në memorje. Në këtë pikë, regjistrimi përfundon — regjistrimi në depo nuk bëhet.
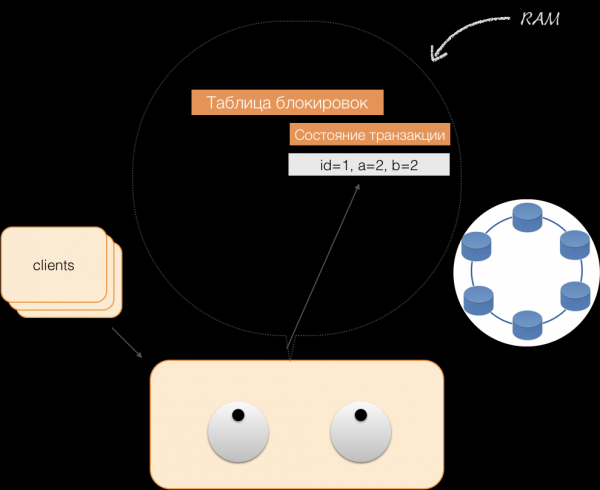
Kur klienti kërkon të dhënat e tij të modifikuara brenda një transaksioni aktiv, koordinatori vepron si më poshtë:
- nëse ID tashmë ekziston në transaksion, të dhënat merren nga memoria;
- nëse ID nuk është në memorie, të dhënat e mungojnë lexohen nga nodet e depozitave, bashkohen me ato që tashmë ekzistojnë në memorje, dhe rezultati i jepet klientit.
Kështu, klienti mund të lexojë ndryshimet e tij, ndërsa klientët e tjerë nuk i shohin këto ndryshime, sepse ato ruhen vetëm në memorjen e koordinatorit, në nodet e Cassandra ato ende nuk kanë mbërritur.
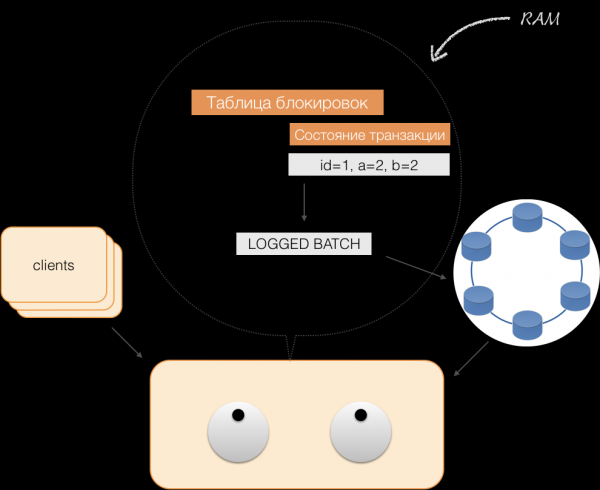
Kur klienti dërgon një commit, gjendja që kishte në kujtesë shërbimi, ruhet nga koordinatori në logged batch, dhe në formën e logged batch dërgohet në magazinat Cassandra. Magazinat bëjnë gjithçka të nevojshme që ky paketë të aplikohet në mënyrë atomike (plotsisht), dhe kthejnë një përgjigje koordinatori, i cili çliron bllokimet dhe konfirmon suksesin e transaksionit për klientin.
Dhe për të anuluar, koordinatori ka nevojë të çlirojë vetëm kujtesën e zënë nga gjendja e transaksionit.
Si rezultat i përmirësimeve të përmendura më lart, ne realizuam parimet ACID:
- Atomizmi. Kjo është një garanci që asnjë transaksion nuk do të regjistrohet pjesërisht në sistem, do të executohen të gjitha nën-operacionet e tij, ose nuk do të ekzekutohet asnjëra. Ky princip respektohet nga logged batch në Cassandra.
- Konsistenca. Çdo transaksion i suksesshëm për definicion regjistron vetëm rezultate të lejuara. Nëse pas hapjes së transaksionit dhe kryerjes së disa operacioneve, zbulohet se rezultati është i papranueshëm, kryhet një rikthim.
- Izolimi. Gjatë ekzekutimit të një transaksioni, transaksionet paralele nuk duhet të ndikojnë në rezultatin e tij. Transaksionet konkurruese janë të izoluara përmes bllokimeve pesimiste në koordinatore. Për leximet jashtë transaksionit respektohet parimi i izolimit në nivelin Read Committed.
- Qëndrueshmëria. Pavarësisht nga problemet në nivelet e poshtme — ndërprerja e energjisë, defekti në pajisje — ndryshimet e bëra nga një transaksion i përfunduar me sukses duhet të mbahen të ruajtura pas rimëkëmbjes së funksionimit.
Leximi përmes indekseve
Le të marrim një tabelë të thjeshtë:
CREATE TABLE photos (
id bigint primary key,
owner bigint,
modified timestamp,
…)
Ajo ka një ID (çelësi primar), pronari dhe data e ndryshimit. Duhet të bëjmë një kërkesë shumë të thjeshtë — të selektojmë të dhënat sipas pronarit me datën e ndryshimit "në 24 orët e fundit".
SELECT *
WHERE owner=?
AND modified>?
Për ta bërë një kërkesë të tillë të operojë shpejt, në një DBMS klasik SQL ne duhet të ndërtojmë një indeks mbi kolonat (owner, modified). Këtë do ta bëjmë mjaft lehtësisht, tani që kemi garantuar ACID!
Indekset në C*One
Ekziston tabela origjinale me fotografi, ku ID e regjistrimit është çelësi primar.
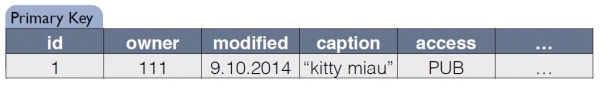
Për indeksin, C*One krijon një tabelë të re, e cila është një kopje e origjinales. Çelësi përputhet me shprehjen indeksuese, pasi përfshin gjithashtu çelësin primar të regjistrimit nga tabela origjinale:
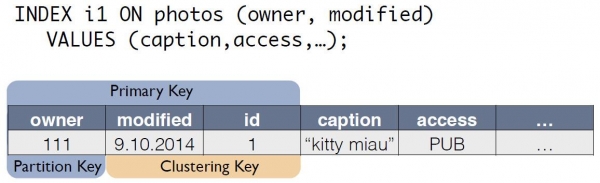
Tani tash në «pronarin e 24 orëve të fundit» mund të riktheni si një select nga një tabelë tjetër:
SELECT * FROM i1_test
WHERE owner=?
AND modified>?
Konsistenca e të dhënave të tabelës fillestare photos dhe indeksit i1 mbahet automatikisht nga koordinatori. Bazuar vetëm në skemën e të dhënave, kur merrni ndryshime, koordinatori gjeneron dhe ruan ndryshimin jo vetëm të tabelës kryesore, por edhe ndryshimet e kopjeve. Asnjë veprim shtesë me tabelën e indeksit nuk kryhet, logjet nuk lexohen, bllokimet nuk përdoren. Kjo do të thotë që shtimi i indekseve konsumon pothuajse asnjë burim dhe ka pak ndikim në shpejtësinë e aplikimit të modifikimeve.
Me ACID arritëm të implementojmë indekse «si në SQL». Ato kanë konsistencë, mund të shkallëzohen, punojnë shpejt, mund të jenë të përbëra dhe të integruara në gjuhën e pyetjeve CQL. Për mbështetje të indekseve nuk është e nevojshme të bëni ndryshime në kodin aplikativ. Gjithçka është e thjeshtë, si në SQL. Dhe, ajo që është më e rëndësishmja, indekset nuk ndikojnë në shpejtësinë e ekzekutimit të modifikimeve të tabelës fillestare të transaksioneve.
Çfarë rezultati kemi arritur
Ne zhvilluam C*One tre vjet më parë dhe e vendosëm në përdorim industrial.
Çfarë e kemi arritur në fund? Le të e vlerësojmë këtë përmes sistemit të përpunimit dhe ruajtjes së fotografive, një nga llojet më të rëndësishme të të dhënave në një rrjet social. Bëhet fjalë jo për trupat e fotografive, por për të gjitha metainformatat. Tani në «Odnoklassniki» ka rreth 20 miliardë të tilla regjistrimesh, sistemi përpunon 80,000 pyetje leximi në sekondë, deri në 8,000 ACID-transaksione në sekondë, të lidhura me modifikimin e të dhënave.
Kur përdorëm SQL me replication factor = 1 (por në RAID 10), metainformatat e fotografive ruheshin në një klaster me 32 makina me Microsoft SQL Server (plus 11 rezervë). Gjithashtu, ishin caktuar 10 servera për ruajtjen e backup-eve. Në total 50 makina të kushtueshme. Sidoqoftë, sistemi punonte me ngarkesë nominale, pa rezervë.
Pas migrimit në sistemin e ri, ne morëm replication factor = 3 — një kopje në çdo data-center. Sistemi përbëhet nga 63 nodet e ruajtjes Cassandra dhe 6 makina koordinatores, gjithsej 69 servera. Por këto makina janë ndjeshëm më të lira, shuma totale e kostos është rreth 30% e kostos së sistemit në SQL. Ndërkohë, ngarkesa qëndron në 30%.
Me implementimin e C*One, vonesat janë zvogëluar: operacioni i shkruajtes në SQL zë rreth 4.5 ms. Në C*One — rreth 1.6 ms. Koha mesatare e transaksionit është më pak se 40 ms, komiti ekzekutohet për 2 ms, koha e leximit dhe shkruajtes është mesatarisht 2 ms. Percentili i 99-të është vetëm 3-3.1 ms, numri i kohë-mandeve është zvogëluar 100 herë — falë përdorimit të gjerë të spekulimeve.
Derisa, tani, pjesa më e madhe e nyjeve të SQL Server është hequr nga përdorimi, produktet e reja zhvillohen vetëm me përdorimin e C*One. Ne e kemi adaptuar C*One për të punuar në cloud-in tonë. , e cila ka lejuar që të shpejtojë ndërtimin e klasterëve të rinj, të thjeshtësojë konfigurimin dhe të automatizojë operimin. Pa kodin burimor, kjo do të kishte qenë ndjeshëm më e ndërlikuar dhe më e çuditshme.
Tani jemi duke punuar për të transferuar magazinat e tjera në cloud — por kjo është një histori krejt ndryshe.
Burimi: habr.com
