

Ky është një artikull i përkthyer nga artikulli im në medium — , që rezultoi të ishte mjaft popullor, ndoshta për shkak të thjeshtësisë së tij. Prandaj, vendosa ta shkruaj në shqip dhe ta pasuroj pak, në mënyrë që një person i zakonshëm, i cili nuk është specialist në punën me të dhëna, të kuptojë se çfarë është një depo të dhënash (DW), çfarë është një liqen të dhënash (Data Lake), dhe si bashkëjetojnë ato së bashku.
Pse vendosa të shkruaj për liqenin e të dhënave? Kam punuar me të dhëna dhe analizë për më shumë se 10 vjet, dhe tani po punoj me të dhëna të mëdha në Amazon Alexa AI në Kembrixh, që ndodhet në Boston, ndonëse unë vetë jetoj në Viktori në ishullin Vancouver dhe shpesh vizitoj Bostonin, Siattlin dhe Vancouverin, dhe ndonjëherë madje edhe në Moskë për të folur në konferenca. Gjithashtu, nga koha në kohë shkruaj, por kryesisht në anglisht, dhe kam shkruar tashmë , gjithashtu kam një nevojë për të ndarë trendet e analizës nga Amerika e Veriut dhe ndonjëherë shkruaj në .
Kam punuar gjithmonë me depo të dhënash, dhe që nga viti 2015 kam filluar të punoj ngushtë me Amazon Web Services, madje kam kaluar në analizën cloud (AWS, Azure, GCP). Kam vëzhguar evolucioni i zgjidhjeve për analizë që nga viti 2007 dhe madje kam punuar te një ofrues depo të dhënash, Teradata, dhe e kam implementuar atë në Sberbank, kur atëherë nisi era e Big Data me Hadoop. Të gjithë filluan të thonë se era e depozita përfundoi dhe tani gjithçka është në Hadoop, dhe më vonë filluan të flisnin për Data Lake, sërish duke thënë se tani me siguri i ka ardhur fundi depozitës së të dhënave. Por për fat të mirë (ndoshta për disa fatkeqësi, ata që fitonin shumë para nga konfigurimi i Hadoop), depozitë e të dhënave nuk iku.
Në këtë artikel do të shqyrtojmë se çfarë është një liqen të dhënash. Artikulli është i destinuar për njerëzit, të cilët kanë pak përvojë me depo të dhënash ose nuk kanë fare.
Në imazh është liqeni Bled, një nga liqenet e mia të preferuara, ndonëse kam qenë aty vetëm njëherë, por e mbajta mend gjatë gjithë jetës. Por ne do të flasim për një tip tjetër liqeni — liqeni i të dhënave. Ndoshta shumë prej jush kanë dëgjuar tashmë këtë term, por një përcaktim tjetër nuk do të dëmtonte askënd.
Para së gjithash, ja përcaktimet më të njohura të Liqenit të Të Dhënave:
«depo e skedarëve të të gjitha llojeve të të dhënave të papërpunuara, që janë të arritshme për analizë nga kushdo në organizatë» — Martin Fowler.
«Nëse mendoni se një liqen të dhënash është si një shishe uji — të pastruar, të paketuar dhe të ndarë për përdorim të përshtatshëm, atëherë liqeni i të dhënave është një rezervuar i madh me ujë në formën e tij natyrore. Përdoruesit mund të marrin ujë për veten, të zhytin thellë, të eksplorojnë» — James Dickson.
Tani ne e dimë saktësisht se liqeni i të dhënave është për analizën, ai na lejon të ruajmë sasi të mëdha të dhënash në formën e tyre origjinale dhe kemi akses të nevojshëm dhe të përshtatshëm në të dhënat.
Unë shpesh e dua ta thjeshtoj gjërat, nëse mund të përshkruaj një term të ndërlikuar me fjalë të thjeshta, do të thotë se e kam kuptuar si funksionon dhe për çfarë është e nevojshme. Njëherë, duke përshkruar në iPhone në galerinë e fotografive, më erdhi ndriçimi, kështu që është një liqen të dhënash i vërtetë, madje bëra një slajd për konferenca:
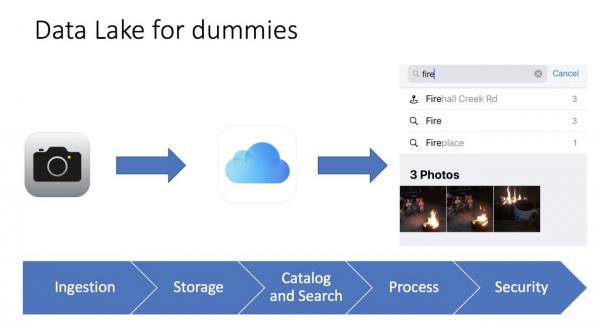
E gjithçka është shumë e thjeshtë. Ne bëjmë një fotografi me telefon, fotografia ruhet në telefon dhe mund të ruhet në iCloud (ruajtja e skedarëve në re). Gjithashtu, telefoni grumbullon metadata të fotografisë: çfarë është e paraqitur, gjeoetiketa, koha. Si rezultat, ne mund të përdorim ndërfaqen e përshtatshme të iPhone për të gjetur fotografinë tonë dhe madje shohim treguesit, për shembull, kur kërkoj fotografitë me fjalën zjarr (fire), unë gjej 3 fotografi me imazhin e zjarrit. Për mua, është thjesht si një mjet Business Intelligence që funksionon shumë shpejt dhe saktë.
Dhe sigurisht, nuk duhet të harrojmë për sigurinë (autorizimin dhe autentikimin), përndryshe të dhënat tona mund të përfundojnë lehtësisht në akses të hapur. Ka shumë lajme për korporata të mëdha dhe startup-e, të cilat të dhënat e tyre përfunduan në akses të hapur për shkak të neglizhencës së zhvilluesve dhe mosrespektimit të rregullave të thjeshta.
Madje një imazh kaq i thjeshtë na ndihmon të kuptojmë se çfarë është një liqen të dhënash, dallimet e tij nga magazina tradicionale e të dhënave dhe elementet e tij kryesore:
- Ngarkimi i të dhënave (Ingestion) — komponenti kyç i liqenit të të dhënave. Të dhënat mund të futen në magazinën e të dhënave në dy mënyra — batch (ngarkesë me intervale) dhe streaming (rrjedhë të dhënash).
- Ruajtja e skedarëve (Storage) — komponenti kryesor i Liqenit të Të Dhënave. Na nevojitet që magazina të jetë e lehtë për t'u zgjeruar, jashtëzakonisht e besueshme dhe me kosto të ulët. Për shembull, në AWS kjo është S3.
- Katalogu dhe Kërkimi (Katalogu dhe Kërkimi) — për të shmangur Bolotën e Të Dhënave (kur ne grumbullojmë të gjitha të dhënat në një vend dhe pastaj është e pamundur të punojmë me to), ne duhet të krijojmë një shtresë të metadatat për klasifikimin e të dhënave, në mënyrë që përdoruesit të mund ta gjejnë lehtësisht informacionin e nevojshëm për analizë. Së additional, mund të përdorim zgjidhje të tjera kërkimi, si ElasticSearch. Kërkimi ndihmon përdoruesin të kërkojë të dhënat e nevojshme përmes një ndërfaqeje të përshtatshme.
- Përgjigje (Procesi) — ky hap është përgjegjës për përpunimin dhe transformimin e të dhënave. Ne mund të transformojmë të dhënat, të ndryshojmë strukturat e tyre, t'i pastrojmë dhe shumë më tepër.
- Siguria (Siguria) — është e rëndësishme të shpenzohet kohë për dizajnimin e sigurisë së zgjidhjes. Për shembull, kriptimi i të dhënave gjatë magazinimit, përpunimit dhe ngarkimit. Është e rëndësishme të përdoren metoda të autentifikimit dhe autorizimit. Në përfundim, nevojitet një mjet auditimi.
Nga një pikëpamje praktike, ne mund ta karakterizojmë liqenin e të dhënave me tre atribute:
- Mblidhni dhe ruani gjithçka — liqeni i të dhënave përmban të gjitha të dhënat, si të dhëna të papërpunuara për çdo periudhë kohe, ashtu edhe të dhëna të përpunuara/të pastruara.
- Analiza e thellë — liqeni i të dhënave u lejon përdoruesve të eksploros dhe të analizojnë të dhënat.
- Qasje fleksibile — liqeni i të dhënave ofron qasje fleksibile për të dhëna të ndryshme dhe për skenarë të ndryshëm.
Tani mund të flasim për ndryshimin mes magazinës së të dhënave dhe liqenit të të dhënave. Zakonisht, njerëzit pyesin:
- Po përsa i përket magazinës së të dhënave?
- A e zëvendësojmë magazinën e të dhënave me liqenin e të dhënave apo e zgjerojmë atë?
- A mund të shkojmë pa liqenin e të dhënave?
Nëse do të flasim shkurt, nuk ka një përgjigje të qartë. Çdo gjë varet nga situata specifike, aftësitë në ekip dhe buxheti. Për shembull, migrohet magazina e të dhënave në Oracle në AWS dhe krijimi i liqenit të të dhënave nga një kompani nënshkruese e Amazon — Woot — .
Nga ana tjetër, ofruesi Snowflake deklaron se nuk ka nevojë të mendoni më për liqenin e të dhënave, pasi platforma e tij të dhënash (deri në 2020 ishte magazina e të dhënave) ju lejon të kombinoni si liqenin e të dhënave ashtu edhe magazinën e të dhënave. Kam punuar pak me Snowflake, dhe është vërtet një produkt unik që mund ta bëjë këtë. Çmimi është një çështje tjetër.
Në përfundim, mendimi im personal është se na nevojitet akoma një depo e dhënash si burim kryesor të dhënash për raportimin tonë, dhe gjithçka që nuk përfshihet, e ruajmë në liqenin e të dhënave. Roli i analitikës është të ofrojë qasje të lehtë për biznesin për marrjen e vendimeve. Siç do të donim, përdoruesit e biznesit punojnë më efikasht me depo të dhënash sesa me liqenin e të dhënave, për shembull në Amazon — kemi Redshift (depo analitike e të dhënave) dhe Redshift Spectrum/Athena (interfaci SQL për liqenin e të dhënave në S3 mbi bazën e Hive/Presto). E njëjta gjë i referohet depozita moderne të të dhënave analitike.
Le të shqyrtojmë arkitekturën tipike të depozitës së të dhënave:
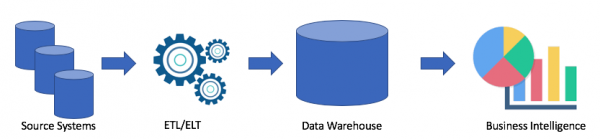
Kjo është një zgjidhje klasike. Ne kemi sistemet burimore, me ndihmën e ETL/ELT ne kopjojmë të dhënat në depo të dhënash analitike dhe i lidhim me zgjidhjen e Business Intelligence (preferenca ime është Tableau, e juaja?).
Kjo zgjidhje ka këto disavantazhe:
- Operacionet ETL/ELT kërkojnë kohë dhe burime.
- Si rregull, kuadri për ruajtjen e të dhënave në depo të dhënash analitike nuk është i lirë (për shembull Redshift, BigQuery, Teradata), pasi ne duhet të blejmë një klaster të tërë.
- Përdoruesit e biznesit kanë qasje në të dhënat e pastruara dhe shpesh të agreguara dhe nuk kanë mundësi të marrin të dhëna të papërpunuara.
Sigurisht, gjithçka varet nga rasti juaj. Nëse nuk keni probleme me depozitat tuaja të dhënash, atëherë nuk keni nevojë për një liqen të dhënash. Por kur paraqiten problemet me mungesën e hapësirës, fuqisë ose kostoja ka një rol kyç, atëherë mund të shqyrtoni mundësinë e një liqeni të dhënash. Kjo është arsyeja pse, liqeni i të dhënave është shumë popullor. Ja një shembull i arkitekturës së liqenit të të dhënave:
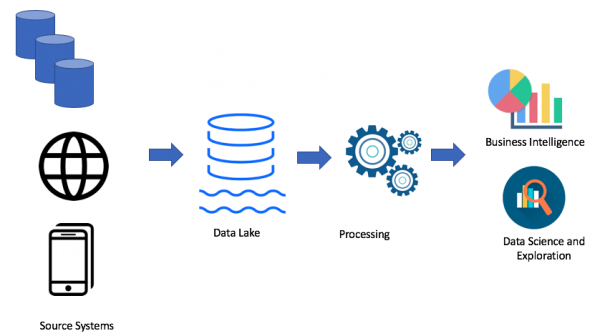
Duke përdorur qasjen e liqenit të të dhënave, ne ngarkojmë të dhënat e papërpunuara në liqenin tonë të të dhënave (batch ose streaming), dhe më pas procesojmë të dhënat sipas nevojës. Liqeni i të dhënave lejon që përdoruesit e biznesit të krijojnë transformimet e tyre të dhënave (ETL/ELT) ose të analizojnë të dhënat në zgjidhjet e Business Intelligence (nëse ka drejtuesin e nevojshëm).
Qëllimi i çdo zgjidhjeje analitike është të shërbejë për përdoruesit e biznesit. Prandaj ne gjithmonë duhet të punojmë nga kërkesat e biznesit. (Në Amazon, ky është një nga parimet — punimi mbrapsht).
Duke punuar dhe me depozitën e dhënave dhe me liqenin e të dhënave, ne mund të krahasojmë të dyja zgjidhjet:
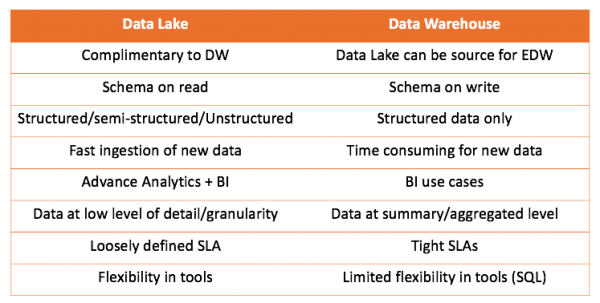
Konkluzioni kryesor që mund të bëhet është se depoja e të dhënave nuk konkuron me liqenin e të dhënave, përkundrazi, e plotëson atë. Por kjo është në dorën tuaj se çfarë i përshtatet rastit tuaj. Gjithmonë është interesante ta provosh vetë dhe të bësh përfundime të sakta.
Dua gjithashtu të flas për një nga rastet kur fillova të përdor qasjen e liqenit të të dhënave. E gjithë kjo është mjaft banale, përpiqesha të përdorja një mjet ELT (ne kishim Matillion ETL) dhe Amazon Redshift, zgjidhja ime funksionoi, por nuk përmbushte kërkesat.
Më nevojitej të merrja log-et e uebit, t'i transformoja dhe t'i agregoja, për të ofruar të dhëna për dy raste:
- Ekipa e marketingut donte të analizonin aktivitetin e botëve për SEO
- IT-i donte të shikonte metrikat e funksionimit të faqeve të internetit
Log-e shumë të thjeshta, mjaft të thjeshta. Ja një shembull:
https 2018-07-02T22:23:00.186641Z app/my-loadbalancer/50dc6c495c0c9188
192.168.131.39:2817 10.0.0.1:80 0.086 0.048 0.037 200 200 0 57
"GET https://www.example.com:443/ HTTP/1.1" "curl/7.46.0" ECDHE-RSA-AES128-GCM-SHA256 TLSv1.2
arn:aws:elasticloadbalancing:us-east-2:123456789012:targetgroup/my-targets/73e2d6bc24d8a067
"Root=1-58337281-1d84f3d73c47ec4e58577259" "www.example.com" "arn:aws:acm:us-east-2:123456789012:certificate/12345678-1234-1234-1234-123456789012"
1 2018-07-02T22:22:48.364000Z "authenticate,forward" "-" "-"
Një skedar peshoi 1-4 megabajt.
Por kishte një vështirësi. Ne kishim 7 domain në mbarë botën, dhe në një ditë krijoheshin 7000 skedarë. Kjo nuk ishte një volum shumë i madh, gjithçka 50 gigabajt. Por madhësia e klasterit tonë Redshift ishte gjithashtu e vogël (4 nod). Ngarkimi në mënyrë tradicionale i një skedari merrte rreth një minutë. Pra, në mënyrë të drejtpërdrejtë, problemi nuk zgjidhej. Dhe kjo ishte ajo herë që vendosa të përdor qasjen e liqenit të të dhënave. Zgjidhja dukej përafërsisht kështu:
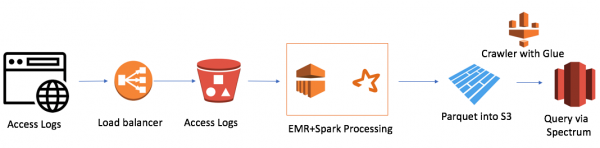
Ishte mjaft e thjeshtë (dua të theksoj se përparësia e punës në re është thjeshtësia). Unë përdora:
- AWS Elastic Map Reduce (Hadoop) si kapacitet llogaritës
- AWS S3 si depo e skedave me mundësi për kriptimin e të dhënave dhe ndarjen e aksesit
- Spark si kapacitet llogaritës InMemory dhe PySpark për logjikën dhe transformimin e të dhënave
- Parquet si rezultat i punës së Spark
- AWS Glue Crawler si mbledhës i metadatumit për të dhëna të reja dhe partitë
- Redshift Spectrum si ndërfaqe SQL për liqenin e të dhënave për përdoruesit ekzistues të Redshift
Klasteri më i vogël EMR+Spark përpunoi të gjithë grupin e skedarëve për 30 minuta. Ka dhe raste të tjera për AWS, sidomos shumë të lidhura me Alexa, ku ka shumë të dhëna.
Kohë më parë mësova një nga disavantazhet e liqenit të të dhënave – është GDPR. Problemi është se kur klienti kërkon ta fshijë, ndërsa të dhënat gjenden në një nga skedarët, nuk mund të përdorim Data Manipulation Language dhe operacionin DELETE si në një bazë të dhënash.
Shpresoj se artikulli sqaroi ndryshimin midis depozitës së të dhënave dhe liqenit të të dhënave. Nëse ishte interesante, mund të përkthej edhe artikujt e mi ose artikujt e profesionistëve që lexoj. Po ashtu mund të flas për zgjidhjet me të cilat punoj dhe arkitekturën e tyre.
Burimi: habr.com
