

Duke hyrë në një produkt që ka evoluar për më shumë se një dekadë, nuk është çudi që të takoni teknologji të vjetra. Por çfarë ndodh nëse pas gjashtë muajve duhet të përballoni një ngarkesë që është 10 herë më e lartë, ndërsa kostoja e rënieve rritet qindra herë? Në këtë rast, ju nevojitet një inxhinier i shkëlqyer të ngarkesave të mëdha. Por për shkak të mungesës së një të tilli, problemi më është besuar mua. Në pjesën e parë të artikullit do të tregoj se si kaluam nga Redis në Redis-cluster, ndërsa në pjesën e dytë do të jap këshilla se si të filloni të përdorni klasterin dhe çfarë të keni parasysh gjatë përdorimit.
Zgjedhja e teknologjisë
A është kaq e keqe Redis i veçantë (redis i veçantë) në konfigurimin 1 master dhe N skllevër? Pse e quaj atë një teknologji të vjetëruar?
Jo, Redis nuk është kaq i keq... Megjithatë, ka disa të meta që nuk mund të injorohen.
Së pari, Redis nuk mbështet mekanizmat e rikuperimit të fatkeqësive pas rënies së masterit. Për të zgjidhur këtë problem, ne përdorëm një konfigurim me kalimin automatik të VIP-ve në një master të ri, ndryshimin e rolit të njërit prej skllevërve dhe kalimin e të tjerëve. Ky mekanizëm funksionoi, por nuk mund të quhej një zgjidhje e besueshme. Së pari, ndodhnin alarmime të false dhe, së dyti, ishte një herësh, dhe pas alarmimit kërkoheshin veprime manuale për të ngjitur mekanizmin.
Së dyti, prania e vetëm një masteri sillte problem për ndarjen e ngarkesës. Duhet të krijonim disa klasterë të pavarur "1 master dhe N skllevër", pastaj të shpërndanim manualisht bazat mbi këto makina dhe të shpresonim që nesër ndonjëra prej bazave nuk do të përshkonte aq shumë sa do të duhej ta transferonim në një instancë të veçantë.
Cilat janë opsionet?
- Zgjidhja më e shtrenjtë dhe e pasur është Redis-Enterprise. Ky është një zgjidhje e kutisë me mbështetje të plotë teknike. Megjithatë, edhe pse duket e përsosur nga pikëpamja teknike, nuk na përputhej për arsye ideologjike.
- Redis-cluster. Nga kutia ka mbështetje për kalimin e fatkeqësive të masterit dhe ndarjen e ngarkesës. Ndërfaqja është pothuajse e njëjtë me versionin e zakonshëm. Duket premtuese, për pengesat do të flasim më vonë.
- Tarantool, Memcache, Aerospike dhe të tjerë. Të gjitha këto mjete bëjnë përafërsisht të njëjtën gjë. Por secili ka dobësitë e veta. Ne vendosëm të mos i vendosim të gjitha vezët në një basket. Memcache dhe Tarantool i përdorim për detyra të tjera dhe, duke kaluar përpara, do të them se në praktikën tonë kemi pasur më shumë probleme me to.
Specifikimi i përdorimit
Le të shikojmë se cilat detyra kemi zgjidhur historikisht me Redis dhe cila funksionalitet kemi përdorur:
- Cache para kërkesave ndaj shërbimeve të largëta si 2GIS | Golang
GET SET MGET MSET "SELECT DB"
- Cache para MYSQL | PHP
GET SET MGET MSET SCAN "KEY BY PATTERN" "SELECT DB"
- Kryesori për shërbimin e punës me sesionet dhe koordinatat e shoferëve | Golang
GET SET MGET MSET "SELECT DB" "ADD GEO KEY" "GET GEO KEY" SCAN
Siç e shihni, nuk ka matematikë të avancuar. Çfarë ka atëherë vështirësinë? Le të analizojmë në veçanti secilën metodë.
Sanitizer.replaceElementWithChildren()
Përshkrimi
Karakteristikat e Redis-cluster
Zgjidhja
GET SET
Shkruaj/lexo çelësin
MGET MSET
Shkruaj/lexo disa çelësa
Çelësat do të jenë në node të ndryshme. Bibliotekat e gatshme dinë të bëjnë Multi-operacione vetëm brenda një node.
Zëvendëso MGET me një pipeline të N GET operacioneve
SELECT DB
Zgjidhni bazën me të cilën do të punojmë
Nuk mbështet disa baza të dhënash
Të gjitha në një bazë. Shtoni prefikse në çelësa
SCAN
Kaloni përmes të gjithëve çelësave në bazë
Pavarësisht se kemi një bazë, kalimi përmes të gjithëve çelësave në kluster është shumë i kushtueshëm.
Mbani invariat brenda një çelësi dhe bëni HSCAN për këtë çelës. Ose hiqni dorë krejtësisht.
GEO
Operacione me gjeokelësin
Gjeokelësi nuk shardohet
KEY BY PATTERN
Kërkoni çelësin sipas modelit
Pavarësisht se kemi një bazë, do të kërkojmë përmes të gjithë çelësave në kluster. Shumë i kushtueshëm.
Hiqni dorë ose mbani invariat, ashtu si në rastin e SCAN.
Redis vs Redis-cluster
Çfarë humbasim dhe çfarë fitojmë kur kalojmë në kluster?
- Disavantazhet: humbasim funksionalitetin e disa bazave.
- Nëse duam të ruajmë të dhëna që nuk lidhen logjikisht në një kluster, do të duhet të bëjmë ndihma përmes prefikseve.
- Humbasim të gjitha operacionet "për bazën", si SCAN, DBSIZE, CLEAR DB etj.
- Multi-operacionet janë bërë ndjeshëm më të komplikuara për t'u realizuar, sepse mund të nevojitet ndihma nga disa node.
- Avantazhet:
- Qëndrueshmëri në formën e kalimit të emergjencës për masterin.
- Shardimi në anën e Redis.
- Transferimi i të dhënave midis node-ve në mënyrë atomike dhe pa ndalese.
- Shtimi dhe shpërndarja e kapaciteteve dhe ngarkesave pa ndërprerje.
Do të arrija në përfundimin se nëse nuk keni nevojë të siguroheni për një nivel të lartë qëndrueshmërie, atëherë kalimi në një klaster nuk ia vlen, pasi mund të jetë një detyrë jo triviale. Por nëse fillimisht zgjidhni midis një versioni të veçantë dhe një klasteri, atëherë duhet të zgjidhni klasterin, pasi ai nuk është në asnjë rast më i keq dhe për më tepër do t'ju heqë një pjesë të dhimbjeve të kokës.
Përgatitja për kalim
Të fillojmë me kërkesat për kalimin:
- Ai duhet të jetë pa shqetësim. Një ndalim i plotë i shërbimit për 5 minuta nuk na ndihmon.
- Ai duhet të jetë maksimalisht i sigurt dhe i gradual. Duam të kemi një lloj kontrolli mbi situatën. Nuk duam të hedhim gjithçka menjëherë dhe të lutemi për butonin e rikthimit.
- Humbej të minimalizuara të të dhënave gjatë kalimit. E kuptojmë që të kalosh në mënyrë atomike do të jetë shumë e komplikuar, prandaj lejojmë një shkëputje të caktuar midis të dhënave në Redisin e zakonshëm dhe atë klaster.
Mirëmbajtja e klasterit
Para kalimit vlen të mendoni nëse mundemi të mbajmë klasterin:
- Grafikët. Ne përdorim Prometheus dhe Grafana për grafikët e ngarkesës së procesorëve, kujtesës së zënë, numrit të klientëve, numrit të operacioneve GET, SET, AUTH, etj.
- Ekspertiza. Imagjinoni se nesër nën përgjegjësinë tuaj do të jetë një klaster i madh. Nëse ai dështoi, askush përveç jush nuk do ta riparojë atë. Nëse fillon të ngadalësohet — të gjithë do vrapojnë tek ju. Nëse duhet të shtoni burime ose të shpërndani ngarkesën — sërish tek ju. Që të mos bëheni gri në 25, është e mençur të parashikoni këto raste dhe të kontrolloni paraprakisht se si do të sillen teknologjitë nën veprime të caktuara. Do flasim për këtë më në detaje në seksionin 'Ekspertiza'.
- Monitorimet dhe njoftimet. Kur klasteri dështoi, dëshirojmë të dimë të parët. Këtu ne e kufizuam njoftimin për faktin se të gjitha nodeve iu kthehen të njëjtat informata mbi gjendjen e klasterit (po, ndodhin edhe ndryshe). Problemet e tjera janë më të shpejta për t'u vënë re nëpërmjet njoftimeve të shërbimeve-klientëve të Redis.
Kënaqësi
Si do të kalojmë:
- Së pari, nevojitet të përgatisim bibliotekën për punën me klasterin. Si bazë për versionin në Gо, morëm go-redis dhe bëmë disa ndryshime për ne. Realizuam metodat Multi përmes pipeline-ve, si dhe ndryshuam disi rregullat për përsëritjen e kërkesave. Me versionin për PHP, kishim më shumë probleme, por në fund vendosëm për php-redis. Së fundmi, ata implementuan mbështetje për klasterin, dhe sipas mendimit tonë, ai duket mirë.
- Më pas, duhet të vendosim vetë klasterin. Kjo bëhet praktikisht me dy komanda mbi bazën e skedarit të konfigurimit. Më shumë rreth konfigurimit do të diskutojmë më poshtë.
- Për një migrim të ngadaltë, ne përdorim dry-mode. Meqenëse kemi dy versione të bibliotekës me një ndërfaqe identike (një për versionin normal, tjetër për klasterin), nuk është e vështirë të krijojmë një mbështjellës që do të punojë me versionin e veçantë dhe njëkohësisht të dublonte të gjitha kërkesat në klaster, të krahasojë përgjigjet dhe të shkruajë shkaqet e mospërputhjeve në log (në rastin tonë në NewRelic). Kështu, madje edhe nëse gjatë aktivizimit versioni klaster dështon, prodhimi ynë nuk do të preket.
- Pasi aktivizuam klasterin në dry-mode, mund të shohim qetësisht grafikë të mospërputhjeve të përgjigjeve. Nëse përqindja e gabimeve po lëviz ngadalë, por me siguri drejt një konstante të vogël, atëherë gjithçka është në rregull. Pse ka ende mospërputhje? Sepse shkrimi në versionin e veçantë ndodh pak më herët se në klaster, dhe për shkak të mikrologëve, të dhënat mund të jenë të ndryshme. Duhet vetëm të shohim logët e mospërputhjeve dhe nëse të gjitha ato janë të shpjegueshme nga mosaplikimi i shkrimit, atëherë mund të ecim përpara.
- Tani mund të kthejmë dry-mode në anën e kundërt. Do të shkruajmë dhe lexojmë nga klasteri, ndërsa do të dublonim në versionin e veçantë. Pse? Gjatë javës tjetër dëshirojmë të vëzhgojmë punën e klasterit. Nëse ndonjëherë zbulojmë se në kulmin e ngarkesës ka probleme, ose kemi harruar ndonjë aspekt, gjithmonë kemi një rikthim emergjent në kodin e vjetër dhe të dhëna aktuale falë dry-mode.
- Tani na mbetet të çaktivizojmë dry-mode dhe të çmontojmë versionin e veçantë.
Ekspertiza
Së pari, një përmbledhje e strukturës së klasterit.
Së pari, Redis është një magazinë key-value. Si çelës përdoren vargje të caktuara. Si vlera mund të përdoren numra, vargje dhe struktura të plota. Këto të fundit janë shumë të shumta, por për të kuptuar strukturën e përgjithshme, kjo nuk është e rëndësishme.
Niveli i ardhshëm pas çelësave janë slots (SLOTS). Çdo çelës i përket një prej 16,383 slots. Brenda çdo slot-i mund të ketë sa të doni çelësa. Pra, të gjithë çelësat ndahen në 16,383 grupe të pa përplase.
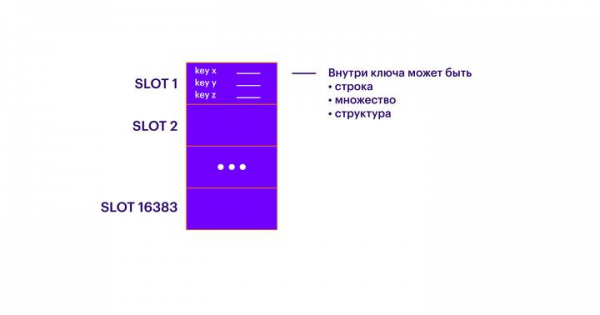
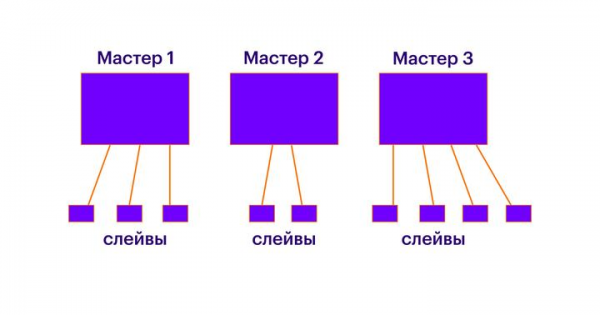
Në cluster duhet të ketë N master-nodes. Çdo node mund të paraqitet si një instancë e veçantë Redis, e cila di gjithçka për nodet e tjera brenda cluster-it. Çdo master-node përmban një numër slots. Çdo slot i përket vetëm një master-node. Të gjitha slots duhet të shpërndahen midis nodave. Nëse disa slots nuk janë shpërndarë, atëherë çelësat që ruhen në to do të jenë të paarritshëm. Është e arsyeshme të bëni çdo master-node të funksionojë në një makinë logjike ose fizike të veçantë. Gjithashtu, duhet të mbani në mend se çdo node funksionon vetëm në një bërthamë, dhe nëse dëshironi të ekzekutoni disa instanca Redis në një makinë logjike, sigurohuni që ato të funksionojnë në bërthema të ndryshme (ne nuk e kemi provuar këtë, por teorikisht gjithçka duhet të funksionojë). Në thelb, master-nodet sigurojnë shardim të zakonshëm, dhe më shumë master-nodes lejojnë të shkallëzoni kërkesat për shkrim dhe lexim.
Pasi që të gjithë çelësat janë shpërndarë në slots dhe slots janë shpërndarë në master-nodes, mund të shtoni një numër të pakufizuar slayv-nodet në çdo master-node. Brenda çdo lidhjeje të tillë "master-slave" do të funksionojë replikimi i zakonshëm. Slayvët janë të nevojshëm për të shkallëzuar kërkesat për lexim dhe për kalimin në rast dështimi të masterit.
Tani le të flasim për operacione që do të ishte mirë të dimë të bëjmë.
Ne do të drejtohemi në sistem përmes Redis-CLI. Meqenëse Redis nuk ka një pikë hyrëse të vetme, operacionet e mëposhtme mund të kryhen në çdo nga nodat. Në çdo pikë do të theksoj mundësinë e kryerjes së operacionit nën ngarkesë.
- E para dhe më e rëndësishmja që na nevojitet: operacioni cluster nodes. Ai kthen gjendjen e cluster-it, tregon listën e nodave, rolet e tyre, shpërndarjen e slots etj. Informacione shtesë mund të merren duke përdorur cluster info dhe cluster slots.
- Do të ishte mirë të ishim në gjendje të shtonim dhe hiqnim nodet. Për këtë qëllim, ekzistojnë operacionet cluster meet dhe cluster forget. Kini parasysh se cluster forget duhet të aplikohet për ÇDO nod, si për masterat ashtu edhe për replikat. Ndërsa për cluster meet është e mjaftueshme të thirret vetëm në një nod. Kjo ndryshim mund të jetë dekurajues, prandaj është më mirë të informoheni për të para se të filloni përdorimin e klasterit. Shtimi i një node bëhet në siguri gjatë operimit dhe nuk ndikon në funksionimin e klasterit (çka ka kuptim). Nëse planifikoni të hiqni një nod nga klasteri, duhet të siguroheni që nuk ka mbetur asnjë slot mbi të (përndryshe rrezikoni të humbni qasjen në të gjitha çelësat mbi këtë nod). Gjithashtu, mos e fshini masterin që ka slave, përndryshe do të kryhet një votim i panevojshëm për një master të ri. Nëse në nodet nuk ka më slot, atëherë kjo është një problem i vogël, por pse të kemi zgjedhje të panevojshme nëse mund ta hiqnim fillimisht slave.
- Nëse është e nevojshme të detyrohet ndërrimi i vendit mes master dhe slave, komanda e duhur është cluster failover. Duke e thirrur këtë në veprim, duhet të kuptoni se gjatë kryerjes së operacionit, masteri do të jetë i paarritshëm. Zakonisht, ndërrimi ndodh për më pak se një sekond, por nuk është atomar. Mund të jeni të sigurt se një pjesë e kërkesave ndaj masterit gjatë kësaj kohe do të përfundojnë me gabim.
- Para hequr një nodë nga klasteri, nuk duhet të mbeten slotë në të. Është më mirë t'i ri-shpërndani ato duke përdorur komandën cluster reshard. Slotët do të transferohen nga një master në një tjetër. E gjithë operacioni mund të zgjasë disa minuta, kjo varet nga sasia e të dhënave që po transferohen, megjithatë procesi i transferimit është i sigurt dhe nuk ndikon aspak në punën e klasterit. Kështu, të dhënat mund të transferohen nga një nodë në një tjetër nën ngarkesë, pa u shqetësuar për disponueshmërinë e tyre. Megjithatë, ka edhe nuanca. Së pari, transferimi i të dhënave është i lidhur me një ngarkesë të caktuar në nodën që merr dhe në nodën që dërgon. Nëse nodë e pranuese është tashmë shumë e ngarkuar me procesor, atëherë nuk duhet ta ngarkoni edhe më tej duke pranuar të dhëna të reja. Së dyti, sapo në masterin dërgues të mos ketë mbetur asnjë slot, të gjithë slave-t e tij menjëherë do të kalojnë tek masteri në të cilin ato slotë janë transferuar. Dhe problemi është se të gjithë këta slave menjëherë do të duan të sinkronizojnë të dhënat. Dhe do të keni fat nëse kjo do të jetë një sinkronizim i pjesshëm dhe jo i plotë. Merrni parasysh këtë, dhe kombinoni operacionet e transferimit të slotëve dhe çaktivizimin/transferimin e slave-ve. Ose shpresoni se keni një rezervë të mjaftueshme.
- Çfarë të bëni nëse gjatë transferimit keni zbuluar se keni humbur slotët? Shpresoj se kjo problem nuk do t'ju preke, por nëse ndodh, ekziston operacioni cluster fix. Ai do t'i shpërndajë slotët në nodë në një rend të rastësishëm. Rekomandoj të kontrolloni punën e tij, duke e fshirë paraprakisht një nodë nga klasteri me slotë të shpërndara. Duke qenë se të dhënat në slotët e pa-shpërndara nuk janë të arritshme, është tepër vonë të shqetësoheni për problemet me disponueshmërinë e këtyre slotëve. Nga ana tjetër, operacioni nuk do të ndikohet nga slotët e shpërndara.
- Një operacion tjetër i dobishëm është monitor. Ai lejon të shihni në kohë reale të gjithë listën e kërkesave që po i drejtohen nodës. Më shumë se kaq, përmes tij mund të bëni grep dhe të zjidhni nëse ka trafik të nevojshëm.
Po ashtu, është e rëndësishme të përmendet procedura e kalimit të fatkeqësisë së master-it. Nëse flasim shkurt, ajo ekziston dhe, sipas mendimit tim, funksionon mjaft mirë. Megjithatë, mos mendoni se nëse tërhiqni kabllon nga priza në makinë me master-nod, Redis do të kalojë menjëherë dhe klientët nuk do ta ndjejnë humbjen. Nga përvoja ime, kalimi ndodh brenda disa sekondash. Gjatë kësaj kohe, një pjesë e të dhënave do të jetë e paqasshme: zbulohet mungesa e master-it, nodet votojnë për një të ri, slave-t kalohen, të dhënat sinkronizohen. Mënyra më e mirë për t'u siguruar vetë se skema funksionon është të organizoni stërvitje lokale. Ngritni një klaster në laptopin tuaj, jepni një ngarkesë minimale, simuloni një rënie (për shembull, duke bllokuar portet), vlerësoni shpejtësinë e kalimit. Sipas mendimit tim, vetëm duke luajtur në këtë mënyrë për një ose dy ditë, mund të jesh i sigurt për funksionimin e teknologjisë. Ose, mund të shpresoni se softueri që përdoret nga gjysma e internetit padyshim funksionon.
Konfigurimi
Shpesh, konfigurimi është gjëja e parë që nevojitet për të filluar punën me mjetin. Dhe kur gjithçka fillon të funksionojë, nuk dëshiron ta prekësh konfigurimin. Kërkohen përpjekje të caktuara për t'u detyruar të kthehesh në cilësime dhe t'i shqyrtosh ato me kujdes. Nga sa mbaj mend, kemi pasur të paktën dy dështime serioze për shkak të pamundësisë për të treguar kujdes ndaj konfigurimit. Kushtoni vëmendje të veçantë pikave të mëposhtme:
- timeout 0
Koha gjatë së cilës mbyllen lidhjet e pasive (në sekonda). 0 - nuk mbyllen
Nuk çdo libërtonë tonë dinte t'i mbyllte lidhjet në mënyrë të saktë. Duke çaktivizuar këtë cilësim, rrezikojmë të bëjmë një limit në numrin e klientëve. Nga ana tjetër, nëse ka një problem të tillë, ndalja automatike e lidhjeve të humbura do ta maskojë atë, dhe mund të mos e vërejmë. Për më tepër, mos e aktivizoni këtë cilësim kur përdorni lidhje persistente. - Save x y & appendonly yes
Ruajtja e snapshot-it RDB.
Problemet RDB/AOF do t'i diskutojmë në detaje më poshtë. - stop-writes-on-bgsave-error no & slave-serve-stale-data yes
Nëse është aktivizuar, atëherë në rastin e dështimit të snapshot-it RDB, master-i do të ndalojë pranimin e kërkesave për ndryshime. Nëse humbet lidhja me master-in, ato slave mund të vazhdojnë të përgjigjen ndaj kërkesave (po). Ose do të ndalojnë përgjigjen (jo)
Nuk na pëlqen situata në të cilën Redis transformohet në një përrallë. - repl-ping-slave-period 5
Pas këtij intervali, ne do të shqetësohemi se mjeshtri është prishur dhe është koha për ta kryer procedurën e kalimit në sistem të dytë.
Do të duhet të gjejmë manualisht ekuilibrin midis alarmeve të rreme dhe aktivizimit të kalimit në sistem të dytë. Në praktikën tonë, kjo është 5 sekonda. - repl-backlog-size 1024mb & epl-backlog-ttl 0
Saktësisht aq të dhëna mund të ruajmë në tampon për replikën që ka humbur lidhjen. Nëse tamponi përfundon, do të jetë e nevojshme të sinkronizohemi plotësisht.
Praktika tregon se është më mirë të vendosni një vlerë më të madhe. Shkaku për të cilin një replikë mund të fillojë të mbetet pas është mjaft i rëndë. Nëse ajo vonohet, gjasat janë se mjeshtri juaj tashmë po përballet me vështirësi, dhe sinkronizimi i plotë do të jetë pika e fundit. - maxclients 10000
Numri maksimal i klientëve në një kohë të vetme.
Nga përvoja jonë, është më mirë të vendosni një vlerë më të madhe. Redis e menaxhon mirë me 10,000 lidhje. Thjesht sigurohuni që sistemi të ketë mjaft sokete. - maxmemory-policy volatile-ttl
Rregulli sipas të cilit fshihen çelësat kur arrihet kufiri i memories së disponueshme.
Këtu është e rëndësishme jo rregulli vetë, por kuptimi se si do të ndodhë kjo. Redis është për t'u lavdëruar për aftësinë e tij për të punuar normalisht kur arrihet kufiri i memories.
Problemet RDB dhe AOF
Megjithëse Redis vetë ruan të gjitha informacionet në memorien RAM, gjithashtu ka një mekanizëm për ruajtjen e të dhënave në disk. Më saktësisht, tre mekanizma:
- RDB-snapshot — një kopje e plotë e të dhënave. Caktohet përmes konfigurimit SAVE X Y dhe lexohet si "Ruaj një kopje të plotë të të dhënave çdo X sekonda, nëse është ndryshuar të paktën Y çelësa."
- Skeda e zakonshme — një listë e operacioneve sipas rendit të ekzekutimit. Shton operacionet e reja në skedë çdo X sekonda ose çdo Y operacione.
- RDB dhe AOF — një kombinim i dy mekanizmave të mëparshëm.
Të gjitha metodat kanë avantazhet dhe disavantazhet e tyre, nuk do t'i rendis të gjitha, vetëm do të veçoj disa pika që nuk janë aq të dukshme, sipas mendimit tim.
Së pari, për të ruajtur një snapshot RDB, është e nevojshme të thërrisni FORK. Nëse ka shumë të dhëna, kjo mund të ngadalësojë tërë Redis për një periudhë prej disa milisekondash deri në një sekondë. Për më tepër, sistemi kërkon të alokojë memorien për një snapshot të tillë, gjë që çon në nevojën për të mbajtur një rezerva të dyfishtë të memorjes RAM: nëse Redis alokohet 8 GB, atëherë në makinë virtuale me të duhet të jetë e disponueshme 16.
Në të dytën, ka probleme me sinkronizimin e pjesshëm. Në modin AOF, gjatë ripërputhjes së skllavëve mund të realizohet një sinkronizim i plotë në vend të një sinkronizimi të pjesshëm. Pse ndodh kjo, nuk kam mundur ta kuptoj. Por duhet ta mbani mend këtë.
Këto dy pika tashmë na bëjnë të mendojmë nëse na duhen vërtet këto të dhëna në disk, nëse gjithsesi janë të kopjuara nga skllavët. Mund të humbasim të dhëna vetëm në rast të dështimit të të gjitha skllavëve, dhe kjo është një problem i nivelit "zjarri në DC". Si një kompromis, mund të propozohet që të ruajmë të dhënat vetëm në skllavë, por në këtë rast duhet të sigurohemi që këta skllavë kurrë të mos bëhen mjeshtër gjatë rikuperimit emergjent (për këtë ka një cilësim të prioriteteve të skllavëve në konfigurimin e tyre). Për veten, në çdo rast konkret mendojmë nëse duhet të ruajmë të dhëna në disk, dhe shpesh përgjigjja është "jo".
Përfundim
Në përfundim, shpresoj të kem dhënë një pasqyrë të përgjithshme për funksionimin e redis-cluster-it atyre që nuk e kanë dëgjuar fare për të, dhe gjithashtu të kem theksuar disa çështje të paqarta për ata që e përdorin prej kohësh.
Faleminderit për kohën tuaj dhe, si zakonisht, komentet rreth temës janë të mirëpritura.
Burimi: habr.com
