

Procesi i përditësimit për klasterin tuaj Kubernetes
Në një moment gjatë përdorimit të klasterit Kubernetes, lind nevoja për të përditësuar nodet që punojnë. Kjo mund të përfshijë përditësime të paketave, përditësimin e bërthamës ose shpërndarjen e imazheve të reja të makinave virtuale. Në terminologjinë e Kubernetes, kjo quhet .
Ky post është pjesë e një cikli me 4 poste:
- Ky post.
- Mbyllja e duhur e pod’eve në klasterin Kubernetes
- Mbyllja e vonuar e pod-it gjatë fshirjes së tij
- Si të evitoni ndonjë shkëputje gjatë funksionimit të klasterit Kubernetes me ndihmën e PodDisruptionBudgets
(shënim: përkthimet e artikujve të tjerë të ciklit priteshin së shpejti)
Në këtë artikull do të përshkruajmë të gjitha mjetet që ofron Kubernetes për të arritur kohë zero shkëputje për nodet që punojnë në klasterin tuaj.
Përcaktimi i problemit
Në fillim do të përdorim një qasje naive, duke përcaktuar problemet dhe duke vlerësuar rreziqet potenciale të kësaj qasjeje dhe duke grumbulluar njohuri për të zgjidhur çdo problem që do të hasim gjatë gjithë ciklit. Si rezultat, do të marrim një konfigurim që përdor lifecycle hooks, readiness probes dhe Pod disruption budgets për të arritur kohën tonë zero të shkëputjes.
Për të filluar udhëtimin tonë, le të marrim një shembull konkret. Supozojmë se kemi një klaster Kubernetes me dy node, në të cilin është e instaluar një aplikacion me dy pod’e, që ndodhen pas Shërbimi:
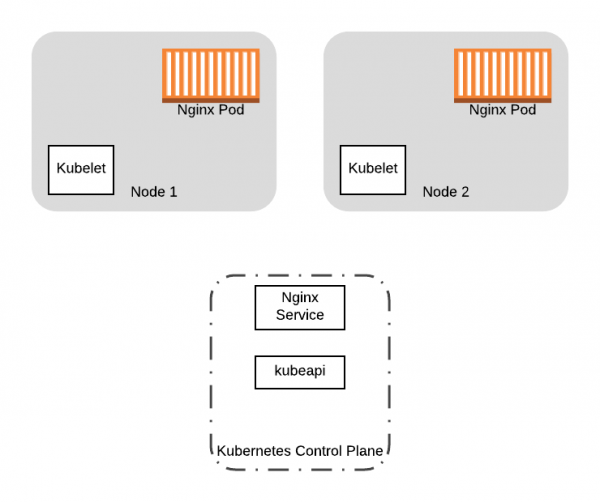
Të fillojmë me dy pod’e me Nginx dhe Shërbimi të instaluar në dy node të klasterit tonë Kubernetes.
Dëshirojmë të përditësojmë versionin e bërthamës të dy nodëve punues në klasterin tonë. Si do ta bëjmë këtë? Një zgjidhje e thjeshtë do të ishte të ngarkonim node të reja me konfigurim të përditësuar dhe pastaj të fiknim nodet e vjetra, duke e shoqëruar këtë me aktivizimin e të rinjve. Edhe pse kjo do të funksiononte, do të kishte disa probleme me këtë qasje:
- Kur të fikni nodet e vjetra, pod’et e instaluara mbi to do të fikën gjithashtu. Çfarë nëse pod’ët duhet të pastrohen për një shkëputje të saktë? Sistemi i virtualizimit që po përdorni mund të mos presë në përfundimin e procesit të pastrimit.
- Çfarë nëse fikni të gjitha nodet në të njëjtën kohë? Do të merrni një shkëputje të konsiderueshme ndërsa pod’ët kalojnë në nodet e reja.
Na necesitamos një mënyrë të saktë për migrimin e pod-ve nga nodet e vjetra dhe duhet të jemi të sigurt se asnjë nga proceset tona të punës nuk është i aktivizuar ndërsa bëmë ndryshime për nodin. Ose kur bëjmë një zëvendësim të plotë të klasterit, si në shembull (dmth zëvendësojmë imazhet e VM), ne duam të transferojmë aplikacionet aktive nga nodet e vjetra në të rinjtë. Në të dyja rastet, ne duam të parandalojmë planifikimin e pod-ve të rinj në nodet e vjetra dhe pastaj të zhveshim të gjithë pod-et e aktivizuara nga ato. Për të arritur këto qëllime, ne mund të përdorim komandën kubectl drain.
Redistribuimi i të gjitha pod-ve nga nodi
Operacioni drain lejon redistribuimin e të gjitha pod-ve nga nodi. Gjatë ekzekutimit të drain, nodi etiket është si unschedulable (flamuri NoSchedule). Kjo parandalon shfaqjen e pod-ve të rinj. Pastaj drain fillon të zhveshë pod-et nga nodi, ndalon punën e kontejnerëve që aktualisht janë të aktivizuar në nod dhe dërgon sinjalin TERM kontejnerëve në pod.
Megjithëse kubectl drain përballohet mirë me zhveshjen e pod-ve, ka edhe dy faktorë të tjerë që mund të shkaktojnë dështim gjatë ekzekutimit të operacionit drain:
- Aplikacioni juaj duhet të jetë në gjendje të mbyllet saktë kur merr sinjalin
TERMkur zhveshen pod-et, Kubernetes dërgon sinjalinTERMkontejnerëve dhe pret ndalimin e tyre për një periudhë të caktuar kohe, pas së cilës, nëse ata nuk janë ndalur, i mbyll me forcë. Në çdo rast, nëse kontejneri juaj nuk e percepton sinjalin saktë, ju ende mund të mbyllni pod-et në mënyrë të pasaktë, nëse ata janë aktivë në atë moment të caktuar (p.sh., është në proces një transaksion në DB). - Ju humbni të gjitha pod-et që përmbajnë aplikacionin tuaj. Ajo mund të jetë e papërshtatshme në momentin kur aktivizohen kontejnerët e rinj në nodet e reja ose, nëse pod-et tuaja janë dislokuar pa kontrolerë, ato mund të mos rifillojnë në tërësi.
Parandalimi i kohës së ndalimit
Për të minimizuar kohën e ndalimit nga ndërprerjet vullnetarë, siç është operacioni drain për nodin, Kubernetes ofron këto mundësi për trajtimin e defekteve:
Në pjesët e tjera të ciklit do të përdorim këto funksione të Kubernetes për të lehtësuar pasojat e transferimit të pod-ve. Për ta bërë më të lehtë ndjekjen e mendimit kryesor, ne do të përdorim shembullin tonë të mësipërm me këtë konfigurim burimor:
---
apiVersion: apps/v1
kind: Deployment
metadata:
 name: nginx-deployment
 labels:
   app: nginx
spec:
 replicas: 2
 selector:
   matchLabels:
     app: nginx
 template:
   metadata:
     labels:
       app: nginx
   spec:
     containers:
     - name: nginx
       image: nginx:1.15
       ports:
       - containerPort: 80
---
kind: Service
apiVersion: v1
metadata:
 name: nginx-service
spec:
 selector:
   app: nginx
 ports:
 - protocol: TCP
   targetPort: 80
   port: 80
Kjo konfiguracion është një shembull minimal Zhvillimi, i cili menaxhon pod’të nginx në klaster. Për më tepër, konfiguracioni përshkruan burimin Shërbimi, i cili mund të përdoret për të aksesuar pod’të nginx në klaster.
Gjatë gjithë ciklit ne do të zgjerim iterativ këtë konfiguracion, që në fund të përfshijë të gjitha mundësitë që Kubernetes ofron për të reduktuar kohën e papërshkueshmërisë.
Për të marrë një version të plotë të implementuar dhe të testuar të përditësimeve të klasterit Kubernetes për papërshkueshmëri zero në AWS dhe burime të tjera, vizitoni .
Lexoni gjithashtu artikuj të tjerë në blogun tonë:
Burimi: habr.com
