

Hyrje
🥇Si të arrish në qiell dhe të bëhesh pilot | ProHoster
Në këtë artikull do të ndaj përvojën time në ndërtimin e një arkitekture mikro-shërbimesh për një projekt që përdor rrjete nervore.
Do të flasim rreth kërkesave të arkitekturës, do të shohim diagramet e ndryshme strukturore, do të shqyrtojmë çdo komponent të arkitekturës së gatshme dhe do të vlerësojmë metrikat teknike të zgjidhjes.
Lexim të këndshëm!
Për disa fjalë rreth detyrës dhe zgjidhjes së saj
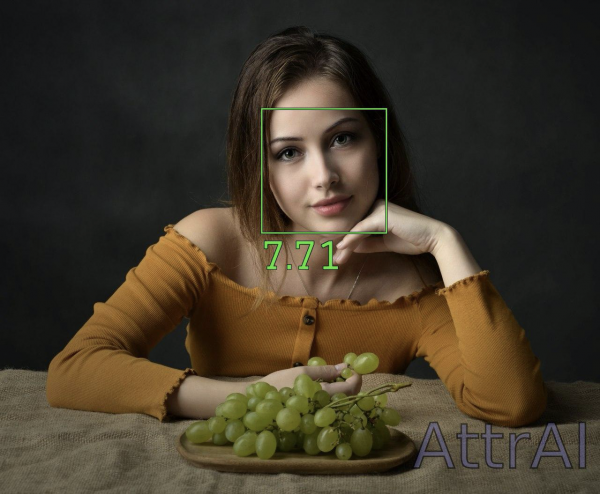
Ideja kryesore është që, në bazë të fotove, të japim një vlerësim të atraktivitetit të personit në një shkallë nga 1 në 10.
Në këtë artikull ne do të largohemi nga përshkrimi i rrjeteve nervore që përdoren dhe procesit të përgatitjes së të dhënave dhe trajnimit. Megjithatë, në një nga publikimet e ardhshme, ne do të kthehemi me siguri në shqyrtimin e pipeline-it të vlerësimit në një nivel më të thellë.
Tani ne do të kalojmë në mënyrë të përgjithshme përmes pipeline-it të vlerësimit, duke përqendruar vëmendjen në ndërveprimin e mikro-shërbimeve në kontekstin e arkitekturës së përgjithshme të projektit.
Gjatë punës mbi pipeline-in e vlerësimit të atraktivitetit, detyra u dekompozua në përbërësit në vijim:
- Identifikimi i fytyrave në foto
- Vlerësimi i secilës nga fytyrat
- Renderimi i rezultatit
E para zgjidhet me ndihmën e . Për të dytën, një rrjet nervor konvulucional u trajnuar në PyTorch, duke përdorur si backbone – nga balanca "cilësi / shpejtësi inferencës në CPU"
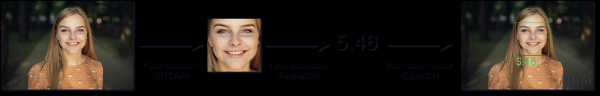
Diagrami funksional i pipeline-it të vlerësimit
Analiza e kërkesave për arkitekturën e projektit
Në ciklin e jetës e projektit, etapet e punës mbi arkitekturën dhe automatizimin e vendosjes së modelit janë shpesh nga më të shtrenjtat në kohë dhe burime.
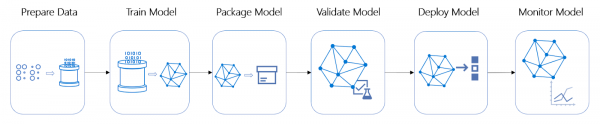
Cikli i jetës së projektit ML
Ky projekt nuk është përjashtim – u vendos që pipeline-i i vlerësimit të paketojë si një shërbim online, për këtë ishte e nevojshme të thellohemi në arkitekturë. Këto ishin disa kërkesa bazë të identifikuara:
- Një repository të vetme për log-e – të gjithë shërbimet duhet të shkruajnë log-e në një vend, dhe të jetë e lehtë për t'i analizuar ato
- Mundësia e shkallëzimit horizontal të shërbimit të vlerësimit — si ngushticë më e mundshme
- Për çdo imazh duhet të ndahen të njëjtat burime të procesorit — për të shmangur shpërthimet në shpërndarjen e kohës për inferencën
- Zhvillim të shpejtë (përsëritje) si të shërbimeve specifike ashtu edhe të stack-ut në tërësi
- Mundësia, nëse është e nevojshme, për të përdorur objekte të përbashkëta në shërbime të ndryshme
Arkitektura
Pas analizimit të kërkesave, bëhet e qartë se arkitektura mikroshërbimeve përshtatet praktikisht perfekt.
Për të eliminuar ndonjë dhimbje të panevojshme, u zgjodh Telegram API si frontend.
Fillimisht, le të shqyrtojmë diagramin strukturore të arkitekturës përfundimtare, pastaj do të kalojmë në përshkrimin e secilit nga komponentët, si dhe do të formalisht procesin e përpunimit të suksesshëm të imazhit.
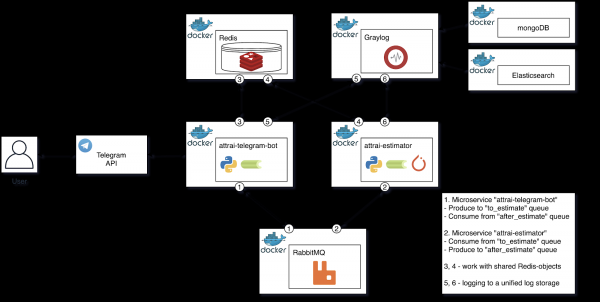
Diagrami strukturore i arkitekturës përfundimtare
Të flasim më në detaje për secilin nga komponentët e diagramit, të shënojmë përgjegjësinë e tyre të Vetme në procesin e vlerësimit të imazhit.
Mikrosherbimi «attrai-telegram-bot»
Ky mikrosherbim inkapsulon të gjitha ndërveprimet me Telegram API. Mund të veçojmë 2 skenarë kryesorë - puna me imazhin e përdoruesit dhe puna me rezultatin e pipeline-it të vlerësimit. Të dy scenarët do t'i shqyrtojmë në mënyrë të përgjithshme.
Kur merret një mesazh nga përdoruesi me imazhin:
- Kryhet filtrimi, që përfshin verifikimet e mëposhtme:
- Prania e madhësisë optimale të imazhit
- Numri i imazheve të përdoruesit, që tashmë janë në radhë
- Pas kalimit të filtrimit fillestar, imazhi ruhet në volumet docker
- Një detyrë e prodhuar dërgohet në radha “to_estimate”, e cila përfshin, midis të tjerash, rrugën për në imazhin që ndodhet në volumet tonë
- Nëse etapet e lartpërmendura kalohen me sukses - përdoruesi do të marrë një mesazh me një kohë të përafërt për përpunimin e imazhit, e cila llogaritet mbi numrin e detyrave në radhë. Në rast gabimi, përdoruesi do të informohet qartë për këtë - duke dërguar një mesazh me informacion se çfarë mund të ketë shkuar keq.
Gjithashtu, ky mikrosherbim, si punonjës celery, dëgjon radhën “after_estimate”, e cila është e destinuar për detyrat që kanë kaluar përmes pipeline-it të vlerësimit.
Kur merret një detyrë e re nga “after_estimate”:
- Nëse imazhi është përpunuar me sukses – dërgojmë rezultatin përdoruesit, nëse jo – e njoftojmë për gabimin
- Fshijmë imazhin, që është rezultati i pipeline-it të vlerësimit
Mikrosherbimi i vlerësimit «attrai-estimator»
Ky mikrosherbim është një punonjës celery dhe inkapsulon gjithçka që lidhet me pipeline-in e vlerësimit të imazhit. Algoritmi i punës këtu është i vetmi - do ta shqyrtojmë atë.
Kur merret një detyrë e re nga “to_estimate”:
- Përshkruajmë imazhin përmes pipeline-it të vlerësimit:
- Ngarko imazhin në memorje
- Bring the image to the desired size
- Find all faces (MTCNN)
- Evaluate all faces (wrap faces found in the previous step into a batch and infer using ResNet34)
- Render the final image
- Draw bounding boxes
- Draw evaluations
- Delete the user’s (original) image
- Save the output from the evaluation pipeline
- Place the task in the ‘after_estimate’ queue, which is listened to by the previously discussed microservice ‘attrai-telegram-bot’
Graylog (+ mongoDB + Elasticsearch)
— is a solution for centralized log management. In this project, it was used for its intended purpose.
The choice fell specifically on it, rather than the familiar stack, due to the convenience of working with it from Python. All that is needed to log in Graylog is to add GELFTCPHandler from the to other root logger handlers of our python microservice.
As someone who has previously only worked with the ELK stack, I generally had a positive experience working with Graylog. The only downside is Kibana’s superior features compared to Graylog’s web interface.
RabbitMQ
— is a message broker based on the AMQP protocol.
In this project, it was used as broker for Celery and operated in durable mode.
Redis
— is a NoSQL DBMS that works with key-value data structures.
Sometimes it's necessary to use common objects in different python microservices that implement some data structures.
For example, Redis stores a hashmap like ‘telegram_user_id => number of active tasks in the queue’, which allows limiting the number of requests from a single user to a certain value, thereby preventing DoS attacks.
Formalize the process of successful image processing
- The user sends an image to the Telegram bot
- ‘attrai-telegram-bot’ receives a message from the Telegram API and parses it
- The task with the image is added to the asynchronous queue ‘to_estimate’
- The user receives a message with the planned estimation time
- ‘attrai-estimator’ takes the task from the ‘to_estimate’ queue, runs it through the evaluation pipeline, and produces a task in the ‘after_estimate’ queue
- ‘attrai-telegram-bot’, listening to the ‘after_estimate’ queue, sends the result to the user
DevOps
Finally, after reviewing the architecture, we can move on to the equally interesting part — DevOps
Docker Swarm
— një sistem klasterizimi, funksionaliteti i të cilit është realizuar brenda Docker Engine dhe është i aksesueshëm nga kutia.
Me ndihmën e «rojeve», të gjithë nodet e klasterit tonë mund të ndahen në 2 lloje – punonjës dhe menaxher. Në pajisjet e llojit të parë krijohen grupe kontejnerësh (stacks), pajisjet e llojit të dytë janë përgjegjëse për shkallëzimin, balancimin dhe . Menaxherët për default janë gjithashtu punonjës.
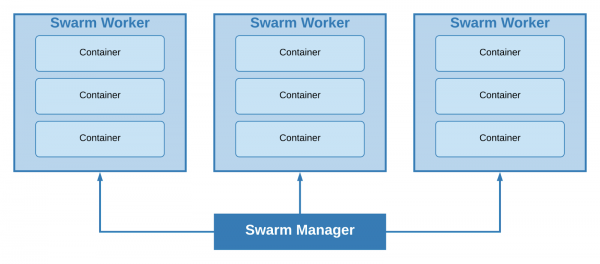
Një klaster me një menaxher lider dhe tre punonjës
Madhësia minimale e mundshme e klasterit është 1 nod, pajisja e vetme do të veprojë njëkohësisht si menaxher lider dhe punonjës. Duke u bazuar në madhësinë e projektit dhe kërkesat minimale për qëndrueshmëri, u mor vendimi për të përdorur këtë qasje.
Duke e kaluar përpara, do të them se që nga shpërndarja e parë në prodhim, e cila ndodhi në mes të qershorit, nuk ka pasur probleme të lidhura me organizimin e këtij klasteri (por kjo nuk do të thotë se një organizim i tillë është i pranueshëm në ndonjë projekt të mesëm ose të madh që ka kërkesa për qëndrueshmëri).
Docker Stack
Në modin e «rojeve» për shpërndarjen e stacks (grupimi i shërbimeve docker) është përgjegjës
Ai mbështet konfigurime docker-compose, duke lejuar përdorimin e parametrave të deploy-it për më tepër.
Për shembull, me ndihmën e këtyre parametrave u kufizuan burimet për secilën nga instancat e mikroshërbimit të vlerësimit (ndajmë N qarqe për N instanca, në vetë mikroshërbimin kufizojmë numrin e qarqeve të përdorura nga PyTorch në një)
attrai_estimator:
  image: 'erqups/attrai_estimator:1.2'
  deploy:
    replicas: 4
    resources:
      limits:
        cpus: '4'
    restart_policy:
      condition: on-failure
      …
Është e rëndësishme të theksohet se Redis, RabbitMQ dhe Graylog janë shërbime stateful dhe nuk është aq e lehtë t'i shkallëzojmë ato si «attrai-estimator»
Duke parashikuar pyetjen—pse jo Kubernetes?
Duket se përdorimi i Kubernetes në projekte të vogla dhe të mesme është një overhed, të gjitha funksionalitetet e nevojshme mund të merren nga Docker Swarm, i cili është mjaft miqësor me përdoruesit si një orkestrator kontejnerësh, si dhe ka një prag të ulët hyrës.
Infrastruktura
Të gjitha këto u zhvilluan në VDS me karakteristika të mëposhtme:
- CPU: 4 bërthama Intel® Xeon® Gold 5120 CPU @ 2.20GHz
- RAM: 8 GB
- SSD: 160 GB
Pas testeve lokale të ngarkesës, dukej se gjatë një fluksi të rëndë përdoruesish, kjo pajisje do të ishte në kufi.
Por vetëm pas implementimit, kam postuar një lidhje në një nga board-et më të njohura të imazheve në CIS (po, atë të famshmen), pas së cilës njerëzit u interesuan dhe brenda disa orëve shërbimi përpunoi me sukses dhjetëra mijëra imazhe. Në momentet kulmore, burimet CPU dhe RAM nuk u shfrytëzuan as në gjysmën e kapacitetit.
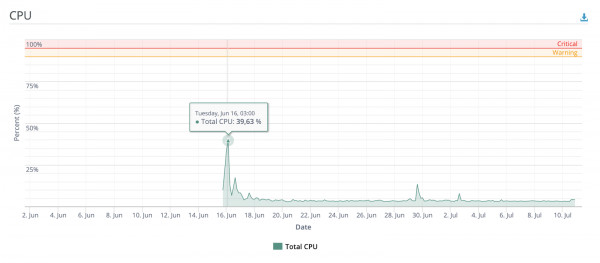
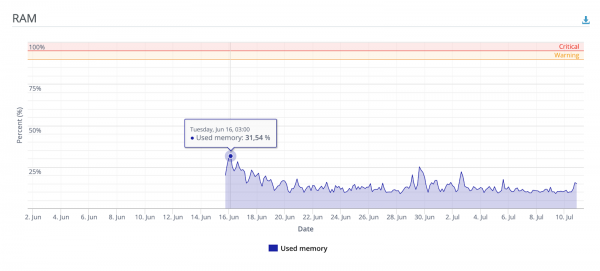
Pak më shumë grafikë
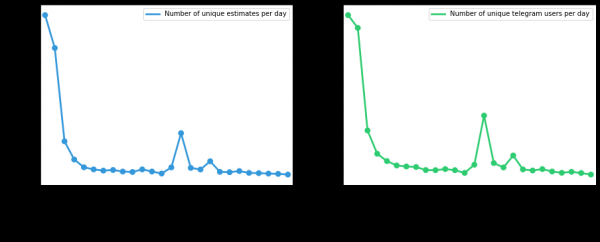
Numri i përdoruesve unikë dhe kërkesave për vlerësim, që nga momenti i implementimit, varion sipas ditës
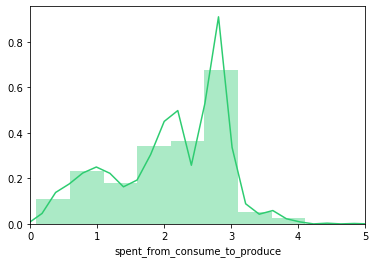
Distribucioni i kohës së inferencës së pipeline-it të vlerësimit
Përfundimet
Në përmbledhje, mund të them se arkitektura dhe qasja për orkestrimin e kontejnerëve e justifikuan vetveten plotësisht — edhe në momentet kulmore nuk kishte rënie dhe vonesa në kohën e përpunimit.
Mendoj që projektet e vogla dhe të mesme, që përdorin inferencën në kohë reale të rrjeteve neuronale në CPU, mund të përfitojnë suksesshëm nga praktikat e përshkruara në këtë artikull.
Do të shtoja se fillimisht artikulli ishte më i gjatë, por, për të mos postuar një dokument të gjatë, vendosa të lë disa pika jashtë — do të kthehemi te to në publikime të ardhshme.
Mund ta provoni botin në Telegram — @AttraiBot, do të funksionojë, të paktën, deri në fund të vjeshtës së vitit 2020. Kujtoj — nuk ruhet asnjë të dhënë personale — as imazhet origjinale, as rezultatet e pipeline-it të vlerësimit — gjithçka fshihet pas përpunimit.
Burimi: habr.com
