

Në këtë raport, Andrei Borodin do të flasë se si morën parasysh përvojën e shkallëzimit të PgBouncer gjatë projektimit të pool-it të lidhjeve. , si e lançuan atë në production. Për më tepër, do të diskutojmë cilat funksione të pool-it do të dëshiroja të shihja në versionet e reja: na rëndësi jo vetëm të mbyllim nevojat tona, por të zhvillojmë komunitetin e përdoruesve. .
Video:
Përshëndetje të gjithëve! Më quajnë Andrei.
Në Yandex, merrem me zhvillimin e bazave të të dhënave open source. Dhe sot kemi një temë për pool-in e lidhjeve.
Nëse e dini se si të quhet pool-i i lidhjeve në rusisht, më thoni. Dua shumë të gjej një term teknik të mirë që duhet të konsolidohet në literaturën teknike.
Tema është mjaft e komplikuar, sepse në shumë baza të dhënash pool-i i lidhjeve është i integruar dhe nuk duhet të dihet fare për të. Disa cilësime, sigurisht, ka kudo, por në Postgres nuk funksionon ashtu. Dhe paralelisht (në HighLoad++ 2019) ka një raport nga Nikolai Samohvalov për cilësimin e kërkesave në Postgres. Dhe mendoj se këtu erdhën njerëz që tashmë i kanë konfiguruar kërkesat në mënyrë perfekte, dhe këta janë njerëzit që përballen me probleme sistemike më të rralla të lidhura me rrjetin, shfrytëzimin e burimeve. Dhe ndonjëherë ka qenë mjaft e komplikuar, për shkak se problemet janë të paqartë.
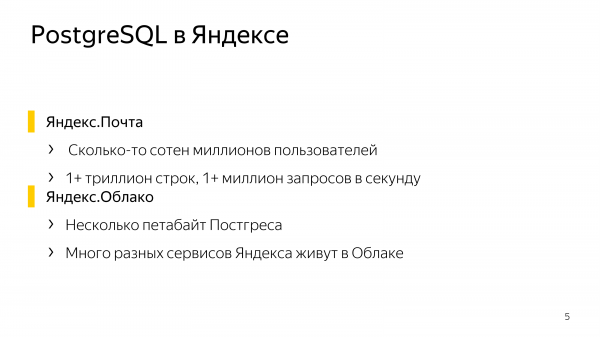
Në Yandex ka Postgres. Në Yandex.Cloud jetojnë shumë shërbime të Yandex. Dhe ne kemi disa petabyte të dhënash që gjenerojnë jo më pak se një milion kërkesa në sekondë në Postgres.
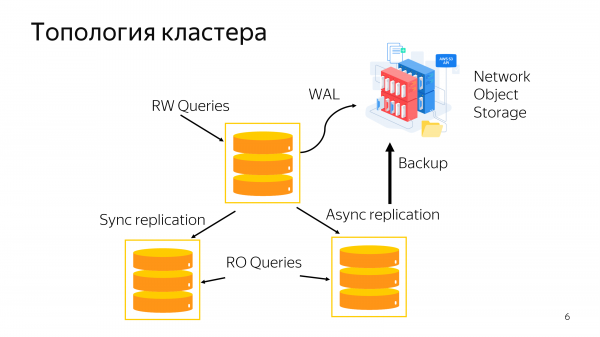
Dhe ne ofrojmë një klaster mjaft standard për të gjitha shërbimet – ky është nodi kryesor primar, dy-replikat normale (një sinkron dhe një asinkron), kopjimi rezerv dhe shkallëzimi i kërkesave lexuese në replikë.
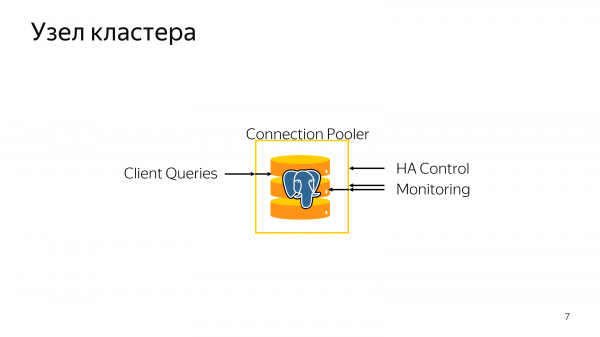
Çdo nod i klasterit është Postgres, mbi të cilin përveç Postgresit dhe sistemeve të monitoringut është gjithashtu instaluar pool-i i lidhjeve. Pool-i i lidhjeve përdoret për fencing dhe për qëllimin e tij kryesor.
Çfarë është qëllimi kryesor i pool-it të lidhjeve?
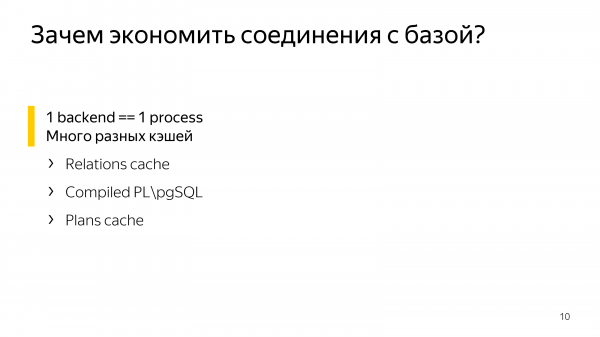
Në Postgres është pranuar modeli procesor në punën me bazën e të dhënave. Kjo do të thotë se një lidhje – është një proces, një backend i Postgres. Dhe në këtë backend ka shumë cache të ndryshme, të cilat janë të kushtueshme për t'u bërë të ndryshme për lidhje të ndryshme.
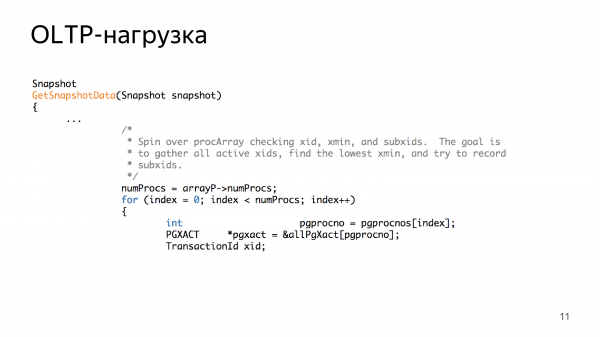
Për më tepër, në kodin e Postgres ka një array, i quajtur procArray. Ai përmban të dhëna kryesore rreth lidhjeve rrjet. Dhe pothuajse të gjithë algoritmet e përpunimit të procArray kanë kompleksitet linear, ata kalojnë nëpër të gjithë array-në e lidhjeve rrjet. Ky është një cikël mjaft i shpejtë, por me një numër të madh të lidhjeve rrjet, gjithçka bëhet pak më e shtrenjtë. Dhe kur çdo gjë bëhet pak më e shtrenjtë, në fund mund të paguani një çmim shumë të lartë për një numër të madh të lidhjeve rrjet.
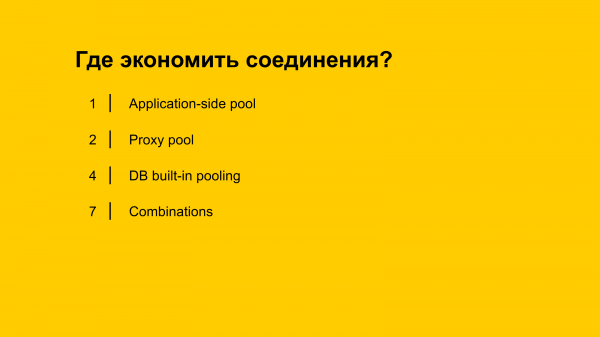
Ka 3 qasje të mundshme:
- Në anën e aplikacionit.
- Në anën e bazës së të dhënave.
- Dhe mes tyre, dmth, të gjitha kombinimet e mundshme.
Fatkeqësisht, pooler-i i integruar është aktualisht në fazën e zhvillimit. Miqtë në kompaninë PostgreSQL Professional kryesisht po merren me këtë. Kur do të shfaqet, është e vështirë të parashikohet. Dhe në të vërtetë, për arkitektin ka dy zgjidhje. Kjo është pool-i nga ana e aplikacionit dhe proxy pool.
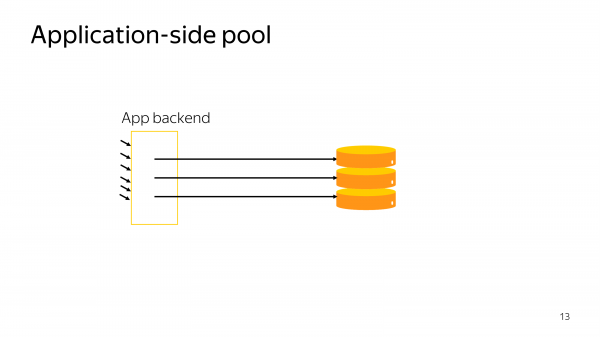
Pool-i nga ana e aplikacionit është manera më e thjeshtë. Dhe pothuajse të gjitha drejtoritë e klientëve ju ofrojnë një mënyrë: miliona lidhjet tuaja në kod të paraqiten si disa dhjetëra lidhje në bazën e të dhënave.
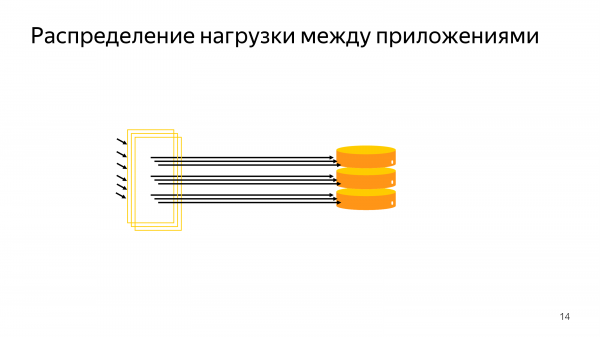
Shtrohet problemi se në një moment të caktuar dëshironi të shkallëzoni backend-in, dëshironi ta publikoni atë në shumë makineri virtuale.
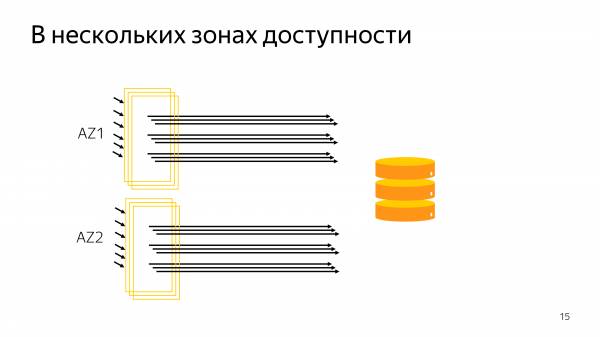
Pastaj e kuptoni edhe se keni disa zona të disponueshmërisë, disa qendra të të dhënave. Dhe qasja me pooling nga ana e klientit çon në numra të mëdhenj. Të mëdhenj do të thotë rreth 10,000 lidhje. Ky është kufiri që mund të funksionojë normalisht.
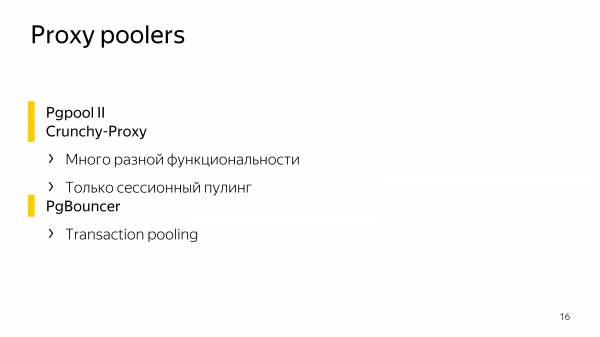
Nëse flasim për proxy poolers, ka dy poolers që dinë shumë. Ata nuk janë vetëm poolers. Ata janë poolers + funksionalitete të tjera fantastike. Këto janë dhe .
Por, fatkeqësisht, kjo funksionalitet shtesë nuk është e nevojshme për të gjithë. Dhe ajo çon në atë që poolers mbështesin vetëm pooling sesionesh, dmth, një klient i ardhshëm, një klient në dalje në bazën e të dhënave.
Për ne, kjo nuk i përshtatet shumë mirë, prandaj ne përdorim PgBouncer, që realizon pooling transaksionesh, dmth, lidhjet server aleatizohen me lidhjet e klientëve vetëm për kohën e transaksionit.
Dhe në ngarkesën tonë – kjo është e vërtetë. Por ka disa probleme.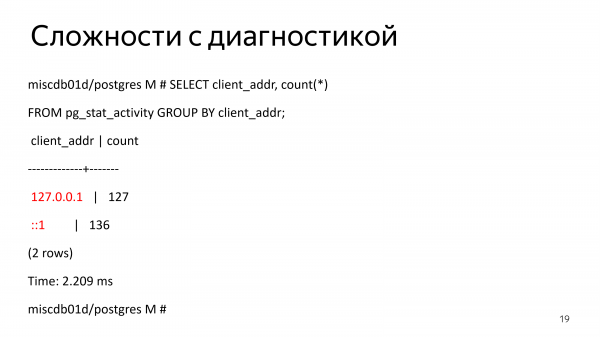
Problemet fillojnë kur dëshironi të diagnostikoni një seancë, sepse të gjitha lidhjet e ardhshme janë lokale. Të gjitha erdhën nga loopback dhe ndonjë mënyrë gjurmimi seancës bëhet e vështirë.
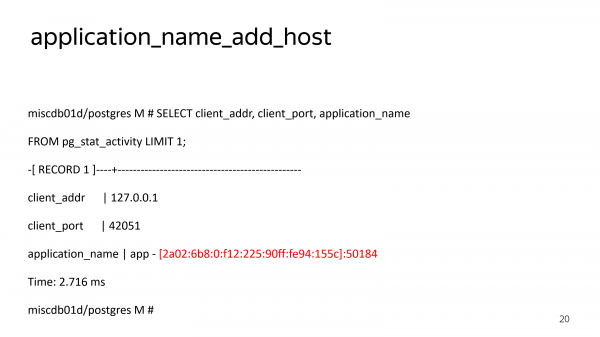
Sigurisht, mund të përdorni application_name_add_host. Ky është një mënyrë në anën e Bouncer për të shtuar një IP në application_name. Por application_name vendoset me një lidhje të nëntokës.
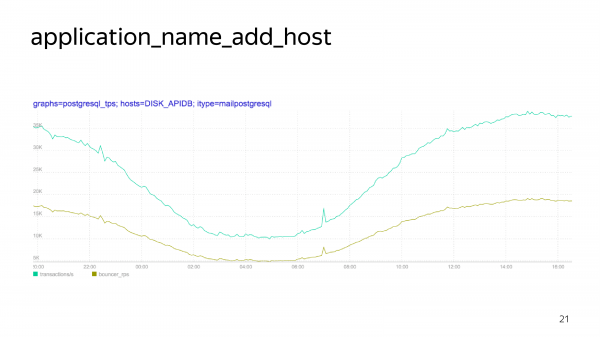
Në këtë grafik, ku linja e verdhë paraqet kërkesat reale, dhe ku linja blu paraqet kërkesat që hyjnë në bazën e të dhënave. Dhe kjo diferencë është pikërisht konfigurimi i application_name, i cili është i nevojshëm vetëm për gjurmim, por ai nuk është krejtësisht falas.
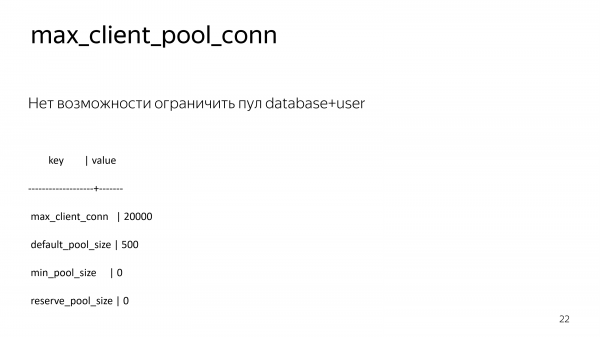
Për më tepër, në Bouncer nuk mund të kufizoni një pool, dmth numrin e lidhjeve me bazën e të dhënave për përdorues të caktuar, për një bazë të caktuar.
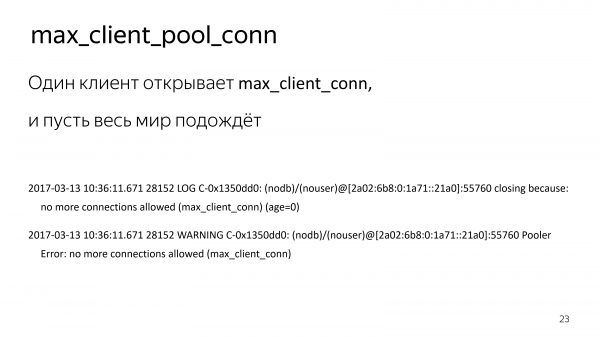
Në çfarë rezultati çon kjo? Keni një shërbim të ngarkuar, të shkruar në C++, dhe diku pranë një shërbim të vogël në nodë, i cili nuk bën asgjë të keqe me bazën, por drejtori i tij po çmendet. Ai hap 20,000 lidhje, ndërsa çdo gjë tjetër pret. Madje edhe kodi juaj është në rregull.
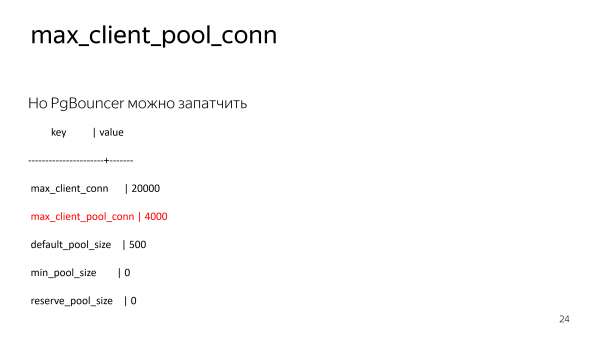
Sigurisht, ne kemi shkruar një patch të vogël për Bouncer, i cili shtoi këtë konfigurim, dmth kufizimin e klientëve në pool.
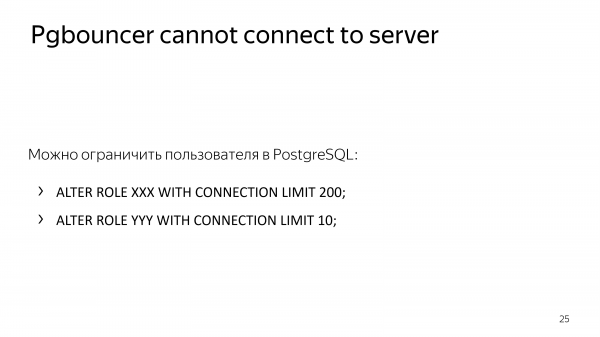
Kjo do të ishte e mundur në anën e Postgres, dmth rolet në bazën e të dhënave të kufizohen me numrin e lidhjeve.
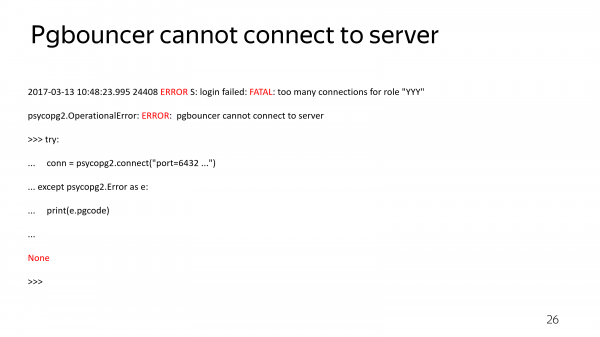
Por atëherë humbni mundësinë për të kuptuar pse nuk keni lidhje me serverin. PgBouncer nuk transmeton gabimin e lidhjes, ai gjithmonë kthen të njëjtën informacion. Dhe nuk mund të kuptoni: ndoshta keni ndryshuar fjalëkalimin, ndoshta thjesht baza ka rënë, ndoshta ka diçka që nuk shkon. Por nuk ka diagnostikim. Nëse sesioni nuk mund të vendoset, nuk do të dini pse kjo nuk mund të bëhet.
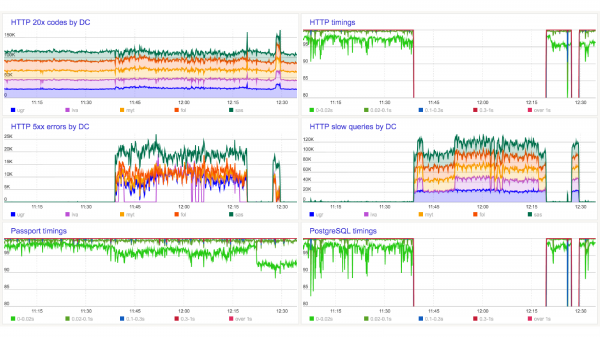
Në një moment të caktuar shikoni grafikët e aplikacionit dhe shihni se aplikacioni nuk po funksionon.
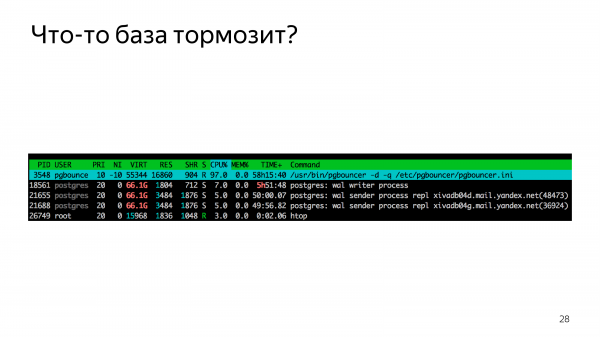
Shikoni në përqendrim dhe shihni se Bouncer është njëri-në-njeri. Ky është një moment përmbysës në jetën e shërbimit. Kuptoni se ishit përgatitur për të shkallëzuar bazën e të dhënave pas një viti e gjysmë, por ju nevojitet të shkallëzoni pooler.
Ne arritëm në përfundimin se na nevojiten më shumë PgBouncer'
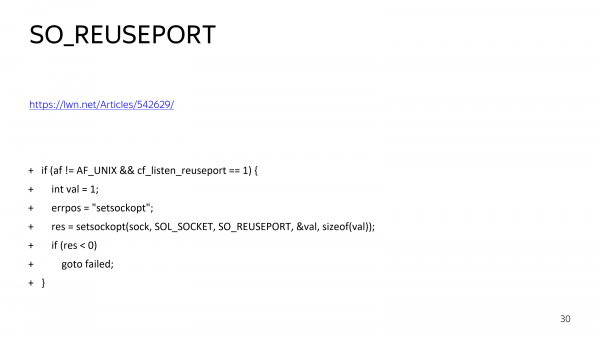
Paksa e përmirësuam Bouncer.
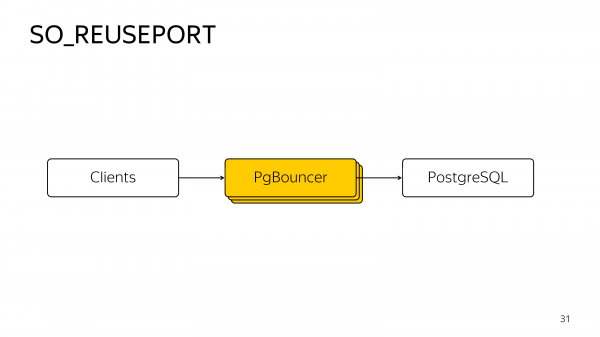
Dhe bëmë që të mund të ngrihen disa Bouncers me ripërdorimin e portit TCP. Dhe tashmë sistemi operativ automatikisht i ndani lidhjet TCP që hyjnë mes tyre me një rund-robin.
Kjo është transparente për klientët, dmth gjithçka duket sikur keni një Bouncer, por keni një fragmentim të lidhjeve idle mes Bouncer'ave të nisur.
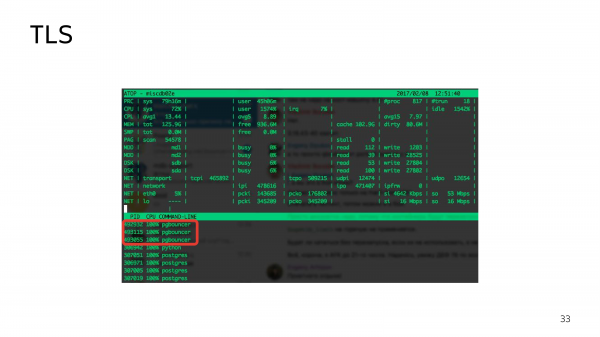
Dhe në një moment të caktuar, mund të vëreni se këta 3 Bouncers po përdorin secili 100% të bërthamës së tij. Ju nevojiten mjaft Bouncers. Pse?
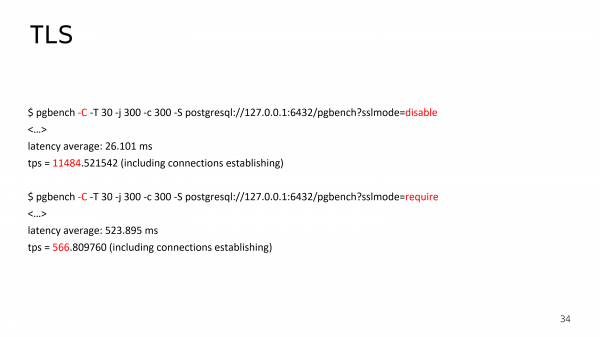
Sepse keni TLS. Keni një lidhje të enkriptuar. Dhe nëse benchmarkoni Postgres me TLS dhe pa TLS, do të zbuloni se numri i lidhjeve të vendosura bie gati me dy renditje me aktivizimin e enkriptimeve, sepse dorëzimi i TLS konsumon burime të procesorit.
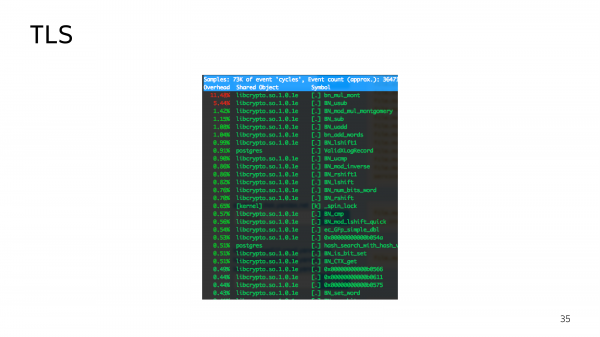
Dhe në krye mund të shihni mjaft shumë funksione kriptografike që kryhen gjatë valës së lidhjeve të ardhshme. Duke pasur parasysh se primary ynë mund të kalojë midis zonave të disponueshmërisë, vala e lidhjeve të ardhshme është një situatë mjaft e zakonshme. Me fjalë të tjera, për një arsye të caktuar, primary i vjetër nuk ishte i disponueshëm, dhe gjithë ngarkesa u dërgua në një qendër tjetër të të dhënave. Të gjithë do të vijnë menjëherë për të përshëndetur me TLS.
Dhe një numër i madh i dorëzimeve TLS mund të mos përshëndesin më Bouncer-in, por ta ngushtojnë atë. Për shkak të kohës së mbarimit, vala e lidhjeve të ardhshme mund të bëhet e pakontrolluar. Nëse keni një ritretry në bazën e të dhënave pa exponential backoff, ato nuk do të vijë përsëri dhe përsëri si një valë koherente.
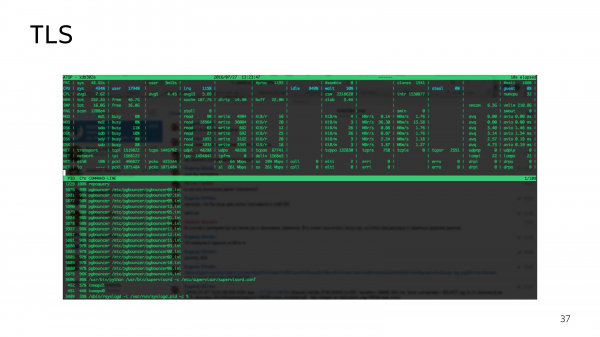
Ja një shembull i 16 PgBouncer që ngarkojnë 16 bërthama në 100%.
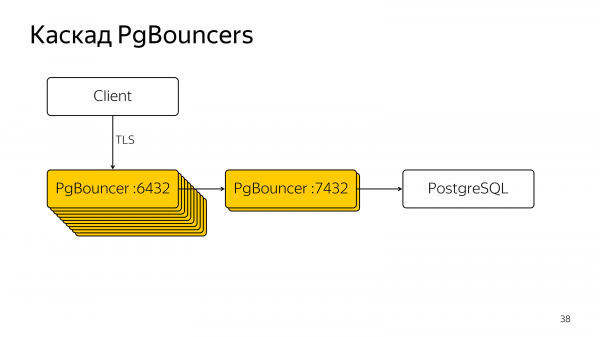
Kemi arritur në PgBouncer të kaskadës. Kjo është konfigurimi më i mirë që mund të arrihet në ngarkesën tonë me Bouncer. Bouncers e jashtme shërbejnë për dorëzimin TCP, ndërsa Bouncers e brendshme shërbejnë për pooling real, që të mos fragmentojnë shumë lidhjet e jashtme.
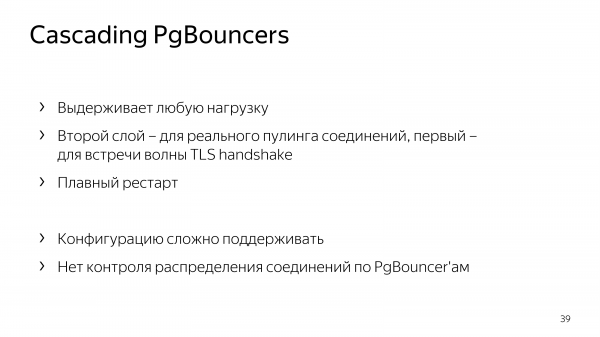
Në një konfigurim të tillë, është e mundur një restart i qetë. Mund të rinitni gjithë këta 18 Bouncers një nga një. Por mbajtja e një konfigurimi të tillë është e vështirë. Administratorët e sistemeve, DevOps dhe njerëzit që kanë vërtet përgjegjësi për këtë server, nuk do të jenë shumë të kënaqur me këtë skemë.
Duket se mund të promovojmë të gjitha zhvillimet tona në open source, por Bouncer-i nuk mbështetet shumë mirë. Për shembull, mundësia për të nisur disa PgBouncers në një port është komituar një muaj më parë. Ndërsa pull request për këtë funksion ishte bërë disa vjet më parë.
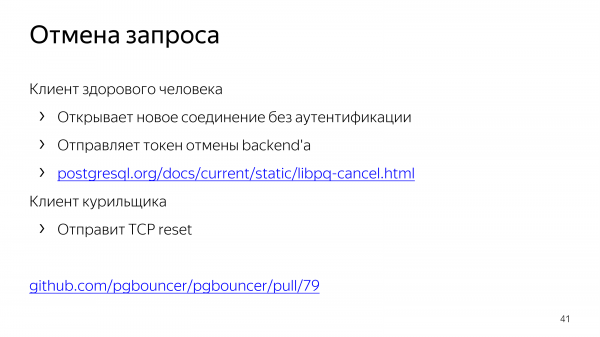
Ose shembuj tjetër. Në Postgres mund të anulloni një kërkesë që po ekzekutohet, duke dërguar një sekret në një lidhje tjetër pa autentifikim të panevojshëm. Por disa klientë thjesht dërgojnë një TCP-reset, pra, përshtasin lidhjen rrjet. Çfarë do të bëjë Bouncer në këtë rast? Ai nuk do të bëjë asgjë. Ai do të vazhdojë të ekzekutojë kërkesën. Nëse keni ardhur me një numër të madh lidhjesh që kanë mbushur bazën me kërkesa të vogla, thjesht të shkëputni lidhjen nga Bouncer nuk do të mjaftojë, duhet gjithashtu të përfundoni ato kërkesa që po ekzekutohen në bazë.
Ky problem është rregulluar dhe ende nuk është integruar në upstream të Bouncer-it.
Kështu arritëm në përfundimin se na nevojitet një pooler lidhjesh tonë, i cili do të zhvillohet, rregullohet, ku do të jetë e mundur të zgjidhen shpejt problemet dhe që, natyrisht, duhet të jetë shumëprocesor.
Dhe multithreading-u e kemi vendosur si një detyrë kryesore. Na duhet të përballojmë mirë valën e lidhjeve TLS që po vijnë.
Për këtë na duhej të zhvillonim një bibliotekë të veçantë, e cila quhet Machinarium, e cila është e destinuar për të përshkruar gjendjet e makinës së lidhjes rrjet si një kod sekondar. Nëse e shikoni kodin burimor të libpq, do të shihni thirrje të ndërlikuara, që mund t'ju kthejnë një rezultat dhe të thonë: "Më thirr pak më vonë. Tani kam IO, por, kur IO të përfundojë, kam ngarkesë për procesorin." Kjo është një skemë me shumë nivele. Ndërveprimi rrjet shpesh përshkruhet si një makinë gjendjesh. Një grup rregullash si "Nëse e kam marrë më parë një titull paketi të madhësisë N, tani pres N byte", "Nëse kam dërguar një paketë SYNC, tani pres një paketë me metadatat e rezultatit". Kjo rezulton në një kod të ndërlikuar, si nëse një labirint do të shndërrohej në një shtrirje të drejtpërdrejtë. Ne e kemi bërë që, në vend të makinës së gjendjeve, programuesi të përshkruajë rrugën kryesore të ndërveprimit në formën e zakonshme të kodit imperativ. Thjesht, në këtë kod imperativ duhet të vendosen vende ku sekuenca e ekzekutimit duhet të shkeputet duke pritur të dhëna nga rrjeti, duke kaluar kontekstin e ekzekutimit në një korutinë tjetër (thread-i të gjelbër). Ky qasje është e ngjashme me atë, që rruga më e pritur në labirintin e regjistrojmë radhazi, dhe pastaj shtojmë degëzime.
Kështu, ne kemi një rrjedhë që bën TCP accept dhe nëpërmjet round-robin transferon shumë punëtorë të lidhjes TPC.
Çdo lidhje klienti punon gjithmonë në një procesor. Kjo e bën atë miqësore për cache.
Për më tepër, ne kemi bërë disa përmirësime në mbledhjen e paketave të vogla në një paketë të madhe për të lehtësuar ngarkesën në TCP-stack të sistemit.
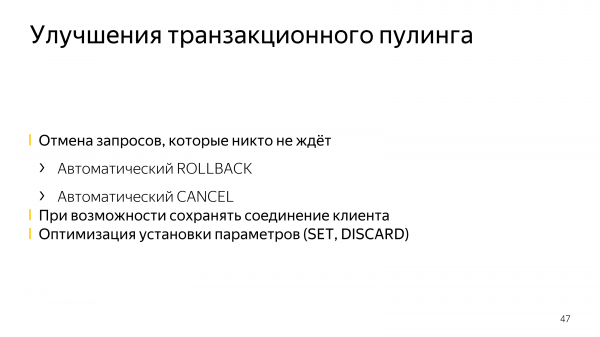
Gjithashtu, ne kemi përmirësuar puliin transaksional në mënyrë që Odyssey me konfigurimin e duhur mund të dërgojë CANCEL dhe ROLLBACK në rast të ndërprerjes së lidhjes rrjet, dmth nëse askush nuk po pret për kërkesën, Odyssey do t'i thotë bazës të mos përpiqet të ekzekutojë atë kërkesë që mund të shpenzojë burime të çmuara.
Sa më shumë të jetë e mundur, ne ruajmë lidhjet me të njëjtin klient. Kjo e lejon që të mos riinstalohet application_name_add_host. Nëse është e mundur, nuk ka riinstalimin shtesë të parametrave të nevojshëm për diagnostikim.
Ne punojmë në interes të Yandex.Cloud. Dhe nëse përdorni PostgreSQL të menaxhuar dhe keni instaluar connection pooler, mund të krijoni replikim logjik jashtë, dmth të largoheni prej nesh, në qoftë se dëshirat përmes replikimit logjik. Bouncer nuk do t’i japë rrjedhën e replikimit logjik jashtë.
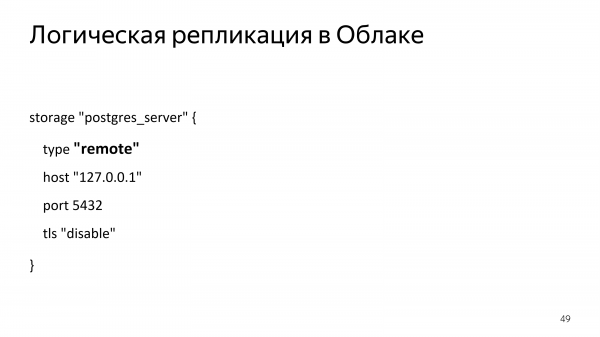
Ky është një shembull i konfigurimit të replikimit logjik.
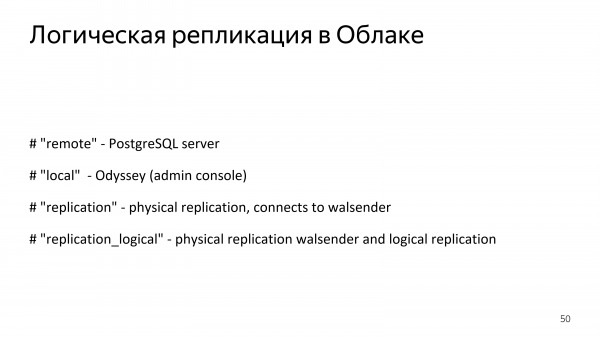
Gjithashtu, kemi mbështetje për replikimin fizik jashtë. Në Cloud është, natyrisht, e pamundur, sepse atëherë klasteri do t'ju japë shumë informacion rreth vetes. Por në instalimet tuaja, nëse ju nevojitet replikim fizik përmes connection pooler në Odyssey, kjo është e mundur.
Në Odyssey ka monitorim plotësisht të përshtatshëm me PgBouncer. Ne kemi të njëjtën konsolë që ekzekuton pothuajse të njëjtat komanda. Nëse ndokush ka ndonjë nevojë që mungon, dërgoni një pull request, ose të paktën një issue në GitHub, ne do ta përfundojmë komandon e nevojshme. Por funksionaliteti kryesor i konsolës PgBouncer tashmë është i pranishëm.
Dhe sigurisht, kemi forwarding të gabimeve. Ne do të kthejmë atë gabim që raportoi baza. Do të merrni informacion përse nuk po hyni në bazë, e jo vetëm se nuk po hyni.
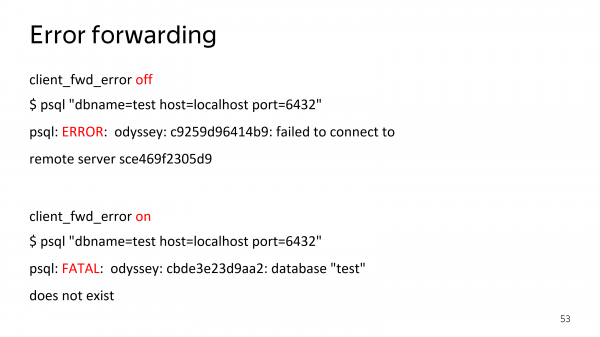
Kjo mundësi mund të çaktivizohet në rast se keni nevojë për 100%-të përputhshmëri me PgBouncer. Mund të veprojmë si Bouncer, thjesht për çdo rast.
Zhvillimi
Disa fjalë për kodin burimor të Odyssey.
Për shembull, ka komandat «Pause / Resume». Ato zakonisht përdoren për të përditësuar bazën e të dhënave. Nëse ju nevojitet të përditësoni Postgres, mund ta vendosni atë në pauzë në connection pooler, të bëni pg_upgrade dhe pastaj të bëni resume. Dhe nga ana e klientit do të duket si të kishte ndaluar baza. Këtë funksionalitet na e sollën njerëzit nga komuniteti. Akoma nuk është marrë me merge, por shpejt do të jetë. (Ndiqeni me merge)
— tashmë është marrë me merge
Për më tepër, një nga veçoritë e reja në PgBouncer është mbështetja për SCRAM Authentication, që na e solli gjithashtu një person që nuk punon në Yandex.Cloud. Të dyja - është funksionalitet kompleks dhe i rëndësishëm.
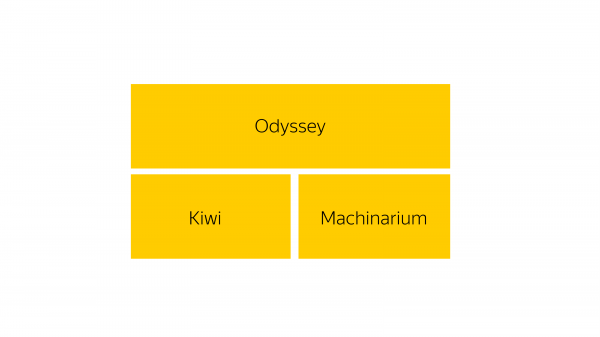
Prandaj dua të flas për atë nga çfarë është ndërtuar Odyssey, ndoshta ju gjithashtu dëshironi tani të shkruani pak kod.
Ju keni bazën origjinale Odyssey, e cila mbështetet në dy biblioteka kryesore. Biblioteka Kiwi - është realizimi i protokollit të mesazheve të Postgres. Pra, protokolli natyror 3 i Postgres është mesazhet standarde, me të cilat frontendët dhe backendët mund të shkëmbejnë. Ato janë realizuar në biblioteken Kiwi.
Biblioteka Machinarium - është biblioteka e realizimit të rrjedhave. Një fragment i vogël i këtij Machinarium është shkruar në assembler. Por, mos u friksoni, aty ka vetëm 15 rreshta.
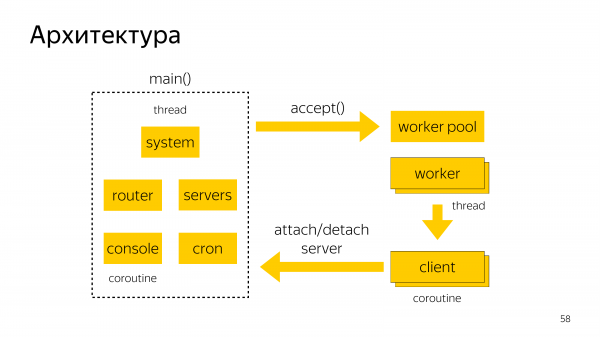
Arkitektura e Odyssey. Ka një makinë kryesore, në të cilën janë të lançuar coroutines. Në këtë makinë realizohet accept i lidhjeve TCP që vijnë dhe shpërndarja në workers.
Brenda një worker-i mund të punojë një trajtues për disa klientë. Po ashtu, në rrjedhën kryesore rrotullohen konsola dhe përpunimi i detyrave crone për të hequr lidhjet që nuk janë më të nevojshme në pool.
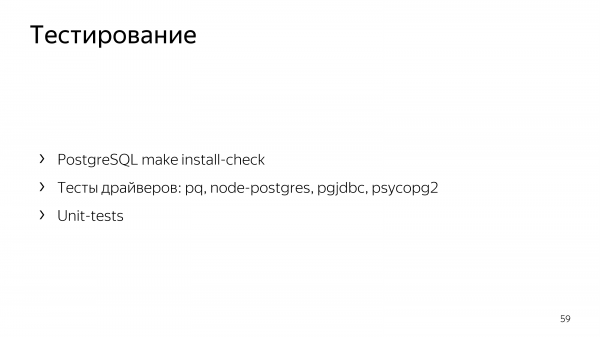
Për testimin e Odyssey përdoret seti standard i testeve të Postgres. Thjesht aktivizojmë install-check përmes Bouncer dhe përmes Odyssey, marrim një div zero. Ka disa teste, të lidhura me formatimin e datave, që nuk kalojnë krejtësisht njësoj në Bouncer dhe në Odyssey.
Për më tepër, ka shumë driver-a, që kanë testimin e tyre. Dhe testet e tyre i përdorim për testimin e Odyssey.
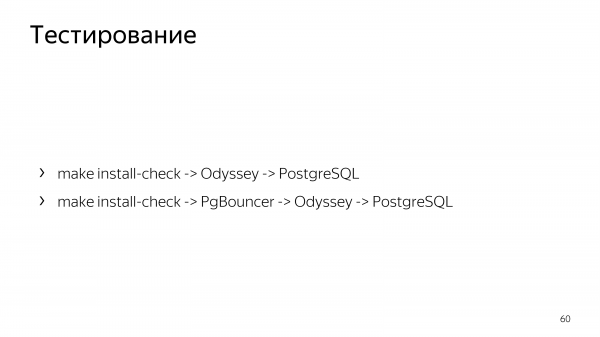
Për më tepër, për shkak të konfiguracioneve tona kaskadë na duhet të testojmë lidhje të ndryshme: Postgres + Odyssey, PgBouncer + Odyssey, Odyssey + Odyssey, për të qenë të sigurt që, nëse Odyssey ndodhet në ndonjë nga pjesët në kaskadë, ai gjithashtu funksionon siç e presim.
Grab
Ne përdorim Odyssey në prodhim. Nuk do të ishte e drejtë të thoja se gjithçka funksionon thjesht. Jo, pra, po, por jo gjithmonë. Për shembull, në prodhim gjithçka punoi thjesht, pastaj erdhën miqtë tanë nga PostgreSQL Professional dhe thanë se kishim një memory leak. Ata me të vërtetë kishin të drejtë, e rregulluam këtë. Por ishte thjesht atëherë.
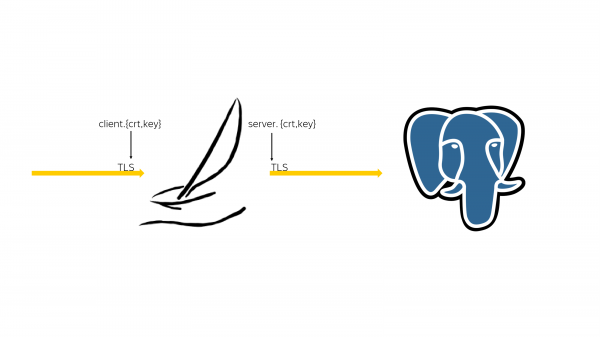
Pastaj zbuluam se në connection pooler ka lidhje TLS që hyjnë dhe lidhje TLS që dalin. Dhe për këto lidhje kërkohen certifikata klienti dhe certifikata serveri.
Certifikatat serveri Bouncer dhe Odyssey i rishikojnë ato pcache, por certifikatat e klientit nuk kanë nevojë të rishikohen nga pcache sepse Odyssey ynë i shkallëzuar në fund të fundit përballet me performancën sistemike të leximit të kësaj certifikate. Kjo për ne ishte një befasi, sepse e kishte një problem shumë vonë. Fillimisht, ai ishte duke u shkallëzuar linear, por pas 20,000 lidhjeve të pranuara njëkohësisht, ky problem doli në pah.
Metoda e Autorizimit të Lejuar – është mundësia që të autentifikohesh me mjetet e integruara të linux. Në PgBouncer kjo realizohet në mënyrë që ka një rrjedh të veçantë për të pritur përgjigjen nga PAM dhe ka rrjedhën kryesore PgBouncer, e cila shërben lidhjen aktuale dhe mund t'i kërkojë që të presin në rrjedhën PAM.
Ne nuk e realizuam këtë për një arsye të thjeshtë. Ne kemi shumë rrjedha. Pse na duhet kjo?
Si rezultat, kjo mund të krijojë probleme me atë që, nëse keni autentifikimin PAM dhe jo PAM, një valë e madhe e autentifikimit PAM mund të vonojë ndjeshëm autentifikimin jo PAM. Kjo është një nga ato gjëra që ne nuk e rregulluam. Por nëse dëshironi ta rregulloni, mund të merret me këtë.
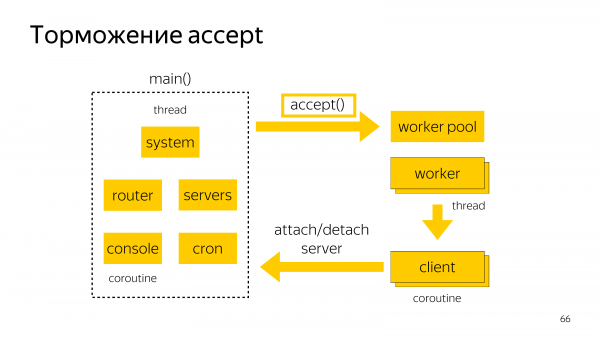
Një tjetër problem ishte se kemi një rrjedh që pranon të gjitha lidhjet e pranuara. Dhe pastaj i kalon në pool-in e punëtorëve, ku do të ndodhi TLS handshake.
Si rezultat, nëse keni një valë koherente prej 20,000 lidhjesh rrjet, ato të gjitha do të priten. Dhe në anën e klientit libpq do të fillojë numërimin e timeout-eve. Në parazgjedhje duket se aty janë 3 sekonda.
Nëse ato të gjitha nuk mund të hyjnë në bazë njëkohësisht, atëherë ata nuk mund të hyjnë në bazë, sepse gjithë kjo mund të mbulohet me një retry jo eksponencial.
Ne arritëm në përfundimin se kopjuam këtu skemën nga PgBouncer me atë që kemi mbrojtjen e numrit të lidhjeve TCP, të cilat ne i pranojmë.
Nëse ne shohim se po pranojmë lidhjet, por ato nuk arrijnë të kryejnë handshake-in, i vendosim në radhë që të mos shpenzojnë burimet e procesorit qendror. Kjo sjell që handshake-i në të njëjtën kohë mund të realizohet vetëm për disa lidhje që kanë ardhur. Por të paktën dikush do të hyjë në bazë, edhe nëse ngarkesa është mjaft e madhe.
Plani i Veprimit
Çfarë do të doja të shihja në të ardhmen në Odyssey? Çfarë jemi të gatshëm të zhvillojmë vetë dhe çfarë presim nga komuniteti?
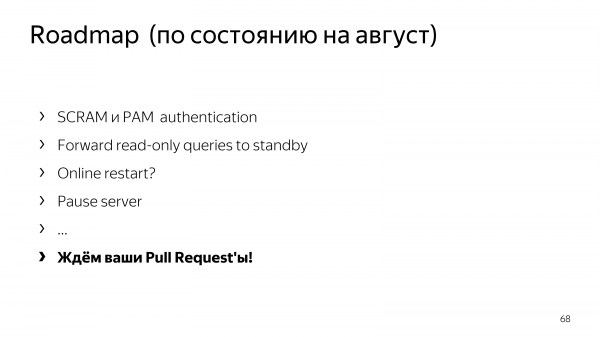
Në gusht 2019.
Këtu është si dukej plani i veprimit të Odyssey në gusht:
- Ne do të donim autentikimin SCRAM dhe PAM.
- Do të doja të lexoja pyetje përpara në varg.
- Do të dëshironim një rindizje online.
- Dhe mundësinë për të bërë një pauzë në server.
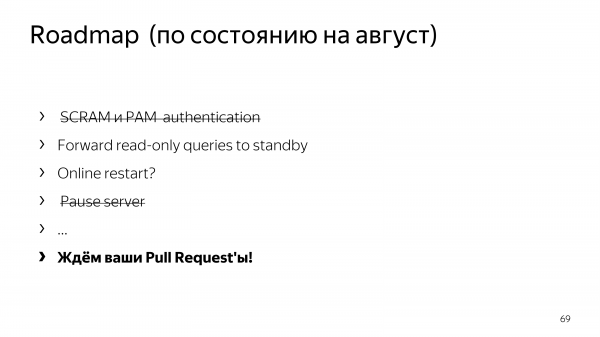
Gjashtëdhjetë për qind e këtij plani janë realizuar, madje jo nga ne. Dhe kjo është shumë mirë. Pra, le të diskutojmë për atë që ka mbetur dhe të shtojmë më shumë.
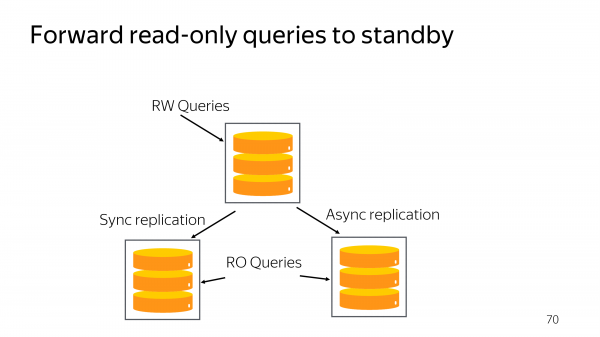
? У нас есть реплики, которые без выполнения запросов будут просто греть воздух. Они нам необходимы для обеспечения failover и switchover. В случае проблем в одном из дата-центре хотелось бы их занять какой-то полезной работой. Потому что те же самые центральные процессоры, ту же самую память мы не можем сконфигурировать по-другому, потому что иначе не будет работать репликация.
Në thelb, në Postgres, duke filluar nga versioni 10, ka mundësi që gjatë lidhjes të specifikoni gjithashtu session_attrs. Në lidhje mund të listoni të gjithë hostet e bazës së të dhënave dhe të thoni se përse po hyni në bazën e të dhënave: për të shkruar ose vetëm për të lexuar. Dhe drejtuesi do të zgjedhë vetë hostin e parë në listë që e pëlqen më shumë, që përmbush kërkesat e session_attrs.
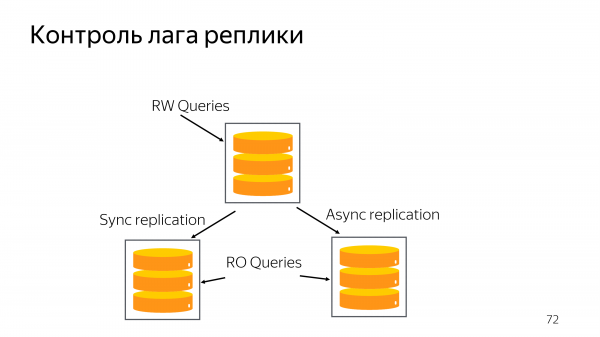
Por problemi i këtij qasje është se nuk kontrollon vonesën e replikimit. Mund të keni një replikë që është vonuar për një periudhë të papranueshme për shërbimin tuaj. Për të realizuar ekzekutimin e plotë të kërkesave të leximit në replikë, në thelb, na nevojitet të mbështesim në Odyssey mundësinë për të mos funksionuar kur nuk mund të lexojmë.
Odyssey duhet të hyjë herë pas here në bazë dhe të pyesë për distancën e replikimit nga primari. Dhe nëse ka arritur një vlerë kufitare, të mos lejojë kërkesat e reja në bazë, të informojë klientin që duhet të nisin përsëri lidhjet dhe ndoshta të zgjedhin një host tjetër për ekzekutimin e kërkesave. Kjo do të lejojë bazën që të rikuperojë më shpejt vonesën e replikimit dhe të kthehet për t'u përgjigjur kërkesave.
Afati i realizimit është i vështirë të thuhet, sepse është open source. Por, shpresoj se nuk do të zgjasë 2.5 vjet si kolegët e PgBouncer. Këtë funksion do të doja ta shihja në Odyssey.
Tani tani mund të krijoni një prepared statement në dy mënyra. Së pari, mund të ekzekutoni komandën SQL, që është "prepared". Për të kuptuar këtë komandë SQL, duhet të mësojmë të kuptojmë SQL nga ana e Bouncer. Do të ishte një overkill, sepse na nevojitet plotësisht një parser. Nuk mund të analizojmë çdo komandë SQL.
Por ka një prepared statement në nivelin e protokollit të mesazheve në proto3. Dhe kjo është ajo vend ku informacioni për krijimin e prepared statement vjen në një formë të strukturuar. Ne mund ta mbështesim kuptimin se në një lidhje serveri klienti kërkoi të krijojë prepared statements. Dhe edhe nëse transaksioni përfundoi, na duhet ende të mbajmë lidhshmërinë midis serverit dhe klientit.
Por këtu ndodhet një mosmarrëveshje në dialog, sepse dikush po flet për nevojën për të kuptuar se cili saktësisht prepared statements ka krijuar klienti dhe për të ndarë lidhjen e serverit midis të gjitha kliënteve që krijuan këtë lidhje serveri, pra ata që krijuan një prepared statement të tillë.
Andres Freund tha se nëse ju vjen një klient që tashmë ka krijuar një prepared statement në një lidhje tjetër serveri, atëherë krijoni atë për të. Por duket se është pak e gabuar të ekzekutoni kërkesat në bazë në vend të klientit, por nga këndvështrimi i zhvilluesit që shkruan protokollin e ndërveprimit me bazën, do të ishte e përshtatshme, nëse thjesht do t'i jepnin një lidhje rrjeti, në të cilën ka një kërkesë të tillë të përgatitur.
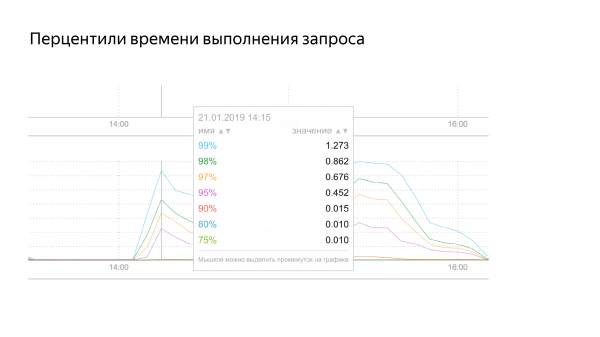
Dhe një veçori tjetër që duhet të implementojmë. Tani kemi monitorim, të përputhshëm me PgBouncer. Mund të kthejmë kohën mesatare të ekzekutimit të kërkesës. Por koha mesatare është temperatura mesatare në spital: dikush është i ftohtë, ndokush është i ngrohtë - në mesatare të gjithë janë të shëndetshëm. Kjo nuk është e vërtetë.
Na duhet të realizojmë mbështetje për percentiles që do të tregonin se ka kërkesa të ngadalta që konsumojnë burime dhe do ta bënin monitorimin më të pranueshëm.
Më e rëndësishmja – dua versionin 1.0 (Versioni 1.1 tashmë ka dalë). Çështja është se tani Odyssey ndodhet në versionin 1.0rc, pra release candidate. Dhe të gjithë problemet që përmenda ishin zgjidhur pikërisht me atë version, përveç memory leak.
Çfarë do të thotë për ne versioni 1.0? Ne po nxjerrim Odyssey në bazat tona. Ai tashmë funksionon në bazat tona, por kur të arrijë në pikën e 1,000,000 kërkesave në sekondë, mund të themi se kjo është versioni i lëshuar dhe mund të quhet 1.0.
Në komunitet disa njerëz kërkuan që në versionin 1.0 të ishin gjithashtu pauza dhe SCRAM. Por kjo do të thotë se do të na duhet të nxjerrim në prodhim versionin e ardhshëm, sepse as SCRAM dhe as pauza nuk janë fqinj në të njëjtën kohë. Megjithatë, shumë për së shumti, ky problem do të zgjidhet mjaft shpejt.
Po pres kërkesat tuaja. Dhe do të doja gjithashtu të dëgjoja se cilat probleme keni me Bouncer. Le të diskutojmë për to. Ndoshta mund të realizojmë disa funksione që ju nevojiten.
Me këtë përfundoj pjesën time, do doja të dëgjoja ju. Faleminderit!
Pyetje
Nëse vendos application_name tim, a do të kalojë siç duhet, përfshirë në pool-in e transaksioneve në Odyssey?
Në Odyssey apo në Bouncer?
Në Odyssey. Në Bouncer kalon.
Ne do të bëjmë set-in.
Dhe nëse lidhja ime e vërtetë do të kalojë në lidhje të tjera, a do të transferohet?
Ne do të bëjmë një set të të gjitha parametrave të renditur në listë. Nuk mund të them nëse në këtë listë ka application_name. Më duket se e kam parë atje. Ne do të vendosim të njëjtët parametra. Me një kërkesë atje set do të bëjë gjithçka që është vendosur nga klienti gjatë fillimit.
Faleminderit, Andrei, për raportin! Raport i mirë! Gëzohem që Odyssey po zhvillohet gjithnjë e më shpejt çdo minutë. Uroj që të vazhdoni kështu. Ne tashmë ju kemi kërkuar të keni lidhje multi data-source, në mënyrë që Odyssey të mund të lidhet njëkohësisht në baza të ndryshme të dhënash, dmth. master slave, dhe pastaj automatikisht pas një faillover të lidhet me një master të ri.
Po, më duket se e mbaj mend këtë diskutim. Aktualisht ka disa storage. Por nuk ka kalim mes tyre. Ne duhet të shqyrtojmë serverin në anën tonë, që ai të jetë ende në jetë dhe të kuptojmë se ka ndodhur një faillover, kush do ta thërrasë pg_recovery. Kam një mënyrë standarde për të kuptuar që nuk jemi në master. Dhe ne duhet ta kuptojmë ndonjëherë nga gabimet ose si? Pra, ideja është interesante, ajo është duke u diskutuar. Shkruani më shumë komente. Nëse keni duar të punës që dinë C, atëherë është fantastike.
Ne pyetje për skalimin me replikat na intereson gjithashtu, sepse dëshirojmë ta bëjmë pranimin e klastereve të replikuar sa më të lehtë për zhvilluesit e aplikacioneve. Por këtu do të donim më shumë komente, domethënë si të bëjmë saktësisht, si të bëjmë mirë.
Përsëri, kjo është një pyetje për replikat. Pra, keni një master dhe disa replika. Dhe është e qartë se në një replikë vini më rrallë se në master për lidhjet, sepse ato mund të kenë dallime. Ju keni thënë se dallimi në të dhëna mund të jetë i tillë, sa nuk do të plotësojë biznesin tuaj dhe nuk do të shkoni atje derisa të ri-replikohet. Nëse pas një kohe të gjatë, filloni të shkoni atje, të dhënat që ju nevojiten nuk do të jenë menjëherë të disponueshme. Pra, nëse vazhdimisht shkojmë në master, aty cache është ngrohur, ndërsa në replikë cache është pak prapa.
Po, është e vërtetë. Në pcache nuk do të ketë blloqe të dhënash që ju dëshironi, në real cache nuk do të ketë informacion rreth tabelave që ju dëshironi, në planet nuk do të ketë kërkesa të parseruara, në përgjithësi nuk do të ketë asgjë.
Dhe kur keni një klaster dhe shtoni një replikë të re, përderisa ajo starton, gjithçka është keq, domethënë ajo po ngre cache-in e saj.
E kuptova idenë. Qasja e duhur do të ishte të filloni një përqindje të vogël të kërkesave fillimisht në replikë, të cilat do të ngrohin cache-in. Thjesht, kemi një kusht që duhet të jemi më shumë se 10 sekonda prapa masterit. Dhe ky kusht të aktivizohet jo me një valë, por gradualisht për disa klientë.
Po, rritni peshën.
Kjo është një ide e mirë. Por fillimisht duhet të implementojmë këtë çaktivizim. Fillimisht duhet të fikemi, pastaj do të mendojmë se si të ndizemi. Kjo është një karakteristikë e shkëlqyer për të u ngjitur gradualisht.
Në nginx ekziston një opsion të tillë fillimisht ngadalë nis në klasterin për serverin. Dhe ai gradualisht ndihmon në rritjen e ngarkesës.
Po, një ide e shkëlqyer, do ta provojmë kur të arrijmë aty.
Burimi: habr.com
