

Aloha, everyone! My name is Oleg Anastasyev, and I work at Odnoklassniki in the Platform team. Besides me, there is a lot of hardware at Odnoklassniki. We have four data centers, which house about 500 racks with over 8 thousand servers. At some point, we realized that implementing a new management system would allow us to utilize the equipment more efficiently, simplify access management, automate the (re)distribution of computing resources, speed up the launch of new services, and accelerate responses to large-scale failures.
So, what did we achieve from this?
In addition to myself and the hardware, there are also people who work with this hardware: engineers who are directly in the data centers; network specialists who configure the networking equipment; admins, or SREs, who ensure the reliability of the infrastructure; and development teams, each responsible for part of the portal's functionalities. The software they create operates somewhat like this:
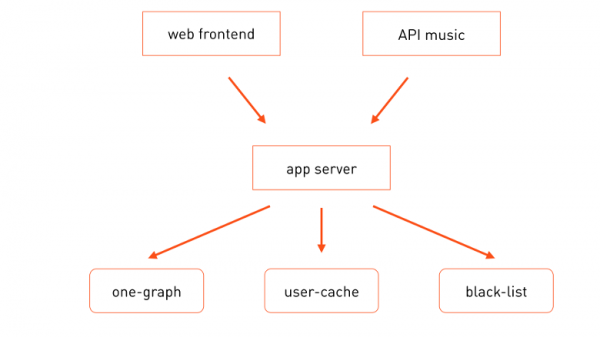
User requests come to both the frontend of the main portal , as well as to others, for example, the music API frontends. They call an application server to handle the business logic, which, during the processing of the request, invokes the necessary specialized microservices — one-graph (graph of social connections), user-cache (cache of user profiles), and so on.
Each of these services is deployed on multiple machines, and each has responsible developers who oversee the functioning of the modules, their operation, and technological development. All these services run on physical servers, and until recently, we would launch exactly one task per server, meaning it was specialized for a specific task.
Why is that? This approach had several advantages:
- It simplifies mass management. Suppose a task requires certain libraries and configurations. Then the server is assigned to a specific group, and a cfengine policy for this group is described (or it is already described), and this configuration is centrally and automatically deployed across all servers in that group.
- It simplifies diagnostics. Le të supozojmë se po shikoni një ngarkesë të rritur të procesorit qendror dhe e kuptoni se kjo ngarkesë mund të jetë gjeneruar vetëm nga ajo detyrë që po punon në këtë procesor hardware. Kërkimi i fajtorëve përfundon shumë shpejt.
- It simplifies monitorimi. Nëse ka diçka që nuk shkon me serverin, monitori njofton për këtë, dhe ju e dini saktësisht se kush është fajtor.
Shërbimi i përbërë nga disa replica, i cakton disa servera — një për secilën. Atëherë burimi llogaritës për shërbimin ndahen shumë thjeshtë: sa më shumë servera ka shërbimi, aq më shumë burime ai mund të konsumojë maksimalisht. "Thjeshtë" këtu nuk është në kuptimin se është e lehtë për t'u përdorur, por se ndarja e burimeve ndodh manualisht.
Ky qasje gjithashtu na lejon të krijojmë konfiguracione të specializuara të hardware për detyrat që ekzekutohen në këtë server. Nëse detyra mban volumes të mëdha të dhënash, atëherë ne përdorim një server 4U me shasi për 38 disqe. Nëse detyra është thjesht llogaritëse, mund të blejmë një server 1U më të lirë. Kjo është efikase në raport me burimet llogaritëse. Kështu, ky qasje na lejon të përdorim katër herë më pak makina për ngarkesë që është e ngjashme me një rrjet social që na është miqësor.
Kjo efikasitet në përdorimin e burimeve llogaritëse duhet të sigurojë gjithashtu efikasitet ekonomik, nëse e marrim parasysh premisën se më e shtrenjta janë serverat. Për një kohë të gjatë, më e shtrenjtë ka qenë pikërisht hardware-i, dhe ne kemi investuar shumë në uljen e kostos së hardware-it, duke krijuar algoritmo për sigurimin e qëndrueshmërisë për të ulur kërkesat për besueshmërinë e pajisjeve. Dhe sot kemi arritur në një fazë ku kostoja e serverit nuk është më përcaktuese. Nëse nuk e marrim parasysh eksotikun më të fundit, konfigurimi specifik i serverëve në raft nuk ka rëndësi. Tani na ka lindur një problem tjetër - çmimi i hapësirës së mbajtur nga serveri në qendrën e të dhënave, pra, hapësira në raft.
Duke kuptuar se kjo është kështu, ne vendosëm të llogarisim se sa efikasisht po përdorim raftet.
Kemi marrë çmimin e serverit më të fuqishëm nga një këndvështrim ekonomik, llogaritëm se sa nga këta serverë mund të vendosnim në raftet e serverëve, sa detyra do të nisnim në bazë të modelit të vjetër "një server = një detyrë" dhe sa detyra do të ishin në gjendje të përdornin pajisjet. Llogaritëm dhe u emocionuam. Doli se efikasiteti i përdorimit të raftit ishte rreth 11%. Konkluzioni është i qartë: duhet të rritet efikasiteti i përdorimit të qendrave të të dhënave. Mund të duket si një zgjidhje e qartë: duhet të fillojmë disa detyra në një server të vetëm. Por këtu fillojnë vështirësitë.
Konfigurimi masiv komplikohet ndjeshëm — tani është e pamundur të caktohet një grup i vetëm serverit. Sepse tani në një server mund të jenë të nisura disa detyra nga skuadra të ndryshme. Për më tepër, konfigurimi mund të jetë në konflikt për aplikacione të ndryshme. Diagnostikimi gjithashtu komplikohet: nëse shihni një rritje të konsumit të procesorëve ose disqeve në server, nuk e dini se cila nga detyrat po shkakton probleme.
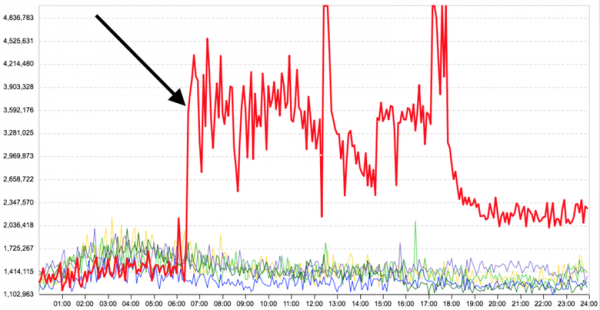
Por e rëndësishmja është se mes detyrave, të nisura në një makinë, nuk ka izolim. Për shembull, grafiku i mesatarit të kohës së përgjigjes për një detyrë në server para dhe pas nisjes së një aplikacioni tjetër, të pa lidhur me të parin — koha e marrjes së përgjigjes për detyrën kryesore është rritur ndjeshëm.
Qartë, duhet të nisnim detyrat ose në kontejnerë, ose në makina virtuale. Duke qenë se pothuajse të gjitha detyrat tona nisin nën menaxhimin e një sistemi operativ (Linux) ose janë përshtatur për të, mbajtja e shumë sistemeve operative të ndryshme nuk është e nevojshme. Prandaj, virtualizimi nuk është i nevojshëm, për shkak të shpenzimeve shtesë ai do të jetë më pak efikas se kontejnerizimi.
Si një realizim i konteinerëve për të ekzekutuar detyra drejtpërdrejt në serverët Docker — është një kandidat i mirë: imazhet e sistemeve të skedarëve zgjidhin mirë problemet me konfigurimet në konflikt. Ajo që imazhet mund të përbëhen nga disa nivele na lejon të zvogëlojmë ndjeshëm volumet e të dhënave që nevojiten për vendosjen e tyre në infrastrukturë, duke ndarë pjesët e përbashkëta në nivele themelore të veçanta. Atëherë nivelet themelore (dhe më të mëdhatë) do të cache-ohen mjaft shpejt në të gjithë infrastrukturën, dhe për të dorëzuar një shumëllojshmëri aplikacionesh dhe versionesh, do të jetë e nevojshme të dërgohen vetëm nivele të vogla.
Plus, regjistri i gatshëm dhe etiketimi i imazheve në Docker na japin primitivë të gatshëm për versionim dhe dorëzim të kodit në production.
Docker, si çdo teknologji tjetër e ngjashme, na ofron një nivel të caktuar izolimi të konteinerëve nga kuti. Për shembull, izolimi i memories — çdo kontejner merr një kufi për përdorimin e memories së makinës, përtej të cilit nuk do ta konsumojë. Gjithashtu, mund të izoloheshin konteinerët për përdorimin e CPU-së. Sidoqoftë, për ne, izolimi standard ishte i pamjaftueshëm. Por për këtë — më poshtë.
Ekzekutimi i drejtpërdrejtë i konteinerëve në serverë është vetëm një pjesë e problemeve. Një pjesë tjetër lidhet me vendosjen e konteinerëve në serverë. Duhet të kuptojmë se cili kontejner mund të vendoset në cilin server. Kjo nuk është një detyrë e thjeshtë, sepse konteinerët duhet të vendosen në serverë sa më ngushtë të jetë e mundur, pa ulur shpejtësinë e punës së tyre. Kjo vendosje mund të jetë e komplikuar dhe në aspektin e disponueshmërisë. Shpesh ne duam të vendosim replika të njëjtit shërbim në raftet e ndryshme ose madje në sallat e ndryshme të qendrës së të dhënave, në mënyrë që në rast të disfatës së raftit ose sallës, të mos humbasim të gjitha replikat e shërbimit menjëherë.
Derdhja e konteinerëve me dorë — nuk është një opsion, kur ke 8 mijë serverë dhe 8—16 mijë konteinerë.
Përveç kësaj, ne donim t'u japim zhvilluesve më shumë autonomi në shpërndarjen e burimeve, në mënyrë që të mund të vendosnin shërbimet e tyre në production, pa ndihmën e administratorit. Në të njëjtën kohë, donim të ruanim kontrollin, në mënyrë që ndonjë shërbim dytësor të mos konsumonte të gjithë burimet e qendrave tona të të dhënave.
Qartë është se na nevojitet një shtresë menaxhuese, e cila do merret automatikisht me këto.
Ja kemi në një imazh të thjeshtë dhe të qartë, të cilin e adhurojnë të gjithë arkitektët: tre katrorë.
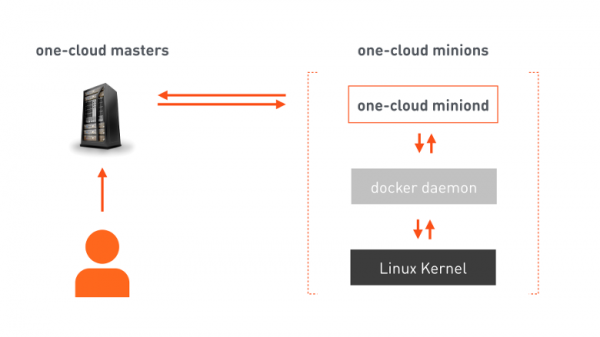
one-cloud masters — një klaster i besueshëm që është përgjegjës për orkestrimin e cloud-it. Zhvilluesi dërgon në master një manifest, në të cilin përmban të gjitha informacionet e nevojshme për vendosjen e shërbimit. Masteri, mbi këtë bazë, jep komanda minjoneve të zgjedhura (makinave të destinuara për të drejtuar kontejnerët). Në minjone ka agjentin tonë, i cili merr komandën, i jep komandat e tij Docker-it dhe Docker-i konfiguron kernelin linux për të ndezur kontejnerin përkatës. Përveç ekzekutimit të komandave, agjenti vazhdimisht i raporton masterit për ndryshimet në gjendjen e minjoneve dhe kontejnerëve të ndezur mbi to.
Shpërndarja e burimeve
Tani le të merremi me detyrën e shpërndarjes më të ndërlikuar të burimeve për shumë minjone.
Burimi llogaritës në one-cloud është:
- Kapaciteti llogaritës i procesorit, i konsumuar nga një detyrë specifike.
- Sasia e memories, e disponueshme për detyrën.
- Trafiku i rrjetit. Çdo minjon ka një interfaks të caktuar rrjeti me një kapacitet të kufizuar, kështu që nuk mund të shpërndahen detyra pa marrë parasysh sasinë e të dhënave që kalohen përmes rrjetit.
- Diskët. Përveç, natyrisht, vendit për të dhënat e detyrës, ne gjithashtu caktuam llojin e diskut: HDD ose SSD. Diskët mund të shërbejnë një numri të caktuar kërkesash në sekondë — IOPS. Prandaj, për detyrat që gjenerojnë më shumë IOPS sesa mund të shërbejë një disk, ne gjithashtu caktuam "spindles" — dmth. disa pajisje disku që duhet të rezervohen ekskluzivisht për detyrën.
Atëherë për ndonjë shërbim, për shembull për user-cache, ne mund ta shkruajmë konsumin e burimeve në këtë mënyrë: 400 bërthama procesori, 2.5 TByte memorie, 50 Gbit/s trafik në të dy drejtimet, 6 TByte hapësirë në HDD, e vendosur në 100 spindles. Ose në një formë më të njohur për ne kështu:
alloc:
    cpu: 400
    mem: 2500
    lan_in: 50g
    lan_out: 50g
    hdd:100x6T
Burimet e shërbimit user-cache konsumojnë vetëm një pjesë të gjitha burimeve të disponueshme në infrastrukturën e prodhimit. Prandaj, dëshirojmë të bëjmë në mënyrë që, papritur, për shkak të një gabimi nga operatori ose jo, user-cache të mos konsumojë më shumë burime se sa i janë caktuar. Kështu, ne duhet të limitojmë burimet. Por çfarë mund të lidhim me kuotën?
Le të kthehemi në skemën tonë të thjeshtuar të bashkëpunimit të komponentëve dhe ta rrisim atë me më shumë detaje — kështu:
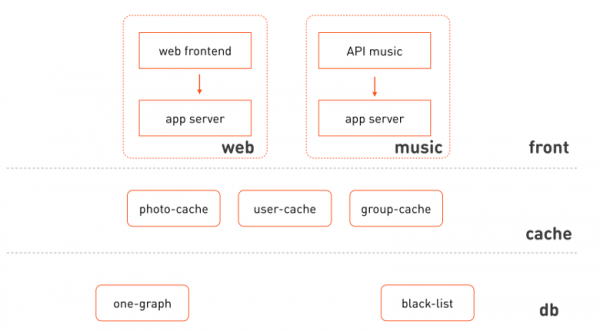
Çfarë bie në sy:
- Frontend-i i uebit dhe muzika përdorin klastere izoluese të së njëjtës server aplikacionesh.
- Mund të dallojmë nivele logjike, të cilat përfshijnë këto klastere: frontet, cache-t, niveli i ruajtjes dhe menaxhimit të të dhënave.
- Frontend-i është i ndryshëm, janë në sistemet funksionale të ndryshme.
- Cache-t gjithashtu mund të shpërndahen nëpër nën-sistemin, të dhënat të cilat ato i ruajnë.
Le të rrisim përsëri figurën:
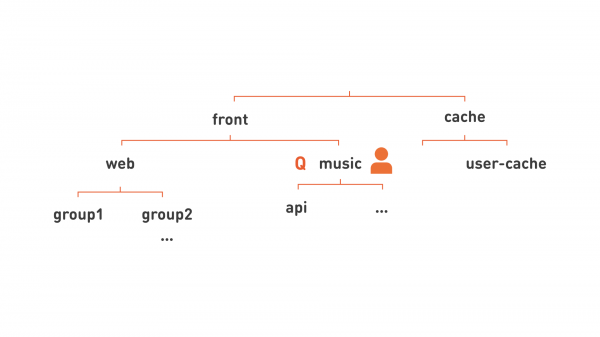
Ooo! Ne shohim një hierarki! Kjo do të thotë se mund të ndajmë burimet më shpesh: të caktojmë një zhvillues përgjegjës për një nyje të kësaj hierarkie, përkatësisht për nën-sistemin funksional (si ‘music’ në figurë), dhe ky nivel hierarkie do të lidhet me kuotën. Kjo hierarki gjithashtu na lejon të organizojmë shërbime më fleksibël për një menaxhim më të lehtë. Për shembull, të gjithë web, pasi është një grumbull shumë i madh serverësh, e ndajmë në disa grupe më të vogla, të cilat paraqiten në figurë si group1, group2.
Duke hequr vijat e tepërta, mund të shkruajmë çdo nyje të figurës sonë në një formë më të sheshtë: group1.web.front, api.music.front, user-cache.cache.
Kështu arrijmë te koncepti i ‘radhës hierarkike’. Ajo ka emrin, si ‘group1.web.front’. Për të caktohet një kuotë për burimet dhe të drejtat e përdoruesve. Një person nga DevOps do t'i japë të drejtat për të dërguar shërbimin në radhë, dhe ky punonjës mund të fillojë diçka në radhë, ndërsa një person nga OpsDev do të ketë të drejta administrimi, dhe tani ai mund të menaxhojë radhën, t'u caktojë njerëz, t'u japë këtyre njerëzve të drejta etj. Shërbimet e filluara në këtë radhë do të ekzekutohen brenda kuotës së radhës. Nëse kuota kompjuterike e radhës nuk është e mjaftueshme për të ekzekutuar të gjitha shërbimet njëkohësisht, ato do të ekzekutohen një nga një, duke formuar kështu pikërisht radhën.
Të shqyrtojmë shërbimet më në detaje. Një shërbim ka një emër të plotë, i cili gjithmonë përfshin emrin e radhës. Atëherë shërbimi i frontend-it të web do të ketë emrin ok-web.group1.web.front. Ndërsa shërbimi i serverit të aplikacioneve, me të cilin ai lidhet, do të emërohet ok-app.group1.web.frontÇdo shërbim ka një manifest, në të cilin përcaktohen të gjitha informacionet e nevojshme për vendosjen në makinat përkatëse: sa burime konsumon kjo detyrë, çfarë konfigure i nevojitet, sa kopje duhet të jenë, vetitë për përballimin e dështimeve të këtij shërbimi. Dhe pas vendosjes së shërbimit në makinat, shfaqen instancat e tij. Ato emërtohen gjithashtu në mënyrë unike — si numri i instancës dhe emri i shërbimit: 1.ok-web.group1.web.front, 2.ok-web.group1.web.front, …
Kjo është shumë e dobishme: duke parë vetëm emrin e enjtës së nisur, ne mund të zbulojmë shumë.
Tani le të njiheni më afër me atë që këto instanca, në të vërtetë, bëjnë: me detyrat.
Klasa e izolimit të detyrave
Të gjitha detyrat në OK (dhe ndoshta kudo) mund të ndahen në grupe:
- Detyrat me vonesë të shkurtër — prodhimi. Për këto detyra dhe shërbime, vonesa e përgjigjes (latencija) është shumë e rëndësishme, sa shpejt çdo kërkesë do të përpunojë sistemi. Shembuj të detyrave: frontet web, cache, serverët e aplikacioneve, depozitat OLTP dhe kështu me radhë.
- Detyrat e llogaritjes — grumbuj. Këtu shpejtësia e përpunimit të çdo kërkese të veçantë nuk është e rëndësishme. E rëndësishme është sa llogaritje gjithsej për një (të madh) interval kohor kjo detyrë do të bëjë (shpejtësia). Këto do të jenë çdo detyrë MapReduce, Hadoop, mësimi i makinerisë, statistika.
- Detyrat anësore — papunë. Për këto detyra as latency as shpejtësia nuk janë shumë të rëndësishme. Këtu përfshihen teste të ndryshme, migrime, llogaritje, konvertime të të dhënave nga një format në atë tjetër. Nga njëra anë, ato duken si detyrat e llogaritjes, nga ana tjetër — nuk është shumë e rëndësishme se sa shpejt do të përfundojnë.
Le të shikojmë si konsumojnë këto detyra burime, për shembull, të procesorit qendror.
Detyrat me vonesë të shkurtër. Një detyrë e tillë do të ketë një model konsumi të CPU-së si ky:
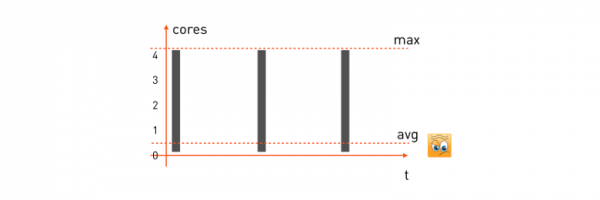
Kërkesa vije nga përdoruesi, detyra fillon të përdorë të gjitha bërthamat e disponueshme të CPU-së, përfundon, kthen një përgjigje, pret kërkesën tjetër dhe qëndron. Vjen kërkesa tjetër — përsëri dëgjohen të gjitha ato që ishin, përpunohen, presim kërkesën tjetër.
Për të garantuar vonesën minimale për një detyrë të tillë, ne duhet të marrim maksimumin e burimeve të konsumuar prej saj dhe të rezervojmë numrin e nevojshëm të bërthamave në minjon (makina që do të kryejë detyrën). Atëherë formula e rezervimit për detyrën tonë do të jetë si kjo:
alloc: cpu = 4 (maks)Dhe nëse kemi një server mini me 16 bërthama, atëherë mund të vendosim pikërisht katër nga këto detyra. Shënoni se konsumi mesatar i procesorit për këto detyra shpesh është shumë i ulët — çka është e qartë, pasi një pjesë të madhe të kohës detyra është në pritje të një kërkese dhe nuk bën asgjë.
Detyrat e llogaritjes. Ato do të kenë një model paksa ndryshe:
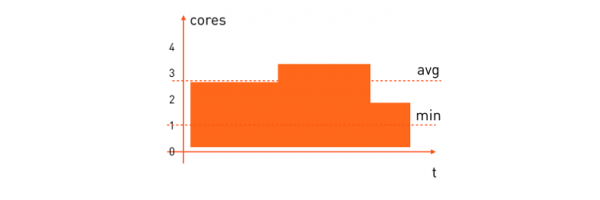
Konsumi mesatar i burimeve të procesorit për këto detyra është mjaft i lartë. Shpesh ne duam që detyra e llogaritjes të përfundojë brenda një kohe të caktuar, prandaj duhen rezervuar numrin minimal të procesorëve që i nevojiten asaj, në mënyrë që llogaritja të përfundojë brenda një kohe të pranueshme. Formula e saj për rezervimin do të duket kështu:
alloc: cpu = [1,*)«Të lutem, vendose në mini, ku ka të paktën një bërthamë të lirë, dhe pastaj gjithçka që ka mbetur — do ta konsumojë».
Këtu efikasiteti i përdorimit është tashmë ndjeshëm më i mirë se për detyrat me vonesë të shkurtër. Por fitimi do të jetë shumë më i madh nëse kombinojmë të dyja llojet e detyrave në një server mini dhe shpërndajmë burimet e saj në lëvizje. Kur detyra me vonesë të shkurtër kërkon procesorin — ajo e merr atë menjëherë, dhe kur burimet nuk janë më të nevojshme — ato i kalohen detyrës së llogaritjes, pra, diçka si kjo:
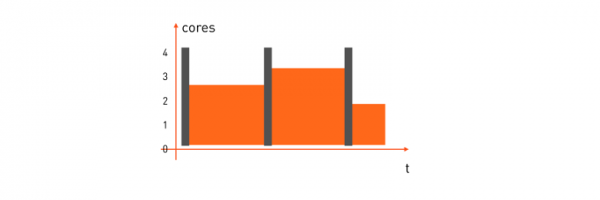
Por si ta bëjmë këtë?
Së pari, le të kuptojmë prodhimin dhe alloc: cpu = 4. Na duhen katër bërthama të rezervuara. Në Docker run, kjo mund të bëhet në dy mënyra:
- Me opsionin
--cpuset=1-4, dmth. të alokosh katër bërthama të caktuara për detyrën në server. - Përdorni
--cpuquota=400_000 --cpuperiod=100_000, të caktosh një kuotë për kohën e procesorit, dmth. të tregosh se për çdo 100 ms të kohës reale detyra konsumon jo më shumë se 400 ms të kohës së procesorit. Kështu, arrijmë të njëjtat katër bërthama.
Por cili nga këto mënyra i përshtatet?
Duket mjaft tërheqëse cpuset. Detyra ka katër bërthama të dedikuara, kështu që caches e procesorëve do të punojnë sa më efikashtë. Kjo ka dhe anën e saj të errët: do të na duhej të merrnim përsipër shpërndarjen e llogaritjeve për bërthamat e papopulluara të makinës në vend të OS-së, gjë që është një detyrë mjaft e ndërlikuar, veçanërisht nëse përpiqemi të vendosim detyrat batch në një makinë të tillë. Testet treguan se opsioni me kuotë përshtatet më mirë këtu: kështu që sistemi operativ ka më shumë liri në zgjedhjen e bërthamës për ekzekutimin e detyrës në momentin aktual dhe koha e procesorit shpërndahet më efikasht.
Le të shohim si të bëjmë rezervë në docker me numrin minimal të bërthamave. Kuota për detyrat batch tashmë nuk është e përdorshme, sepse nuk është e nevojshme të kufizohet maksimumi, mjafton të garantohet minimumi. Dhe këtu përshtatet mirë opsioni docker run --cpushares.
Kemi rënë dakord që nëse batch kërkon garanci minimale për një bërthamë, atëherë ne tregojmë --cpushares=1024, dhe nëse minimumi është për dy bërthama, atëherë tregojmë --cpushares=2048. Cpu shares nuk ndihmojnë në shpërndarjen e kohës së procesorit deri sa ajo të mjaftojë. Kështu, nëse prodhimi nuk përdor të katra bërthamën e tij, asgjë nuk e kufizon detyrat batch dhe ato mund të përdorin kohë shtesë të procesorit. Por në rastin kur ka mungesë procesori, nëse prodhimi ka konsumuar të katër bërthatë dhe ka arritur kuotën, koha e mbetur e procesorit do të ndahet proporcionalisht sipas cpushares, dmth. në situatën me tre bërthama të lira, njëra do ta marrë detyra me 1024 cpushares, dhe dy të tjera do ta marrin detyra me 2048 cpushares.
Por përdorimi i kuotës dhe aksioneve nuk është mjaft. Na nevojitet që detyra me vonesë të shkurtër të ketë përparësi mbi detyrën batch gjatë shpërndarjes së kohës së procesorit. Pa një përprioritizim të tillë, detyra batch do të marrë të gjitha kohën e procesorit në momentin kur ajo nevojitet për prodhim. Në Docker run nuk ka opsione të përprioritizimit të konteinerëve, por ndihmohen nga politikashin e planifikuesit të procesorëve në Linux. Mund të lexoni më shumë për to , dhe në këtë artikull ne do të kalojmë për to shkurtimisht:
- SCHED_OTHER
Fillimisht marrin të gjithë proceset normale të përdoruesve në një makinë Linux. - SCHED_BATCH
E përshtatur për procese kërkuese për burime. Kur vendoset një detyrë në procesor, hyn një ndëshkim i quajtur aktivizim: një detyrë e tillë me probabilitet të vogël do të marrë burime nga procesori, nëse në atë moment po përdoret nga një detyrë me SCHED_OTHER. - SCHED_IDLE
Një proces i sfondit me prioritet shumë të ulët, edhe më të ulët se nice –19. Ne përdorim bibliotekën tonë me kod të hapur. , për të vendosur politikën e nevojshme gjatë lançimit të kontejnerit përmes thirrjes.
one.nio.os.Proc.sched_setscheduler( pid, Proc.SCHED_IDLE )Por edhe nëse nuk programoni në Java, të njëjtën gjë mund ta bëni me komandën chrt:
chrt -i 0 $pidDo t'i përmbledhim të gjitha nivelet tona të izolimit në një tabelë për qartësi:
Klasa e izolimit
Shembulli alloc
Opsionet Docker run
sched_setscheduler chrt*
Prod
cpu = 4
--cpuquota=400000 --cpuperiod=100000
SCHED_OTHER
Batch
Cpu = [1, * )
--cpushares=1024
SCHED_BATCH
Përgjithësisht
Cpu= [2, *)
--cpushares=2048
SCHED_IDLE
*Nëse bëni chrt nga brenda kontejnerit, mund të nevojitet kapaciteti sys_nice, sepse në mënyrë të paracaktuar Docker e heq këtë kapacitet gjatë lançimit të kontejnerit.
Por detyrat nuk konsumojnë vetëm procesorin, por gjithashtu trafikun, i cili ndikon në vonesën e detyrave rrjetërore edhe më shumë se shpërndarja e gabuar e burimeve të procesorit. Prandaj, natyrisht, duam të kemi një pamje të njëjtë edhe për trafikun. Kjo do të thotë, kur detyra prodhimi dërgon disa paketa në rrjet, ne caktuar shpejtësinë maksimale (formula alloc: lan=[*,500mbps) ), me të cilën prodhimi mund ta bëjë këtë. Dhe për batch ne garantojmë vetëm kapacitetin minimal, por nuk e kufizojmë maksimalin (formula alloc: lan=[10Mbps,*) ) Në këtë rast, trafiku prodhim duhet të ketë prioritet mbi detyrat batch.
Këtu Docker nuk ka asnjë primitiv që mund të përdorim. Por na vjen në ndihmë . Ne arritëm rezultatet e dëshiruara përmes disiplinës . Me ndihmën e saj, ne ndajmë dy klasa trafiku: prodhimi me prioritet të lartë dhe batch/i papunë me prioritet të ulët. Si rezultat, konfigurimi për trafikun e daljes është kjo:
këtu 1:0 — «qdisc rrënjësor» i disiplinës hsfc; 1:1 — klasa nënpunës hsfc me një kufi të përgjithshëm të kapacitetit prej 8 Gbit/s, nën të cilën vendosen klasat nënpunëse të të gjithë konteinerëve; 1:2 — klasa nënpunës hsfc e cila është e përbashkët për të gjitha detyrat batch dhe idle me një limit «dinamik», për të cilin do të flasim më poshtë. Klasa të tjera nënpunës hsfc janë klasa të dedikuara për konteinerët prodhues që punojnë aktualisht me kufij që përkojnë me manifestet e tyre, — 450 dhe 400 Mbit/s. Çdo klasë hsfc ka një radhë qdiscip fq ose fq_codel, në varësi të versionit të kernelit linux, për të shmangur humbjet e pacjeve gjatë shpërthimeve të trafikut.
Zakonisht disiplinat tc shërbejnë për të prioritarizuar vetëm trafikun e daljes. Por ne duam të prioritarizojmë edhe trafik hyrës — sepse ndonjë detyrë batch mund të zgjedhë lehtësisht të gjithë kanalin hyrës, duke marrë, për shembull, një paketë të madhe të të dhënave hyrëse për map&reduce. Për këtë ne përdorim modulin , i cili krijon një ndërfaqe virtuale ifbX për çdo ndërfaqe rrjeti dhe ndihmon në ridrejktimin e trafikut hyrës nga ndërfaqja në daljen për ifbX. Më pas për ifbX funksionojnë të gjitha ato disiplinat për kontrollin e trafikut të daljes, për të cilat konfigurimi hsfc do të jetë shumë i ngjashëm:
Gjatë eksperimenteve, zbuluam se rezultatet më të mira hsfc shfaqen kur klasa 1:2 e trafikut batch/idle pa prioritet kufizohet në makinat-minion jo më shumë se deri në një bandë të lirë. Në të kundërt, trafiku pa prioritet ndikon shumë në vonesat e detyrave prodhuese. Vlera aktuale e bandës së lirë miniond përcaktohet çdo sekondë, duke matur mesataren e konsumit të trafikut nga të gjitha detyrat prodhuese të këtij minioni  dhe duke e zbritur atë nga kapaciteti i ndërfaqes rrjetit
 me një rezervë të vogël, dmth.

Banda përcaktohet për trafikun hyrës dhe dalës në mënyrë të pavarur. Dhe në përputhje me vlerat e reja, miniond rindërton limitin e klasës pa prioritet 1:2.
Kështu kemi realizuar të tri klasat e izolimit: prod, batch dhe idle. Këto klasa ndikon shumë në karakteristikat e ekzekutimit të detyrave. Prandaj vendosëm që ta vendosim këtë tipar në majë të hierarkisë, në mënyrë që në një shikim mbi emrin e radhës hierarkike të kuptohet menjëherë me çfarë kemi të bëjmë:
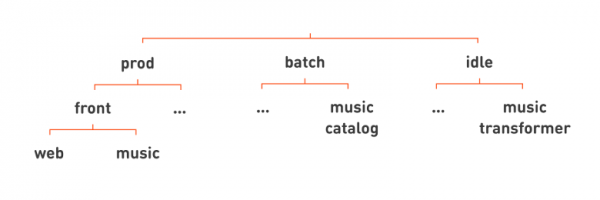
Të gjitha frontet tona të njohura web dhe music atëherë vendosen në hierarki nën prod. Për shembull, nën batch le të vendosim shërbimin music catalog, i cili her pas krijon një katalog këngësh nga një grup skedash mp3 të ngarkuara në «Odnoklassniki». Një shembull shërbimi nën idle mund të jetë transformuesi muzikor, i cili normalizon nivelin e volumit të muzikës.
Me heqjen e vijave të panevojshme, ne mund ta shkruajmë emrin e shërbimeve tona më të sheshta, duke shtuar klasën e izolimit të detyrës në fund të emrit të plotë të shërbimit: web.front.prod, catalog.music.batch, transformer.music.idle.
Dhe tani, duke e parë emrin e shërbimit, ne kuptojmë jo vetëm se çfarë funksioni kryen, por edhe klasën e tij të izolimit, dhe për këtë arsye, kritikësinë e tij, etj.
Gjithçka është e shkëlqyer, por ka një të vërtetë të hidhur. Izolimi i plotë i detyrave që funksionojnë në një makinë është i pamundur.
Ajo çfarë arritëm: nëse batch konsumon shumë të burime të procesorit, atëherë planifikuesi i integruar i CPU Linux e bën shumë mirë punën e tij, dhe ndikimi në detyrën prod është praktikisht i padukshëm. Por nëse kjo detyrë batch fillon të punojë aktivisht me memorien, atëherë ndikimi ndërmjet tyre fillon të shfaqet. Kjo ndodh sepse te detyra prod ‘hiqen’ cache-t e procesorit nga memoria — si rezultat, rriten humbjet në cache, dhe procesori e përpunon detyrën prod më ngadalë. Një detyrë e tillë batch mund të rrisë vonesat e kontejnerit tonë tipik prod me 10%.
Izolimi i trafikut është edhe më i komplikuar për shkak se kartat moderne të rrjetit kanë një radhë të brendshme paketash. Nëse një paketë nga detyra batch arrin aty e para, atëherë ajo do të dërgohet e para nëpër kabllin, dhe këtu s’ka çfarë të bësh.
Përveç kësaj, deri tani kemi arritur të zgjidhim vetëm detyrën e prioritetizimit të trafikut TCP: për UDP, qasja me hsfc nuk funksionon. Dhe madje në rastin e trafikut TCP, nëse detyra batch gjeneron shumë trafik, kjo gjithashtu jep rreth 10% rritje të vonesës së detyrës prod.
Qëndrueshmëri
Një nga qëllimet gjatë zhvillimit të one-cloud ishte përmirësimi i qëndrueshmërisë së Odnoklassniki. Prandaj, më pas do të doja të shqyrtoj skenaret e mundshme të dështimeve dhe fatkeqësive. Le të fillojmë me një skenar të thjeshtë — me dështimin e kontejnerit.
Kontejneri mund të dështojnë në disa mënyra. Kjo mund të jetë një eksperiment, një gabim ose një problem në manifest, që bën që detyra prodhuese të konsumojë më shumë burime se ç'është përcaktuar në manifest. Kemi pasur një rast: një zhvillues implementoi një algoritëm të komplikuar, e rishikoi atë shumë herë, e komplikoi vetveten dhe u ngatërrua deri sa në fund detyra filloi të humbiste rreth. Dhe për shkak se detyra prodhuese ka përparësi mbi të gjitha të tjerat në këto minj, ajo filloi të konsumonte të gjitha burimet e disponueshme të procesorit. Në këtë situatë, izolimi ndihmoi, ose më saktë, kuota e kohës së procesorit. Nëse detyrës i është caktuar një kuotë, ajo nuk do të konsumojë më shumë. Prandaj, detyrat e lotit dhe të tjera prodhuese që punonin në të njëjtën makinë nuk vunë re asgjë.
Një problem tjetër i mundshëm është rënia e konteinerit. Dhe këtu na shpëtojnë politikat e rikthimit, të cilat të gjithë i njohin, Docker përballohet shkëlqyeshëm me këtë. Praktikisht të gjitha detyrat prodhuese kanë një politikë rikthimi gjithmonë. Ndonjëherë përdorim on_failure për detyrat e lotit ose për rikthimin e konteinerëve prodhues.
Por çfarë mund të bëjmë kur një minjë e tërë është e paqëndrueshme?
Sigurisht, mund të nisim një kontejner në një makinë tjetër. Gjëja më interesante këtu është se çfarë ndodh me adresat IP (adresat), që i janë caktuar kontejnerit.
Ne mund të caktojmë kontejnerëve të njëjtat adresa IP si ato të makinave-minj, ku këta kontejnerë po nisin. Pastaj, kur kontejneri nis në një makinë tjetër, adresa e tij IP ndryshon, dhe të gjithë klientët duhet të kuptojnë se kontejneri ka shpërngulur, tani duhet të shkojnë në një adresë tjetër, e cila kërkon një shërbim të veçantë të Zbulimit të Shërbimeve.
Zbulimi i Shërbimeve është i këndshëm. Në treg ka shumë zgjidhje të niveleve të ndryshme të besueshmërisë për organizimin e regjistrit të shërbimeve. Shpesh në këto zgjidhje implementohet logjika e balancuesit të ngarkesës, ruajtja e konfigurimeve të tjera në formë të ruajtjes KV etj.
Megjithatë, ne do të preferonim të ishim pa nevojën për të implementuar një regjistër të veçantë, sepse kjo do të nënkuptonte hyrjen e një sistemi kritik, i cili përdoret nga të gjitha shërbimet në prodhim. Dhe kjo do të thoshte se është një pikë e mundshme dështimi, dhe duhet të zgjidhni ose të zhvilloni një zgjidhje shumë të besueshme, e cila, është e qartë, është shumë e komplikuar, e gjatë dhe e shtrenjtë.
Një tjetër mangësi e madhe është se për ta bërë infrastrukturën tonë të vjetër të funksionojë me të re, do të duhej të rishkruanim çdo detyrë për t'u përshtatur me ndonjë sistem të Zbulimit të Shërbimeve. Ka shumë punë, madje në disa raste është e pamundur, sidomos kur flitet për pajisje të nivelit të ulët që funksionojnë në nivelin e bërthamës së sistemit operativ ose direkt me harduerin. Realizimi i kësaj funksionaliteti me anë të modeleve të njohura të zgjidhjeve, si p.sh. do të nënkuptonte ndonjëherë ngarkesë shtesë, ndonjëherë - komplikim në operacione dhe skenarë të tjerë dështimi. Ne nuk dëshironim ta komplikonim këtë, prandaj vendosëm që përdorimi i Zbulimit të Shërbimeve të ishte opsional.
Në one-cloud, IP-ja i ndjek kontejnerin, domethënë çdo instancë e detyrës ka adresën e saj të vetme IP. Kjo adresë është "statike": ajo përfshihet për çdo instancë në momentin e parë të aktivizimit të shërbimit në cloud. Nëse gjatë jetës së shërbimit ka pasur një numër të ndryshëm instancash - atëherë në përfundim do të ketë aq shumë adresa IP sa instanca maksimale që kanë ekzistuar.
Pas kësaj, këto adresa nuk ndryshojnë: ato i janë caktuar një herë dhe vazhdojnë të ekzistojnë gjatë gjithë jetës së shërbimit në prodhim. Adresat IP i ndjekin kontejnerët përmes rrjetit. Nëse një kontejner transferohet në një minion tjetër, atëherë adresa do të kalojë gjithashtu pas tij.
Kështu, përputhja e emrit të shërbimit me listën e adresave të tij IP ndryshon shumë rrallë. Nëse herë tjetër shohim emrat e instancave të shërbimit, të cilat i përmendëm në fillim të artikullit (1.ok-web.group1.web.front.prod, 2.ok-web.group1.web.front.prod, …), ne do të vërejmë se ato i ngjajnë FQDN-ve që përdoren në DNS. Kështu, për të shfaqur emrat e instancave të shërbimeve në IP-të e tyre, ne përdorim protokollin DNS. Në fakt, ky DNS kthen të gjitha adresat IP të rezervuara për të gjithë kontenierët — si ata që janë në punë, ashtu edhe të ndaluarit (për shembull, nëse përdoren tri replika, ndërsa kemi pesë adresa të rezervuara — të pesë do të kthehen). Klientët, duke marrë këtë informacion, do të përpiqen të lidhin me të pesë replikat — dhe kështu do të identifikojnë ata që janë në punë. Ky variant i përcaktimit të disponueshmërisë është dukshëm më i besueshëm, pasi nuk angazhon as DNS-në, as Zbulimin e Shërbimeve, duke e bërë kështu të pamundur zgjidhjen e problemeve me ruajtjen e informacionit të saktë dhe qëndrueshmërinë e këtyre sistemeve. Për më tepër, në shërbime kritike, nga të cilat varet funksionimi i portalit tërë, ne mund të mos përdorim fare DNS-në, por thjesht të shkruajmë adresat IP në konfigurim.
Implementimi i një transferimi të tillë të IP-ve pas kontenierëve mund të jetë jo trivial — dhe do të ndalemi në atë se si funksionon, në shembullin e ardhshëm:
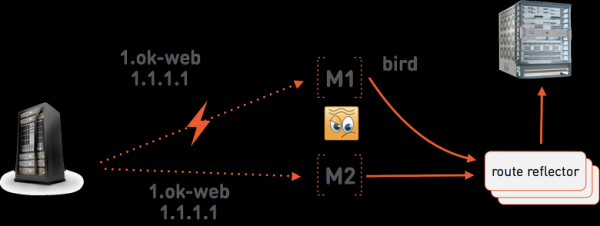
Supozoni se master-i i one-cloud jep komandën minion-it M1 të niste 1.ok-web.group1.web.front.prod me adresën 1.1.1.1. Në minion punon , i cili e njofton këtë adresë në serverat e veçantë . Këta të fundit kanë një seancë BGP me paisjen rrjetë, në të cilën transmetohet rruge e adresës 1.1.1.1 te M1. M1 pastaj rrugeton paketat brenda kontenierit duke përdorur mjetet Linux. Ka tre serverë route reflector, pasi kjo është një pjesë shumë kritike e infrastrukturës one-cloud — pa to, rrjeti në one-cloud nuk do të funksionojë. Ne i vendosim ato në raftë të ndryshëm, sa më shumë qëështë e mundur, në salla të ndryshme të qendrës së të dhënave, për të minimizuar mundësinë e dështimit të njëkohshëm të të treve.
Tani le të supozojmë se lidhja midis master-it one-cloud dhe minion-it M1 ka humbur. Master-i one-cloud tani do të veprojë, duke u nisur nga supozimi se M1 ka dështuar plotësisht. Do të thotë se do të japë urdhrin minion-it M2 të niste web.group1.web.front.prod me të njëjtin adresë 1.1.1.1. Tani kemi dy rrugë konfliktuale në rrjet për 1.1.1.1: në M1 dhe në M2. Për të zgjidhur konflikte të tilla, ne përdorim Multi Exit Discriminator, i cili specifikohet në njoftimin BGP. Ky numër tregon peshën e rrugës së njoftuar. Nga konfliktualet do të zgjidhet rruga me vlerën më të vogël MED. Masteri one-cloud mbështet MED si një pjesë integrale e IP adresave të kontejnerëve. Në herën e parë adresa shpërndahet me një MED mjaft të madh = 1 000 000. Në situatën e një transferimi të tillë emergjent të kontejnerit, masteri e ul MED, dhe M2 tashmë do të marrë komandën të njoftojë adresën 1.1.1.1 me MED = 999 999. Ndërsa instanca që punon në M1 do të mbetet pa lidhje, dhe ardhmëria e saj na intereson pak derisa të rikthehet lidhja me masterin, kur do të ndalet si një kopje e vjetër.
Aksidentet
Të gjitha sistemet e menaxhimit të qendrave të të dhënave gjithmonë e përballojnë me sukses dështimet e vogla. Rënia e kontejnerit është një normë pothuajse në çdo vend.
Le të shqyrtojmë se si ne i përballojmë aksidentet, për shembull dështimin e energjisë në një ose më shumë sallat e qendrës së të dhënave.
Çfarë do të thotë aksident për sistemin e menaxhimit të qendrës së të dhënave? Në radhë të parë, kjo është një dështim masiv dhe njëkohësisht i shumë makinave, dhe sistemi i menaxhimit duhet të migrojë një numër të madh kontejnerësh njëkohësisht. Por nëse aksidenti është shumë i gjerë, ndodh që të gjitha detyrat nuk mund të ricaktohen në minibotë të tjerë, sepse kapaciteti burimor i qendrës së të dhënave bie nën 100% të ngarkesës.
Shpesh aksidentet shoqërohen me dështimin e nivelit menaxhues. Kjo mund të ndodhë për shkak të dështimit të pajisjeve të tij, por më shpesh për shkak se aksidentet nuk testohet, dhe niveli menaxhues vetë bie nga ngarkesa e rritur.
Çfarë mund të bëjmë me të gjitha këto?
Migrazione masive nënkuptojnë se në infrastrukturë krijohet një numër i madh veprimesh, migracionesh dhe vendosjesh. Çdo migracion mund të marrë njëfarë kohe të nevojshme për të dorëzuar dhe paketa imazhet e kontejnerëve deri te minibotët, për të nisur dhe inicializuar kontejnerët etj. Prandaj, është e preferueshme që detyrat më të rëndësishme të nisin përpara atyre më pak të rëndësishme.
Le të shohim përsëri hierarkinë e njohur të shërbimeve dhe të përpiqemi të vendosim se cilat detyra dëshirojmë të nisim fillimisht.
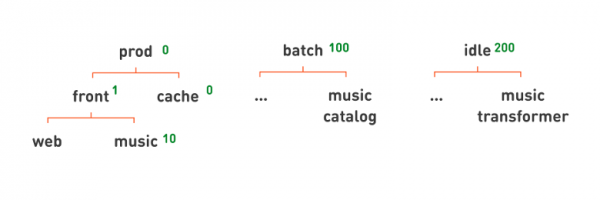
Sigurisht, këto janë proceset që marrin pjesë drejtpërdrejt në përpunimin e kërkesave të përdoruesve, pra, prod. Ne e specifikojmë këtë me prioritetin e vendosjes — një numër që mund t'i caktohet radhës. Nëse ndonjë radhë ka një prioritet më të lartë, shërbimet e saj vendosen së pari.
Në prod ne caktojmë prioritetet më të larta, 0; në batch — pak më të ulëta, 100; në idle — akoma më të ulëta, 200. Prioritetet aplikohen në mënyrë hierarkike. Të gjitha detyrat nën hierarkinë do të kenë prioritetin përkatës. Nëse duam që brenda prod caching të nisë përpara frontend-eve, atëherë caktojmë prioritetet për cache = 0 dhe për frontin e nënradhës = 1. Nëse, për shembull, duam që nga frontet të niset së pari portali kryesor, ndërsa fronti i muzikës më pas, mund t'i caktojmë këtij të fundit një prioritet më të ulët — 10.
Problemi tjetër është mungesa e burimeve. Pra, na ka dështuar një numër i madh pajisjesh, të tëra sallat e qendrës së të dhënave, ndërsa kemi nisur kaq shumë shërbime saqë tani nuk ka burime të mjaftueshme për të gjithë. Duhet të vendosim se për cilat detyra do të sakrifikojmë që shërbimet kryesore kritike të funksionojnë.
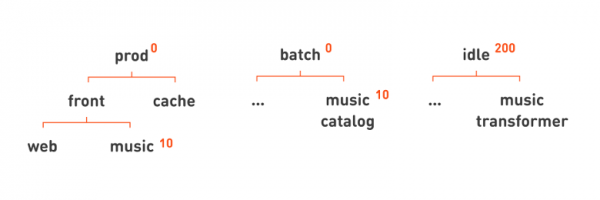
Në dallim nga prioriteti i vendosjes, nuk mund të sakrifikojmë pa dallim të gjitha detyrat batch, disa prej të cilave janë të rëndësishme për funksionimin e portalit. Prandaj ne kemi ndarë veçmas prioritetin e dëbimit të detyrave. Kur vendoset, një detyrë me prioritet më të lartë mund të dëbojë, pra, të ndalë një detyrë me prioritet më të ulët, nëse nuk ka më minion të lirë. Në këtë rast, detyra me prioritet më të ulët, me shumë mundësi, do të mbetet e pa vendosur, pra, për të nuk do të ketë më minion të përshtatshëm me burime të mjaftueshme të lira.
Në hierarkinë tonë është shumë e thjeshtë të specifikohet një prioritet i tillë dëbimi, që detyrat e prod dhe batch të dëbojnë ose ndalin detyrat idle, por jo njëra-tjetrën, duke caktuar për idle një prioritet të barabartë me 200. Po ashtu si në rastin e prioritetit të vendosjes, mund të përdorim hierarkinë tonë për të përshkruar rregulla më të komplikuara. Për shembull, do të specifikojmë se për funksionin e muzikës do të sakrifikojmë nëse na mungojnë burimet për portalin kryesor të uebit, duke vendosur për nodet përkatëse prioritet më të ulët: 10.
Aksidentet e Qendrës së të Dhënave tërësisht
Pse mund të dështojë e gjithë qendra e të dhënave? Natyror. Kishte një post të shkëlqyer se si . Elementi i jashtëm mund të përfshijnë ata që me një herë në një kolektor dogjën fiber optikë dhe qendra e të dhënave humbi plotësisht lidhjen me vendet e tjera. Shkaqet e daljes jashtë funksionit ndodhin gjithashtu për shkak të faktorëve njerëzorë: operatori mund të japë një komandë të tillë që e bën tërësisht të pamundur qendrën e të dhënave. Kjo mund të ndodhë për shkak të një defekti të madh. Në përgjithësi, qendrat e të dhënave bie — nuk është një fenomen i zakontë. Kjo ndodh një herë në disa muaj.
Dhe ja se çfarë bëjmë që askush #okzhivi të mos postojë në Twitter.
Strategjia e parë është izolimi. Çdo instancë e one-cloud është e izoluar dhe mund të menaxhojë makinat vetëm e një qendër të dhënash. Pra, humbja e një reje për shkak të defekteve ose komandave të gabuara të operatorit — është humbje vetëm e një qendër të dhënash. Jemi të përgatitur për këtë: ekziston një politikë rezervimi, ku replika e aplikacionit dhe të dhënave vendosen në të gjitha qendrat e të dhënave. Ne përdorim baza të të dhënave të qëndrueshme dhe rregullisht testojmë dështimet.
Duke patur parasysh se sot kemi katër qendra të të dhënash, ka edhe katër eksperimentale të plota dhe të izoluar të one-cloud.
Ky qasje jo vetëm që mbron nga dështimet fizike, por gjithashtu mund të mbrojë nga gabimet e operatorit.
Çfarë mund të bëjmë për faktorët njerëzorë? Kur operatori i jep re një komandë të çuditshme ose potencialisht të rrezikshme, ai mund të kërkohet papritur të zgjidhë një problem të vogël për të verifikuar se sa mirë ka menduar. Për shembull, nëse është një ndalje masive e shumë replikave ose thjesht një komandë e çuditshme — reduktimi i numrit të replikave ose ndryshimi i emrit të imazhit, jo vetëm numri i versionit në manifestin e ri.
Përfundime
Karakteristikat dalluese të one-cloud:
- Një skemë hierarkike dhe vizuale e emrave të shërbimeve dhe kontejnerëve, e cila lejon shumë shpejt të kuptoni se çfarë është kjo detyrë, për çfarë i takon dhe si punon dhe kush është përgjegjës për të.
- Ne përdorim teknikën tonë të bashkimit të detyrave prod- dhe batch-në minj, për të rritur efikasitetin e ndarjes së makinave. Në vend të cpuset përdorim quota të CPU, aksione, politika të planifikuesit të CPU dhe Linux QoS.
- Nuk arritëm të izolojmë plotësisht kontejnerët që punojnë në një makinë, por ndikimi i tyre mbetet brenda 20%.
- Organizimi i shërbimeve në një hierarki ndihmon në eliminimin automatik të emergjencave përmes prioriteteve të vendosjes dhe zëvendësimit..
FAQ
Pse nuk morëm një zgjidhje të gatshme.
- Klasat e ndryshme të izolimit të detyrave kërkojnë logjikë të ndryshme gjatë vendosjes në mini. Ndërsa detyrat prodhuese mund të vendosen me rezervimin e thjeshtë të burimeve, detyrat batch dhe idle duhet të vendosen duke ndjekur shfrytëzimin e vërtetë të burimeve në makinat mini.
- Nevoja për të marrë parasysh burimet e konsumuar nga detyrat, siç janë:
- kapaciteti i rrjetit;
- tipet dhe "spindlet" e disqeve.
- Nevoja për të specifikuar prioritetet e shërbimeve gjatë largimit të aksidenteve, të drejtat dhe kuotat e ekipeve për burimet, që arrihet përmes radhëve hierarkike në one-cloud.
- Nevoja për të pasur emra njerëzorë për kontejnerët për të reduktuar kohën e reagimit ndaj aksidenteve dhe incidenteve.
- Pamundësia për të zbatuar njëkohësisht në mënyrë universale Zbulimin e Shërbimeve; nevoja për të bashkëjetuar për një kohë të gjatë me detyrat e vendosura në hostët harduerikë, e cila zgjidhet me adresat IP "statike", që ndjekin kontejnerët, dhe si pasojë, nevoja për një integrim unik me infrastrukturën e gjerë rrjetore.
Të gjitha këto funksione do të kërkonin rikonstruksione të thella të zgjidhjeve ekzistuese dhe, duke vlerësuar sasinë e punës, ne kuptuam se mund të zhvillonim një zgjidhje tonën me të njëjtat shpenzime pune. Por zgjidhja jonë do të ishte ndjeshëm më e lehtë për t'u eksploruar dhe zhvilluar - nuk ka abstraksione të panevojshme që mbështesin funksionalitetin e panevojshëm për ne.
Atyre që lexojnë rreshtat e fundit - faleminderit për qëndrueshmërinë dhe vëmendjen!
Burimi: habr.com
