

Arkitektura mikrosërvices, siç është gjithçka në këtë botë, ka përparësitë dhe disavantazhet e saj. Disa procese bëhen më të thjeshta me të, të tjera - më të komplikuara. Dhe në emër të shpejtësisë së ndryshimeve dhe një shkallëzueshmërie më të mirë, ne duhet të bëjmë disa sakrifica. Një prej tyre është komplikuar analitika. Në një monolit, të gjitha analitikët operacionalë mund të reduktohen në kërkesa SQL në një replikë analitike, por në arkitekturën e shumë shërbimeve, çdo shërbim ka bazën e tij dhe duket se një kërkesë nuk mjafton (apo ndoshta mjafton?). Për ata që janë të interesuar se si zgjidhëm problemin e analitikës operative në kompaninë tonë dhe si mësuam të jetojmë me këtë zgjidhje - mirëseerdhët.
Quhem Pavel Sivas, në DomKlik punoj në ekipin që është përgjegjës për mbështetje në depozitat analitike të të dhënave. Aktivitetin tonë mund ta kategorizojmë në inxhinieri të të dhënave, por, në të vërtetë, spektri i detyrave është shumë më i gjerë. Ka standardet e zakonshme për inxhinieri të të dhënave ETL/ELT, mbështetje dhe adaptim të veglave për analizën e të dhënave dhe zhvillimin e veglave tona. Në veçanti, për raportimin operativ ne vendosëm të 'pretendojmë' se kemi një monolit dhe t'u japim analistëve një bazë, ku do të jenë të gjitha të dhënat e nevojshme për ta.
Në përgjithësi, ne shqyrtuam alternativa të ndryshme. Mund të ndërtosh një depo të plotë – madje e provuam, por, për të qenë të sinqertë, nuk arritëm ta lidhim mjaft shpesh ndryshimin në logjikë me një proces ndërtimi të depozitës dhe të bërit ndryshime në të që ishte mjaft i ngadaltë (nëse dikush e ka arritur, na shkruani në komentet si). Duhej të shkonim tek analistët dhe t'u thoshim: ‘Djem, mësoni python dhe shkoni në kopjet analitike’, por kjo është një kërkesë shtesë për rekrutimin e personelit dhe dukej se duhej ta evitonim, nëse është e mundur. Vendosëm të provonim teknologjinë FDW (Foreign Data Wrapper): në thelb, kjo është një standard dblink që ekziston në standardin SQL, por me një ndërfaqe shumë më të përshtatshme. Në bazë të saj ne zhvilluam një zgjidhje, e cila përfundimisht u konsolidua, dhe mbi të u ndaluam. Detajet e saj janë një temë për një artikull të veçantë, ndoshta edhe për më shumë se një, pasi do të doja të flisja për shumë gjëra: nga sinkronizimi i skemave të bazave deri te menaxhimi i aksesit dhe anonimizimi i të dhënave personale. Po ashtu, duhet të sqarohet se kjo zgjidhje nuk është një zëvendësim për bazat e të dhënave analitike dhe depozet reale, ajo zgjidh vetëm një detyrë të caktuar.
Në nivelin e lartë, kjo duket kështu:
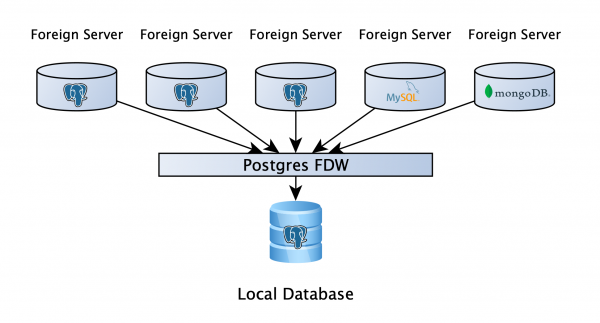
Ekziston një bazë PostgreSQL, ku përdoruesit mund të ruajnë të dhënat e tyre të punës, dhe më e rëndësishmja – në këtë bazë përmes FDW janë lidhur kopjet analitike të të gjitha shërbimeve. Kjo mundëson të shkruani një kërkesë ndaj disa bazave, dhe nuk ka rëndësi çfarë janë: PostgreSQL, MySQL, MongoDB ose diçka tjetër (një skedar, API, nëse ndonjëherë nuk ka ndonjë avullues të përshtatshëm, mund të shkruani tuajin). Duket mjaft e përshtatshme, apo jo? A duhet të shpërndahemi?
Po të ishte gjithçka kaq e shpejtë dhe e thjeshtë, ndoshta nuk do të kishim asnjë artikull.
Është e rëndësishme të kuptohet qartë se si PostgreSQL trajton kërkesat ndaj serverëve të largët. Kjo duket logjike, megjithatë shpesh ne nuk i kushtojmë vëmendje: PostgreSQL ndan kërkesën në pjesë, të cilat ekzekutohen ndaras në serverët e largët, mbledh këto të dhëna dhe llogaritjet përfundimtare i bën vetë, për këtë arsye shpejtësia e ekzekutimit të kërkesës do të varet shumë nga mënyra se si është shkruar ajo. Duhet gjithashtu të theksohet: kur të dhënat vijnë nga një server i largët, ato nuk kanë më indekse, nuk ka asgjë që do të ndihmojë planifikuesin, kështu që mund ta ndihmojmë dhe t'i japim udhëzime vetëm ne vetë. Dhe pikërisht për këtë do doja të flisja më në detaje.
Kërkesë e thjeshtë dhe plani me të
Për të treguar se si PostgreSQL ekzekuton një kërkesë në një tabelë me 6 milionë rreshta në distancë server, le të shohim një plan të thjeshtë.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table;

Aggregate  (cost=418383.23..418383.24 rows=1 width=8) (actual time=3857.198..3857.198 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..402376.14 rows=6402838 width=0) (actual time=4.874..3256.511 rows=6406868 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table
Planning time: 0.986 ms
Execution time: 3857.436 ms
Përdorimi i komandës VERBOSE mundëson të shohim kërkesën që do të dërgohet në serverin e largët dhe rezultatet e të cilit do të marrim për përpunim të mëtejshëm (rreshti RemoteSQL).
Të shkojmë pak më thellë dhe të shtojmë në kërkesën tonë disa filtra: një sipas boolean fushës, një sipas përfshirjes timestamp në interval dhe një sipas jsonb.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta->>'source' = 'test';

Aggregate  (cost=577487.69..577487.70 rows=1 width=8) (actual time=27473.818..25473.819 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..577469.21 rows=7390 width=0) (actual time=31.369..25372.466 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)))
        Rows Removed by Filter: 5046843
        Remote SQL: SELECT created_dt, is_active, meta FROM fdw_schema.table
Planning time: 0.665 ms
Execution time: 27474.118 ms
Këtu është momenti, në të cilin duhet të kemi parasysh gjatë hartimit të kërkesave. Filtrat nuk u dërguan në serverin e largët, çka do të thotë se për t'u ekzekutuar PostgreSQL tërheq të gjitha 6 milionë rreshta, për t'i filtruar më pas lokal (rreshti Filter) dhe për të bërë agregimin. Çelësi i suksesit është të hartojmë kërkesën në mënyrë që filtrat të dërgohen në makinë, e që ne të marrim dhe të agregojmë vetëm rreshtat e nevojshëm.
Kjo është një sitë booleanesh
Me fushat boolean është shumë e thjeshtë. Problemi në kërkesën origjinale ndodhi për shkak të operatorit is. Nëse e zëvendësojmë atë me =, atëherë ne do të marrim rezultatin e mëposhtëm:
shpjegoni analizën e hollësishme
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 muaj'
AND CURRENT_DATE - INTERVAL '6 muaj'
AND meta->>'source' = 'test';

Agregati  (cost=508010.14..508010.15 rows=1 width=8) (koha aktuale 19064.314..19064.314 rows=1 loops=1)
  Dalja: count(1)
  ->  Skane të Huaja mbi fdw_schema."table"  (cost=100.00..507988.44 rows=8679 width=0) (koha aktuale 33.035..18951.278 rows=1360025 loops=1)
        Dalja: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filtri: ((("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('tani'::cstring)::date - '7 muaj'::interval)) AND ("table".created_dt <= ((('tani'::cstring)::date)::timestamp me zonë kohore - '6 muaj'::interval)))
        Rreshtat e hequra nga Filtri: 3567989
        SQL i Largët: SELECT created_dt, meta FROM fdw_schema.table WHERE (is_active)
Koha e planifikimit: 0.834 ms
Koha e ekzekutimit: 19064.534 ms
Siç e shihni, filtri kaloi në serverin e largët, dhe koha e ekzekutimit u reduktua nga 27 në 19 sekonda.
Duhet theksuar se operatori is dallojë nga operatori = në atë që ai mund të punojë me vlerën Null. Kjo do të thotë se is not True në filtri do të lërë vlera False dhe Null, ndërsa != True do të lërë vetëm vlera False. Prandaj, kur zëvendësoni operatorin is not duhet të kaloni në filtrin dy kushte me operatorin OR, për shembull, WHERE (col != True) OR (col is null).
Kemi kuptuar për boolean, tani vazhdojmë më tej. Por le të kthejmë filtrin mbi vlerën boolean në versionin e tij origjinal, në mënyrë që të shqyrtojmë efektin nga ndryshimet e tjera.
timestamptz? hz
Në përgjithësi, shpesh na duhet të eksperimentojmë se si të shkruajmë saktësisht një kërkesë që përfshin serverë të largët, dhe më pas të kërkojmë shpjegime pse ndodhin pikërisht kështu. Ka shumë pak informacion në lidhje me këtë në Internet. Kështu, në eksperimentet tona zbuluam se filtri mbi një datë fikse shkon në serverin e largët me sukses, por kur dëshirojmë të caktojmë datën dinamikisht, për shembull, now() ose CURRENT_DATE, kjo nuk ndodh. Në shembullin tonë, ne shtuam një filtr që kolonën created_at të përmbante të dhëna për një muaj të kaluar (BETWEEN CURRENT_DATE — INTERVAL ‘7 muaj’ AND CURRENT_DATE — INTERVAL ‘6 muaj’). Çfarë vepruam në këtë rast?
shpjego analizën e hollësishme
SELECT count(1)
FROM fdw_schema.tabela
WHERE is_active është E vërtetë
DHE created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 muaj')
DHE created_dt >'source' = 'test';

Aksesuese (kostot=306875.17..306875.18 rreshta=1 gjerësi=8) (koha aktuale=4789.114..4789.115 rreshta=1 loops=1)
  Dalja: count(1)
  InitPlan 1 (kthen $0)
    ->  Rezultati  (kostot=0.00..0.02 rreshta=1 gjerësi=8) (koha aktuale=0.007..0.008 rreshta=1 loops=1)
          Dalja: ((('tani'::cstring)::date)::timestamp me zonë kohore - '7 muaj'::interval)
  InitPlan 2 (kthen $1)
    ->  Rezultati  (kostot=0.00..0.02 rreshta=1 gjerësi=8) (koha aktuale=0.002..0.002 rreshta=1 loops=1)
          Dalja: ((('tani'::cstring)::date)::timestamp me zonë kohore - '6 muaj'::interval)
  ->  Skano i Huaj në fdw_schema."tabela"  (kostot=100.02..306874.86 rreshta=105 gjerësi=0) (koha aktuale=23.475..4681.419 rreshta=1360025 loops=1)
        Dalja: "tabela".id, "tabela".is_active, "tabela".meta, "tabela".created_dt
        Filtri: (("tabela".is_active ËSHTË E VËRTETË) DHE (("tabela".meta ->>'source'::text) = 'test'::text))
        Rreshtat e hequr nga Filter: 76934
        SQL i Largët: SELECT is_active, meta FROM fdw_schema.tabela WHERE ((created_dt >= $1::timestamp me zonë kohore)) DHE ((created_dt < $2::timestamp me zonë kohore))
Koha e planifikimit: 0.703 ms
Koha e ekzekutimit: 4789.379 ms
Kemi sugjeruar planifikuesit të llogarisë paraprakisht datën në nënkërkesë dhe të kalojë një variabël të gatshme në filtër. Dhe kjo sugjerim na dha një rezultat të shkëlqyer, kërkesa u bë më e shpejtë pothuajse 6 herë!
Edhe njëherë, këtu është e rëndësishme të jeni të kujdesshëm: tipi i të dhënave në nënkërkesë duhet të jetë i njëjtë si ai i fushës, mbi të cilën filtrojmë; ndryshe planifikuesi do të vendosë se tipet janë të ndryshme dhe është e nevojshme së pari të nxjerrë të gjitha të dhënat dhe më pas të filtrojë lokal.
Të rikthejmë filtrin për datën në vlerën e tij fillestare.
Freddy kundër Jsonb
Në përgjithësi, fushat Boolean dhe datat tashmë e përshpejtuar kërkesën tonë, megjithatë kishte edhe një tip të dhënash tjetër. Lufta me filtrimin mbi të, për ta thënë të drejtën, ende nuk është përfunduar; megjithatë këtu ka dhe suksese. Pra, ja si na rezultoi të kalojmë filtrin mbi jsonb fushën në serverin e largët.
shpjego analizën e hollësishme
SELECT count(1)
FROM fdw_schema.tabela
WHERE is_active është E vërtetë
DHE created_dt MES CURRENT_DATE - INTERVAL '7 muaj'
DHE CURRENT_DATE - INTERVAL '6 muaj'
DHE meta @> '{"source":"test"}'::jsonb;

Aksesuese (kostot=245463.60..245463.61 rreshta=1 gjerësi=8) (koha aktuale=6727.589..6727.590 rreshta=1 loops=1)
  Dalja: count(1)
  ->  Skano i Huaj në fdw_schema."tabela"  (kostot=1100.00..245459.90 rreshta=1478 gjerësi=0) (koha aktuale=16.213..6634.794 rreshta=1360025 loops=1)
        Dalja: "tabela".id, "tabela".is_active, "tabela".meta, "tabela".created_dt
        Filtri: (("tabela".is_active ËSHTË E VËRTETË) DHE ("tabela".created_dt >= (('tani'::cstring)::date - '7 muaj'::interval)) DHE ("tabela".created_dt  '{"source": "test"}'::jsonb))
Koha e planifikimit: 0.747 ms
Koha e ekzekutimit: 6727.815 ms
Në vend të operatorëve të filtrimit, duhet përdorur operatori i pranisë së një jsonb në një tjetër. 7 sekonda në vend të 29. Deri tani, kjo është alternativa e vetme e suksesshme për transferimin e filtrave nga jsonb në serverin e largët, por këtu është e rëndësishme të merret parasysh një kufizim: ne po përdorim versionin e bazës 9.6, megjithatë deri në fund të prillit planifikojmë të përfundojmë testet e fundit dhe të kalojmë në versionin 12. Pasi të përditësohemi, do të shkruajmë se si ndikon kjo, sepse ndryshimet për të cilat ka shumë shpresë janë mjaft të shumta: json_path, sjellja e re e CTE, push down (e pranishme që nga versione 10). E presim me padurim.
Finish him
Ne kemi kontroluar se si çdo ndryshim ndikon në shpejtësinë e kërkesës veçmas. Le të shikojmë tani se çfarë do të ndodhë kur të tre filtrat të shkruhen siç duhet.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 month')
AND created_dt  '{"source":"test"}'::jsonb;

Aggregate  (cost=322041.51..322041.52 rows=1 width=8) (actual time=2278.867..2278.867 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.010..0.010 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 mons'::interval)
  InitPlan 2 (returns $1)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.003..0.003 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.02..322041.41 rows=25 width=0) (actual time=8.597..2153.809 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table WHERE (is_active) AND ((created_dt >= $1::timestamp with time zone)) AND ((created_dt  '{"source": "test"}'::jsonb))
Planning time: 0.820 ms
Execution time: 2279.087 ms
Po, kërkesa duket më e komplikuar, kjo është një çmim i detyruar, por shpejtësia e ekzekutimit arrin 2 sekonda, që është më shumë se 10 herë më shpejt! Dhe po flasim për një kërkesë shumë të thjeshtë ndaj një sërë të dhënash relativisht të vogla. Në kërkesat reale kemi marrë përmirësime deri në disa qindra herë.
Të përmendim përmbledhjen: nëse po përdorni PostgreSQL me FDW, gjithmonë kontrolloni nëse të gjithë filtrat dërgohen në serverin e largët, dhe do të keni fat... Të paktën derisa të arrini në join-et ndërmjet tabelave nga tabela të ndryshme serverësh. Por kjo është një histori për një artikull tjetër.
Faleminderit për vëmendjen! Do të isha i gëzuar të dëgjoja pyetje, komente, si dhe histori për përvojat tuaja në komentet.
Burimi: habr.com
