

Raporti i dedikohet çështjeve praktike të zhvillimit të operatorëve në Kubernetes, dizajnimit të arkitekturës së tij dhe parimeve themelore të funksionimit.
Në pjesën e parë të raportit do të shqyrtojmë:
- çfarë është një operator në Kubernetes dhe për çfarë është i nevojshëm;
- si e thjeshton operatori menaxhimin e sistemeve të ndërlikuara;
- çfarë mund të bëjë operatori dhe çfarë nuk mund të bëjë.
Më pas, do të kalojmë në diskutimin e strukturës së brendshme të operatorit. Do të shqyrtojmë arkitekturën dhe funksionimin e operatorit hap pas hapi. Do të analizojmë në detaje:
- interaksionin midis operatorit dhe Kubernetes;
- cilat funksione operatori merr përsipër, dhe çfarë delegon në Kubernetes.
Do të shqyrtojmë menaxhimin e shard-eve dhe kopjeve të DB në Kubernetes.
Më pas, do të diskutojmë çështjet e ruajtjes së të dhënave:
- si të punoni me Ruajtjen e Përhershme nga këndvështrimi i operatorit;
- tronditjet e mundshme të përdorimit të Ruajtjes Lokale.
Në pjesën përfundimtare të raportit do të shqyrtojmë shembuj praktikë të përdorimit me Amazon ose Shërbimin e Google Cloud. Raporti ndërtone mbi shembujt e zhvillimit dhe përvojës së operimit të operatorit për ClickHouse.
Video:
E kam emrin Vladislav Klimenko. Sot doja të flisja për përvojën tonë në zhvillimin dhe operimin e operatorëve, sidomos për një operator të specializuar për menaxhimin e klastereve të databazave. Në shembullin e për menaxhimin e klasterit ClickHouse.
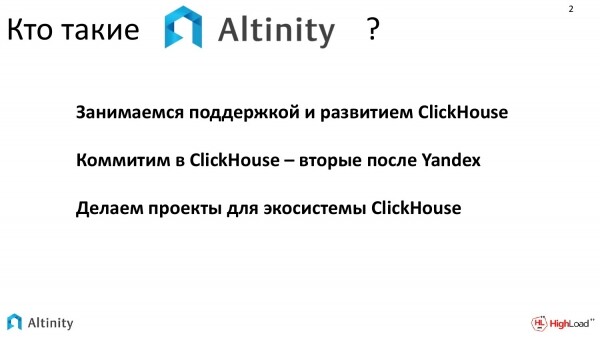
Pse kemi mundësinë të flasim për operatorin dhe ClickHouse?
- Ne merremi me mbështetje dhe zhvillim të ClickHouse.
- Aktualisht përpiqemi gradualisht të kontribuojmë në zhvillimin e ClickHouse. Dhe jemi të dytët pas Yandex në sasinë e ndryshimeve të kryera në ClickHouse.
- Përpiqemi të bëjmë projekte shtesë për ekosistemin e ClickHouse.
Një nga këto projekte doja të flisja. Ky është ClickHouse-operator për Kubernetes.
Në raportin tim do të doja të preknja dy tema:
- Tema e parë – si funksionon operatori ynë për menaxhimin e databazave ClickHouse në Kubernetes.
- Tema e dytë – si funksionon çdo operator, pra si bashkëvepron ai me Kubernetes.
Sidoqoftë, këto dy pyetje do të ndërthuren gjatë gjithë raportit tim.
Kush do të jetë i interesuar të dëgjojë atë që përpiqem të them?
- Më së shumti do të jetë interesante për ata që operojnë operatorët.
- Apo për ata që duan të krijojnë të vetin, për të kuptuar se si funksionon brenda, si bashkëvepron operatori me Kubernetes dhe cilat tronditje mund të shfaqen.
Për ta kuptuar më mirë atë që do të diskutojmë sot, do të ishte e dobishme të dimë se si funksionon Kubernetes dhe të kemi një përgatitje bazike për teknologjitë e cloud.
Çfarë është ClickHouse? Ajo është një bazë të dhënash kolonore me specifikë në përpunimin online të kërkesave analitike. Dhe ajo është plotësisht open source.
Dhe na duhet të dimë vetëm dy gjëra. Duhet të dimë se kjo është një bazë të dhënash, prandaj ajo që do të tregoj do të jetë e aplikueshme praktikisht për çdo bazë të dhënash. Dhe se DBMS ClickHouse është shumë e shkallëzueshme, duke ofruar për një shkallëzim pothuajse linear. Prandaj, gjendja e klasterit – është një gjendje natyrale për ClickHouse. Dhe ndoshta më interesante është të diskutojmë se si të menaxhojmë klasterin ClickHouse në Kubernetes.
Pse është e nevojshme atje? Pse nuk mund të vazhdojmë ta eksploatojmë atë vet? Pergjigjet janë pjesërisht teknike dhe pjesërisht organizative.
- Në praktikë, ne gjithnjë e më shpesh hasim situata të tilla, kur në kompanitë e mëdha tashmë praktikisht të gjitha komponentët janë në Kubernetes. Baza e të dhënave mbetet përjashtim.
- Dhe gjithnjë e më shpesh bëhet pyetja: "A mund ta fusim atë brenda?". Prandaj, kompanitë e mëdha përpiqen të krijojnë maksimalën e unifikimit të menaxhimit për të pasur mundësinë të menaxhojnë shpejt depozitat e tyre të dhënash.
- Dhe kjo ndihmon në veçanti, nëse është e nevojshme që maksimalisht të përsërisim të njëjtën gjë në një vend të ri, dmth. maksimalja portabilitet.
Sa e lehtë ose e vështirë është? Natyrisht, kjo mund të bëhet me duar. Por nuk është aq e lehtë, sepse ne hasim në ndërlikimin e menaxhimit të vetë Kubernetes, por mbi këtë përflakja e specifikës së ClickHouse. Kështu, ndodh një agregatë.
Dhe gjithçka së bashku ofron një set mjaft të gjerë teknologjish, të cilat bëhen mjaft të vështira për t'u menaxhuar, sepse Kubernetes sjell pyetje të përditshme për operimin, ndërsa ClickHouse sjell pyetje të veta për operimin e përditshëm. Sidomos, nëse kemi disa ClickHouse-e dhe duhet të bëjmë vazhdimisht diçka me to.
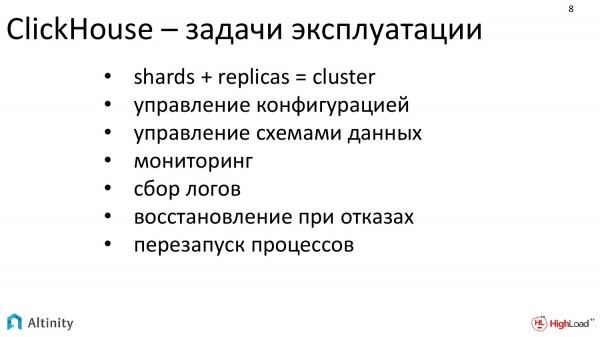
Në ClickHouse, me konfigurim dinamik, ka një numër të konsiderueshëm pyetjesh që krijojnë një ngarkesë të vazhdueshme për DevOps:
- Kur duam të ndryshojmë diçka në ClickHouse, për shembull, të shtojmë një replikë, një shard, do të duhet të realizojmë menaxhimin e konfiguracionit.
- Më pas, duhet të ndryshoni skemën e të dhënave, sepse ClickHouse ka një mënyrë specifike të shardimit. Duhet të ndahen skemat e të dhënave dhe të konfigurohen.
- Duhet të konfigurohet monitorimi.
- Mblidhni logjet për shards të rinj, për replika të reja.
- Kujdesuni për rikuperimin.
- Dhe për rindezjen.
Këto janë punë rutinore, të cilat shumë do të donin t'i lehtësonin në përgatitje.
Kubernetes po ndihmon shumë në menaxhim, por në aspektet themelore të sistemit.
Kubernetes lehtëson dhe automatizon gjëra si:
- Rikuperimi.
- Rindezja.
- Menaxhimi i sistemit të ruajtjes.
Kjo është e mirë, kjo është drejtimi i duhur, por ai nuk ka një kuptim të plotë se si të menaxhohet një klaster i bazës së të dhënave.
Dëshirojmë më shumë, duam që e gjithë baza e të dhënave të funksionojë në Kubernetes.
Dëshirojmë të kemi diçka si një buton të madh magjik të kuq, mbi të cilin klikoni dhe ju krijohet dhe mbahet gjatë gjithë ciklit të jetës një klaster me detyra të përditshme që duhen zgjidhur. Klasteri ClickHouse në Kubernetes.
Dhe ne kemi përpjekur të krijojmë një zgjidhje që do të ndihmonte në lehtësimin e punës. Ky është ClickHouse-operator për Kubernetes nga kompania Altinity.
Operatori është një program, detyra kryesore e të cilit është të menaxhojë programe të tjera, domethënë ai është një menaxher.
Dhe ai përmban modele sjelljeje. Mund ta quajmë këtë njohuri të kodifikuara mbi fushën përkatëse.
Dhe detyra kryesore e tij është të lehtësojë jetën për DevOps dhe të reduktojë menaxhimin e mikros, që ai (DevOps) të mendojë në terma më të lartë, domethënë që ai (DevOps) të mos merret me menaxhimin e detajeve manualisht.
Dhe operatori është pikërisht një robot ndihmës, që lufton me detyra të vogla dhe ndihmon DevOps.
Pse është nevojitur operatori? Ai tregohet veçanërisht i mirë në dy çështje:
- Kur një specialist që merret me ClickHouse, nuk ka përvojë të mjaftueshme, por duhet të operohet ClickHouse, operatori lehtëson operimin dhe ndihmon në manaxhimin e një klasteri ClickHouse me një konfiguracion mjaft të komplikuar, duke mos u përfshirë shumë në detaje se si funksionon gjithçka brenda. Thjesht i jepni detyra të nivelit të lartë, dhe kjo funksionon.
- Dhe detyra e dytë, në të cilën ai shihet më së miri, është kur duhet të automatizohet një numër i madh detyrash tipike. Ai heq mikrodetyrat nga administruesit e sistemit.
Kjo është më e nevojshme për ata që sapo kanë filluar rrugën e tyre, ose për ata që duhet të angazhohen shumë në automatizim.
Cila është dallimi i qasjes që bazohet në operatorë nga sistemet e tjera? Ka Helm. Ai gjithashtu ndihmon në instalimin e ClickHouse, mund të vizatoni helm charts, të cilat madje vendosin një klaster të tërë ClickHouse. Çfarë dallimi ka midis operatorit dhe, për shembull, Helm?
Dallimi themelor është se Helm është menaxhim paketash, ndersa operatori shkon më tej. Ai mbulon të gjithë ciklin e jetës. Nuk është vetëm instalimi, janë detyrat e përditshme, që përfshijnë skalimin, sharding, pra, të gjitha ato që duhet të kryhen në procesin e ciklit të jetës (nëse nevojitet, edhe fshirja) – të gjitha këto i zgjidh operatori. Ai përpiqet të automatizojë dhe mbështesë të gjithë ciklin e jetës së softuerit. Kjo është dallimi i tij themelor nga zgjidhjet e tjera që janë të pranishme.
Kjo ishte pjesa hyrëse, le të vazhdojmë më tutje.
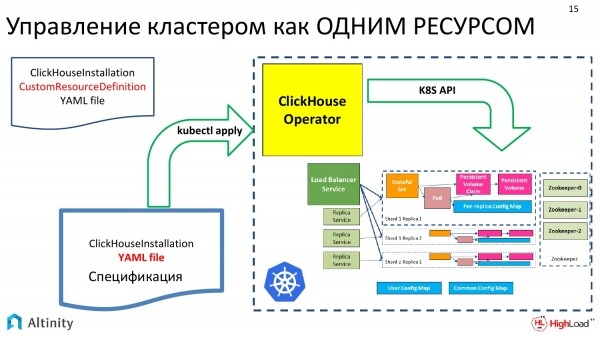
Si ndërtuojmë operatorin tonë? Ne përpiqemi të qasemi në mënyrë që të menaxhojmë klasterin ClickHouse si një burim të vetëm.
Ja, në anën e majtë të pamjes kemi të dhënat hyrëse. Ky është një YAML me specifikimin e klasterit, që në mënyrën klasike kalon përmes kubectl në Kubernetes. Atje, operatori e merr, bën magjinë e tij. Dhe në daljen kemi diçka të tillë. Kjo është implementimi i ClickHouse në Kubernetes.
Dhe më pas do të shikojmë gradualisht se si funksionon operatori, cilat detyra tipike mund të zgjidhen. Do të shqyrtojmë vetëm detyrat tipike, sepse kemi kohë të kufizuar. Dhe nuk do të flasim për gjithçka që mund të zgjidhë operatori.
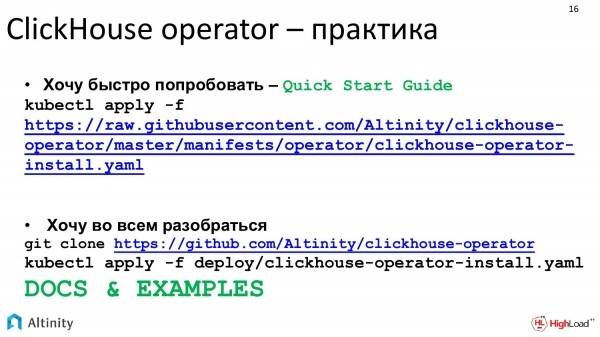
Le të nisemi nga praktika. Projekti ynë është plotësisht open source, kështu që mund të shihni në GitHub se si funksionon. Dhe mund të lini që, nëse dëshironi të provoni ta aktivizoni thjesht, atëherë mund të filloni me udhëzuesin e shpejtë.
Nëse dëshironi të zhyteni në detaje, ne përpiqemi të mbajmë dokumentacionin në një formë më të pranueshme.
Le të nisim me një detyrë praktike. Detyra e parë, nga e cila të gjithë duam të fillojmë, është ta nisnim shembullin e parë në njëfarë mënyre. Si ta nxjerrim në punë ClickHouse me ndihmën e operatorit, edhe pa e ditur shumë si funksionon? Shkruajmë një manifest, pasi të gjitha komunikimet me k8s janë komunikime përmes manafests.
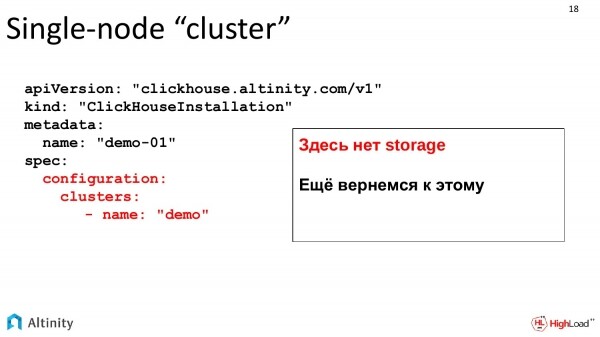
Ja një manifest i tillë i komplikuar. Ajo që kemi theksuar me të kuqe është ajo që duhet të akcentohet. Ne i kërkojmë operatorit të krijojë një grup me emrin demo.
Për momentin këto janë shembuj bazikë. Storage ende nuk përshkruhet, por do të kthehemi te storage pak më vonë. Për tani, do të ndjekim zhvillimin e grupit në dinamikë.
E krijuam këtë manifest. I japim atë operatorit tonë. Ai punoi, bëri magjinë.
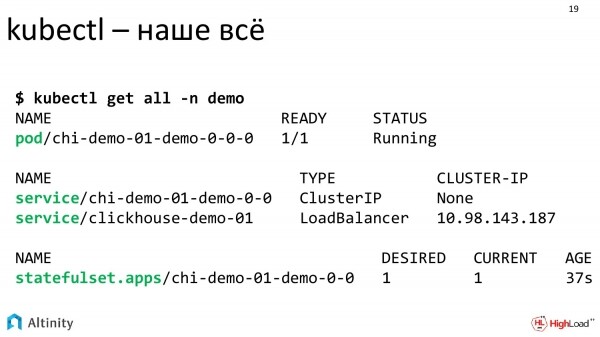
Shikojmë në konsolë. Tre komponente të ndryshme janë interesante – këto janë Pod, dy Shërbime dhe StatefulSet.
Operatori kreu punën e tij, dhe ne mund të shohim se çfarë saktësisht krijoi ai.
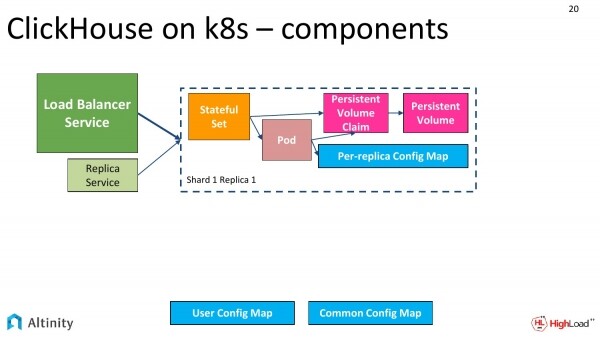
Ai krijon një skemë të tillë. Kemi StatefulSet, Pod, ConfigMap për çdo ndryshim, ConfigMap për të gjithë grupin. Sigurisht, shërbimet si pika hyrëse në grup.
Shërbimet janë Shërbimi Qendror Load Balancer dhe gjithashtu mund të ketë për çdo ndryshim, për çdo shard.
Ja si duket grupi ynë bazë. Ai përbëhet nga një nodësh të vetme.
Le të vazhdojmë, do të komplikohemi. Duhet të shardojmë grupin.
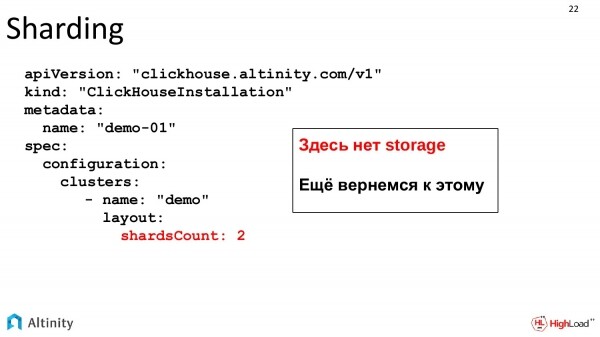
Detyrat tona po rriten, duke filluar dinamikën. Dëshirojmë të shtojmë një shard. Ndjekim zhvillimin. Ndryshojmë specifikimin tonë. Shkruajmë se duam dy shard.
Ky është po ai skedar, i cili zhvillohet në mënyrë dinamike me rritjen e sistemit. Storage nuk ka, storage do të shqyrtohet më vonë, kjo është një temë e veçantë.
I japim YAML-operatorit dhe shohim se çfarë del.
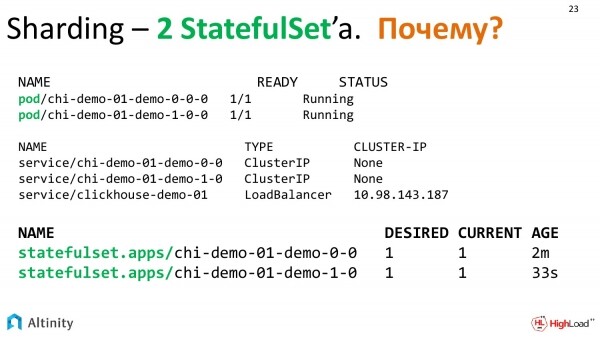
Operatori mendoi dhe krijoi entitetet e mëposhtme. Tani kemi dy Pod, tre Shërbime dhe, befas, 2 StatefulSet. Pse 2 StatefulSet?
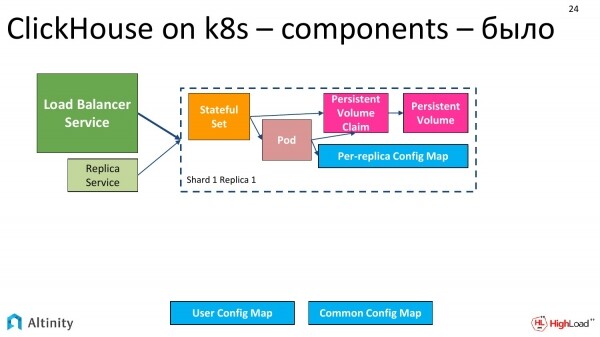
Në skemë ishte kështu – ky ishte gjendja fillestare, kur kishim një pod.
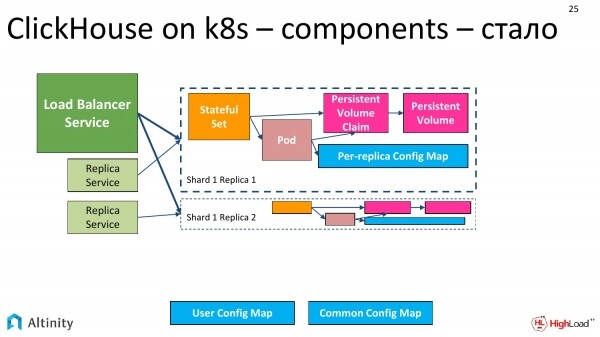
Tani u bë kështu. Për momentin gjithçka është e thjeshtë, është e dyfishuar.
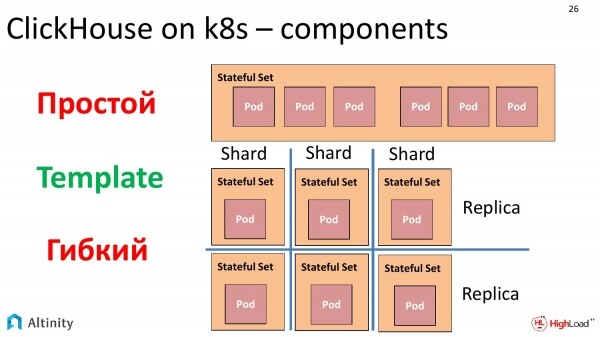
Dhe pse StatefulSet u bë dy? Këtu duhet të largohemi dhe të diskutojmë çështjen se si në Kubernetes menaxhohen Pod’ët.
Ka një objekt të tillë të quajtur StatefulSet, i cili lejon krijimin e një grupi Pod’ësh nga një shablon. Faktor kryesor është Template. Dhe mund të eksploroni shumë Pod’ë nga një shablon në një StatefulSet. Dhe fraza kyçe këtu është "nga një shablon shumë Pod’ë."
Dhe kishte një tundim të madh për të bërë të gjithë klastri, duke e paketuar në një StatefulSet. Kjo do të funksiononte, nuk ka asnjë problem. Por ka një nuancë. Nëse duam të formojmë një klasër heterogjen, pra me disa versione të ClickHouse, atëherë kemi disa pyetje. Po, StatefulSet mund të bëjë një përditësim të rrotullueshëm, po aty mund të vendosim versionin e ri, duke shpjeguar se nuk duhet të provojmë më shumë se kaq shumë nodë njëherësh.
Por nëse e ekstrapolojmë detyrën dhe themi se duam të krijojmë një klasër plotësisht heterogjen dhe duam jo të kalojmë nga versioni i vjetër në të riun me anë të përditësimit rrotullues, por thjesht duam të krijojmë një klasër heterogjen si në pjesën e versioneve të ndryshme të ClickHouse, ashtu edhe në pjesën e ruajtjes së ndryshme. Duam, për shembull, të krijojmë disa replika mbi disqe të veçanta, mbi të ngadalta, në përgjithësi, të ndërtojmë plotësisht një klasër heterogjen. Dhe për shkak se StatefulSet bën një zgjidhje të standardizuar nga një model, nuk ka mundësi ta bëjmë këtë.
Pas disa reflektimesh, u mor vendimi që të veprojmë kështu. Çdo replika është në StatefulSet-in e vet. Ka disa mangësi në këtë zgjidhje, por në praktikë, operatori e enkapsulon plotësisht këtë. Dhe ka shumë përfitime. Mund të ndërtojmë një klasër plotësisht ashtu siç duam, për shembull, absolutisht heterogjen. Prandaj, në klastrin tonë, ku kemi dy shard-e me një replika, do të kemi 2 StatefulSet-a dhe 2 Pod-a pikërisht për shkak se kemi zgjedhur një qasje të tillë për shkak të arsyeve të përmendura më sipër për mundësinë e ndërtimit të një klasri heterogjen.
Të kthehemi te detyrat praktike. Ne në klastrin tonë duam të konfigurimim përdoruesit, pra na nevojitet ndonjë konfigurim i ClickHouse në Kubernetes. Operatorët ofrojnë të gjitha mundësitë për këtë.
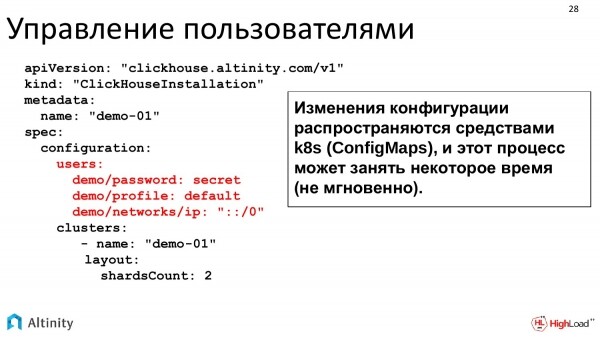
Mund ta shkruajmë drejtpërsëdrejti në YAML atë që duam. Të gjitha mundësitë e konfigurimit mapohen drejtpërsëdrejti nga ky YAML tek konfigurimet e ClickHouse, të cilat më pas shpërndahen në të gjithë klastrin.
Mund të shkruajmë edhe kështu. Ky është vetëm një shembull. Fjalëkalimi mund të bëhet e enkriptuar. Të gjitha mundësitë e konfigurimit të ClickHouse mbështeten. Këtu është vetëm një shembull.
Konfigurimi për klastri shpërndahet si ConfigMap. Në praktikë, përditësimi i ConfigMap-it nuk ndodh në mënyrë të menjëhershme, prandaj nëse klastri është i madh, procesi i shpërndarjes së konfigurimit zgjat disi. Por gjithçka është shumë e rehatshme në funksionim.
E rendim situatën më të komplikuar. Klusteri po zhvillohet. Ne duam të replikojmë të dhënat. Pra, kemi tashmë dy shard-e, me një replikë secili, të vendosur përdoruesit. Po rritemi dhe duam të merremi me replikimin.
Çfarë na nevojitet për replikimin?
Na nevojitet ZooKeeper. Në ClickHouse, replikimi ndërtohet duke përdorur ZooKeeper. ZooKeeper është i nevojshëm që replikat e ndryshme të ClickHouse të kenë konsensus në lidhje me cilat blloqe të dhënash ndodhen në cilin ClickHouse.
Mund të përdoren çfarëdo ZooKeeper-i. Nëse kompania ka një ZooKeeper të jashtëm, atëherë mund ta përdorim atë. Nëse jo, mund të instalojmë nga depoja jonë. Ka një installer që e bën këtë punë më të lehtë.
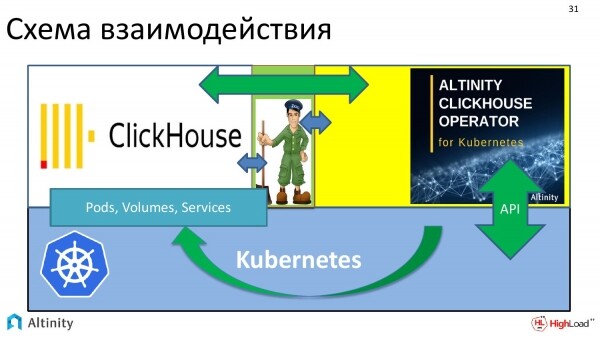
Këtu është skema e bashkëveprimit të gjithë sistemit. Kemi Kubernetes si platformë. Atje ekzekutohet operatori ClickHouse. ZooKeeper e kam paraqitur këtu. Dhe operatori bashkëpunon si me ClickHouse, ashtu edhe me ZooKeeper. Pra, kemi bashkëveprim.
Dhe gjithçka kjo është e nevojshme që ClickHouse të ngashmojë me sukses të dhënat në k8s.
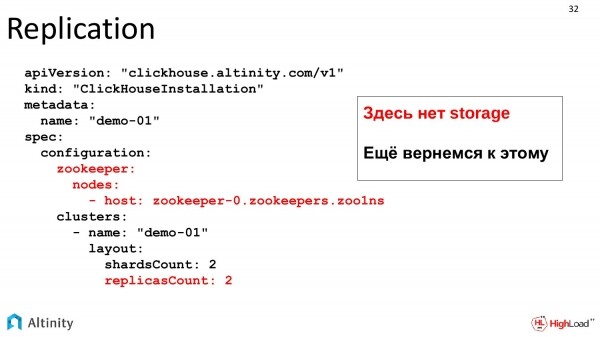
Tani le të shohim vetë detyrën, se si do të duket manifesti për replikimin.
Ne i shtojmë dy seksione manifestit tonë. E para – është se nga mund të marrë ZooKeeper, i cili mund të jetë brenda Kubernetes, ose të jashtme. Kjo është thjesht një përshkrim. Dhe kërkojmë replikat. Pra, ne duam dy replika. Në përfundim, do të kemi 4 pod-e. Për ruajtjen kujtojmë, ajo do të kthehet pak më vonë. Ruajtja është një këngë e veçantë.
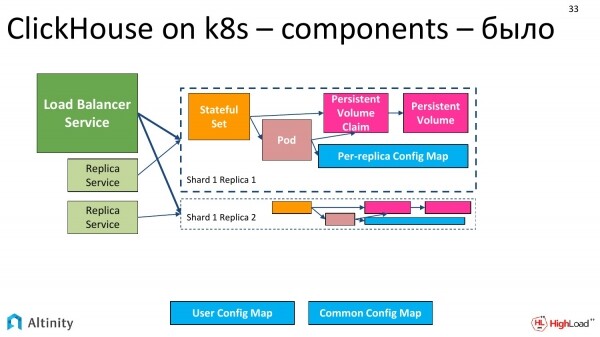
Ishte kështu.
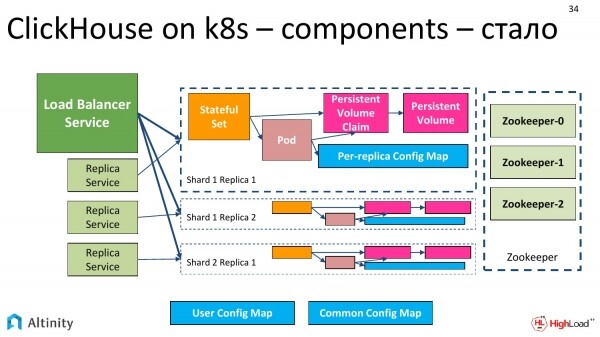
Bëhet kështu. Shtohen replikat. E katërta nuk u fut, ne besojmë që atje mund të ketë shumë. Dhe në anë shtohet ZooKeeper. Skemat po komplikohet.
Dhe erdhi koha të shtojmë detyrën tjetër. Do të shtojmë Ruajtje të Përhershme.
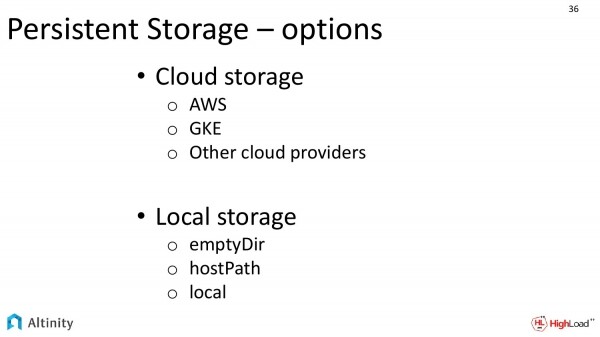 Për Ruajtjen e Përhershme kemi mundësi të ndryshme ekzekutimi.
Në rast se ne ekzekutojmë në një ofrues cloud, për shembull, duke përdorur Amazon, Google, ka një joshje të madhe për të përdorur ruajtjen cloud. Kjo është shumë e convenient, kjo është mirë.
Dhe ka një opsion tjetër. Kjo është për ruajtjen lokale, kur diskët janë lokale në çdo nod. Ky opsion është shumë më i komplikuar në ekzekutim, por në të njëjtën kohë është më i efektshëm.
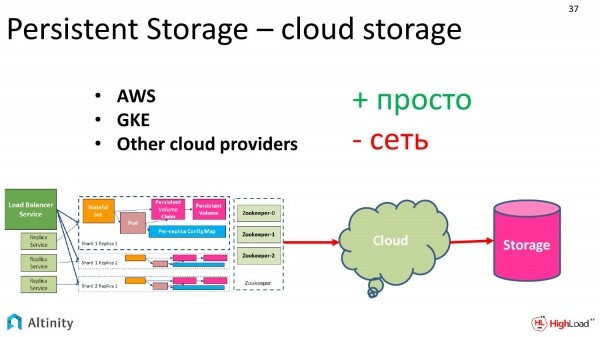
Le të shohim se çfarë kemi në lidhje me ruajtjen cloud.
Ka avantazhe. Është shumë e lehtë për t'u konfiguruar. Ne thjesht kërkojmë nga ofruesi cloud, që na jepni, ju lutem, ruajtjen e tillë me kapacitet të tillë, të këtij klasë. Klasat janë përshkruar nga ofruesit vetë.
Dhe ka një mangësi. Për dikë ky është një mangësi që nuk është kritike. Sigurisht, do të ketë ndonjë zhvillim të performancës. Është shumë i përshtatshëm për punë, i besueshëm, por ka disa rreziqe potenciale për performancën.
Dhe pasi ClickHouse fokusohet pikërisht në performancë, mund të themi se nxjerr maksimumin e mundshëm, prandaj shumë klientë përpiqen të nxjerrin maksimumin e performancës.
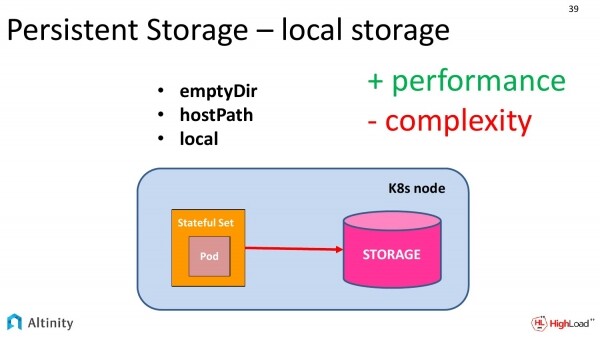
Dhe për të arritur maksimumin, na nevojitet ruajtja lokale.
Kubernetes ofron tre abstraksione për të përdorur ruajtjen lokale në Kubernetes. Këto janë:
- EmptyDir
- HostPath.
- Local
Le të shqyrtojmë se si ndryshojnë dhe si janë të ngjashëm.
Së pari, në të tre qasjet ruajtja përbën disqet lokale që ndodhen në të njëjtën nodë fizike k8s. Por ato kanë disa ndryshime.
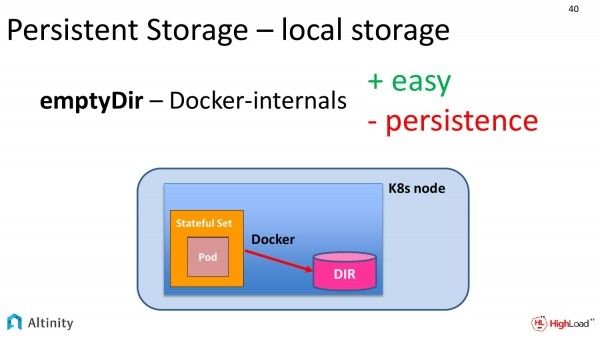
Të fillojmë me gjënë më të thjeshtë, pra me emptyDir. Çfarë është kjo në praktikë? Kjo është kur ne i kërkojmë sistemit të kontenjerëve (më shpesh është docker) që të na japë akses në një dosje në diskun lokal.
Në praktikë, docker krijon ndonjëherë një dosje të përkohshme në rrugët e tij të veta, e emërton atë me një hash të gjatë. Dhe ofron një ndërfaqe për aksesin në të.
Si do të funksionojë kjo për sa i përket performancës? Kjo do të funksionojë me shpejtësinë e diskut lokal, dmth. kjo është plotësisht e aksesueshme për diskun tuaj.
Por kjo ka një mangësi të vet. Persistente janë mjaft të dyshimta. Me lëvizjen e parë të dockers me kontejnerët, Persistente humbin. Nëse Kubernetes dëshiron, për ndonjë arsye, të transferojë këtë Pod në një disk tjetër, atëherë të dhënat humbasin.
Ky qasje është e mirë për teste, sepse shpejtësia tregon tashmë normale, por për diçka të rëndësishme ky variant nuk është i përshtatshëm.
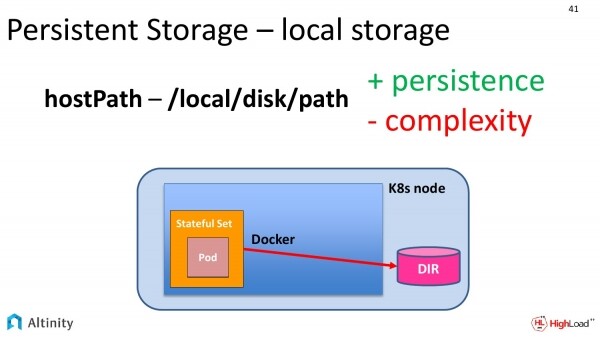
Prandaj ka një qasje të dytë. Kjo është hostPath. Nëse shikoni slajdin e kaluar dhe këtë, mund të shihni një vetëm dallim. Dosja është shkuar nga docker drejtpërdrejt në nodën Kubernetes. Këtu është pak më e thjeshtë. Ne shkruajmë direkt rrugën në sistemin e skedarëve vendas, ku do të doja të ruaja të dhënat e mia.
Avantazhet e këtij mënyre janë reale. Ky është tashmë një Persistent i vërtetë, madje klasik. Të dhënat tona do të shkruhen në disk në një adresë të caktuar.
Ka there dhe disavantazhe. Kjo është kompleksiteti i menaxhimit. Kubernetes-i ynë mund të dëshirojë të lëvizë një Pod në një nodë tjetër fizike. Dhe këtu hyn në lojë DevOps. Ai duhet të shpjegojë saktë të gjithë sistemit se lëvizja e këtyre pod'ëve mund të bëhet vetëm në ato nódë ku keni diçka të montuar dhe jo më shumë se një nodë në një kohë. Kjo është mjaft e komplikuar.
Për këto qëllime, ne si operator kemi krijuar shabllone për të fshehur gjithë këtë kompleksitet. Dhe do të ishte e mjaftueshme të thuash: 'Dua që të kem një instance ClickHouse për çdo nodë fizike dhe në këtë rrugë'.
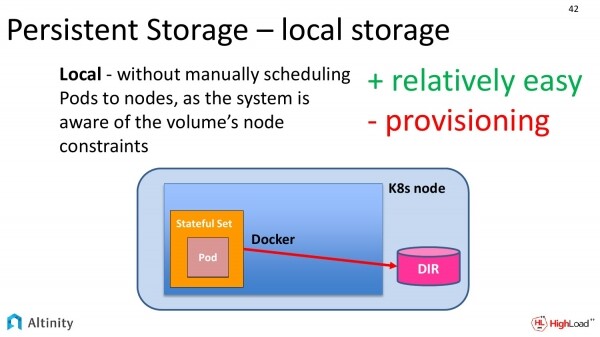
Por kjo nevojë nuk është vetëm për ne, prandaj gentlemanët nga Kubernetes-i vetë e kuptojnë se njerëzit duan të kenë akses në disqet fizike, prandaj ata ofrojnë një nivel të tretë.
Ai quhet local. Diferenca me sliden e mëparshme praktikisht nuk ka. Vetëm se më parë duhej të bënim me dorë që këto pod'ë nuk mund të lëvizeshin nga një nodë në një tjetër, sepse ata duhet të ishin të lidhur për një rrugë të tillë me disqin fizik lokal, dhe tani të gjitha këto njohuri inkapsulohen vetë në Kubernetes. Dhe bëhet shumë më e thjeshtë për t'u konfiguruar.
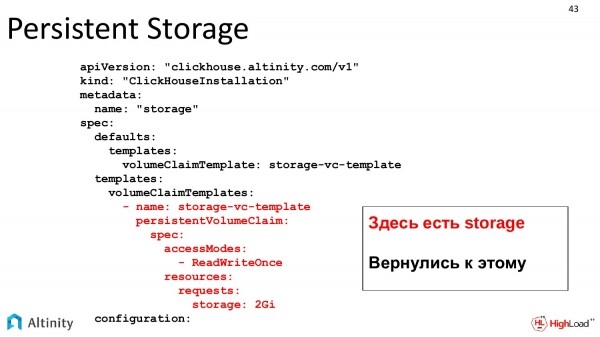
Të kthehemi në detyrën tonë praktike. Të kthehemi në shabllonin YAML. Këtu kemi një storage të vërtetë. Jemi rikthyer në këtë. Ne përcaktojmë një shabllon klasike VolumeClaim si në k8s. Dhe përshkruajmë se çfarë storage-i duam.
Pas kësaj, k8s do të kërkojë storage. Do ta ndajë atë në StatefulSet. Dhe në fund do ta kemi në dispozicion ClickHouse.
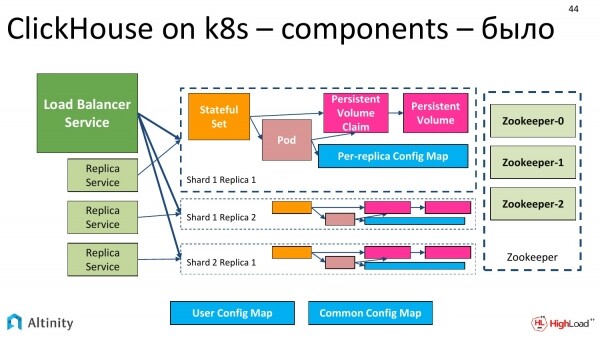
Ishte një skemë e tillë. Storage-i ynë i Përhershëm ishte e kuqe, që siç do të na nxiste ta bënim atë.
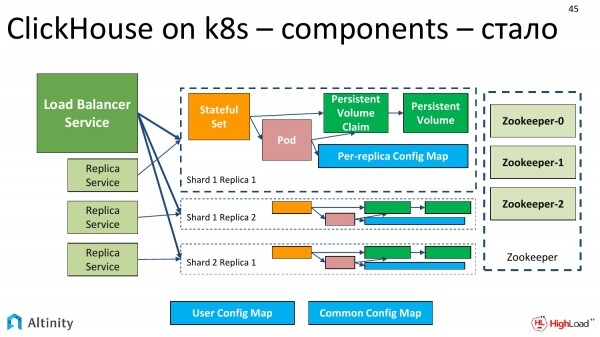
Dhe ajo bëhet e gjelbër. Tani skema e klasterit ClickHouse mbi k8s është plotësisht finalizuar. Kemi sharde, replika, ZooKeeper, kemi një Persistent të vërtetë, i cili realizohet në një mënyrë ose një tjetër. Skema tashmë është plotësisht funksionale.
Ne vazhdojmë të jetojmë. Klasteri ynë po zhvillohet. Dhe Алексей po përpiqet, duke lëshuar një version të ri të ClickHouse.
Shkaktohet një detyrë praktike – të testojmë versionin e ri të ClickHouse në klasterin tonë. Dhe, natyrisht, nuk dëshirojmë ta përditësojmë krejt, dëshirojmë ta vendosim një version të ri në një replika ndoshta në një qoshe të largët, dhe ndoshta jo një version të ri, por dy menjëherë, pasi ato dalin shpesh.
Çfarë mund të themi për këtë?
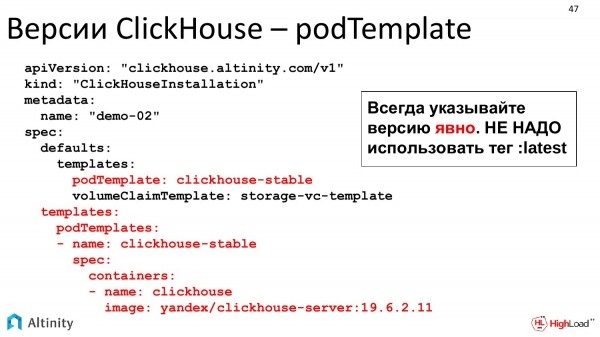
Këtu kemi pikërisht një mundësi të tillë. Këto janë shabllonë pod’ash. Mund të detajojmë, operatori ynë lejon plotësisht ndërtimin e një klasteri heterogjen. Domethënë, konfigurojmë nga të gjitha replikat në grumbull, deri te çdo replikë individuale me versionin që duam për ClickHouse, cilin version duam për storage. Mund të konfigurojmë plotësisht një klaster me konfigurimin që na nevojitet.
Tani do të thellojmë pak më shumë. Deri tani kemi folur se si funksionon ClickHouse-operatori në lidhje me specifikat e ClickHouse.
Tani do doja të thosha disa fjalë mbi mënyrën se si funksionon çdo operator, si dhe si bashkëvepron me K8s.
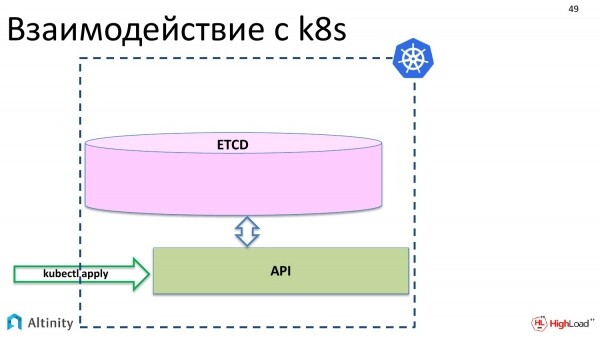
Le të shqyrtojmë bashkëveprimin me K8s për fillim. Çfarë ndodh kur bëjmë kubectl apply? Objekte tona shfaqen përmes API në etcd.
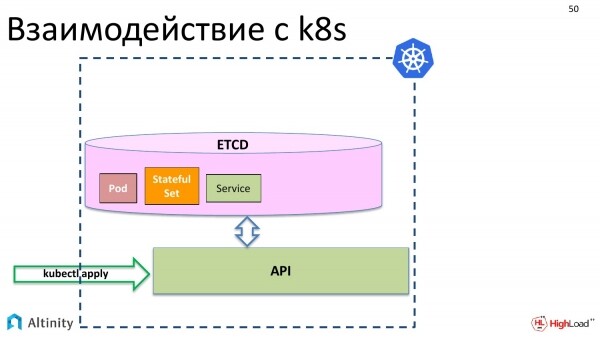
Për shembull, objektet bazë të Kubernetes: pod, StatefulSet, shërbim dhe kështu me radhë.
Megjithatë, asgjë fizike nuk ndodh ende. Këto objekte duhet të materializohen në klaster.
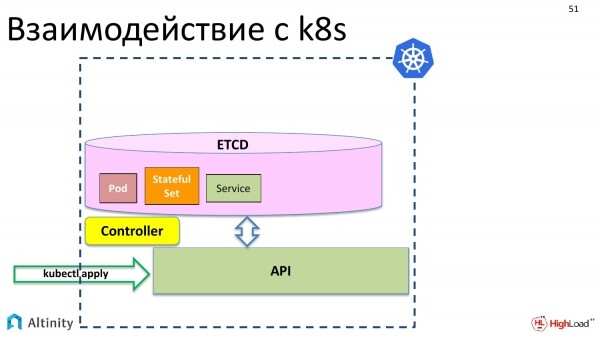
Për këtë, shfaqet kontrolluesi. Kontrolluesi është një komponent i veçantë K8s që di si të materializojë këto përshkrime. Ai di se çfarë dhe si duhet bërë fizikisht. Ai di si të aktivizojë kontejnerët, çfarë duhet të konfigurohet në mënyrë që serveri të funksionojë.
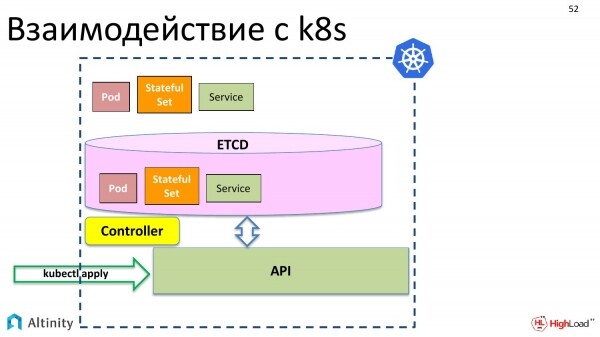
Dhe ai materializon objektet tona në K8s.
Por ne duam të operojmë jo vetëm me pod-a, StatefulSet-a, por duam të krijojmë ClickHouseInstallation, domethënë, një objekt të tipit ClickHouse, për ta operuar si një njësi të vetme. Aktualisht, kjo mundësi nuk ekziston.
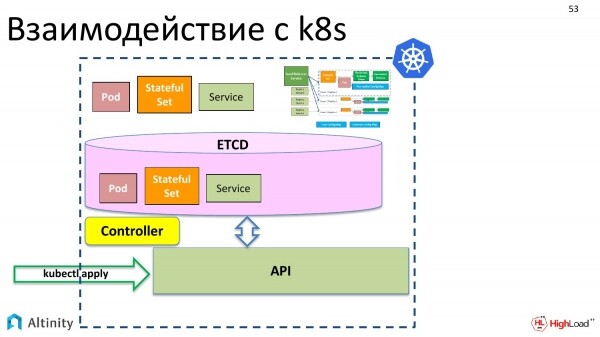
Por K8s ka diçka tjetër të këndshme. Ne duam që të kemi ndonjëherë një entitet të tillë të komplikuar, në të cilin do të ishte i grumbulluar klasteri ynë nga pod’ash dhe StatefulSet.
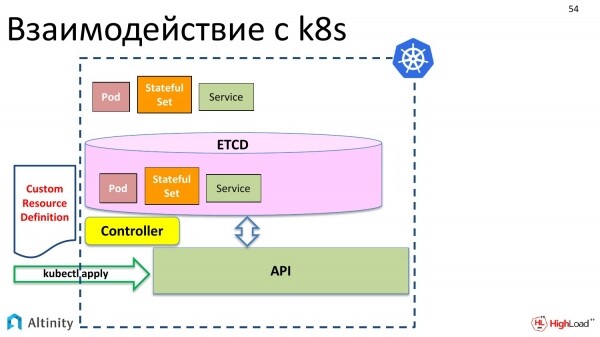
Dhe çfarë duhet të bëjmë për këtë? Së pari, dalin përpara Definimi i Burimeve të Personalizuara. Çfarë është kjo? Ky është një përshkrim për K8s që do të kemi një lloj të dhënash të tjera, që dëshirojmë të shtojmë një burim të personalizuar në pod, StatefulSet, i cili do të jetë kompleks brenda. Ky është një përshkrim i strukturës së të dhënave.
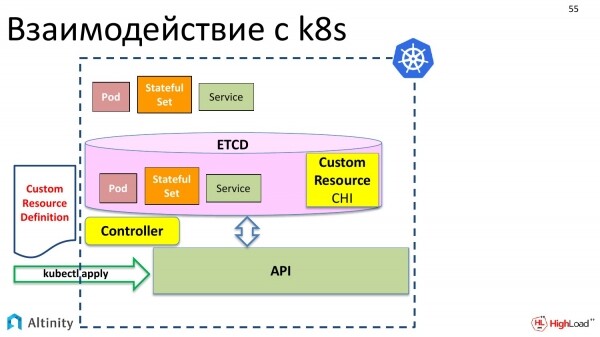
Ne e dërgojmë gjithashtu atë përmes kubectl apply. Kubernetes e pranoi me gëzim.
Dhe tani kemi në ruajtje, te objekti në etcd, mundësinë për të regjistruar një burim të personalizuar me emrin ClickHouseInstallation.
Por tani, asgjë më tej nuk do të ndodhë. Që do të thotë, nëse tani krijojmë një skedar YAML, i cili e kemi shqyrtuar me përshkrimin e shardit, replika dhe themi "kubectl apply", Kubernetes do ta pranojë, do ta vendosë në etcd dhe do të thotë: "Mirë, por nuk di çfarë të bëj me të. Si ta menaxhoj ClickHouseInstallation nuk e di."
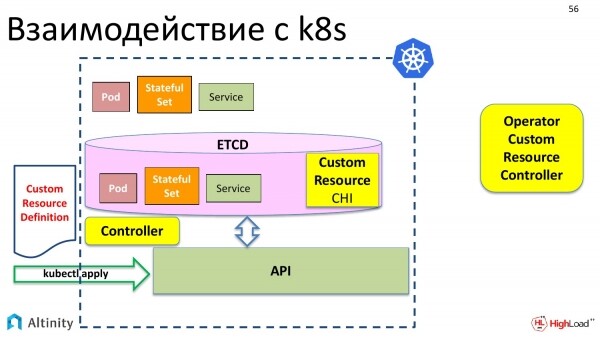
Prandaj, na nevojitet dikush që do të ndihmojë Kubernetes të menaxhojë një lloj të ri të dhënash. Nga ana e majtë kemi një kontrollues të rregullt të Kubernetes, i cili punon me llojet e zakonshme të të dhënave. Ndërsa nga ana e djathtë duhet të shfaqet një kontrollues personalizuar, i cili di të punojë me llojet e personalizuara të të dhënave.
Dhe ndryshe quhet operator. E kam nxjerrë këtu jashtë Kubernetes, sepse ai mund të ekzekutohet edhe jashtë K8s. Në shumicën e rasteve, sigurisht, të gjithë operatorët ekzekutohen në Kubernetes, por asgjë nuk e pengon atë të qëndrojë jashtë, prandaj këtu është nxjerrë veçmas.
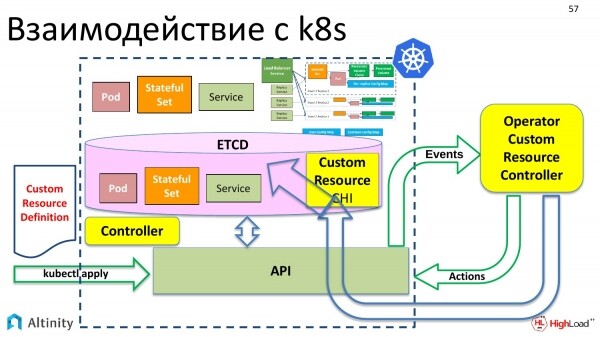
Dhe tashmë kontrolluesi personalizuar, i njohur si operator, bashkëvepron me Kubernetes përmes API-së. Ai tashmë di të bashkëveprojë me API-në. Dhe ai tashmë di si të materializojë një skemë të komplikuar nga burimi personalizuar, që dëshirojmë të krijojmë. Këtë saktësisht bën operatori.
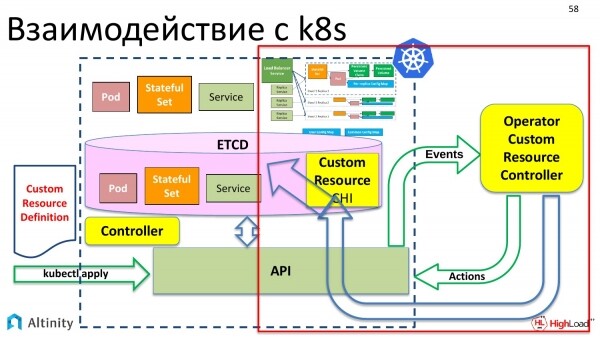
Si funksionon operatori? Le të hedhim një sy në anën e djathtë për të zbuluar se si e bën këtë. Do të kuptojmë se si operatori materializon gjithçka dhe si vazhdon bashkëveprimi me K8s.
Operatori është një program. Ai është i orientuar nga ngjarjet. Operatorin me anë të API-së së Kubernetes nënshkruan për ngjarje. Në API-në e Kubernetes ka pika hyrëse ku mund të nënshkruhen ngjarje. Dhe nëse diçka ndryshon në K8s, atëherë Kubernetes dërgon ngjarje te të gjithë ata që e duan, dmth. ai që është nënshkruar në këtë pikë API do të marrë njoftime.
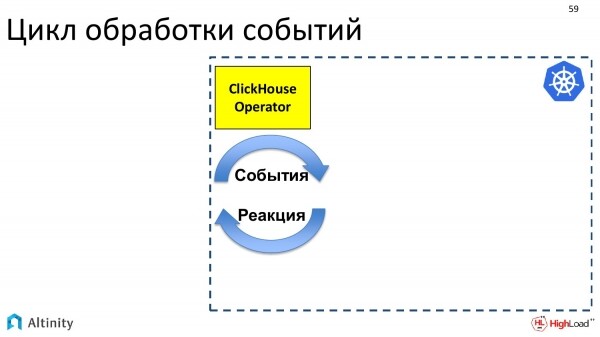
Operatori nënshkruhet për ngjarje dhe duhet të bëjë ndonjë reagim. Detyra e tij është të reagojë ndaj ngjarjeve që shfaqen.
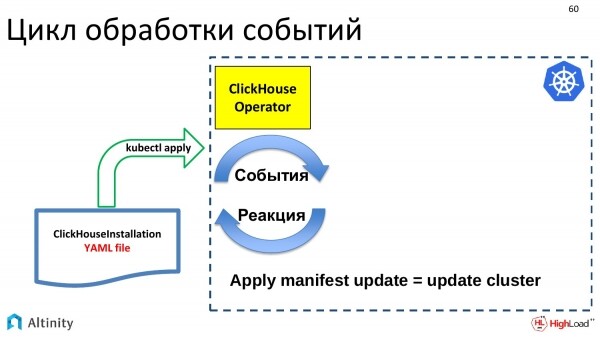
Ngjarjet gjenerohen nga disa azhurnime. Vjen skedari ynë YAML me përshkrimin e ClickHouseInstallation. Ai shkoi në etcd përmes kubectl apply. Aty ndodhi një ngjarje, dhe në përfundim, kjo ngjarje erdhi në ClickHouse-operator. Operatori mori këtë përshkrim. Dhe ai duhet të bëjë diçka. Nëse ka ardhur një azhurnim në objektin ClickHouseInstallation, atëherë duhet të azhurnojmë klasterin. Dhe detyra e operatorit është të azhurnojë klasterin.
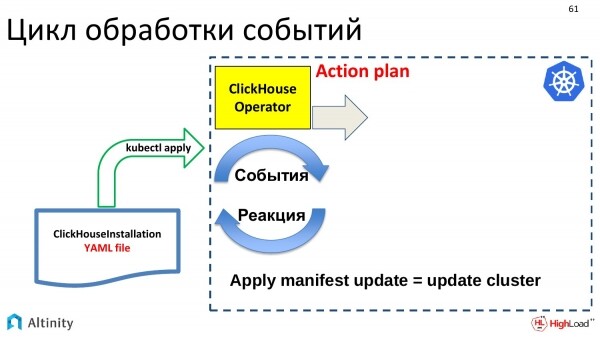
Çfarë bën ai? Së pari, duhet të hartojmë një plan veprimi, se çfarë do të bëjmë me këtë përditësim. Përditësimet mund të jenë shumë të vogla, dmth, të vogla në aplikimin YAML, por mund të sjellin ndryshime shumë të mëdha në klaster. Prandaj, operatori krijon një plan dhe më pas e ndjek atë.
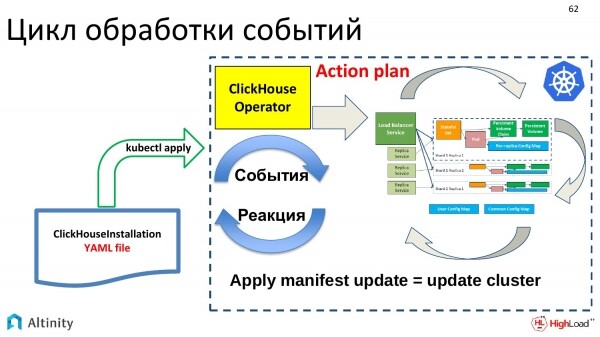
Ai fillon sipas këtij plani të krijojë këtë strukturë brenda, për të materializuar pod’ët, shërbimet, dmth, të bëjë atë që është detyra e tij kryesore. Është si ndërtimi i një klasteri ClickHouse në Kubernetes.
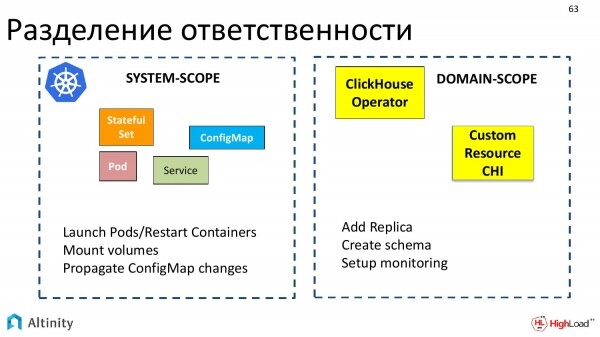
Tani le të prekim një gjë interesante. Ky është ndarja e përgjegjësisë midis Kubernetes dhe operatorit, dmth, çfarë bën Kubernetes, çfarë bën operatori dhe si interaktojnë ata me njëri-tjetrin.
Kubernetes është përgjegjës për gjërat sistemore, dmth, për grupin bazë të objekteve, që mund të interpretohen si sistem i gjerë. Kubernetes di si të nisë pod’ët, si të rihapë konteinerët, si të bëjë mount volumes, si të punojë me ConfigMap, dmth, gjithçka që mund të quhet sistem.
Operatorët operojnë në fushat tematike. Çdo operator bëhet për fushën e tij tematike. Ne e bëmë për ClickHouse.
Dhe operatori ndërvepron pikërisht në terma të fushës tematike, siç janë shtimi i një kopjeje, krijimi i një skeme, konfigurimi i monitorimit. Kështu krijohet një ndarje.
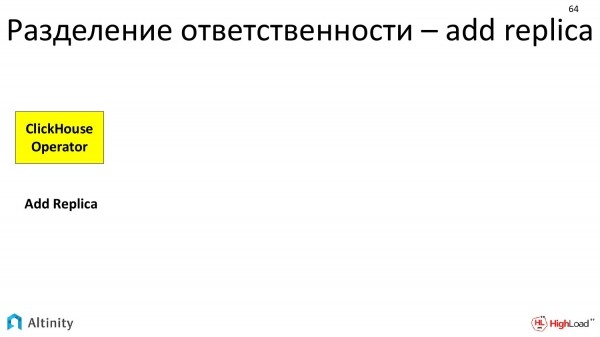
Le të shikojmë një shembull praktik, si ndodh kjo ndarje përgjegjësish kur ne performojmë veprimin shto një kopje.
Në operator vjen detyra – shto një kopje. Çfarë bën operatori? Operatorit do të llogarisë se duhet të krijojë një StatefulSet të ri, në të cilin duhet të përshkruajë disa shabllone, kërkesën për volume.
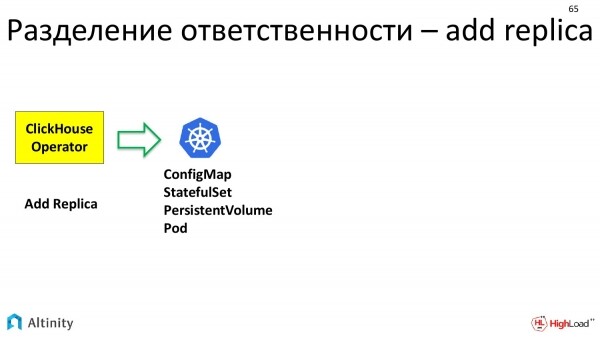
Ai e përgatit gjithçka dhe e kalon më tej në K8s. I thotë se i nevojitet ConfigMap, StatefulSet, Volume. Kubernetes punon. Ai materializon njësitë bazë me të cilat operon.
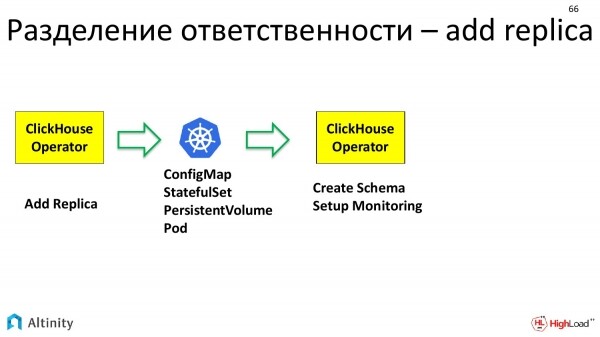
Dhe më pas përsëri ndërhyn ClickHouse-operatori. Ai tashmë ka një pod fizik, në të cilin mund të bëjë diçka. Dhe ClickHouse-operatori punon përsëri në terma të fushës tematike. Pra, konkretisht për ClickHouse, për të përfshirë një kopje në klaster, duhet, së pari, të konfigurohet skema e të dhënave që ka ky klaster. Dhe së dyti, kjo kopje duhet të përfshihet në monitorim, në mënyrë që të jetë e lehtë për t'u ndjekur. Kjo tashmë e konfigurimin nga operatori.
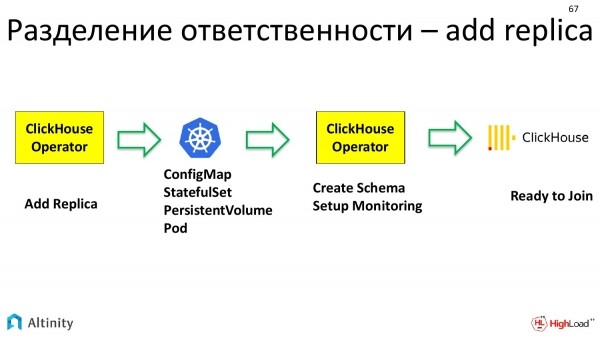
Dhe vetëm pas kësaj merr pjesë vetë ClickHouse, pra një entitet tjetër më i lartë. Kjo është tashmë një bazë të dhënash. Ajo ka instancën e saj, një replikë të re konfiguruar, e cila është e gatshme të bashkohet me klasterin.
Pra, krijohet një zinxhir për执行和分责任在添加复制品 është mjaft i gjatë.
Të vazhdojmë me detyrat tona praktike. Nëse klasteri tashmë ekziston, mund të kryhet migrimi i konfiguracionit.
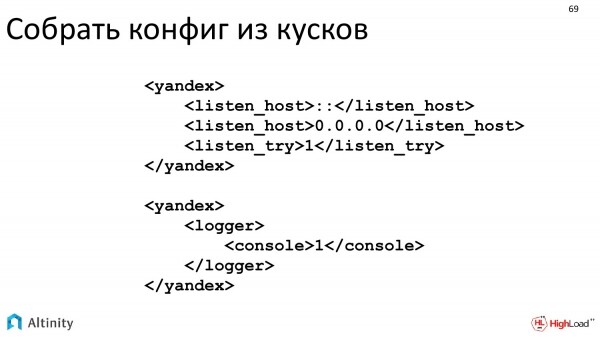
Ne e bëmë që në xml ekzistues, i cili kuptohet nga ClickHouse, mund të kalojnë përmes.
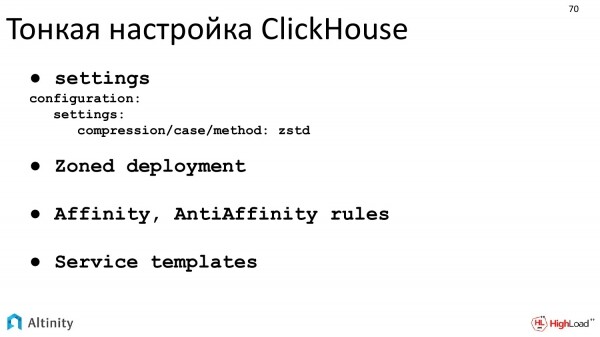
Mund të bëhet një konfigurim i saktë i ClickHouse. Pikërisht implementimi me zona është ajo për të cilën flasja gjatë shpjegimit të hostPath, ruajtjes lokale. Kështu është siç duhet të bëhet implementimi me zona.
Detyra e ardhshme praktike është monitorimi.
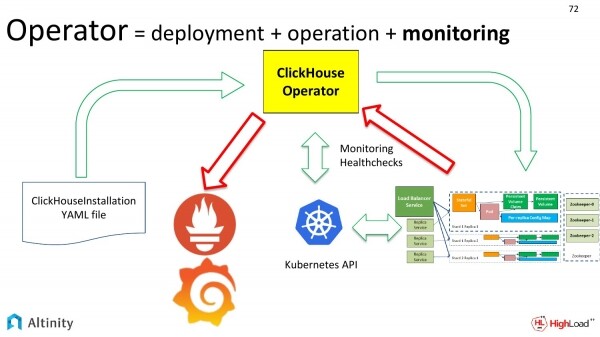
Nëse klasteri ynë ndryshon, duhet të përshtatni monitorimin periodikisht.
Le të shqyrtojmë skemën. Ne kemi shqyrtuar tashmë стрелките зелене. Tani le të shqyrtojmë стрелките e kuqe. Ky është mënyra si duam të monitorojmë klasterin tonë. Si metrikat nga klasteri ClickHouse kalojnë në Prometheus dhe më pas në Grafana.
Dhe cila është vështirësia me monitorimin? Pse ky proces nxirret si një arritje? Vështirësia është pikërisht në dinamike. Kur kemi një klaster dhe ai është static, mund të konfigurojmë monitorimin një herë dhe më pas të mos shqetësohemi më.
Por nëse kemi shumë klastere, ose gjithmonë diçka ndryshon, procesi është dinamik. Dhe të bësh rregullime të vazhdueshme në monitorim është një humbje burimesh dhe kohe, pra madje është vetëm mëndje. Kjo duhet automatizuar. Vështirësia është pikërisht në dinamikën e procesit. Dhe operatori e automatizon këtë shumë mirë.
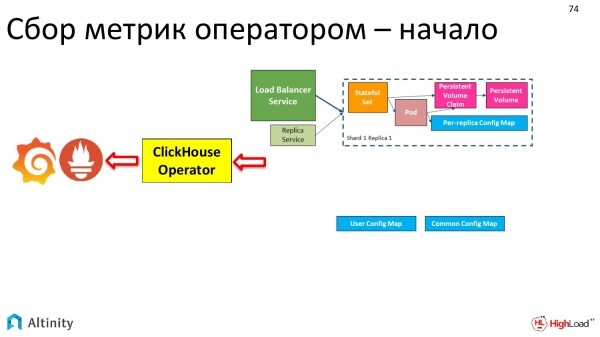
Si u zhvillua klasteri ynë? Në fillim ai ishte kështu.
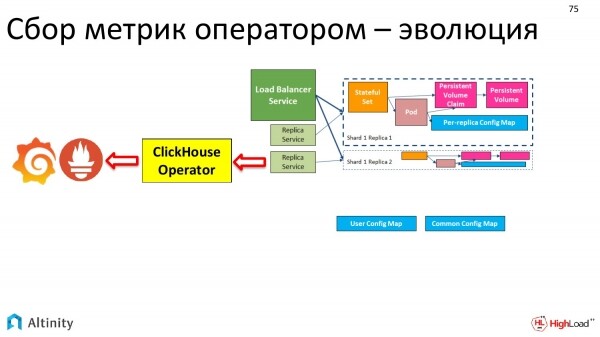
Pastaj ai ishte kështu.
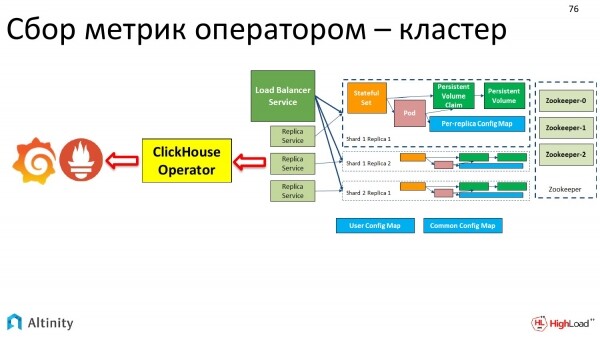
Në fund, ai u bë kështu.
Dhe monitorimi bëhet automatikisht nga operatori. Një pikë e vetme hyrjeje.
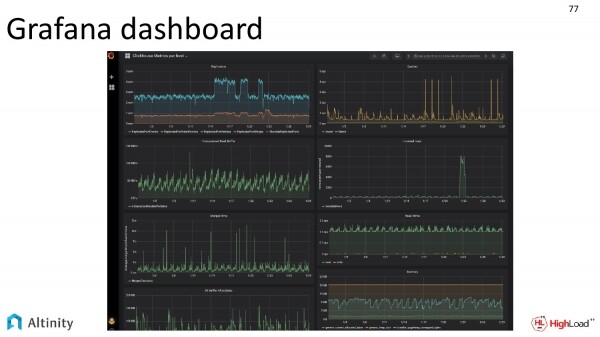
Dhe ne vetëm shikojmë të dhënat në Grafana dashboard, si po jeton klasteri ynë brenda.
Për më tepër, Grafana dashboard shpërndahet gjithashtu me operatorin tonë direkt në burimin. Mund ta lidhni dhe ta përdorni. Ky është screenshot-i që na dha DevOps-i ynë.
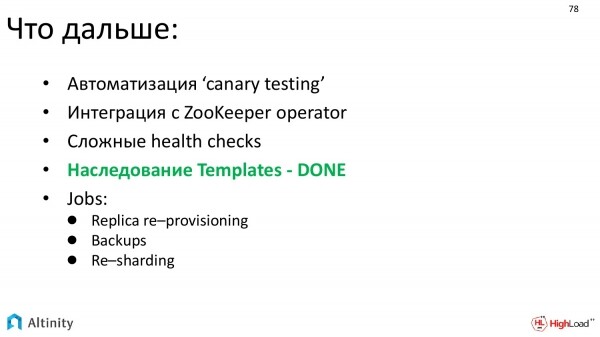
Ku dëshirojmë të shkojmë më tej? Kjo është:
- Të zhvillojmë automatizimin e testimit. Detyra kryesore është testimi automatik i versioneve të reja.
- Ne duam shumë të automatizojmë integrimin me ZooKeeper. Gjithashtu, kemi në plan të integrohemi me ZooKeeper-operator. Domethënë, për ZooKeeper është shkruar një operator dhe është logjike që dy operatorë të fillojnë të integrohen për të ndërtuar një zgjidhje më të përshtatshme.
- Duam të bëjmë verifikime më të komplikuara të jetëgjatësisë.
- E theksova me gjelbër atë që na pret trashëgimi e Templates – PUNË E PLOTË, domethënë me versionin e ardhshëm të operatorit do të kemi tashmë trashëgimi të shabllonëve. Ky është një mjet i fuqishëm që lejon ndërtimin e konfigurimeve të komplikuara nga pjesët.
- Dhe ne duam automatizimin e detyrave komplekse. Kryesorja nga to është Re-sharding.
Le të bëjmë një përmbledhje ndërmjetës.
Çfarë marrim në fund? Dhe a ja vlen të merremi me këtë apo jo? A duhet të përpiqemi të tërheqim bazën e të dhënave në Kubernetes dhe të përdorim operatorin në përgjithësi dhe Alitnity-operatorin në veçanti.
Në fund marrim:
- Një thjeshtim dhe automatizim të konsiderueshëm të konfigurimit, zhvillimit, si dhe mbështetjes.
- Monitoring i integruar menjëherë.
- Dhe shabllone të kodifikuara të gatshme për situata komplekse. Veprime si të shtosh një replikë nuk duhet të bëhen me dorë. Këtë e bën operatori.
Ka mbetur vetëm një pyetje e fundit. Ne tashmë kemi bazën e të dhënave në Kubernetes, virtualizim. Si është performanca e një zgjidhjeje të tillë, duke marrë parasysh se ClickHouse është optimizuar për performancë?
Përgjigja është – gjithçka është në rregull! Nuk do e shpjegoj në detaje, ky është një temë e një raporti tjetër.
Por ka një projekt të tillë si TSBS. Cila është qëllimi i tij kryesor? Ky është një test për performancën e bazave të të dhënave. Kjo është një përpjekje për të krahasuar të ngrohtat me të ngrohta, të butat me të buta.
Si funksionon ai? Gjenerohet një grup i dhënash. Pastaj ky grup i dhënash kalon në teste të njëjta mbi baza të ndryshme të të dhënave. Dhe çdo bazë të dhënash zgjidh një problem ashtu siç di të bëjë. Më pas mund të krahasosh rezultatet.
Ai tashmë mbështet një mori të madhe bazash të të dhënave. Kam theksuar tre kryesoret. Këto janë:
- TimescaleDB.
- InfluxDB.
- ClickHouse.
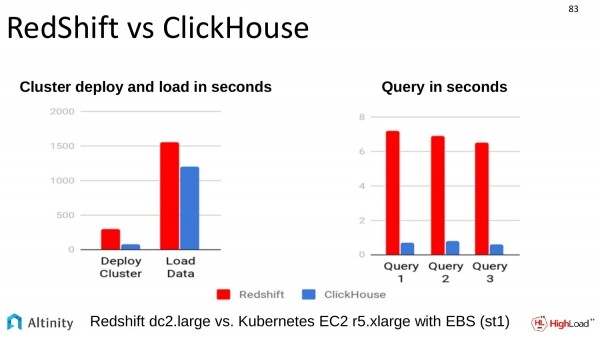
Gjithashtu, është bërë një krahasim me një zgjidhje tjetër të ngjashme. Krahasimi me RedShift. Krahasimi është bërë në Amazon. ClickHouse gjithashtu e tejkalon të gjitha në këtë aspekt.
Cilat përfundime mund të nxirren nga ajo që kam treguar?
- DB në Kubernetes është i mundur. Më vjen keq, ndoshta mund të jetë çdo lloj, por në përgjithësi duket se është e mundur. ClickHouse në Kubernetes me siguri është e mundur falë operatorit tonë.
- Operatori ndihmon në automatizimin e proceseve dhe vërtet lehtëson jetën.
- Performanca është normale.
- Dhe, na duket se kjo mund dhe duhet të përdoret.
Open source – bashkohuni!
Siç kam thënë më parë, operatori është një produkt plotësisht open source, prandaj do të ishte shumë e mirë nëse numri maksimal i njerëzve e përdor atë. Bashkohuni! Ne po ju presim ju të gjithë!
Faleminderit të gjithëve!
Pyetje
Faleminderit për raportin! Unë quhem Anton. Jam nga kompania SEMrush. Më intereson çështja e logimit. Për monitorimin ka informacion, por për logimin asgjë, nëse flasim për klasterin në tërësi. Ne, për shembull, kemi ngritur një klaster në pajisje. Dhe ne përdorim logimin qendror, mbledhim me mjete standarde në një grumbull të përbashkët. Dhe pastaj e nxjerrim informacionin që na intereson nga atje.
Një pyetje e mirë, pra, logimi është në listën e punëve. Operator nuk e automatizon ende këtë. Ai ende po zhvillohet, projekti është ende mjaft i ri. Ne e kuptojmë domosdoshmërinë e logimit. Kjo gjithashtu është një temë shumë e rëndësishme. Dhe ndoshta nuk është më pak e rëndësishme se monitorimi. Por e para në listën për realizim ka qenë monitorimi. Logimi do të vijë. Ne, natyrisht, përpiqemi të automatizojmë të gjitha aspektet e jetës së klasterit. Prandaj përgjigjja – për momentin operatori, fatkeqësisht, nuk e di këtë, por është në planet tona, do ta bëjmë. Nëse keni dëshirë të bashkoheni, atëherë bëni një pull request, ju lutem.
Përshëndetje! Faleminderit për raportin! Kam një pyetje standarde, të lidhur me Vëllimet e Përhershme. Kur krijojmë një konfiguracion me këtë operator, si e përcakton operatori se në cilin nodë është montuar ndonjë disk, ose dosje? A duhet ta sqarojmë paraprakisht se, ju lutem, vendosni ClickHouse tonë pikërisht në këto nodë, në të cilat ka disk?
Sipas asaj që kuptoj, kjo pyetje është një vazhdim i ruajtjes lokale, veçanërisht pjesës së saj për hostPath. Është si të shpjegosh gjithë sistemin se duhet që pod-i të jetë aktivizuar pikërisht në një nodë të tillë, në të cilën kemi disk fizik të lidhur, i cili është montuar në një rrugë të tillë. Kjo është një seksion e tërë, të cilin e kam prekur shumë sipërfaqësisht, sepse përgjigjja është mjaft e gjatë.
Në thelb, kjo duket kështu. Natyrisht, na nevojitet të bëjmë provisioning të këtyre volumes. Aktualisht, në storage lokal nuk ka provisioning dinamik, prandaj DevOps duhet të krijojnë vetë diskët, këto volumes. Ata duhet të shpjegojnë Kubernetes provisioning, se do të keni Persistent volumes të një klase të caktuar, të cilat ndodhen në node të caktuar. Më pas, duhet të shpjegohet Kubernetes, se pod’ët që kërkojnë një klasë të tillë storage lokal, duhet të planifikohen vetëm në ato node, përmes labels. Për këto qëllime, operatori ka mundësinë të caktojë një label dhe one per host instance. Dhe do të rezultojë se pod’ët do të rregullohen nga Kubernetes për t'u nisur vetëm në node që përmbushin kërkesat e labels, duke folur në terma të thjeshtë. Administratorët caktojnë labels, bëjnë provisioning të diskëve manualisht. Dhe atëherë kjo do të shkallëzohet.
Dhe pikërisht opsioni i tretë lokal ndihmon ta lehtësojë këtë. Siç e kam theksuar, është një punë e imët e konfigurimit, që në fund ndihmon për të arritur performancën maksimale.
Kam një pyetje tjetër, e lidhur me këtë. Kubernetes është menduar kështu, që nuk ka rëndësi nëse humbim apo jo një node. Çfarë duhet të bëjmë në këtë rast, nëse e humbëm node’in ku ndodhet një shard?
Po, Kubernetes origjinalisht është pozicionuar që marrëdhënia jonë me pod’ët tanë është si me bagëtitë, por këtu çdo disk bëhet si një kafshë e dashur. Ka një problem, që nuk mund t'i hedhim ata thjesht kështu. Dhe zhvillimi i Kubernetes shkon në drejtimin që nuk është e mundur të shohim gjithçka filozofikisht si burime që mund të hidhen plotësisht.
Tani, një pyetje praktike. Çfarë të bëni, nëse ju ka humbur një node, në të cilin ishte disk? Këtu, detyra zgjidhet në një nivel më të lartë. Në rastin e ClickHouse, kemi replika që punojnë në një nivel më të lartë, pra në nivelin e ClickHouse.
Cila është dispozita rezultuese? Për të siguruar që të dhënat të mos humbin është përgjegjësi e DevOps. Ai duhet ta konfiguronte siç duhet replikimin dhe duhet të përpiqet që replikimi të ekzekutohet. Në replikën në nivelin e ClickHouse, të dhënat duhet të jenë të duplikatuara. Kjo nuk është një detyrë që e zgjidh operatori. Dhe nuk është një detyrë që e zgjidh vetë Kubernetes. Kjo është në nivelin e ClickHouse.
Çfarë duhet të bëni nëse një nodë e fortë ka rënë? Duket se do të duhet të vendosni një të dytë, ta konfiguroni siç duhet diskun, dhe të aplikoni etiketat. Pas kësaj, ajo do të përmbushë kërkesat që Kubernetes mund të fillojë një instancë pod-i mbi të. Kubernetes do ta nisë atë. Numri juaj i pod-eve nuk është i mjaftueshëm sipas kërkesave. Ajo do të kalojë nëpër ciklin që unë tregova. Dhe në nivelin më të lartë, ClickHouse do të kuptojë që kemi një replikë, ajo është ende bosh dhe duhet të fillojmë të transferojmë të dhëna mbi të. Pra, ky proces është ende pak i automatizuar.
Faleminderit për elaborimin! Kur ndodhin disa gjëra të këqija, operatori bie dhe rilansohet, dhe në këtë moment ndodhin ngjarje, a e përpunoni ndonjëherë atë?
Çfarë do të ndodhë nëse operatori ka rënë dhe është rilansuar, apo jo?
Po. Dhe në këtë moment kanë ndodhur ngjarje.
Detyra, çfarë të bëjmë në këtë rast, ndahen pjesërisht midis operatorit dhe Kubernetes. Kubernetes ka mundësinë të riprodhojë ngjarjen që ndodhi. Ai e riprodhon. Dhe detyra e operatorit është të sigurojë që kur i bëhet riprodhimi i logjeve të ngjarjeve, këto ngjarje të jenë idempotente. Dhe për të siguruar që përsëritja e të njëjtës ngjarje nuk shkakton dëme në sistemin tonë. Dhe operatori ynë e kryen këtë detyrë.
Përshëndetje! Faleminderit për elaborimin! Dmitry Zavyalov, kompani Smedova. A është planifikuar shtimi i mundësisë së konfigurimit me haproxy në operator? Më intereson ndonjë balancues tjetër përveç standardit, në mënyrë që të jetë inteligjent dhe të kuptojë se çfarë është realisht ClickHouse.
A po flisni për Ingress?
Po, zëvendësoni Ingress me haproxy. Në haproxy mund të specifikoni topologjinë e klasterit, ku ndodhen replikat.
Derisa ne nuk kemi menduar për këtë. Nëse ju nevojitet dhe mund të shpjegoni pse është e nevojshme, mund ta realizojmë, në veçanti nëse dëshironi të merrni pjesë. Ne do ta shqyrtojmë me kënaqësi këtë mundësi. Përgjigjja e shkurtër – jo, për momentin nuk kemi një funksionalitet të tillë. Faleminderit për sugjerimin, ne do ta shqyrtojmë atë. Nëse gjithashtu shpjegoni rastin e përdorimit dhe pse është e nevojshme në praktikë, për shembull, krijoni issues në GitHub, do të ishte mrekulli.
Ajo ekziston tashmë.
Mirë. Ne jemi të hapur për çdo propozim. Dhe haproxy po shtohet në listën e punëve për t'u bërë. Lista e punëve për t'u bërë po rritet, dhe jo pakësohet për momentin. Por kjo është e mirë, do të thotë që produkti është i kërkuar.
Burimi: habr.com
