

Shën. përkth.: Në këtë artikull, kompania Banzai Cloud ndan një shembull të përdorimit të utilitarëve të saj të veçantë për të lehtësuar operimin e Kafka brenda Kubernetes. Udhëzimet e dhëna ilustrojnë se si mund të përcaktoni madhësinë optimale të infrastrukturës dhe të konfiguroni Kafka për të arritur kapacitetin e nevojshëm të kalimit.
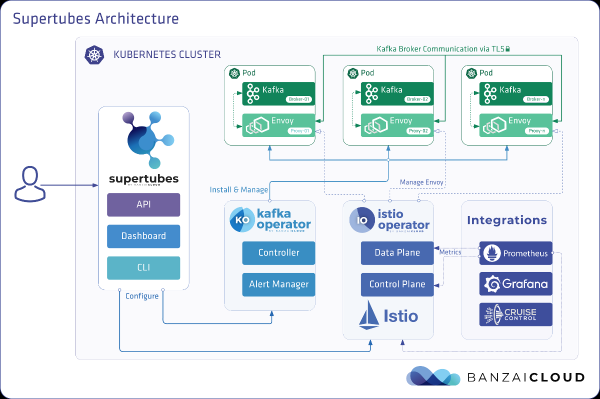
Apache Kafka është një platformë e shpërndarë për rrjedhjen e të dhënave, e cila lejon krijimin e sistemeve të besueshme, të shkallëzueshme dhe me performancë të lartë të rrjedhave në kohë reale. Mundësitë e saj të jashtëzakonshme mund të zgjerohen përmes Kubernetes. Për këtë, ne zhvilluam dhe një mjet të quajtur . Këto lejojnë ekzekutimin e Kafka në Kubernetes dhe përdorimin e funksioneve të saj të ndryshme, si konfigurimi i detajuar i brokerit, shkallëzimi në bazë të metrikeve me rimbalancim, ndjeshmëria ndaj raftit (rack awareness), dhe (graceful) lëshimi i përditësimeve, etj.
Provo Supertubes në klastrin tënd:
curl https://getsupertubes.sh | sh dhe supertubes install -a --no-democluster --kubeconfigOse kontakto . Gjithashtu, mund të lexoni rreth disa mundësive të Kafka, me të cilat punësohet automatikisht përmes Supertubes dhe operatorit të Kafka. Për to, ne kemi shkruar tashmë në blog:
- ;
- ;
- ;
- ;
- ;
- ;
- .
Duke vendosur të vendosni një klaster Kafka në Kubernetes, sigurisht që do të përballeni me problematikën e përcaktimit të madhësisë optimale të infrastrukturës bazë dhe nevojës për të optimizuar në detaje konfigurimin e Kafka për të përmbushur kërkesat për kapacitetin e kalimit. Performanca maksimale e çdo brokeri përcaktohet nga performanca e komponentëve të infrastrukturës në bazën e tij, siç janë memorja, procesori, shpejtësia e diskut, kapaciteti i rrjetit, etj.
Idealisht, konfigurimi i brokerit duhet të jetë i tillë që të gjithë elementët e infrastrukturës të përdoren në maksimumin e potencialit të tyre. Megjithatë, në praktikë, një konfigurim i tillë është shumë i vështirë. Më e mundshme është që përdoruesit të konfigurojnë brokerët në një mënyrë që maksimalizojnë përdorimin e një ose dy komponenteve (diskut, memorie apo procesor). Në përgjithësi, brokeri tregon maksimumin e performancës kur konfigurimi i tij lejon që komponenti më i ngadalshëm të përdoret “në kapacitet të plotë”. Kështu, ne mund të marrim një ide të përafërt mbi ngarkesën me të cilën mund të përballojë një broker.
Teorikisht, ne gjithashtu mund të llogarisim numrin e brokerëve që nevojiten për të përballuar një ngarkesë të caktuar. Megjithatë, në praktikë, ka shumë mundësi konfigurimi në nivele të ndryshme, saqë të vlerësosh performancën potenciale të një konfigurimi është shumë e vështirë (nëse jo e pamundur). Në fjalë të tjera, është shumë e vështirë të planifikosh një konfigurim në bazë të një performance të caktuar.
Për përdoruesit e Supertubes, ne zakonisht ndjekim qasjen e mëposhtme: fillojmë me një konfigurim të caktuar (infrastruktura + cilësime), pastaj masim performancën e saj, rregullojmë cilësimet e brokerit dhe e përsërisim procesin përsëri. Kjo ndodh deri në momentin kur potenciali i komponentit më të ngadalshëm të infrastrukturës është plotësisht e angazhuar.
Me këtë mënyrë ne marrim një përfaqësim më të qartë të numrit të brokerëve të nevojshëm për klasterin që të përballojë një ngarkesë të caktuar (numri i brokerëve gjithashtu varet nga faktorë të tjerë, si numri minimal i replikave të mesazheve për të siguruar qëndrueshmërinë, numri i liderëve të partition-it, etj.). Për më tepër, ne kemi një ide se për cilin komponent infrastruktural është e dëshirueshme shkallëzimi në mënyrë vertikale.
Në këtë artikull do të flasim për hapat që ndjekim për të "nxjerrë gjithçka" nga komponentët më të ngadalshëm në konfigurimet fillestare dhe për të matur kapacitetin e klasterit Kafka. Një konfigurim i qëndrueshëm kërkon të paktën tre brokerë që funksionojnë.min.insync.replicas=3), të shpërndara në tre zona të ndryshme të disponueshmërisë. Për konfigurimin, zgjerimin dhe monitorimin e infrastrukturës Kubernetes, ne përdorim platformën tonë të menaxhimit të kontejnerëve për nube hibride — . Ajo mbështet on-premise (bare metal, VMware) dhe pesë lloje nube (Alibaba, AWS, Azure, Google, Oracle), si dhe çdo kombinim të tyre.
Mendime mbi infrastrukturën dhe konfiguratën e klasterit Kafka
Për shembujt e mëposhtëm, ne zgjodhëm AWS si ofruesin e shërbimeve në nube dhe EKS si shpërndarjen e Kubernetes. Një konfigurim të ngjashëm mund të realizohet me — shpërndarja e Kubernetes nga Banzai Cloud, e certifikuar nga CNCF.
Disku
Amazon ofron lloje të ndryshme . Në thelb, gp2 dhe io1 bazohet në disqe SSD, megjithatë për të siguruar një shkallë të lartë kalimi, gp2 konsumon kreditë e grumbulluara (I/O credits), prandaj ne preferuam llojin io1, i cili ofron një shkallë të qëndrueshme të lartë kalimi.
Llojet e instancave
Performanca e Kafka varet shumë nga cache-i i faqeve të sistemit operativ, prandaj na duhen instanca me mjaftueshëm memorie për brokerët (JVM) dhe cache-in e faqeve. Instanca c5.2xlarge është një fillim i mirë, pasi ka 16 GB memorie dhe E meta e tij është se ai mund të sigurojë performancë maksimale për më shumë se 30 minuta çdo 24 orë. Nëse ngarkesa e punës kërkon performancë maksimale për një periudhë më të gjatë, duhet të shqyrtojmë lloje të tjera instancash. Ne pikërisht kështu vepruam, duke u ndalur në c5.4xlarge.Ai siguron një shkallë maksimale kalimi në 593.75 MB/s.Shkalla maksimale e kalimit për volumet EBS io1 është më e lartë se ajo e instancës c5.4xlarge., prandaj elementi më i ngadaltë i infrastrukturës duket se është shkalla e kalimit I/O e këtij lloji instancash (çka gjithashtu duhet të konfirmohet nga rezultatet e testeve tona të ngarkesës).
Rrjeti
Shkalla e kalimit të rrjetit duhet të jetë e mjaftueshme në krahasim me performancën e instancës VM dhe diskun; ndryshe, rrjeti bëhet një ngushticë. Në rastin tonë, ndërfaqja e rrjetit c5.4xlarge. mbështet shpejtësinë deri në 10 Gb/s, që është dukshëm më e lartë se shkalla e kalimit I/O e instancës VM.
Dislokimi i brokerëve
Brokers duhet të instalohen (planifikohen në Kubernetes) në nodet e dedikuara, për të shmangur konkurrencën me proceset e tjera për burimet e CPU, memories, rrjetit dhe diskut.
Versioni Java
Zgjedhja logjike është Java 11, pasi është e pajtueshme me Docker në kuptimin që JVM e përcakton saktë procesorët dhe memories e disponueshme për kontejnerin ku funksionon brokeri. Duke ditur se kufijtë e procesorëve janë të rëndësishëm, JVM brenda dhe në mënyrë transparente përcakton numrin e flukseve GC dhe flukseve të kompilimit JIT. Ne përdorëm imazhin Kafka banzaicloud/kafka:2.13-2.4.0, duke përfshirë versionin Kafka 2.4.0 (Scala 2.13) në Java 11.
Nëse dëshironi të dini më shumë rreth Java/JVM në Kubernetes, shikoni publikimet tona të mëposhtme:
- ;
- .
Cilësimet e memories së brokerit
Ka dy aspekte kryesore në konfigurimin e memories së brokerit: cilësime për JVM dhe për pod-in Kubernetes. Kufiri i memories i vendosur për pod-in duhet të jetë më i madh se madhësia maksimale e heap, në mënyrë që JVM të ketë hapësirë për meta-hapsirën Java, e cila ndodhet në memorien e vet, dhe për caches e faqeve të sistemit operativ, të cilin Kafka e përdor aktivisht. Në testet tona, ne ekzekutuam brokerat Kafka me parametrat -Xmx4G -Xms2G, dhe kufiri i memories për pod-in ishte 10 Gi. Ju lutem vini re se cilësimet e memories për JVM mund të merren automatikisht përmes -XX:MaxRAMPercentage dhe -X:MinRAMPercentage, në përputhje me kufirin e memories për pod-in.
Cilësimet e procesorëve të brokerit
Për gjithësisht, mund të rritet performanca duke rritur paralelizmin nëpërmjet rritjes së numrit të flukseve të përdorura nga Kafka. Sa më shumë procesorë të jenë të disponueshëm për Kafka, aq më mirë. Në testin tonë filluam me një kufi prej 6 procesorësh dhe gradualisht (në iteracione) e rritëm numrin e tyre deri në 15. Për më tepër, ne vendosëm num.network.threads=12 në cilësimet e brokerit, për të rritur numrin e flukseve që pranojnë të dhëna nga rrjeti dhe i dërgojnë ato. Menjëherë, duke kuptuar se brokerat pasues nuk mund të marrin replikat mjaft shpejt, e rritëm num.replica.fetchers deri në 4, për të përshpejtuar shpejtësinë me të cilën brokerat pasues replikonin mesazhet nga liderët.
Instrumenti i gjenerimit të ngarkesës
Duhet të sigurohemi që potenciali i gjeneratorit të ngarkesës së zgjedhur të mos përfundojë para se klasteri Kafka (benchmark-u që po zhvillohet) të arrijë ngarkesën e tij maksimale. Me fjalë të tjera, është e nevojshme të kryhet një vlerësim paraprak i mundësive të mjetit të gjenerimit të ngarkesës dhe të zgjidhen për të tipe instancash me një numër të mjaftueshëm procesorësh dhe memories. Në këtë rast, mjeti ynë do të prodhojë më shumë ngarkesë sesa klasteri Kafka është në gjendje të përballojë. Pas shumë eksperimentesh, ne u ndalëm në tre instanca c5.4xlarge., në secilën prej të cilave u ejecua gjeneratori.
Benchmarking
Matja e performancës është një proces iterativ që përfshin stadet e mëposhtme:
- konfigurimi i infrastrukturës (klasterit EKS, klasterit Kafka, mjetit për gjenerimin e ngarkesës, si dhe Prometheus dhe Grafana);
- gjenerimi i ngarkesës për një periudhë të caktuar për filtrimin e devijimeve të rastësishme në treguesit e performancës që mblidhen;
- rregullimi i infrastrukturës dhe konfigurimit të brokerit në bazë të treguesve të performancës së vëzhguar;
- përsëritja e procesit deri sa të arrihet niveli i kërkuar i kapacitetit të klasterit Kafka. Gjatë këtij procesi, ai duhet të jetë stabilisht i riprodhueshëm dhe të tregojë variacione minimale të kapacitetit.
Në seksionin e mëpasshëm janë përshkruar hapat që janë ndjekur gjatë procesit të benchmarking-ut të klasterit provues.
Mjetet
Për të përshpejtuar implementimin e konfiguracionit bazë, gjenerimin e ngarkesës dhe matjen e performancës u përdorën mjetet e mëposhtme:
- për organizimin e klasterit EKS nga Amazon me (për mbledhjen e metrikave të Kafka dhe infrastrukturës) dhe (për vizualizimin e këtyre metrikave). Ne përfituam nga shërbimet në e integruara, të cilat ofrojnë monitorim federal, grumbullim të centralizuar të log-ve, skanimin e dobësive, rikuperimin nga dështimet, sigurinë e nivelit korporativ dhe shumë të tjera.
- — mjeti për testimin e ngarkesës së klasterit Kafka.
- Panelet Grafana për vizualizimin e metrikave të Kafka dhe infrastrukturës: , .
- Supertubes CLI për konfigurimin maksimalisht të thjeshtë të një klasteri Kafka në Kubernetes. Zookeeper, Kafka operator, Envoy dhe shumë komponente të tjera janë instaluar dhe janë konfiguruar siç duhet për të nisur një klaster Kafka të gatshëm për prodhim në Kubernetes.
- Për instalimin supertubes CLI përdorni udhëzimet e dhëna .
Kluster EKS
Përgatitni klustër EKS me nod të dedikuar punues c5.4xlarge. në zona të ndryshme disponibiliteti për pod’ë me brokerët Kafka, si dhe nod të dedikuar për gjeneratorin e ngarkesës dhe infrastrukturën e monitorimit.
banzai cluster create -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/cluster_eks_202001.jsonKur klusteri EKS të jetë aktiv, aktivizoni — ai do të deploy Prometheus dhe Grafana në kluster.
Komponentët sistemikë të Kafka
Instaloni komponentët sistemikë të Kafka (Zookeeper, kafka-operator) në EKS duke përdorur supertubes CLI:
supertubes install -a --no-democluster --kubeconfigKlusteri Kafka
Nga parazgjedhja në EKS përdoren vëllime EBS të tipit gp2, prandaj është e nevojshme të krijoni një klasë të veçantë ruajtjeje të bazuar në vëllime io1 për klusterin Kafka:
kubectl create -f - <<EOF
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fast-ssd
provisioner: kubernetes.io/aws-ebs
parameters:
  type: io1
  iopsPerGB: "50"
  fsType: ext4
volumeBindingMode: WaitForFirstConsumer
EOF
Vendosni parametrin për brokerët min.insync.replicas=3 dhe deployoni pod’ë brokerësh në nodet në tri zona të ndryshme disponibiliteti:
supertubes cluster create -n kafka --kubeconfig -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/kafka_202001_3brokers.yaml --wait --timeout 600Temat
Ne kemi nisur paralelisht tre instanca të gjeneratorit të ngarkesës. Secila prej tyre shkruan në temën e saj, dmth. na nevojiten gjithsej tre tema:
supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest1
spec:
  name: perftest1
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
    name: perftest2
spec:
  name: perftest2
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest3
spec:
  name: perftest3
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF
Për secilën temë, faktori i replikimit është 3 — vlera minimale e rekomanduar për sisteme prodhimi me disponibilitet të lartë.
Instrumenti i gjenerimit të ngarkesës
Ne kemi lançuar tre kopje të gjeneratorit të ngarkesës (secila shkruante në një temë të veçantë). Për pod-et e gjeneratorit të ngarkesës, është e nevojshme të caktosh afinitetin e nodit, në mënyrë që të planifikohen vetëm në nodet e dedikuara për ta:
apiVersion: extensions/v1beta1
kind: Deployment
metadata:
  labels:
    app: loadtest
  name: perf-load1
  namespace: kafka
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      app: loadtest
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        app: loadtest
    spec:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: nodepool.banzaicloud.io/name
                operator: In
                values:
                - loadgen
      containers:
      - args:
        - -brokers=kafka-0:29092,kafka-1:29092,kafka-2:29092,kafka-3:29092
        - -topic=perftest1
        - -required-acks=all
        - -message-size=512
        - -workers=20
        image: banzaicloud/perfload:0.1.0-blog
        imagePullPolicy: Always
        name: sangrenel
        resources:
          limits:
            cpu: 2
            memory: 1Gi
          requests:
            cpu: 2
            memory: 1Gi
        terminationMessagePath: /dev/termination-log
        terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      terminationGracePeriodSeconds: 30
Disa pika për t'u marrë parasysh:
- Gjeneratori i ngarkesës krijon mesazhe me gjatësi 512 byte dhe i publikton ato në Kafka në grupe të 500 mesazheve.
- Me ndihmën e argumentit
-required-acks=allpublikimi konsiderohet i suksesshëm kur të gjitha replikat e sinkronizuara të mesazhit janë marrë dhe konfirmuar nga brokera të Kafka. Kjo do të thotë se në benchmark ne matëm jo vetëm shpejtësinë e liderëve që marrin mesazhe, por edhe të pasuesve të tyre, që riprodhojnë mesazhet. Qëllimi i këtij testi nuk është të vlerësojë shpejtësinë e leximit nga konsumatorët (consumers) e mesazheve të sapo pranuara, të cilat aktualisht qëndrojnë në caches e faqeve të OS, dhe krahasimi i saj me shpejtësinë e leximit të mesazheve që ruhen në disk. - Gjeneratori i ngarkesës ekzekuton paralelisht 20 punëtorë (
-workers=20). Çdo punëtor përmban 5 prodhues, të cilët e ndajnë lidhjen e punëtorit me klasterin Kafka. Në përfundim, çdo gjenerator ka 100 prodhues, dhe të gjithë ata dërgojnë mesazhe në klasterin Kafka.
Vëzhgimi i gjendjes së klasterit
Gjatë testimit të ngarkesës së klasterit Kafka, ne gjithashtu ndjekim shëndetin e tij për të siguruar që nuk ka rilëshime të pod-eve, kopje të sinkronizuara dhe qëkapaciteti maksimal i kalimit të të dhënave të jetë me fluktuacione minimale:
- Generatori i ngarkesës shkruan statistika standarde mbi numrin e mesazheve të publikuara dhe nivelin e gabimeve. Pjesa e gabimeve duhet të mbetet në vlerën
0,00%. - , i vendosur nga kafka-operator, ofron një panel monitorimi ku gjithashtu mund të ndiqni gjendjen e klasterit. Për të parë këtë panel, ekzekutoni:
supertubes cluster cruisecontrol show -n kafka --kubeconfig - Niveli ISR (numri i kopjeve "in-sync") shrink dhe expansion janë të barabarta me 0.
Rezultatet e matjeve
3 brokerë, madhësia e mesazheve — 512 byte
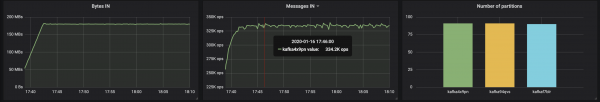
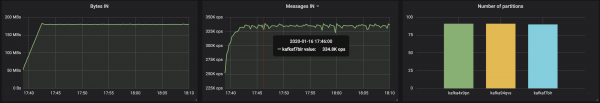
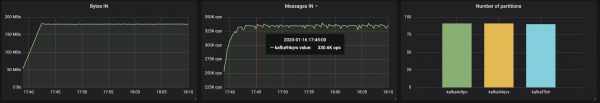
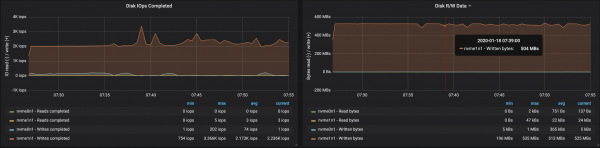
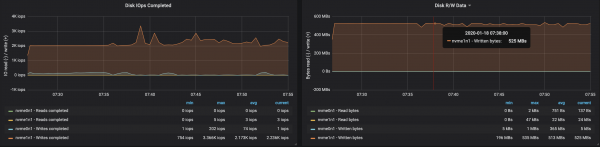
Me partition-at e shpërndara në mënyrë të barabartë në tre brokerë, arritëm një performancë ~500 Mb/s (paku 990 mijë mesazhe në sekondë):
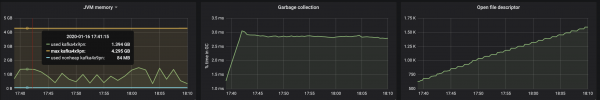
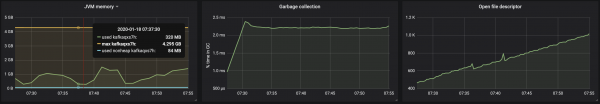
Konsumi i memorjes nga JVM nuk e kaloi 2 Gb:
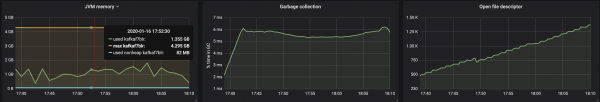
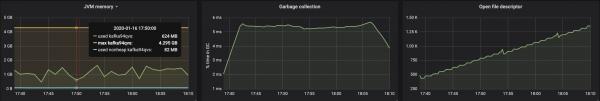
Kapaciteti i kalimit të të dhënave arriti kapacitetin maksimale I/O të nyjës në të tri instancat ku ishin aktivizuar brokerët:
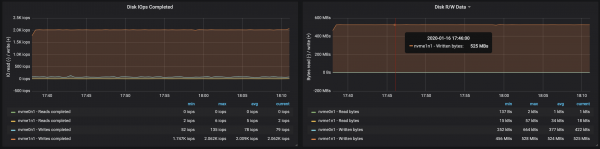
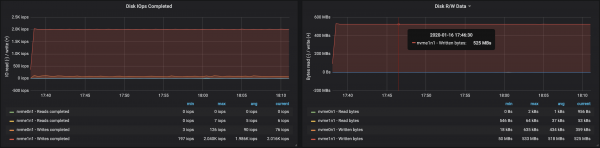
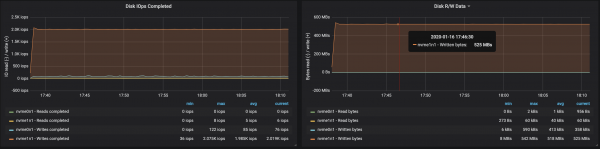
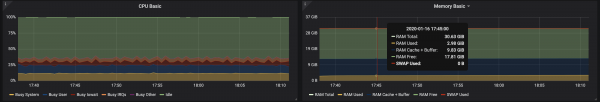
Nga të dhënat mbi përdorimin e memorjes nga nyjat, thuhet se sistemet e buferizimit dhe të caches zënë rreth 10-15 Gb:
3 brokerë, madhësia e mesazheve — 100 byte
Me uljen e madhësisë së mesazheve, kapaciteti i kalimit të të dhënave bie rreth 15-20%: ndikon koha e kaluar për të përpunuar secilin mesazh. Për më tepër, ngarkesa mbi procesorin është rritur gati dyfish.
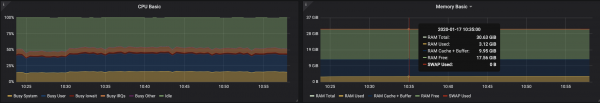
Duke qenë se ka ende bërthama të papërdorura në nyjat e brokerëve, performanca mund të përmirësohet duke ndryshuar konfigurimin e Kafka-s. Kjo është një detyrë e vështirë, prandaj për të rritur kapacitetin e kalimit, është më mirë të punoni me mesazhe më të mëdha.
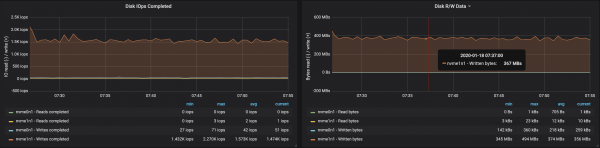
4 brokerë, madhësia e mesazheve — 512 byte
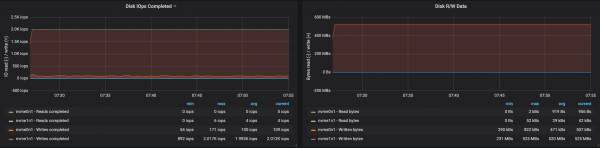
Është e lehtë të rritet performanca e klasterit Kafka thjesht duke shtuar brokerë të rinj dhe duke ruajtur balancimin e partition-ave (kjo siguron shpërndarjen e barabartë të ngarkesës midis brokerëve). Në rastin tonë, pas shtimit të një brokeri, kapaciteti i kalimit të klasterit u rrit në ~580 Mb/s (~1,1 milion mesazhe në sekondë). Rritja doli të ishte më e vogël se sa pritej: kjo kryesisht shpjegohet nga disbalanci i partition-ave (jo të gjithë brokerët punojnë në kapacitetin e plote).
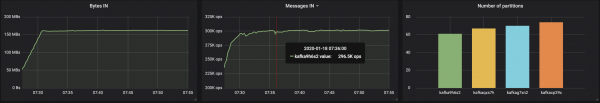
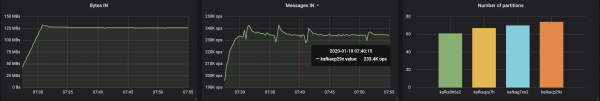
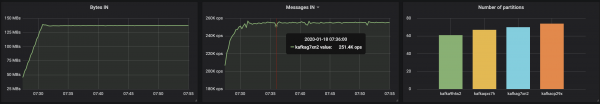
Konsumimi i memories nga JVM mbetet nën 2 GB:
Punësimi i brokerëve me grumbuj është prekur nga disbalanci i partition-ëve:
Përfundimet
Qasja iteruese e paraqitur më sipër mund të zgjerohet për të përfshirë skenarë më kompleksë, duke përfshirë qindra konsumatorë, riparticionim, azhurnime të aplikueshme, rikthime të pod-eve, etj. Të gjitha këto na lejojnë të vlerësojmë kufijtë e mundësive të klasterit Kafka nën kushte të ndryshme, të identifikojmë ngushticat në funksionimin e tij dhe të gjejmë mënyra për t'u përballur me to.
Ne kemi zhvilluar Supertubes për një shpërndarje të shpejtë dhe të lehtë të klasterit, konfigurimin e tij, shtimin / heqjen e brokerëve dhe tematikave, reagimin ndaj njoftimeve dhe sigurimin e funksionimit të duhur të Kafka në Kubernetes në përgjithësi. Qëllimi ynë është të ndihmojmë në përqendrimin te detyra kryesore ('të gjenerojmë' dhe 'të konsumojmë' mesazhe Kafka), ndërsa të gjitha punët e rënda t'i besojmë Supertubes dhe operatorit Kafka.
Nëse jeni të interesuar në teknologjitë dhe projektet Open Source të Banzai Cloud, abonohuni në kompaninë në , ose .
P.S. nga përkthyesi
Lexoni gjithashtu në blogun tonë:
- «»;
- «»;
- «».
Burimi: habr.com
