

Përshëndetje, Habr! Emri im është Maksim Vasiliev, punoj si analist dhe menaxher projektesh në FINCH. Sot do të flas për atë se si me ndihmën e ElasticSearch, arritëm të përpunojmë 15 milion kërkesa për 6 minuta dhe të optimizojmë ngarkesat ditore në faqen e njërit prej klientëve tanë. Fatkeqësisht, do të duhet të qëndrojmë pa emra, pasi kemi një NDA, shpresojmë që përmbajtja e artikullit të mos vuajë për këtë. Le të vazhdojmë.
Si është organizuar projekti
Në backend-in tonë krijojmë shërbime që sigurojnë funksionimin e faqeve të internetit dhe aplikacionit mobil të klientit tonë. Strukturën e përgjithshme mund ta shihni në diagram:
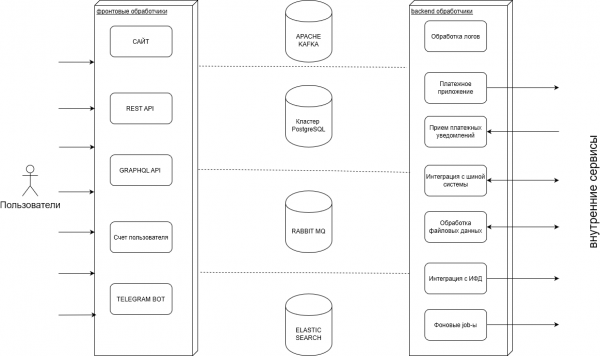
Në procesin e punës ne përpunojmë një numër të madh transaksionesh: blerjeve, pagesave, operacioneve me balancet e përdoruesve, për të cilat ruajmë shumë log-e, si dhe importojmë dhe eksportojmë këto të dhëna në sisteme të jashtme.
Ka gjithashtu procese të kundërta, për të cilat ne marrim të dhëna nga klienti dhe i dërgojmë ato përdoruesve. Përveç kësaj, ekzistojnë gjithashtu procese për menaxhimin e pagesave dhe programeve të bonusit.
Një historik i shkurtër
Fillimisht, si depo e vetme të dhënash, ne përdorim PostgreSQL. Avantazhet standarde të DBMS: ekzistenca e transaksioneve, një gjuhë e zhvilluar për përzgjedhjen e të dhënave, një gamë e gjerë mjeteve për integrim; bashkë me performancën e mirë, për një kohë të gjatë përmbushën kërkesat tona.
Ne ruajmë në Postgres të gjitha të dhënat: nga transaksionet deri te lajmet. Por numri i përdoruesve po rritej dhe me të rritej edhe numri i kërkesave.
Për të kuptuar, numri vjetor i sesioneve në vitin 2017 vetëm në faqen desktop — 131 milion. Në vitin 2018 — 125 milion. Vitin 2019 përsëri 130 milion. Shtoni aty edhe 100-200 milion nga versioni mobil i faqes dhe aplikacioni mobil, dhe do të merrni një numër kolosal kërkesash.
Me rritjen e projektit, Postgres nuk po arrinte më të përballonte ngarkesën, ne ishim duke ngecur — u shfaq një numër i madh kërkesash të ndryshme, për të cilat nuk arritëm të krijonim një numër të mjaftueshëm indekse.
Ne kuptonim se kishte nevojë për depo të tjera të dhënash, që do të plotësonin nevojat tona dhe do të lehtësonin ngarkesën nga PostgreSQL. Si mundësi shqyrtuam Elasticsearch dhe MongoDB. Të fundit humbte për këto pika:
- Shpejtësia e ngadaltë e indeksimit me rritjen e volumit të të dhënave në indekse. Te Elastic, shpejtësia nuk varet nga volumi i të dhënave.
- Nuk ka kërkim me tekst të plotë
Kështu ne zgjodhëm Elastic për vete dhe u përgatitëm për kalimin.
Kalimi në Elastic
1. Ne filluam kalimin me shërbimin e kërkimit të pikave të shitjes. Klienti ynë ka gjithsej rreth 70,000 pikash shitjeje dhe nevojiten disa lloje kërkimi në faqe dhe në aplikacion:
- Kërkim me tekst mbi emrin e vendit
- Kërkimi gjeo në një rreth të caktuar nga një pikë. Për shembull, nëse përdoruesi dëshiron të shohë se cilat pika shitjeje janë më afër shtëpisë së tij.
- Kërkimi në një katror të caktuar – përdoruesi çizmon një katror në hartë dhe i shfaqen të gjitha pikat në këtë rreth.
- Kërkimi me filtrat shtesë. Pikat e shitjes ndryshojnë nga njëra-tjetra sipas asortimentit
Nëse flasim për organizimin, atëherë në Postgres ne kemi burimin e të dhënave si për hartën, ashtu edhe për lajmet, ndërsa në Elastic bëhen Snapshot'ë nga të dhënat origjinale. Arsyeja është se fillimisht Postgres nuk mund të përballonte kërkimin sipas të gjithë kritereve. Nuk ishte vetëm se kishte shumë indekse, ato mund të ishin edhe të ndërthurura, prandaj planifikuesi i Postgres humbiste dhe nuk kuptonte se cili indeks të përdorte.
2. Tjetra në radhë ishte seksioni i lajmeve. Në faqe publikohen çdo ditë publikime, në mënyrë që përdoruesi të mos humbasë në rrjedhën e informacionit, të dhënat duhet të renditen përpara dorëzimit. Për këtë kërkohet kërkimi: në faqe mund të kërkosh sipas përputhjes së teksteve, dhe gjithashtu të aktivizosh filtrat shtesë, pasi ato gjithashtu janë krijuar përmes Elastic.
3. Më pas na u transferua përpunimi i transaksioneve. Përdoruesit mund të blejnë një produkt të caktuar në faqe dhe të marrin pjesë në lojëra me çmime. Pas këtyre blerjeve, ne përpunojmë një numër të madh të dhënash, veçanërisht në fundjavë dhe festat. Për krahasim, në ditët e zakonshme numri i blerjeve përbën rreth 1.5-2 milionë, ndërsa në festat numri mund të arrijë deri në 53 milionë.
Në të njëjtën kohë, të dhënat duhet të përpunohen në një kohë minimale — përdoruesit nuk e pëlqejnë të presin disa ditë për rezultat. Nëpërmjet Postgres nuk mund të arriheshin këto afate — ne shpesh merrnim bllokime, dhe derisa ne përpunonim të gjitha kërkesat, përdoruesit nuk mund të verifikonin nëse kishin fituar çmime apo jo. Kjo nuk është shumë e këndshme për biznesin, prandaj e transferuam përpunimin në Elasticsearch.
Frekvenca
Aktualisht, përditësimet janë të vendosura ngjarjesh, sipas kushteve të mëposhtme:
- Pikat e shitjes. Sapo marrim të dhëna nga një burim jashtë, ne menjëherë nisim përditësimin.
- Lajmet. Sapo në сайт редактируют какую-либо новость, она автоматически отправляется в Elastic.
Këtu përsëri duhet mentioned përmbledhja e Elastic. Në Postgres, gjatë dërgimit të kërkesës, duhet të presim derisa ai të përpunojë ndershëm të gjitha regjistrimet. Në Elastic, mund të dërgoni 10 mijë regjistrime dhe menjëherë të filloni punën, pa pritur që regjistrimet të shpërndahen në të gjitha Shards. Sigurisht, ndonjë Shard ose Replica mund të mos e shohin të dhënat menjëherë, por shumë shpejt gjithçka do të jetë e disponueshme.
Mënyrat e integrimit
Ka 2 mënyra integrimi me Elastic:
- Nëpërmjet klientit natyral për TCP. Drejtuesi natyror po shkruhet gradualisht: nuk mbështetet më, ka një sintaksë shumë të pakëndshme. Prandaj, ne nuk e përdorim praktikisht dhe përpiqemi të heqim dorë nga ai.
- Nëpërmjet ndërfaqes HTTP, në të cilën mund të përdorim si kërkesa JSON, ashtu edhe sintaksën Lucene. Kjo e fundit është një motor teksti që përdor Elastic. Në këtë variant ne marrim mundësinë e Batch përmes kërkesave JSON përmes HTTP. Ky variant ne përpiqemi ta përdorim.
Falë ndërfaqes HTTP, ne mund të përdorim libra që ofrojnë një realizim asinkron të klientit HTTP. Ne mund të shfrytëzojmë përparësinë e Batch dhe API asinkron, që në fund na jep një performancë të lartë, e cila ndihmoi shumë në ditët e një promovimi të madh (për këtë më poshtë)
Pak numra për krahasim:
- Ruajtja e përdoruesve që morën çmimet në Postgres në 20 rrjedha pa grupime: 460713 regjistrime në 42 sekonda
- Elastic + klient reaktiv në 10 rrjedha + batch në 1000 elemente: 596749 regjistrime në 11 sekonda
- Elastic + klient reaktiv në 10 rrjedha + batch në 1000 elemente: 23801684 regjistrime në 4 minuta
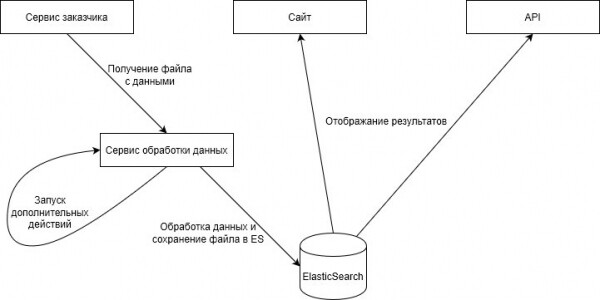
Aktualisht, ne kemi shkruar një menaxher kërkesash për HTTP, i cili ndërtón JSON, si Batch/në Batch dhe e dërgon përmes çdo klienti HTTP pavarësisht nga biblioteka. Gjithashtu, mund të zgjidhni të dërgoni kërkesat me sinkron ose asinkron.
Në disa integrime ne ende përdorim klientin zyrtar të transportit, por kjo është vetëm një çështje e ristrukturimit të afërt. Ndërkohë, për përpunimin përdoret një klient i brendshëm, i ndërtuar mbi bazën e Spring WebClient.
Promovim i madh
Një herë në vit, projekti organizon një promovim të madh për përdoruesit — kjo është ajo që quhet Highload, pasi gjatë këtyre ditëve punojmë me dhjetëra miliona përdorues në të njëjtën kohë.
Zakonisht kulmet e ngarkesave ndodhin gjatë festave, por kjo promovim është një nivel krejtësisht tjetër. Në vitin e kaluar, në ditën e promovimit, shitëm 27 580 890 njësi të produkteve. Të dhënat u përpunuan për më shumë se gjysmë ore, që shkaktoi shqetësim te përdoruesit. Përdoruesit morën çmime për pjesëmarrje, por bëhej e qartë se procesi duhet të shpejtohej.
Në fillim të vitit 2019, ne vendosëm se na nevojitej ElasticSearch. Gjatë një viti organizuam përpunimin e të dhënave që merrnim në Elastic dhe shfaqjen e tyre në API-në e aplikacionit mobil dhe në faqen e internetit. Në përfundim, vitin e ardhshëm gjatë promovimit ne përpunuam 15 131 783 regjistrime brenda 6 minutash.
Duke pasur parasysh se ka shumë dëshira për të blerë produkte dhe për të marrë pjesë në tërheqjen e çmimeve, kjo është një masë përkohësore. Tani ne po i dërgojmë informacionet aktuale në Elastic, por në të ardhmen planifikojmë të transferojmë informacionin arkivor për muajt e kaluar në Postgres, si një magazinë të përhershme. Për të mos zënë indekset Elastic, që gjithashtu ka kufizimet e veta.
Përfundimi / konkluzionet
Në këtë moment, ne kemi transferuar në Elastic të gjithë shërbimet që donim dhe për tani e kemi marrë një pauzë. Tani po ndërtojmë një indeks në Elastic mbi magazinën tonë të qëndrueshme në Postgres, e cila merr mbi vete ngarkesën e përdoruesve.
Në të ardhmen planifikojmë të transferojmë shërbimet kur kuptojmë se kërkesat për të dhëna bëhen shumë të larmishme dhe kërkohen në numra të pakufizuar kolonesh. Kjo tashmë është një detyrë që nuk është për Postgres.
Nëse na nevojitet kërkimi përmbajtësor në funksionin ose nëse kemi shumë kritere të ndryshme kërkimi, atëherë ne tashmë e dimë se duhet ta transferojmë në Elastic.
⌘⌘⌘
Faleminderit që e lexuat. Nëse kompaninë tuaj gjithashtu përdorin ElasticSearch dhe kanë raste të tyre të realizimit, na thoni. Do të ishte interesante të mësojmë si e bëjnë të tjerët 🙂
Burimi: habr.com
