

Si të rritet 10 herë numri i kërkesave në DB pa kaluar në një server më të fuqishëm dhe të ruhet funksionaliteti i sistemit? Do të flas për mënyrat si luftuam me rënien e performancës së bazës sonë të të dhënave, si e optimizuam SQL kërkesat për të shërbyer sa më shumë përdorues dhe për të mos rritur shpenzimet për burimet llogaritore.
Unë po zhvilloj një shërbim për menaxhimin e proceseve biznesore në kompanitë e ndërtimit. Me ne punojnë rreth 3 mijë kompani. Më shumë se 10 mijë njerëz punojnë çdo ditë me sistemin tonë për 4-10 orë. Ai zgjidh një gamë të gjerë detyrash planifikimi, njoftimi, paralajmërimi, validimi... Ne përdorim PostgreSQL 9.6. Në bazën tonë të të dhënave kemi rreth 300 tabela dhe çdo ditë pranojmë deri në 200 milion kërkesa (10 mijë të ndryshme). Në mesatare, kemi 3-4 mijë kërkesa për sekondë, në momentet më aktive më shumë se 10 mijë kërkesa për sekondë. Pjesa më e madhe e kërkesave është OLAP. Shtesat, modifikimet dhe fshirjet janë shumë më pak, që do të thotë se ngarkesa OLTP është relativisht e vogël. Të gjitha këto numra i përmenda, që të mund të vlerësoni shtrirjen e projektit tonë dhe të kuptoni se sa e rëndësishme mund të jetë për ju përvoja jonë.
Piktura e parë. Lirike
Kur filluam zhvillimin, nuk menduam shumë për ngarkesën që do të rëndonte mbi DB dhe çfarë do të bënim nëse serveri do të ndalte së funksionuari. Gjatë projektimit të DB ndjekëm rekomandimet e përgjithshme dhe u munduam të mos na bëjmë vetë të këqija, por nuk shkuam përtej këshillave të zakonshme si "mos përdorni modelin ne nuk shkuam. E projektuam duke u bazuar në parimet e normalizimit duke evituar tepricën e të dhënave dhe nuk u shqetësuam për shpejtimin e kërkesave të ndryshme. Sapo erdhën përdoruesit e parë, u përballëm me problemin e performancës. Ashtu si zakonisht, ishim krejtësisht të papërgatitur për këtë. Problemet e para ishin të thjeshta. Si rregull, gjithçka zgjidhej duke shtuar një indeks të ri. Por erdhi një moment kur zgjidhjet e thjeshta nuk funksiononin më. Kur kuptuam se na mungonte përvoja dhe po bëhej gjithnjë e më e vështirë të kuptonim shkakun e problemeve, angazhova ekspertë që na ndihmuan të konfigurojmë siç duhet serverin, të lidhim monitorimin dhe na treguan se ku të shihnim për të marrë .
Piktura e dytë. Statistike
Kështu që kemi rreth 10 mijë kërkesa të ndryshme që kryhen në bazën tonë të të dhënave çdo ditë. Nga këto 10 mijë, ka disa monstër që kryhen 2-3 milion herë me një kohë mesatare ekzekutimi prej 0.1-0.3 ms dhe ka kërkesa me një kohë mesatare ekzekutimi prej 30 sekondash, të cilat thirren 100 herë në ditë.
Optimizimi i të gjitha 10 mijë kërkesave nuk ishte i mundur, prandaj vendosëm të kuptojmë se ku të drejtojmë përpjekjet për të rritur performancën e bazës së të dhënave në mënyrë të drejtë. Pas disa iteracionesh, filluam të ndanë kërkesat në lloje.
Kërkesat TOP
Këto janë kërkesat më të rënda, të cilat zënë më shumë kohë (koha totale). Këto janë kërkesa që ose thirren shumë shpesh ose kërkesa që ekzekutohen shumë ngadalë (kërkesat e ngadalta dhe të shpeshta janë optimizuar që në iteracionet e para për shpejtësinë). Si rezultat, serveri shpenzon më shumë kohë për ekzekutimin e tyre. Është e rëndësishme të ndahen kërkesat kryesore sipas kohës totale të ekzekutimit dhe veçmas sipas kohës IO. Metodat e optimizimit të këtyre kërkesave janë pak të ndryshme.
Praktika e zakonshme e të gjitha kompanive - të punojnë me kërkesat TOP. Ato janë të pakta, optimizimi i madhe të paktën një kërkese mund të lirojë 5-10% të burimeve. Megjithatë, ndërsa projekti “rritet”, optimizimi i kërkesave TOP bëhet një detyrë gjithnjë e më e komplikuar. Të gjitha metodat e thjeshta janë zbatuar tashmë, dhe vetë kërkesa më “e rëndë” ndalon “vetëm” 3-5% të burimeve. Nëse kërkesat TOP në total zënë më pak se 30-40% të kohës, atëherë me siguri keni bërë përpjekje që ato të punojnë shpejt dhe ka ardhur koha për të kaluar në optimizimin e kërkesave nga grupi tjetër.
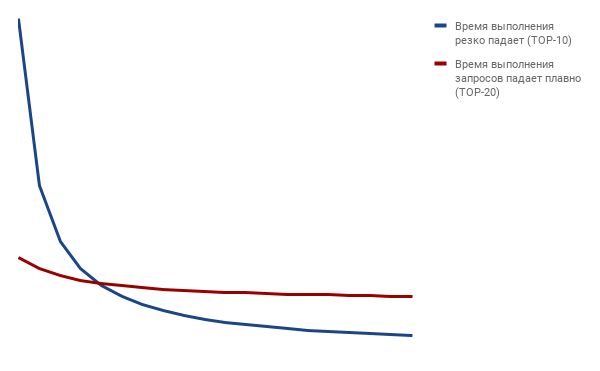
Tani mbetet të përgjigjemi në pyetjen se sa kërkesa kryesore të përfshijmë në këtë grup. Unë zakonisht marr jo më pak se 10, por jo më shumë se 20. Mundohem që koha e ekzekutimit të parë dhe të fundit në grupin TOP të ndryshojë jo më shumë se 10 herë. Pra, nëse koha e ekzekutimit të kërkesave bie ndjeshëm nga vendi i parë në të dhjetin, atëherë marr TOP-10, nëse rënia është më e butë, atëherë e rris madhësinë e grupit në 15 ose 20.
Kërkesat mesatare (medium)
Ato janë të gjitha kërkesat që vijnë menjëherë pas TOP-it, përveç 5-10% të fundit. Zakonisht, optimizimi i këtyre kërkesave përmban mundësinë për të ngritur ndjeshëm performancën e serverit. Këto kërkesa mund të “peshojnë” deri në 80%. Por edhe nëse pjesëmarrja e tyre kalon 50%, atëherë është koha për t’i shqyrtuar ato më me kujdes.
Bisht (tail)
Si e tha, këto kërkesa vijnë në fund dhe kërkojnë 5-10% të kohës. Mund t'i harrosh ato, nëse nuk po përdor mjete automatike për analizimin e kërkesave, atëherë optimizimi i tyre gjithashtu mund të jetë i lirë.
Si të vlerësosh çdo grup?
Unë përdor një kërkesë SQL që ndihmon në vlerësimin e tillë për PostgreSQL (jam i sigurt që për shumë DBMS të tjera mund të shkruhet një kërkesë e ngjashme)
Kërkesa SQL për vlerësimin e madhësisë së grupeve TOP-MEDIUM-TAIL
SELECT sum(time_top) AS sum_top, sum(time_medium) AS sum_medium, sum(time_tail)
FROM
(
  SELECT CASE WHEN rn  20 AND rn  800              THEN tt_percent ELSE 0 END AS time_tail
  FROM (
    SELECT total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query,
    ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn
    FROM pg_stat_statements
    ORDER BY total_time DESC
  ) AS t
)
AS ts
Rezultati i kërkesës - tre kolona, secila prej të cilave përmban përqindjen e kohës që shpenzohet për përpunimin e kërkesave nga ky grup. Brenda kërkesës ndodhen dy numra (në rastin tim, këto janë 20 dhe 800), që ndajnë kërkesat e një grupi nga tjetri.
Kështu, përfshirja e kërkesave në fillim të punës për optimizim dhe tani, është rreth kësaj.
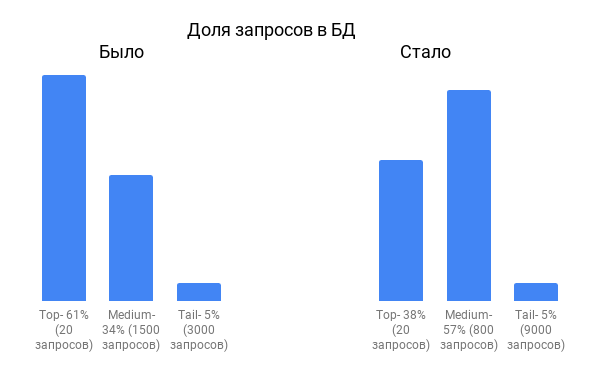
Nga diagrami, duket se përqindja e kërkesave TOP u ul ndjeshëm, ndërsa u rritën "mesatarët".
Fillimisht, në kërkesat TOP hynin gabime të hapura. Me kalimin e kohës, të sëmurat e fëmijërisë u zhdukën, përqindja e kërkesave TOP u pakësua, duke kërkuar përpjekje gjithnjë e më të mëdha për të përshpejtuar kërkesat e rënda.
Për të marrë tekstet e kërkesave, ne përdorim këtë kërkesë.
SELECT * FROM (
  SELECT ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn, total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query
  FROM pg_stat_statements
  ORDER BY total_time DESC
) AS T
WHERE
rn  20 AND rn  800  -- TAIL
Ja lista e teknikave më të përdorura që na ndihmuan të shpejtojmë kërkesat TOP:
- Ridisajnimi i sistemit, për shembull, ri-ndërton logjikën e njoftimeve në broker mesazh në vend të kërkesave periodike në DB.
- Shtimi ose ndryshimi i indekseve.
- Rishkrimi i kërkesave ORM në SQL të pastër.
- Rishkrimi i logjikës së ngarkimit lenjues të të dhënave.
- Keshimi përmes denormalizimit të të dhënave. Për shembull, ne kemi lidhjen e tabelave Transporti -> Llogaria -> Kërkesa -> Aplikimi. Kjo do të thotë se çdo transport është i lidhur me aplikimin përmes tabelave të tjera. Për të mos lidhur të gjitha tabelat në çdo kërkesë, ne e kopjojmë lidhjen me aplikimin në tabelën e Transportit.
- Marrja e të dhënave statike nga tabela me referenca dhe tabela që ndryshojnë rrallë në memorien e programit.
Ndonjëherë, ndryshimet kërkonin një ripërdorim të konsiderueshëm, por jepnin një shkarkim prej 5-10% të sistemit dhe ishin të justifikuara. Me kalimin e kohës, rezultati bëhej gjithnjë e më i vogël, dhe ripërdorimi kërkonte një përmirësim më serioz.
Atëherë ne kemi vënë re grupin e dytë të kërkesave - grupin e të mesëm. Në këtë grup kishte shumë më tepër kërkesa dhe dukej se do të shkonte shumë kohë për të analizuar tërë grupin. Megjithatë, shumica e kërkesave ishin shumë të thjeshta për t'u optimizuar dhe shumë probleme përsëriteshin dhjetëra herë në variacione të ndryshme. Ja disa shembuj të optimizimeve tipike që ne aplikonim për dhjetëra kërkesa të ngjashme dhe çdo grup i kërkesave të optimizuara shkarkonte DB-në me 3-5%.
- Në vend të kontrollit të pranisë së regjistrimeve duke përdorur COUNT dhe skanimin e plotë të tabelës, filluam të përdornim EXISTS.
- Na u hoq DISTINCT (nuk ka një recetë të përbashkët, por ndonjëherë mund të hiqet lehtësisht, duke përshpejtuar kërkesën nga 10-100 herë).
Për shembull, në vend të kërkesës për marrjen e të gjithë drejtuesve nga një tabelë e madhe dërgimesh (DELIVERY)
SELECT DISTINCT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM DELIVERY D JOIN PERSON P ON D.DRIVER_ID = P.ID
bëmë një kërkesë në një tabelë relativisht të vogël PERSON
SELECT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM PERSON
WHERE EXISTS(SELECT D.ID FROM DELIVERY WHERE D.DRIVER_ID = P.ID)
Duket se ne përdorëm një nënkërkesë të korreluar, por ajo jep një përshpejtim më shumë se 10 herë.
- Në shumë raste e eliminuam plotësisht COUNT dhe
- në vend të
UPPER(s) LIKE JOHN%përdorim
s ILIKE “John%”
Çdo kërkesë specifike arriti të përshpejtohej disa herë nga 3 deri në 1000 herë. Pavarësisht nga rezultatet mbresëlënëse, në fillim na duket se nuk kishte kuptim optimizimi i një kërkese që kryhet në 10 ms, është në rreth 300 kërkesat më të rënda dhe në përgjithësi kohën e ngarkesës në DB zë një përqindje të vogël. Por duke aplikuar të njëjtën recetë për grupin e kërkesave të ngjashme ne arrinim të përfitonim disa përqindje. Për të mos humbur kohë me kontrollin manual të të gjithë qindra kërkesave, ne shkruam disa skriptë të thjeshtë që me ndihmën e shprehjeve të rregullta gjenin kërkesa të ngjashme. Si rezultat, kërkimi automatizuar i grupeve të kërkesave na lejoi të përmirësonim edhe më shumë performancën tonë, duke shpenzuar përpjekje modeste.
Pas rezultatit, ne kemi punuar tashmë për tre vjet me të njëjtën pajisje. Ngarkesa mesatare ditore është rreth 30%, dhe në pikat më të larta arrin deri në 70%. Numri i kërkesave ashtu si dhe numri i përdoruesve është rritur rreth 10 herë. Dhe e gjithë kjo falë monitorimit të vazhdueshëm të grupeve të kërkesave TOP-MEDIUM. Sa herë që një kërkesë e re shfaqet në grupin TOP, ne e analizojmë menjëherë dhe përpiqemi ta përshpejtojmë. Grupin MEDIUM e shqyrtojmë një herë në javë duke përdorur skenarë analize. Nëse hasim kërkesa të reja, të cilat dihen si të optimizohen, ne i ndryshojmë ato shpejt. Ndonjëherë gjejmë mënyra të reja optimizimi, të cilat mund të aplikohen menjëherë për disa kërkesa.
Sipas parashikimeve tona, serveri aktual do të mbajë rritjen e numrit të përdoruesve edhe 3-5 herë të tjera. Megjithatë, ne kemi edhe një as në mëngë - nuk i kemi kaluar ende kërkesat SELECT në një pasqyrë, siç rekomandohet. Por ne nuk e bëjmë këtë me qëllim, pasi duam së pari të shfrytëzojmë deri në fund mundësitë e optimizimit 'inteligjent', para se të aktivizojmë 'artillerinë e rëndë'.
Një vështrim kritik mbi punën e kryer mund të sugjerojë përdorimin e skalimit vertikal. Të blini një server më të fuqishëm, në vend që të humbni kohë specialistësh. Një server mund të mos kushtojë shumë, sidomos duke ditur se kufijtë e skalimit vertikal nuk janë shfrytëzuar ende. Megjithatë, numri i kërkesave është rritur vetëm 10 herë. Pas disa vitesh, funksionaliteti i sistemit është zgjeruar dhe tani ka më shumë lloje kërkesash. Funksionaliteti që ishte, përmes memorizimit, kryhet me një numër më të vogël kërkesash, dhe gjithashtu kërkesa më efektive. Kështu, mund të shumëzojmë me qetësi edhe me 5, për të marrë një koeficient të vërtetë shpejtësie. Prandaj, sipas llogaritjeve më modeste, mund të thuhet se shpejtësia është rritur 50 herë e më shumë. Të rrisësh vertikalisht serverin 50 herë do të ishte më e shtrenjtë. Sidomos duke pasur parasysh se një optimizim i kryer një herë punon gjithmonë, ndërsa llogaria për serverin e marrë me qira vjen çdo muaj.
Burimi: habr.com
