

Çfarë mund ta bëjë një kompani kaq të madhe si Lamoda, me një proces të përsosur dhe qindra shërbime të lidhura, të ndryshojë ndjeshëm qasjen e saj? Motivimi mund të jetë krejtësisht i ndryshëm: nga legjislacioni deri te dëshira e natyrshme e çdo programuesi për të eksperimentuar.
Por kjo nuk do të thotë se nuk mund të pritet një përfitim shtesë. Në çfarë mënyre mund të fitohet, nëse zbatohet API i orientuar nga ngjarjet në Kafka, do të tregojë Sergey Zaika (). Mbi të gjitha sfidat dhe zbulimet interesante do të flasim gjithashtu – eksperimentet nuk mund të kalojnë pa to.
Disclaimer: Ky artikull është i bazuar në materialet e mitapit që Sergey mbajti në nëntor të vitit 2018 në HighLoad++. Përvoja e drejtpërdrejtë e punës së Lamoda me Kafka tërhoqi dëgjuesit po aq sa dokime të tjera nga programi. Na duket se është një shembull i shkëlqyer se gjithmonë mund dhe duhet të gjejmë aleatë, ndërsa organizatorët e HighLoad++ do të vazhdojnë të përpiqen të krijojnë një atmosferë miqësore për këtë.
Për procesin
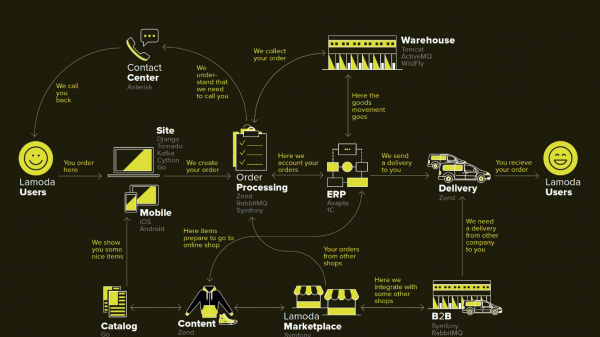
Lamoda është një platformë e madhe e-commerce, e cila ka qendrën e saj të kontaktit, shërbimin e dërgesës (dhe shumë partnerë), studio fotografike, një depo të madhe dhe gjithçka funksionon me softin e saj. Ka dhjetëra mënyra pagesash, partnerë b2b që mund të përdorin një pjesë ose të gjitha këto shërbime dhe duan të dinë informacionin e saktë për produktet e tyre. Për më tepër, Lamoda punon në tri vende përveç RF dhe atje gjithçka është paksa ndryshe. Në total, ndoshta ekzistojnë më shumë se njëqind mënyra për të konfigurimin e një porosie të re, e cila duhet të trajtohet në mënyrën e vet. Të gjitha këto funksionojnë me ndihmën e dhjetëra shërbimeve, të cilat komunikojnë ndonjëherë në mënyra jo të qarta. Ka gjithashtu një sistem qendror, përgjegjësia kryesore e të cilit është statusi i porosive. Ne e quajmë atë BOB, unë punoj me të.
Refund Tool me API të orientuar ndaj ngjarjeve
Fjala e orientuar nga ngjarjet është përdorur shumë, më vonë do të përcaktojmë saktësisht se çfarë nënkupton kjo. Do të fillojmë me kontekstin në të cilin ne vendosëm të provonim qasjen e API-së të orientuar nga ngjarjet në Kafka.
Në çdo dyqan, përveç porosive për të cilat blerësit paguajnë, ka raste kur dyqani kërkohet të kthejë para, sepse produkti nuk i përshtatet klientit. Ky proces relativisht i shkurtër: sqarojmë informacionin, nëse është e nevojshme, dhe transferojmë paratë.
Por nja udhëzimi u bë më i komplikuar për shkak të ndryshimeve në legjislacion, dhe na duhet të realizojmë një mikroshërbim të veçantë për këtë.
Motivacioni ynë:
- Ligji FZ-54 — në përmbledhje, ligji kërkon të raportojmë në administratën tatimore për çdo transaksion financiar, qoftë kthim apo ardhje, me një SLA mjaft të shkurtër prej disa minutash. Ne, si e-commerce, kryejmë një numër të konsiderueshëm transaksionesh. Teknikisht, kjo do të thotë një përgjegjësi të re (pra një shërbim të ri) dhe përmirësime në të gjitha sistemet e përfshira.
- BOB split — një projekt i brendshëm i kompanisë për të eliminuar numrin e madh të përgjegjësive jo-profesionale nga BOB dhe për të reduktuar kompleksitetin e tij të përgjithshëm.
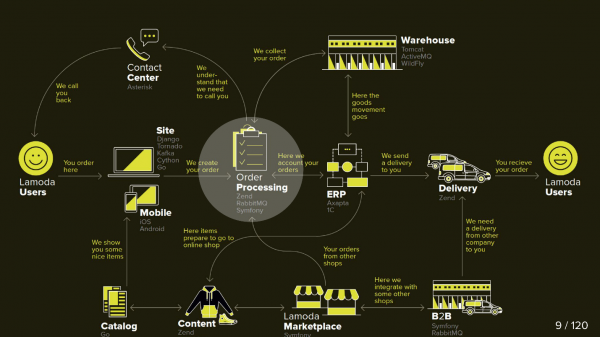
Në këtë skemë janë paraqitur sistemet kryesore të Lamoda. Tani shumica e tyre përbëjnë më shumë një grup prej 5-10 mikroshërbimesh rreth një monoliti në zvogëlim. Ato po rriten, por ne përpiqemi t'i bëjmë më të vogla, sepse është e frikshme të vendosësh një fragment të dedikuar në mes — nuk duhet lejuar që ai të bie. Të gjitha shkëmbimet (arrows) ne jemi të detyruar t'i rezervojmë dhe të supozojmë se ndonjëra prej tyre mund të bëhet e paaksesueshme.
Në BOB gjithashtu ka shumë shkëmbime: sisteme pagese, dërgimi, njoftime etj.
Teknikisht BOB është:
- ~150k rreshta kodi + ~100k rreshta testesh;
- php7.2 + Zend 1 & Komponentët Symfony 3;
- >100 API & ~50 integrime dalëse;
- 4 vende me logjikën e tyre të biznesit.
Të implementosh BOB është e shtrenjtë dhe e dhimbshme, numri i kodit dhe detyrat që ai zgjidh janë të tilla sa askush nuk mund ta mbajë atë në mendje në tërësi. Në thelb, ka shumë arsye për ta thjeshtuar.
Procesi i kthimit
Fillimisht në proces përfshihen dy sisteme: BOB dhe Pagesa. Tani po shfaqen edhe dy të tjera:
- Shërbimi i Fiskalizimit, i cili do të marrë përsipër problemet me fiskalizimin dhe komunikimin me shërbimet e jashtme.
- Mjeti i Kthimit, në të cilin thjesht transferohen shkëmbimet e reja, për të mos rritur BOB-në.
Tani procesi duket kështu:
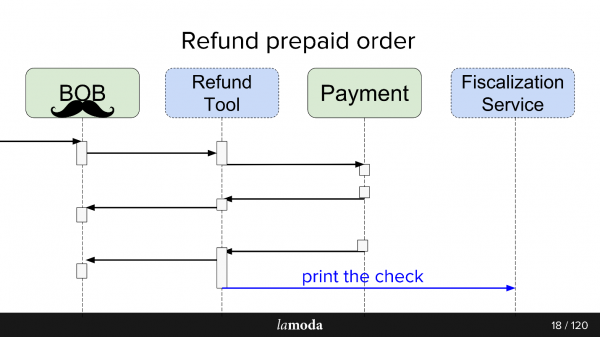
- BOB merr një kërkesë për kthimin e parave.
- BOB e informon këtë Mjet Kthimi.
- Mjeti i Kthimit i thotë Pagesës: "Kthe paratë".
- Pagesa kthen paratë.
- Mjeti i Kthimit dhe BOB sinjalizojnë njëri-tjetrin për statuset, sepse tani të dyve u nevojitet. Ne ende nuk jemi gati të kalojmë plotësisht në Mjetin Kthimi, sepse në BOB ka UI, raporte për kontabilitetin, dhe në përgjithësi shumë të dhëna që nuk mund të transferohen aq lehtësisht. Na duhet të rrimë në dy karrige.
- Shkarkohet kërkesa për fiskalizim.
Kështu, ne krijuam një autobus ngjarjesh përmes Kafka, ku gjithçka është lidhur. Hurra, tani kemi një pikë të vetme të dështimit (sarkazëm).
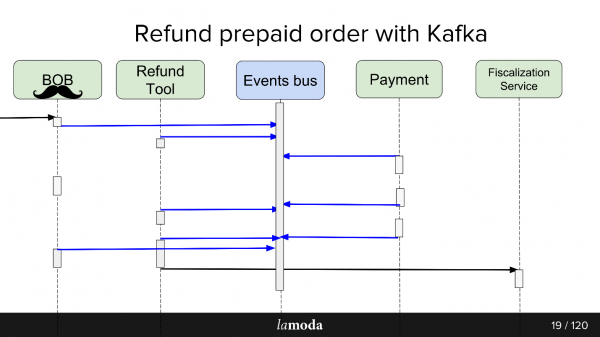
Pikat e forta dhe të dobëta janë mjaft evidente. Krijuam autobus, që do të thotë se tani të gjitha shërbimet varen nga ai. Kjo e thjeshton projektimin, por sjell një pikë të vetme të dështimit në sistem. Nëse Kafka bie, procesi do të ndalojë.
Çfarë është API me ngjarje?
Një përgjigje e mirë për këtë pyetje ndodhet në raportin e Martin Fowler (GOTO 2017). .
Përmbledhja e asaj që ne bëmë:
- Ne përfshimë të gjitha shkëmbimet asinkrone përmes ruajtjes së ngjarjeve.Në vend që të lajmërojmë çdo konsumator të interesuar përmes rrjetit në lidhje me ndryshimin e statusit, ne shkruajmë një ngjarje në një depo të centralizuar mbi ndryshimin e statusit, dhe konsumatorët e interesuar në temë lexojnë prej aty gjithçka që shfaqet.
- Ngjarja (event) në këtë rast është një njoftim (notifications) për atë që diçka ka ndryshuar diku. Për shembull, statusi i porosisë është ndryshuar. Konsumatori, i cili kërkon disa të dhëna përcjellëse të rëndësishme për ndryshimin e statusit dhe që nuk janë në njoftim, mund të mësojë gjendjen e tyre vetë.
- Varianti maksimal është sourcing i plotë të ngjarjeve, transferi i gjendjes, në të cilin ngjarja përmban të gjitha informacionet e nevojshme për përpunim: nga erdhi dhe në çfarë statusi kaloi, si ndryshuan të dhënat etj. Pyetje është vetëm sa e arsyeshme është dhe sa informacion mund të lejoni të ruhet.
Në kuadër të lançimit të Refund Tool, ne përdorëm variantin e tretë. Kjo e thjeshtoi përpunimin e ngjarjeve, pasi nuk është e nevojshme të nxjerrim informata të detajuara, plus përjashtoi skenarin kur çdo ngjarje e re shkakton një shpërthim të kërkesave të qarta nga konsumatorët.
Shërbimi Refund Tool nuk është i ngarkuar, prandaj Kafka aty është më shumë një provë sesa një nevojë. Nuk mendoj se, nëse shërbimi i kthimit të parave do të bëhej një projekt me ngarkesë të lartë, biznesi do të ishte i kënaqur.
Shkëmbimi asinkron AS IS
Për shkëmbimet asinkrone, departamenti i PHP zakonisht përdor RabbitMQ. Grumbullojmë të dhënat për kërkesën, i vendosim në radhë, dhe konsumatori i të njëjtit shërbim e lexon dhe dërgon (ose jo). Për API-në vetë, Lamoda e përdor aktivisht Swagger. E projektojmë API-në, e përshkruajmë në Swagger, gjenerojmë kodin klient dhe server. Gjithashtu, ne përdorim një JSON RPC 2.0 pak më të zgjeruar.
Disa vende përdorin autobusë esb, disa jetojnë në activeMQ, por, në përgjithësi, RabbitMQ — standard.
Async exchange TO BE
Duke një analogji kur projektojmë shkëmbimin përmes events-bus. Ne e përshkruajmë shkëmbimin e të dhënave në të ardhmen në një mënyrë të ngjashme përmes përshkrimeve të strukturës së event-it. Formati yaml, ne duhej të bënim vetë kodin e gjenerimit, gjeneratori sipas specifikacionit krijon DTO dhe mëson klientët dhe serverët të punojnë me ta. Gjenerimi bëhet në dy gjuhë — golang dhe php. Kjo lejon që bibliotekat të jenë të sinkronizuara. Gjeneratori është shkruar në golang, ndaj mori emrin gogi.
Event-sourcing në Kafka është diçka tipike. Ka një zgjidhje nga versioni kryesor enterprise i Kafka Confluent, ka , një zgjidhje nga "vëllezërit" tanë në fushën e domenit Zalando. Motivacioni ynë për të filluar me vanilla Kafka është që të mbajmë zgjidhjen falas, derisa të vendosim nëse do ta përdorim atë në masë, si dhe të ruajmë hapësirë për manovrim dhe përmirësime: ne duam mbështetje për JSON RPC 2.0 , gjeneratorët për dy gjuhë dhe të shohim çfarë tjetër.Ironikisht, që edhe në një rast të tillë të lumtur, kur ekziston një biznes mjaft analog si Zalando, i cili bëri një zgjidhje të ngjashme, ne nuk mund ta përdorim atë efektivisht.
Arkitekturshëm, në fillim, modeli është i tillë: lexojmë direkt nga Kafka, por shkruajmë vetëm përmes events-bus. Për leximin në Kafka ka shumë të gatshme: brokerë, balancues dhe ajo është më shumë-më pak e gatshme për shkallëzim horizontal, këtë dëshironim ta ruanim. Megjithatë, për shkrimin, ne dëshiruam ta mbështjellim përmes një Gateway aka Events-bus, dhe ja pse.
Events-bus
Ose autobusi i ngjarjeve. Ky është thjesht një gateway http stateless, që merr për vete disa role të rëndësishme:
Validimi i produkteve
- — kontrollojmë që ngjarjet përputhen me specifikimin tonë. Sistemi kryesor për ngjarjet
- , domethënë kjo është sistemi kryesor dhe i vetëm në kompani, që përgjigjet në pyetjen, se cilat ngjarje me cilat struktura konsiderohen përshtatëse. Në validim përfshihen thjesht llojet e të dhënave dhe enums për specifikimin e fortë të përmbajtjes.Funksioni Hash
- për shardimin — struktura e mesazhit Kafka është key-value dhe sipas hashes nga key llogaritet se ku do ta vendosim. Pse
Ne punojmë në një kompani të madhe me një proces të vendosur. Pse të ndryshojmë diçka?
Ky është një eksperiment , dhe ne presim të fitojmë disa përfitime.1:n+1 shkëmbime (një me shumë)
Me Kafka është shumë e lehtë të lidheni me API të konsumatorëve të rinj.
Me Kafka është shumë e lehtë të lidheni me API-të e konsumatorëve të rinj.
Supozoni se keni një regjistër që duhet ta mbani të azhurnuar në disa sisteme njëkohësisht (edhe në të reja). Më parë ne krijonim një bundle që implementonte set-API, dhe sistemit master i raportonim adresat e konsumatorëve. Tani sistemi master dërgon përditësime në një topic, dhe të gjithë ata që janë të interesuar lexojnë. Pati një sistem të ri — e regjistruam atë në topic. Po, gjithashtu një bundle, por më të thjeshtë.
Në rastin e refund-tool, i cili është një pjesë e BOB, është e lehtë për ne të mbajmë ato të sinkronizuara përmes Kafka. Pagimi thotë se paratë u kthyen: BOB, RT e morën vesh këtë, ndërruan statuset e tyre, Shërbimi i Fiskalizimit mori vesh për këtë dhe nxori një çek.
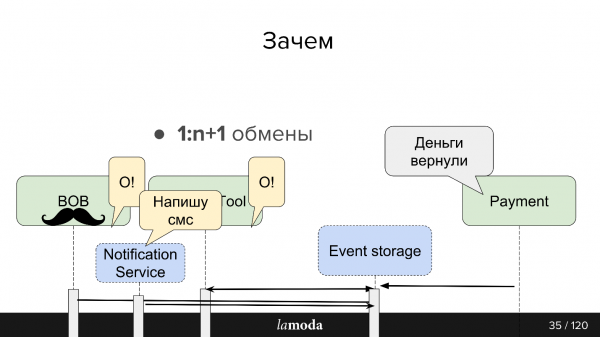
Ne kemi plane për të bërë një Shërbim të Përcjelljes së Njoftimeve i cili do të informonte klientin për lajmet në lidhje me porosinë e tij/për kthimet. Aktualisht kjo përgjegjësi është shpërndarë midis sistemeve. Na mjafton të mësojmë Shërbimin e Njoftimeve të kapë informacionin përkatës nga Kafka dhe të reagojë ndaj tij (dhe të çaktivizojmë këto njoftime në sistemet e tjera). Nuk do të nevojiten shkëmbime të reja të drejtpërdrejta.
Data-driven
Informacioni midis sistemeve bëhet i transparencës — sado "enterprise" të jetë i ndërlikuar dhe sa i madh të jetë backlog-u juaj. Në Lamoda ka një departament të Analizës së Të Dhënave që mbledh të dhënat nga sistemet dhe i transformon ato në një formë të ripërdorueshme, si për biznesin ashtu edhe për sistemet inteligjente. Kafka lejon që t’ju ofrojë atyre shumë të dhëna shpejt dhe të mbajë këtë rrjedhë informacioni të azhurnuar.
Replication log
Mesazhet nuk humbasin pas leximit, si në RabbitMQ. Kur një event përmban informacion të mjaftueshëm për përpunim, ne kemi një histori të ndryshimeve të fundit mbi objektin, dhe, nëse dëshirojmë, mundësinë për të aplikuar këto ndryshime.
Koha e ruajtjes së replication log varet nga intensiteti i shkrimeve në këtë topic, Kafka lejon që të konfigurohen fleksibël kufijtë për sa i përket kohës së ruajtjes dhe përmasat e të dhënave. Për topicet intensive është e rëndësishme që të gjithë konsumatorët të arrijnë të lexojnë informacionin përpara se ai të zhduket, edhe në rast të një mosfunksionimi të përkohshëm. Zakonisht arrihet të ruhet informacioni për njësi ditësh, që është mjaft e mjaftueshme për mbështetje.
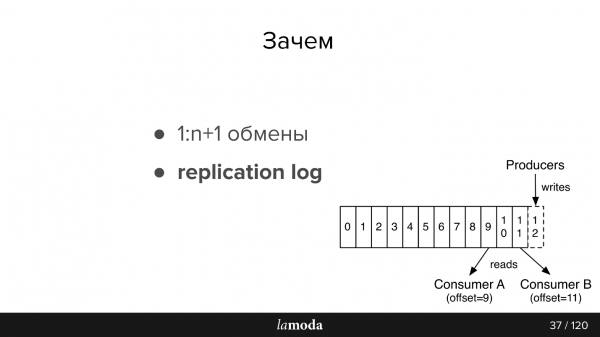
Më pas pak përmbledhje e dokumentacionit, për ata që nuk janë të njohur me Kafka (imazhi gjithashtu është nga dokumentacioni)
Në AMQP ka radhë: shkruajmë mesazhe në radhë për konsumatorin. Zakonisht, një radhë trajtohet nga një sistem me të njëjtën logjikë biznesi. Nëse nevojitet që të njoftohen disa sisteme, mund të mësojmë aplikacionin të shkruajë në disa radhë ose të konfigurojmë një exchange me një mekanizëm fanout, i cili i kopjon ato vetë.
Në Kafka ka një abstraksion të ngjashëm topic, ku shkruani mesazhe, por ato nuk zhduken pas leximit. Në mënyrë të parazgjedhur, kur lidheni me Kafka, merrni të gjitha mesazhet, dhe ka mundësinë të ruani vendin ku jeni ndalur. Kështu që lexoni sequentially, mund të mos shënoni mesazhin si të lexuar, por të ruani id, nga i cili pastaj do të vazhdoni leximin. Id, ku jeni ndalur, quhet offset (shkëputje), dhe mekanizmi është commit offset.
Për rrjedhojë, mund të implementoni logjikë të ndryshme. Për shembull, BOB ekziston në 4 instanca për vende të ndryshme - Lamoda është në Rusi, Kazakistan, Ukrainë, Bjellorusi. Duke qenë se ato deploy-ohen veçmas, ato kanë pak më shumë konfigurime dhe logjikë biznesi të veçantë. Ne tregojmë në mesazh se për cilin vend është. Çdo konsumator BOB në çdo vend lexon me groupId të ndryshme, dhe nëse mesazhi nuk i përket atij, e kalon atë, dmth. menjëherë komiton offset +1. Nëse po aq topic lexon Shërbimi Ynë të Pagesave, atëherë ai e bën këtë me një grup të veçantë, dhe për këtë arsye offset-et nuk përputhen.
Kërkesat për ngjarjet:
- Plotësia e të dhënave. Do të donim që në ngjarje të kishte të dhëna të mjaftueshme për ta trajtuar atë.
- Integriteti. Ne e delegojmë Events-bus kontrollin se ngjarja është e qëndrueshme dhe ai mund ta trajtojë atë.
- Rendi është i rëndësishëm. Në rastin e kthimit, ne jemi të detyruar të punojmë me historinë. Me njoftimet, rendi nuk ka rëndësi, nëse janë njoftime homogjene, email-i do të jetë i njëjtë pavarësisht se cili porosi mbërriti i pari. Në rastin e kthimit ka një proces të qartë, nëse e ndryshojmë rendin, do të ketë përjashtime, rimbursimi nuk do të krijohet apo nuk do të përpunojë - ne do të përfundojmë në një status tjetër.
- Koherenca. Ne kemi një repository dhe tani po krijojmë ngjarje në vend të API. Na nevojitet një mënyrë për të transmetuar shpejt dhe në mënyrë të lirë informacionin për ngjarjet e reja dhe për ndryshimet në ato ekzistuese në shërbimet tona. Kjo arrihet përmes një specifikimi të përbashkët në një depozitë git të ndarë dhe gjeneratorëve të kodit. Prandaj, klientët dhe serverët në shërbime të ndryshme janë të pajtuar.
Kafka në Lamoda
Kemi tri instalime Kafka:
- Logs;
- R&D;
- Events-bus.
Sot po flasim vetëm për pikën e fundit. Në events-bus, ne kemi instalime të vogla - 3 brokerë (serverë) dhe gjithsej 27 tema. Zakonisht, një temë është një proces. Por kjo është një çështje delikate dhe tani do ta trajtojmë atë.
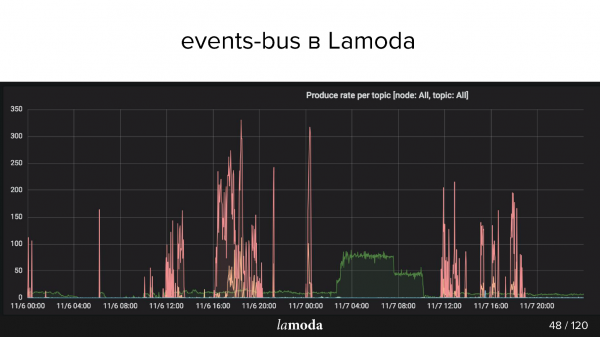
Më sipër është grafiku rps. Procesi i kthimeve shënohet me një vijë turchize (po, po, ajo që është në boshtin X), dhe me pink procesi i përditësimit të përmbajtjes.
Katalogu Lamoda përmban miliona produkte, dhe të dhënat përditësohen vazhdimisht. Disa koleksione dalin nga moda, në vend të tyre lançohen të reja, dhe në katalog në vazhdimësi shfaqen modele të reja. Ne përpiqemi të parashikojmë se çfarë do të jetë interesante për klientët tanë nesër, prandaj vazhdimisht blejmë gjëra të reja, i fotografojmë dhe përditësojmë vitrinën.
Pikat rozë janë përditësime produktesh, dmth ndryshime për produktet. Është e dukshme se djemtë po fotografonin, fotografonin, dhe pastaj papritur! - ngarkuan një grup ngjarjesh.
Rastet e përdorimit të Lamoda Events
Arkitektura e ndërtuar përdoret për operacione të tilla:
- Ndjekja e statusve të kthimeve: thirrje për veprim dhe ndjekja e statusve nga të gjitha sistemet e përfshira. Pagesa, statuset, fiskalizimi, njoftimet. Këtu kemi provuar qasje, krijuar mjete, mbledhur të gjitha gabimet, shkruar dokumentacionin dhe u kemi treguar kolegëve se si ta përdorin këtë.
- Përditësimi i kartelave të produkteve: konfigurimi, meta-të dhënat, karakteristikat. Lexohet nga një sistem (i cili shfaq), ndërsa shkruhet nga disa.
- Email, push dhe sms: porosia u mblodh, porosia arriti, kthimi u pranua etj., shumë prej tyre.
- Stoku, përditësimi i magazinës — përditësim sasi i emrave, thjesht numra: ardhja në magazinë, kthimi. Nevojitet që të gjitha sistemet e lidhura me rezervimin e produkteve të operojnë me të dhëna sa më të sakta. Tani sistemi i përditësimit të stokut është mjaft kompleks, Kafka do ta lehtësojë atë.
- Analiza e të dhënave (R&D-nd部门), mjetet ML, analiza, statistika. Ne duam që informacioni të jetë transparent – për këtë Kafka është shumë i përshtatshëm.
Tani është pjesa më interesante për dhimbjet e përvoja dhe zbulimet interesante që ndodhën gjatë gjashtë muajve.
Problemet e dizajnit
Supozoni se duam të bëjmë një gjë të re – për shembull, të transferojmë tërë procesin e dorëzimit në Kafka. Tani, një pjesë e procesit realizohet në Procesimin e Porosive në BOB. Pas kalimit të porosisë në shërbimin e dorëzimit, pozita në magazinë ndërmjetëse dhe gjërat e tjera kanë një model statusi. Ka një monolit të tërë, madje dy, plus një grumbull API-sh të dedikuara për dorëzimin. Ata dinë shumë më tepër për dorëzimin.
Duket se këto janë fusha të ngjashme, por për Procesimin e Porosive në BOB dhe për sistemin e dorëzimit statuset ndryshojnë. Për shembull, disa shërbime kurierike nuk dërgojnë statuset ndërmjetëse, por vetëm ato përfundimtare: "u dorëzua" ose "u humb". Të tjerët, përkundrazi, raportojnë shumë hollësisht për lëvizjen e produktit. Të gjithë kanë rregullat e tyre të validimit: për dikë, një email valid është i mjaftueshëm për ta procesuar; për të tjerë, është jo valid, por porosia gjithsesi do të procesuar, sepse ka telefon për kontakt, ndërsa dikush tjetër do të thotë se një porosi e tillë nuk do të procesuar fare.
Rrjedha e të dhënave
Në rastin e Kafka, lind pyetja e organizimit të rrjedhës së të dhënave. Kjo detyrë është e lidhur me zgjedhjen e strategjisë në disa pikë, le të kalojmë përmes tyre të gjitha.
Në një temë apo në të ndryshme?
Ne kemi një specifikim të ngjarjes. Në BOB shkruajmë se një porosi e caktuar duhet të dorëzohet, dhe përcaktojmë: numri i porosisë, përbërja e saj, disa SKU dhe kodet bar etj. Kur produkti të arrijë në magazinë, dorëzimi do të mund të marrë statuset, timestamps dhe gjithçka tjetër që nevojitet. Por më pas duam të marrim azhurnime për këto të dhëna në BOB. Ne kemi një proces të kundërt për marrjen e të dhënave nga dorëzimi. A është kjo e njëjta ngjarje? Apo është një shkëmbim i veçantë që meriton një temë të veçantë?
Me sa duket, ato do të jenë shumë të ngjashme, dhe tundimi për të bërë një temë është i justifikueshëm, sepse një temë e veçantë – është konsumatorë të veçantë, konfigurime të veçanta, gjenerim të veçantë të gjithçkaje. Por nuk është fakt.
Fusha e re apo ngjarje e re?
Por shkak se ndodhin ato ngjarje, ka një problem tjetër. Për shembull, jo të gjitha sistemet e dërgimit mund të gjenerojnë një DTO të tillë, që mund të gjenerojë BOB. Ne i dërgojmë atyre ID-të, por ata nuk i ruajnë, sepse atyre nuk u nevojiten, ndërsa nga pikëpamja e fillimit të procesit event-bus, ky fushë është e domosdoshme.
Nëse ne vendosim një rregull për event-bus që ky fushë është e domosdoshme, atëherë jemi të detyruar në BOB ose në trajtuesin e ngjarjeve fillestare të vendosim rregulla të tjera verifikimi. Verifikimi fillon të përhapet në shërbim — kjo nuk është shumë e përshtatshme.
Një problem tjetër është komoditeti i zhvillimit inkremental. Na thonë se duhet të shtojmë diçka në ngjarje, dhe, ndoshta, nëse e mendojmë mirë, duhet të kishte qenë një ngjarje e veçantë. Por në skemën tonë, një ngjarje e veçantë është një temë e veçantë. Një temë e veçantë është tërë procesi që përshkrova më lart. Zhvilluesi ndjen lidhjen të thjeshtë të shtojë një fushë tjetër në skemën JSON dhe ta ri-gjenerojë.
Në rastin e refunds, ne në këtë mënyrë arritëm në një ngjarje ngjarjesh pas gjashtë muajsh. Kishim një meta-ngjarje, e cila quhej refund update, në të cilën kishte një fushë tipe, e cila përshkruante se çfarë përfshin ky update. Nga kjo kishim "fantastike" switch-e me verifikuesit, që thoshin se si duhet verifikuar kjo ngjarje me këtë tip.
Versionimi i ngjarjeve
Për verifikimin e mesazheve në Kafka, mund të përdoren , por duhet të kemi parasysh që të përdorim Confluent. Në rastin tonë me versionimin, duhet të jemi të kujdesshëm. Nuk do të jetë gjithmonë e mundur të ritheksojmë mesazhet nga replication log, sepse modeli është "larguar". Kryesisht, bëhet që të ndërtojmë versione në atë mënyrë që modeli të jetë backward-compatible: për shembull, ta bëjmë një fushë përkohësisht të pavlefshme. Nëse ndryshimet janë shumë të forta, fillojmë të shkruajmë në një temë të re, dhe klientët e kalojmë kur ata e përfundojnë të vjetrin.
Garancia e rendit të leximit të partitions
Temat brenda Kafka janë të ndara në partitions. Kjo nuk është shumë e rëndësishme derisa ne projektuojmë entitetet dhe shkëmbimet, por është e rëndësishme kur vendosim se si do ta konsumojmë dhe do ta shkallëzojmë.
Në rrethanat normale, ju shkruani në Kafka një temë. Fallback, përdoret një ndarës, dhe të gjithë mesazhet e kësaj teme bien në të. Ndërsa konsumatori lexon këto mesazhe në mënyrë të njëpasnjëshme. Le të themi tani, që na duhet të zgjeronim sistemin që mesazhet të lexohet nga dy konsumatorë të ndryshëm. Nëse, për shembull, dërgoni një SMS, mund të themi që Kafka të krijojë një ndarje të shtesë, dhe Kafka do të fillojë të ndajë mesazhet në dy pjesë - gjysmën aty, gjysmën këtu.
Si i ndan Kafka? Çdo mesazh ka një trup (ku ruajmë JSON) dhe ka një çelës. Më këtij çelësi mund të aplikoni një funksion hash, i cili do të përcaktojë në cilën ndarje do të shkojë mesazhi.
Në rastin tonë me rikthimet, kjo është e rëndësishme, nëse marrim dy ndarës, ka mundësi që konsumatori paralel të trajtojë ngjarjen e dytë përpara asaj të parë dhe do të ketë probleme. Funksioni hash garanton që mesazhet me të njëjtin çelës do të shkojnë në të njëjtën ndarje.
Ngjarjet vs urdhrat
Kjo është një tjetër problem me të cilin u përballëm. Ngjarja është një ngjarje: ne themi që diçka ndodhi (something_happened), për shembull, një artikull u anulua ose u bë rikthimi. Nëse këto ngjarje dikush i dëgjon, atëherë në "artikulli u anulua" entiteti i rikthimit do të krijohet dhe "u bë rikthimi" do të regjistrohet diku në konfigurime.
Por zakonisht, kur projektoni ngjarje, nuk dëshironi të shkruani ato kot - parashikoni që dikush do t'i lexojë. Niveli i joshjes është i lartë për të shkruar jo something_happened (item_canceled, refund_refunded), por something_should_be_done. Për shembull, artikulli është gati për kthim.
Nga njëra anë, kjo sugjeron se si do të përdoret ngjarja. Nga ana tjetër, kjo duket shumë më pak si emri normal i një ngjarjeje. Po ashtu, nga kjo nuk është shumë larg deri te urdhri do_something. Por nuk keni garanci që kjo ngjarje është lexuar nga dikush; dhe nëse është lexuar, atëherë është lexuar me sukses; dhe nëse është lexuar me sukses, atëherë bëri diçka, dhe kjo diçka kaloi me sukses. Në momentin që ngjarja bëhet do_something, bëhet e nevojshme të keni feedback dhe kjo është problem.
Në shkëmbimin asinkron në RabbitMQ, kur lexoni një mesazh, shkoni te http, keni një përgjigje - të paktën, që mesazhi u pranua. Kur shkruani në Kafka, keni një mesazh që ju keni shkruar në Kafka, por për mënyrën si është trajtuar, nuk dini asgjë.
Prandaj, në rastin tonë, duhej të merrnim një ngjarje përgjegjëse dhe të vendosnim monitorimin që, nëse ndodhin kaq shumë ngjarje, pas një periudhe kohore duhet të ndodhin kaq shumë ngjarje përgjegjëse. Nëse kjo nuk ndodh, duket se diçka ka shkuar keq. Për shembull, nëse dërgojmë ngjarjen "item_ready_to_refund", presim që refundi të krijohet, klientit t'i kthehen paratë, dhe ne të marrim ngjarjen "money_refunded". Por kjo nuk është e sigurt, prandaj nevojitet monitorimi.
Nuancat
Ka një problem mjaft të qartë: nëse lexoni nga tópiku në mënyrë të vazhdueshme, dhe keni ndonjë mesazh të keq, konsumatori bie dhe më tej nuk mund të vazhdoni. Ju nevojitet të ndaloni të gjithë konsumatorët, të komitoni offset-in më tej, për të vazhduar leximin.
Ne e dinim këtë, e kishim parashikuar, dhe megjithatë ndodhi. Ndodhi sepse ngjarja ishte e vlefshme nga pikëpamja e events-bus, ngjarja ishte e vlefshme nga pikëpamja e validuesit të aplikacionit, por nuk ishte e vlefshme nga pikëpamja e PostgreSQL, sepse në një sistem MySQL kishim UNISIGNED INT, ndërsa në sistemin e sapo shkruar ishte PostgreSQL thjesht me INT. Ai ka një madhësi pak më të vogël dhe Id nuk u përshtat. Symfony vdiq me një përjashtim. Ne, natyrisht, e kapëm përjashtimin, sepse e kishim parashikuar atë, dhe planifikuam të komitonim këtë offset, por para kësaj donim të rritnim numëruesin e problemeve, duke qenë se mesazhi u përpunua me dështim. Numëruesit në këtë projekt gjithashtu ndodhen në bazë, dhe Symfony tashmë kishte mbyllur komunikimin me bazën, dhe një përjashtim tjetër vrau të gjithë procesin pa shanse për të komituar offset-in.
Për një kohë, shërbimi qëndroi i palëvizur - për fat, me Kafka kjo nuk është aq e frikshme, sepse mesazhet mbeten. Kur puna rikthehet, do të jetë e mundur t'i lexoni ato. Kjo është e dobishme.
Kafka ka mundësinë përmes tooling të vendosë një offset të çfarëdo. Por për ta bërë këtë, duhet të ndaloni të gjithë konsumatorët - në rastin tonë, të përgatisni një version të veçantë, në të cilin nuk do të ketë konsumatorësh, redeployments. Atëherë me anë të tooling në Kafka është e mundur të lëvizni offset-in dhe mesazhi do të kalojë.
Një nuancë tjetër - replication log vs rdkafka.so — është e lidhur me specifikat e projektit tonë. Ne kemi PHP, dhe në PHP, zakonisht të gjitha bibliotekat komunikojnë me Kafka përmes depozitës rdkafka.so, dhe më pas ka një lloj mbulese. Mund të jetë se këto janë vështirësi të veta, por rezultoi se thjesht rileximi i një pjese të lexuar më parë nuk është aq i lehtë. Në përgjithësi, pati probleme programe.
Duke u kthyer te veçoritë e punës me partitions, në dokumentacion është shkruar në mënyrë të drejtpërdrejtë consumers >= topic partitions. Por e mësova këtë shumë më vonë se sa do të dëshiroja. Nëse dëshironi të shkallëzoni dhe të keni dy konsumatorë, ju nevojiten të paktën dy partitions. Kështu, nëse keni pasur një partition, në të cilin ishte grumbulluar 20,000 mesazhe, dhe krijuat një të ri, numri i mesazheve nuk do të përputhet shpejt. Prandaj, për të pasur dy konsumatorë paralelë, duhet të merresh me partitions.
Monitorimi
Mendoj se, sipas monitorimeve, do të jetë akoma më e qartë se cilat probleme ka qasja aktuale.
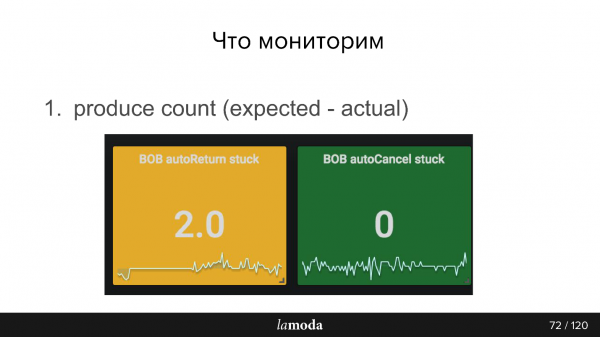
Për shembull, numërojmë sa produkte në bazë sapo kanë ndryshuar statusin, dhe për pasojë, për këto ndryshime duhet të ndodhin ngjarje, dhe e dërgojmë këtë numër në sistemin tonë të monitorimit. Më pas nga Kafka marrim numrin e dytë, sa në të vërtetë janë regjistruar ngjarje. Është e qartë, diferenca midis këtyre dy numrave gjithmonë duhet të jetë zero.
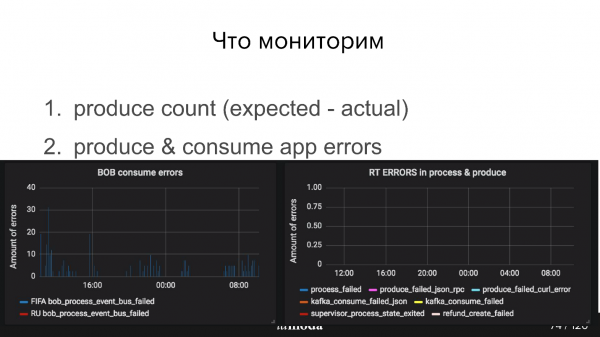
Për më tepër, duhet të monitorojmë si shkon prodhuesi, nëse events-bus ka pranuar mesazhet, dhe si shkon konsumatori. Për shembull, në grafikët më poshtë, Refund Tool është mirë, ndërsa BOB ka dukshëm disa probleme (pikat blu).
Kisha përmendur tashmë vonesën e grupit të konsumatorëve. Në thelb, kjo është sasia e mesazheve të pa lexuara. Në tërësi, konsumatorët tanë punojnë shpejt, prandaj vonesa zakonisht është 0, por ndonjëherë mund të ketë një kulm të shkurtër. Kafka e bën këtë nga kutia, por duhet të caktohet një interval i caktuar.
Ka një projekt , i cili do t'ju japë më shumë informacion për Kafka. Ai thjesht ofron statusin e grupit të konsumatorëve përmes API-së, siç është statusi i grupit të konsumatorëve. Përveç OK dhe Failed, aty ka edhe warning, dhe do të mund të mësoni se konsumatorët tuaj nuk po arrijnë ritmin e prodhimit - nuk po arrijnë të lexojnë atë që shkruhet. Sistemi është mjaft i zgjuar, është komod për t'u përdorur.
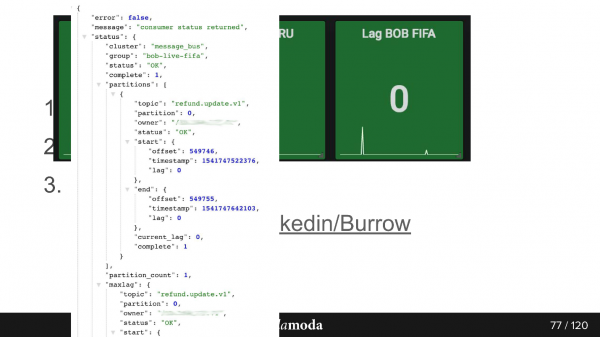
Kështu duket përgjigja përmes API-së. Këtu është grupi bob-live-fifa, partition refund.update.v1, statusi OK, lag 0 - offseti i fundit i përfunduar është ky.
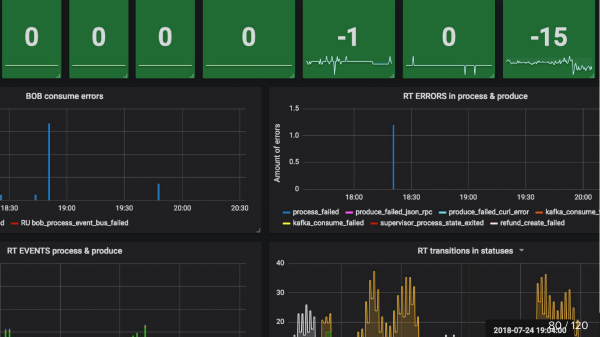
Monitorimi updated_at SLA (e bllokuar) Unë tashmë kam përmendur. Për shembull, artikulli kaloi në statusin që është gati për kthim. Ne vendosim Cron, i cili thotë se nëse brenda 5 minutash ky objekt nuk kalon në refund (ne kthejmë paratë përmes sistemit të pagesave shumë shpejt), atëherë diçka sigurisht ka shkuar keq, dhe ky është një rast për suportin. Prandaj merrni thjesht Cron, i cili lexon këto gjëra, dhe nëse janë më shumë se 0, atëherë dërgon një alarm.
Përmbledhja, përdorimi i ngjarjeve është i përshtatshëm kur:
- informacioni i nevojitet disa sistemeve;
- rezultati i përpunimit nuk ka rëndësi;
- ka pak ngjarje ose ngjarjet janë të vogla.
Duket se artikulli ka një temë mjaft specifike - API asinkron mbi Kafka, por për të lidhur me të, dua menjëherë të rekomandoj shumë cosa.
Së pari, e ardhmja duhet të presim deri në nëntor, por tashmë në prill do të ketë versionin e tij në Shën Petersburg, ndërsa në qershor do të flasim për ngarkesa të larta në Novosibirsk.
Së dyti, autori i raportit, Sergey Zaika, është pjesë e Komitetit Programor të konferencës sonë të re mbi menaxhimin e njohurive. . Konferenca është një ditore, do të mbahet më 26 prill, por programi është shumë i ngjeshur.
Dhe gjithashtu në maj do të ketë dhe (me DevOpsConf në përbërje) - atje gjithashtu mund të ofroni temën tuaj, të flisni për përvojën tuaj dhe të ankohemi për goditjet tuaja të papritura.
Burimi: habr.com
