

Në Sitimobil përdorim bazën e të dhënave MySQL si depozitat kryesore të të dhënave të qëndrueshme. Kemi disa klastera të bazës së të dhënave për shërbime dhe qëllime të ndryshme.
Disponueshmëria e vazhdueshme e masterit është një tregues kritik i funksionimit të sistemit të tërësishëm dhe pjesëve të tij. Rindërtimi automatik i klasterit në rast të dështimit të masterit zvogëlon ndjeshëm kohën e reagimit ndaj incidenteve dhe kohën e pushimit të sistemit. Në këtë artikull do të shqyrtoj skemën e sigurisë së disponueshmërisë së lartë (HA) të klasterit MySQL mbi dhe adresat IP virtuale (VIP).
Zgjidhja HA mbi VIP
Fillimisht do të flas shkurtimisht mbi atë që përfaqëson sistemi ynë i ruajtjes së të dhënave.
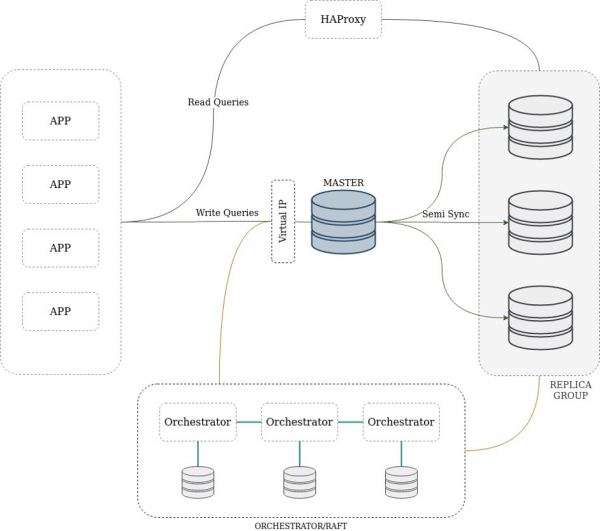
Ne përdorim një skemë klasike replikimi me një master të vetëm, i cili është në dispozicion për shk writing dhe shumë replika që përdoren vetëm për lexim. Klasteri mund të përmbajë një master ndërmjetës — një nyjë që është njëkohësisht replikë dhe master për të tjerët. Klientët qasen në replikat përmes HAProxy, që lejon shpërndarjen e barabartë të ngarkesës dhe lehtësinë në shkallëzim. Përdorimi i HAProxy ka shkak historik dhe tani jemi në procesin e migrimit në ProxySQL.
Replikimi realizohet në mënyrë gjysmë-sinkrone në bazë të GTID. Do të thotë, së paku një replikë duhet të regjistrojë transaksionin në log, përpara se të pranohet si e suksesshme. Ky mod i replikimit siguron një balancim optimal midis performancës dhe ruajtjes së të dhënave në rast dështimi të nyjës kryesore. Në përgjithësi, të gjitha ndryshimet dërgohen nga masteri te replikat përmes Row Based Replication (RBR), por disa nyje mund të kenë mixed binlog format.
Orkestratori përditëson periodikisht gjendjen e topologjisë së klasterit, analizon informacionin e marrë dhe në rast problemeve mund të fillojë procedurën e rindërtimit automatik. Vetë procedura është përgjegjësi e zhvilluesit, pasi mund të realizohet në shumë mënyra: mbi VIP, DNS, duke përdorur shërbime zbulimi (service discovery) ose mekanizma të shkruar vetë.
Një nga mënyrat e thjeshta për të rindërtuar masterin në rast të dështimit të tij është përdorimi i adresave VIP lundruese.
Çfarë duhet të dini mbi këtë zgjidhje para se të vazhdoni më tutje:
- VIP — është një adresë IP që nuk është e lidhur me një ndërfaqe fizike të caktuar rrjeti. Kur një nyje dështon ose gjatë punimeve të planifikuara, ne mund ta kalojmë VIP në një burim tjetër me një kohë të minimizuar ndalimi.
- Largimi dhe dhënia e një adrese IP virtuale janë operacione të lira dhe të shpejta.
- Për të punuar me VIP, kërkohet akses në server përmes SSH, ose përdorimi i utilitareve speciale, për shembull,
keepalived.
Të shqyrtojmë problemet e mundshme me masterin tonë dhe të paraqesim se si duhet të funksionojë mekanizmi i rikuperimit automatik.
Lidhja rrjetë është humbur me masterin, ose ka ndodhur një problem në nivelin e "harduerit", dhe serveri nuk është i aksesueshëm.
- Orkestratori përditëson topologjinë e klasterit, çdo riprodhim raporton për mungesën e masterit. Orkestratori nis procesin e zgjedhjes së një riprodhimi të përshtatshëm për rolin e masterit të ri dhe fillon rikuperimin.
- Përpiqemi të heqim VIP nga masteri i vjetër — pa sukses.
- Riprodhimi kalon në rolin e masterit. Topologjia ristrukturohet.
- Shtojmë një ndërfaqe të re rrjeti me VIP. Duke qenë se nuk arritëm ta heqim VIP, në sfond nisemi me dërgimin e periudhshëm të kërkesës gratuitous ARP. Ky lloj kërkese/ndjelljeje lejon përditësimin në switch-ët e lidhur të tabelës së përputhjes së adresave IP dhe MAC, duke njoftuar kështu për lëvizjen e VIP tonë. Kjo minimizon probabilitetin e
split brainnë rastin e rikthimit të masterit të vjetër. - Të gjitha lidhjet e reja menjëherë drejtohen në masterin e ri. Lidhjet e vjetra përfundojnë pa sukses, duke bërë apel të përsëritur në DB në nivelin e aplikacionit.
Serveri punon në mënyrë normale, ka ndodhur një dështim në nivelin e DBMS.
Algoritmi është i ngjashëm me rastin e mëparshëm: përditësimi i topologjisë dhe nisja e procesit të rikuperimit. Duke qenë se serveri është i aksesueshëm, ne me sukses lirojmë VIP-në nga masteri i vjetër, e transferojmë në të riun dhe dërgojmë disa kërkesa ARP. Rikthimi i mundshëm i masterit të vjetër nuk duhet të ndikoje në klasterin e ristrukturuar dhe punën e aplikacionit.
Probleme të tjera
Dështimi i riprodhimeve ose i masterëve të përkohshëm nuk sjell veprime automatike dhe kërkon ndërhyrje manuale.
Interfejsi virtual rrjetit gjithmonë shtohet përkohësisht, që do të thotë se pas rinisjes së serverit, VIP nuk shenjohet automatikisht. Çdo instancë e DB fillon në mënyrë standarde në modalitetin vetëm për lexim, orkestratori automatikisht kalon master-in e ri në të shkruajtur dhe përpiqet të vendosë vetëm për lexim në master-in e vjetër. Këto veprime janë të orientuara për të reduktuar probabilitetin split brain.
Gjatë procesit të rikuperimit mund të ndodhin probleme, për të cilat gjithashtu duhet të njoftoni përmes UI të orkestratorit, përveç mjeteve standarde të monitorimit. Ne kemi zgjeruar REST API duke shtuar këtë mundësi ( aktualisht është në shqyrtim).
Schema e përgjithshme e zgjidhjes HA është e paraqitur më poshtë.
Zgjedhja e master-it të ri
Orkestratori është mjaft i mençur dhe përpiqet të zgjedhë si master të ri sipas këtyre kritereve:
- mungesa e repikës nga master-i;
- versioni i MySQL i master-it dhe repikës;
- tipi i repikimit (RBR, SBR ose miks);
- vlerësimi në një ose më shumë qendra të të dhënave;
- praninë
GTID i gabuar— transaksionet që janë kryer në repikë dhe mungojnë në master; - po ashtu merren parasysh rregullat e përdoruesve për zgjedhjen.
Jo çdo repikë është kandidati ideal për rolin e master-it. Për shembull, repika mund të përdoret për kopjimin e të dhënave, ose serveri ka një konfigurim më të dobët të "harduerit". Orkestratori rregulla manuale, me ndihmën e të cilave mund të rregulloni preferencat tuaja për zgjedhjen e kandidatëve nga më të preferuarit deri te ata të injoruar.
Koha e reagimit dhe rikuperimit
Në rastin e një incidenti, është e rëndësishme të minimizohet koha e ndalimit të sistemit, prandaj do të shqyrtojmë parametrat e MySQL që ndikojnë në ndërtimin dhe përditësimin e topologjisë së klasit nga orkestratori:
- — numri i sekondave, për të cilat repika pret ardhjen e të dhënave të reja ose sinjalit heartbeat nga master-i, para se lidhja të njihet si e humbur dhe të kryhet ripërcaktimi. Sa më i vogël të jetë ky vlerë, aq më shpejt repika do të jetë në gjendje të përcaktojë se lidhja me master-in është shkeputur. Ne e vendosim këtë vlerë të jetë 5 sekonda.
- — numri i sekondave midis përpjekjeve për rikthim. Në rast të problemeve në rrjet, një vlerë e ulët e këtij parametri do të lejojë rikthim të shpejtë dhe do të parandalojë nisjen e procesit të rimëkëmbjes së klasterit. Vlera e rekomanduar është 1 sekondë.
MASTER_RETRY_COUNT— numri maximal i përpjekjeve për rikthim.MASTER_HEARTBEAT_PERIOD— intervali në sekonda, pas të cilit master-i dërgon një sinjal heartbeat. Në parazgjedhje, është e barabartë me gjysmën e vlerësslave_net_timeout.
Parametrat e orkestratorit:
DelayMasterPromotionIfSQLThreadNotUpToDate— nëse është i barabartë metrue, atëherë roli i master-it nuk do të zbatohet në replikën-kandidate derisa rrjedha SQL e replikës të përfundojë të gjitha transaksionet e papërfunduara nga Relay Log. Ne e përdorim këtë opsion për të mos humbur transaksionet në kushte vonese të të gjitha replikave-kandidate.InstancePollSeconds— frekuenca e ndërtimit dhe azhurnimit të topologjisë.RecoveryPollSeconds— frekuenca e analizës së topologjisë. Në rast se zbulohet një problem, niset rikthimi i topologjisë. Kjo është, e barabartë me 1 sekondë.
Çdo nod në klasteri pyetet nga orkestratori një herë në InstancePollSeconds sekonda. Në rast se zbulohet ndonjë problem, gjendja e klasterit detyrohet, dhe më pas merret një vendim përfundimtar për të realizuar rikthimin. Duke eksperimentuar me parametra të ndryshëm të DB dhe orkestratorit, kemi arritur të ulemi kohën e reagimit dhe rikthimit në 30 sekonda.
Standi i testimit
Testimi i skemës HA e filluam me zhvillimin e një dhe më pas implementimin në mjedise testimi dhe prodhimi. Stenda lokale është plotësisht e automatizuar mbi bazën e Docker-it dhe lejon të eksperimentojmë me konfigurimin e orkestratorit dhe rrjetit, të shkallëzojmë klasterin nga 2-3 servera në disa dhjetëra dhe të zhvillojmë ushtrime në një mjedis të sigurt.
Gjatë ushtrimeve ne zgjedhim një nga metodat e imitim të problemeve: të qetësojmë menjëherë master-in me kill -9, të përfundojmë butë procesin dhe të ndalojmë serverin (docker-compose stop), të imitojmë probleme me rrjetin me iptables -j REJECT ose iptables -j DROP. Ne presim këto rezultate:
- orkestratori do të zbulojë probleme me master-in dhe do të azhurnojë topologjinë për më pak se 10 sekonda;
- procedura e rikthimit do të nisë automatikisht: do të ndryshojë konfigurimi i rrjetit, roli i master-it do të kalojë në replikë, topologjia do të rinovohet;
- masteri i ri do të jetë i disponueshëm për regjistrim, replikat e drejtpërdrejta nuk do të humbasin gjatë procesit të rindërtimit;
- të dhënat do të fillojnë të regjistrohen në masterin e ri dhe të replikohen;
- koha totale e rikuperimit do të jetë jo më shumë se 30 sekonda.
Siç e dini, sistemi mund të sillej ndryshe në mjediset e testimit dhe në ato të prodhimit për shkak të konfigurimeve të ndryshme të ‘harduerit’ dhe rrjetit, dallimeve në ngarkesat sintetike dhe reale, etj. Prandaj, herë pas here ne kryejmë ushtrime në kushte reale, duke kontrolluar se si sillej sistemi në rast të humbjes së lidhjes rrjet dhe degradimit të disa pjesëve të tij. Në të ardhmen dëshirojmë të ndërtuam një infrastrukturë krejtësisht identike për të dy mjediset dhe ta automatizojmë testimin e saj.
Përfundimet
Funksionaliteti i nodës kryesore të sistemit të ruajtjes së të dhënave është një nga detyrat kryesore të ekipit SRE dhe të operacioneve. Zbatimi i orkestratorit dhe zgjidhjes HA të bazuar në VIP ka sjellë rezultatet e mëposhtme:
- zbulesa e besueshme e problemeve me topologjinë e klasterit të DB;
- reaksion automatik dhe të shpejtë në incidentet e lidhura me masterin, duke reduktuar kohën e papunësisë së sistemit.
Megjithatë, zgjidhja ka kufizimet dhe disavantazhet e saj:
- zhvillimi i skemës HA në disa Qendra të Dhënash do të kërkojë një rrjet L2 të përbashkët ndërmjet tyre;
- para se të emërojmë VIP në masterin e ri, na nevojitet të lirohet ai në të vjetrin. Procesi është sekuencial, gjë që rrit kohën e rikuperimit;
- lirimi i VIP kërkon qasje SSH në serverin, ose çdo mënyrë tjetër për thirrjen e procedurave të distancuara. Duke qenë se serveri ose DB është duke përjetuar probleme që shkaktuan procesin e rikuperimit, nuk mund të jemi të sigurt se lirimi i VIP do të përfundojë me sukses. Dhe kjo mund të çojë në dy servera me të njëjtin adresë IP virtuale dhe një problem
split brain.
Për të shmangur split brain, mund të përdoret metoda ('Qëlloni Nodën Tjetër Në Kokë'), e cila izolon plotësisht ose fik nodën problematike. Ka edhe mënyra të tjera për realizimin e disponueshmërisë së lartë të klasterit: kombinimi i VIP dhe DNS, zbulimi i shërbimeve dhe shërbimet proxy, replikimi sinkron dhe metoda të tjera, të cilat kanë disavantazhet dhe avantazhet e tyre.
Kam tregova për qasjen tonë në krijimin e një klasteri MySQL me tolerancë për dështime. Ai është i lehtë për t'u zbatuar dhe ofron një nivel të pranueshëm besueshmërie në kushtet aktuale. Ndërsa sistemi zhvillohet si një e tërë dhe infrastruktura në veçanti, ky qasje do të evoluojë pa dyshim.
Burimi: habr.com
