

Këtë pranverë ne kemi diskutuar disa tema hyrëse, për shembull, dhe . Në të dytën, ne madje premtuam të vazhdojmë studimin e performancës së topologjive të ndryshme me shumë disqe në ZFS. Kjo është një sistem skedarësh të ardhshme që tani po implementohet kudo: nga në .
Epo, sot është dita më e përshtatshme për t'u njohur me ZFS, lexues të kureshëm. Thjesht dinë se, sipas një vlerësimi modest të zhvilluesit të OpenZFS, Matt Arens, 'është vërtet e komplikuar.'
Por para se të arrijmë te numrat — dhe ata do të jenë, e premtoj — për të gjitha opsionet e konfigurimit me tetë disqe në ZFS, duhet të flasim për atë si si ZFS i ruan të dhënat në disk.
Zpool, vdev dhe device
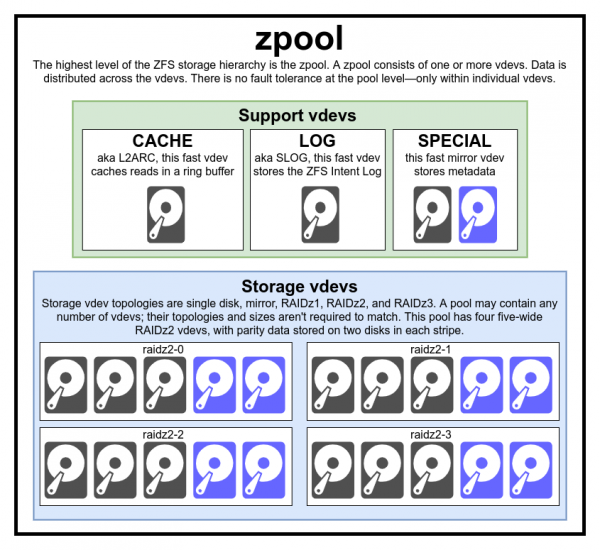
Ky diagram i rezervuarit të plotë përfshin tre vdev të ndihmës, një nga çdo klasë, dhe katër për RAIDz2
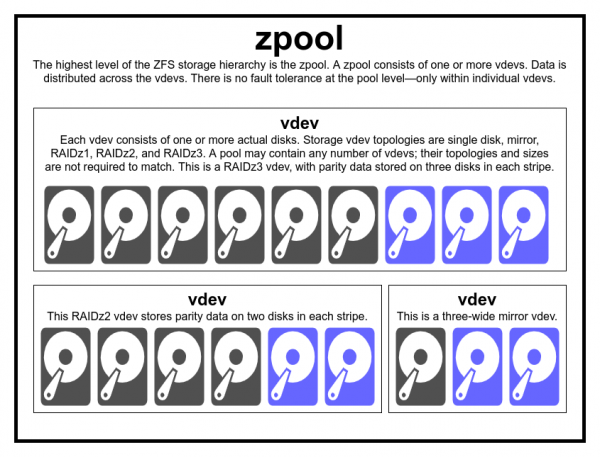
Zakonisht nuk ka arsye për të krijuar një rezervuar nga lloje dhe dimensione të papajtueshme vdev — por nëse dëshironi, asgjë nuk ju pengon të bëni këtë
Për të kuptuar vërtet sistemin e skedarëve ZFS, duhet të shikoni me kujdes në strukturën e saj reale. Së pari, ZFS bashkon nivelet tradicionale të menaxhimit të volumit dhe sistemit të skedarëve. Së dyti, ajo përdor një mekanizëm transaksional të kopjimit në shkrim. Këto veçori do të thotë që sistemi është strukturalisht shumë i ndryshëm nga sistemet e zakonshme të skedarëve dhe grupeve RAID. Grupi i parë i blloqeve themelore për të kuptuar: është rezervuari i ruajtjes (zpool), aparati virtual (vdev) dhe aparati i vërtetë (device).
zpool
Rezervuari i ruajtjes zpool — struktura më e lartë e ZFS. Çdo rezervuar përmban një ose më shumë aparate virtuale. Ndërsa secili prej tyre përmban një ose më shumë aparate të vërtetë (device). Pulat virtuale janë blloqe autonome. Një kompjuter fizik mund të përmbajë dy ose më shumë rezerva të veçanta, por secili është plotësisht i pavarur nga të tjerët. Rezervuarët nuk mund të ndajnë aparate virtuale.
Redundanca e ZFS ndodhet në nivelin e aparateve virtuale, jo në nivelin e rezervuara. Në nivelin e rezervuara nuk ka asnjë lloj redundance — nëse humbet ndonjë magazinë vdev ose një vdev të veçantë, atëherë humbet gjithashtu të gjithë rezervuarin.
Pulat e ruajtjes moderne mund të përballojnë humbjen e cache-it ose log-ëve të pajisjeve virtuale — megjithatë, ata mund të humbin një sasi të vogël të të dhënave të papastruara nëse humbasin log-un e vdev gjatë një ndërlidhjeje ose dështimi të sistemit.
Ekziston një keqkuptim i zakonshëm që "strips" ZFS shkruhen në të gjithë pulin. Kjo është e pasaktë. Zpool nuk është aspak një RAID0 qesharak; është më tepër një me një mekanizëm të ndërlikuar shpërndarjeje.
Për shumicën e rasteve, shënimet shpërndahen midis pajisjeve virtuale të disponueshme sipas hapësirës së lirë të disponueshme, kështu që teorikisht të gjitha do të mbushen njëkohësisht. Në versionet më të vonshme të ZFS, merret parasysh përdorimi aktual (utilizimi) i vdev — nëse një pajisje virtuale është shumë më e ngarkuar se një tjetër (p.sh., për shkak të ngarkesës së leximit), ajo do të shpërfillët për shkruan, pavarësisht nga koeficienti më i lartë i hapësirës së lirë.
Mekanizmi i përcaktimit të përdorimit, i ndërtuar në metodat moderne të shpërndarjes së shënimeve ZFS, mund të reduktojë vonesën dhe të rrisë kapacitetin gjatë periudhave të ngarkesës së pazakontë të lartë — por kjo nuk është kartë-bllok për përzierjen e pavullnetshme të HDD-ve të ngadalshme dhe SSD-ve të shpejtë në një pul. Një pul i tillë, i pabarabartë, do të funksionojë gjithsesi me shpejtësinë e pajisjes më të ngadalshme, pra sikur të ishte krejtësisht përbërë nga këto pajisje.
vdev
Çdo pul ruajtjeje përbëhet nga një ose disa pajisje virtuale (virtual device, vdev). Në turn, çdo vdev përfshin një ose më shumë pajisje reale. Shumica e pajisjeve virtuale përdoren për ruajtjen e thjeshtë të të dhënave, por ekzistojnë disa klasa ndihmëse të vdev, duke përfshirë CACHE, LOG dhe SPECIAL. Çdo nga këto lloje vdev mund të ketë një nga pesë topologjitë: një pajisje të vetme (single-device), RAIDz1, RAIDz2, RAIDz3 ose pasqyrë (mirror).
RAIDz1, RAIDz2 dhe RAIDz3 janë variante të veçanta të asaj që dikur njihej si RAID me dyfishim (diagonal). 1, 2 dhe 3 i referohen numrit të bllokjeve të kontrollit të paracaktuar për secilën brez të të dhënave. Në vend të disqeve të veçanta për sigurimin e kontrollit, pajisjet virtuale RAIDz e shpërndajnë këtë kontroll në mënyrë semi-uniforme mes disqeve. Një masiv RAIDz mund të humbasë aq disqe sa ka bllokje kontrolli; nëse humb edhe një tjetër, do të dalë jashtë funksionit dhe do të shkatërrojë gjithashtu rezervatin e ruajtjes.
Në pajisjet virtuale të pasqyrës (mirror vdev), çdo bllok ruhet në çdo pajisje në vdev. Ndërsa pasqyrat dyfisha (two-wide) janë më të zakonshme, mund të ketë çdo numër të rastësishëm pajisjesh në pasqyrë — në instalime të mëdha për të përmirësuar performancën e leximit dhe qëndrueshmërinë, shpesh përdoren pasqyra trefish. Një pasqyrë vdev mund të mbijetojë çdo dështim, për sa kohë që vazhdon të funksionojë së paku një pajisje në vdev.
Vdev të vetme në thelb janë të rrezikshme. Një pajisje virtuale e tillë nuk do të mbijetojë asnjë dështim — dhe nëse përdoret si ruajtje ose vdev i veçantë, dështimi i saj do të çojë në shkatërrimin e të gjithë rezervatit. Kujdesuni shumë këtu.
Pajisjet virtuale CACHE, LOG dhe SPECIAL mund të krijohen sipas ndonjë prej topologjive të mësipërme — por kujtoni se humbja e një pajisjeje virtuale SPECIAL do të thotë humbjen e rezervatit, kështu që rekomandohet që të ketë një topologji të tepërt.
device
Kjo është ndoshta termi më i lehtë për t'u kuptuar në ZFS — është literalisht një pajisje blloku me qasje të rastësishme. Kujtoni se pajisjet virtuale përbëhen nga pajisje të veçanta, ndërsa rezervati përbëhet nga pajisje virtuale.
Disqet — magnetike ose solid-state — janë pajisjet më të zakonshme bllok që përdoren si blloqe ndërtimi për vdev. Megjithatë, çdo pajisje me një descriptor në /dev është në rregull — kështu që gjithashtu mund të përdoren grupe të plota RAID harduerike si pajisje të veçanta.
Një skedar raw i thjeshtë është një nga pajisjet alternative më të rëndësishme bllok nga të cilat mund të ndërtohet një vdev. Pulat testuese nga janë një mënyrë shumë e dobishme për të provuar komandat e rezervatit dhe për të parë sa hapësirë është në dispozicion në rezervat ose pajisjet virtuale të kësaj topologjie.
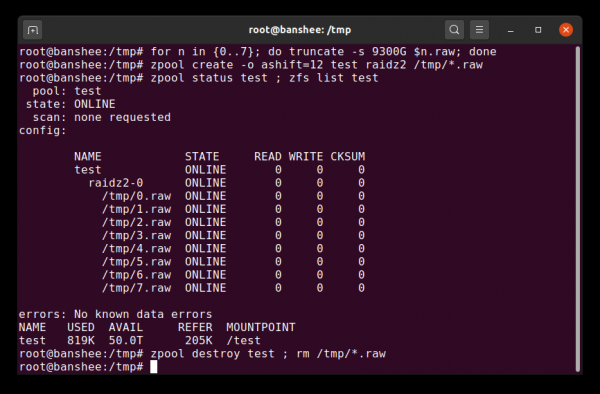
Mund të krijoni një grup testues nga skedarë të holluar për disa sekonda — por mos harroni më pas të fshini të gjithë grupin dhe komponentët e tij.
Supozoni se dëshironi të vendosni një server me tetë disqe dhe planifikoni të përdorni disqe 10 TB (~9300 GiB) — por nuk jeni të sigurt se cila topologji i përshtatet më së miri nevojave tuaja. Në shembullin e mësipërm, ne krijojmë një grup testues nga skedarët e holluar për disa sekonda — dhe tani e dimë se një RAIDz2 vdev me tetë disqe 10 TB siguron 50 TiB kapacitet të dobishëm.
Një klasë tjetër e veçantë e pajisjeve është SPARE (rezervë). Pajisjet e nxehta të zëvendësimit, ndryshe nga pajisjet e zakonshme, i përkasin të gjithë grupit dhe jo një vdev të vetëm. Nëse ndonjë vdev në grup dështon, dhe pajisja rezervë është e lidhur me grupin dhe e disponueshme, ajo automatikisht do të bashkohet me vdev-in e dëmtuar.
Pas lidhjes me vdev-in e dëmtuar, pajisja rezervë fillon të marrë kopje ose rikonstruksione të të dhënave që duhet të jenë në pajisjen e munguar. Në RAID-in tradicional, kjo quhet rikuperim (rebuilding), ndërsa në ZFS që quhet "rikuperim mbivendësie" (resilvering).
Është e rëndësishme të theksohet se pajisjet rezervë nuk zëvendësojnë përherë pajisjet që kanë dështuar. Kjo është vetëm një zëvendësim i përkohshëm për të shkurtuar kohën gjatë së cilës vdev-i është i degraduar. Pas zëvendësimit të pajisjes së dështuar nga administratori, ndodh rikuperimi i mbivendësisë në këtë pajisje të përhershme, dhe SPARE shkëputet nga vdev-i dhe kthehet në funksion si rezervë për të gjithë grupin.
Grupet e të dhënave, blloqet dhe sektoret
Grupi tjetër i blloqeve ndërtuese që duhet të kuptohet në udhëtimin tonë me ZFS, lidhet më shumë me mënyrën se si organizohen dhe ruhen të dhënat. Ne këtu kalojmë disa nivele — si metaslab — për të shmangur grumbullimin e detajeve, duke ruajtur kuptimin e strukturës së përgjithshme.
Grupi i të dhënave (dataset)
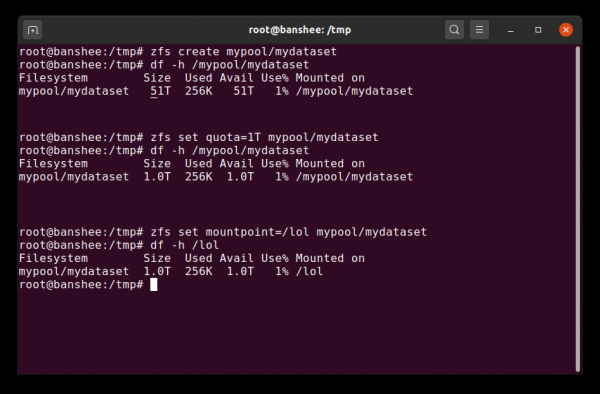
Kur krijojmë për herë të parë një grup të dhënash, ai tregon gjithë hapësirën e disponueshme të grupit. Pastaj ne vendosim një kuotë — dhe ndryshojmë pikën e montimit. Magjia!
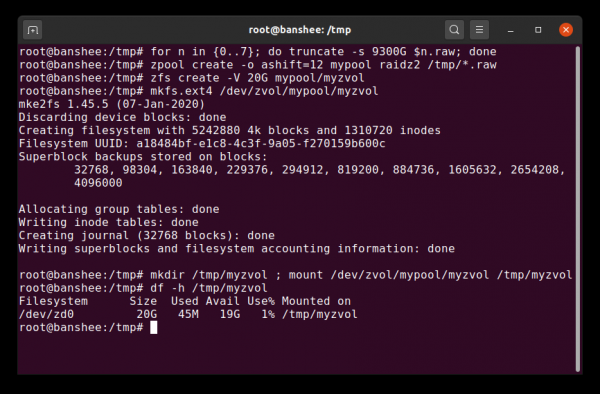
Zvol është në thelb një grup të dhënash, i cili i mungon layer-in e tij të sistemit të skedarëve, që ne e zëvendësojmë këtu me një sistem të zakonshëm skedarësh si ext4.
Grupi i të dhënave ZFS është afërsisht i ngjashëm me sistemin standard të skedarëve të montuar. Ashtu si një sistem i zakonshëm skedarësh, në pamje të parë duket "thjesht si një tjetër dosje". Por, ashtu si në sistemet e zakonshme të skedarëve të montuar, secili grup të dhënash ZFS ka setin e vet të pronave bazë.
Para së gjithash, një grup të dhënash mund të ketë një kuotë të caktuar. Nëse vendosni zfs set quota=100G poolname/datasetname, atëherë nuk do të jeni në gjendje të shkruani në dosjen e montuar /poolname/datasetname më shumë se 100 GiB.
A keni vënë re praninë – dhe mungesën – e ndarësve në fillim të çdo rreshti? Secili grup të dhënash ka vendin e tij si në hierarkinë ZFS, ashtu edhe në hierarkinë e montimit të sistemit. Në hierarkinë ZFS nuk ka ndarës në fillim – filloni me emrin e pishinës dhe pastaj rrugën nga një grup të dhënash në tjetrin. Për shembull, pool/parent/child për një grup të dhënash me emrin fëmija nën grupin e dhënash prind parent në një pishinë me një emër krijues pool.
Në mënyrë të parazgjedhur, pika e montimit të grupit të dhënash do të jetë ekuivalente me emrin e tij në hierarkinë ZFS, me një ndarës në fillim – pishina me emrin pool do të montojë si /pool, grupi i të dhënash parent do të montohet në /pool/parent, dhe grupi i dhënash fëmijë fëmija do të montohet në /pool/parent/child. Megjithatë, pika e montimit e sistemit për grupin e dhënash mund të ndryshohet.
Nëse ne përcaktojmë zfs set mountpoint=/lol pool/parent/child, atëherë grupi i dhënash pool/parent/child do të montohet në sistem si /lol.
Përveç grupeve të dhënash, duhet të përmendim volumin (zvols). Një volum është afërsisht i ngjashëm me një grup të dhënash, përveçse nuk ka në të një sistem skedarësh – është thjesht një pajisje blloku. Ju mund, për shembull, të krijoni zvol me emrin mypool/myzvol, pastaj ta formatoni me një sistem skedarësh ext4, dhe më pas ta montoni këtë sistem skedarësh – tani keni një sistem skedarësh ext4, por me mbështetje për të gjitha funksionet e sigurisë ZFS! Kjo mund të duket e çuditshme në një kompjuter, por ka shumë më shumë kuptim si një back-end kur eksportoni një pajisje iSCSI.
Njësi
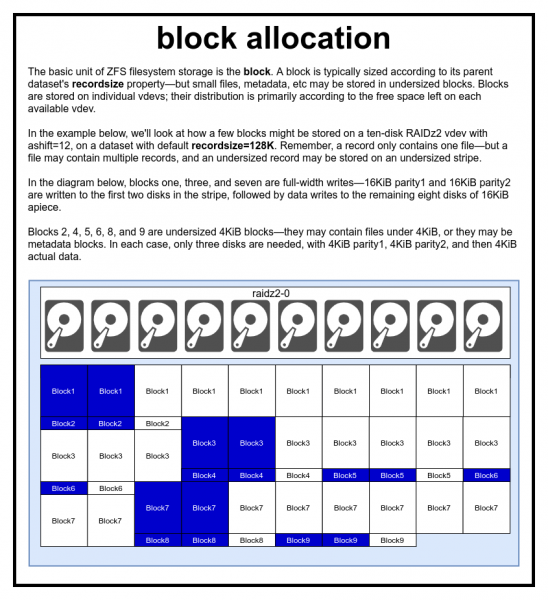
Skedari përfaqësohet nga një ose disa blloqe. Çdo bllok ruhet në një pajisje virtuale. Madhësia e bllokut zakonisht është e barabartë me parametrin recordsize, por mund të ulet në 2^ashift, nëse përmban metadata ose një skedar të vogël.
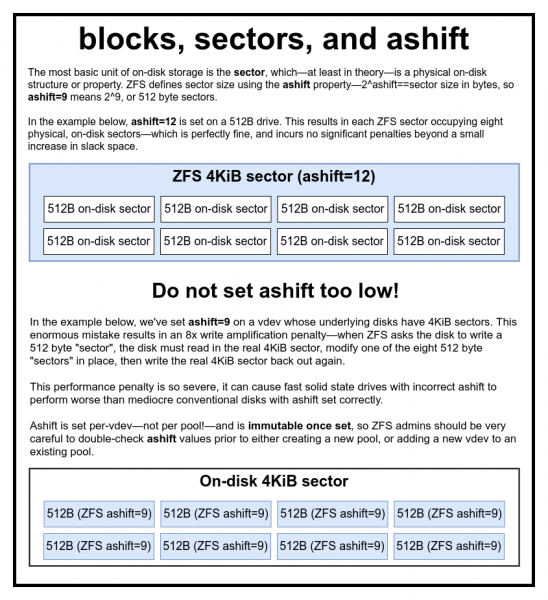
Ne vërtet, vërtetë nuk e kemi fjalë për dëmin e madh të performancës, nëse vendosni një ashift shumë të vogël
Në grupin ZFS të gjitha të dhënat, duke përfshirë metadatën, ruhen në blloqe. Madhësia maksimale e bllokut për secilën grup të dhënash përcaktohet në pronën recordsize (madhësia e shënimit). Madhësia e shënimit mund të ndryshojë, por kjo nuk do të ndryshojë madhësinë ose pozicionin e ndonjë blloku që është tashmë shkruar në grupin e dhënash - ajo vepron vetëm për blloqet e reja ndërsa shkruhen.
Nëse nuk është përcaktuar ndryshe, madhësia aktuale e shënimit për default është 128 KiB. Ky është një kompromis i caktuar, ku performanca do të jetë as ideale, as e tmerrshme në shumicën e rasteve. Madhësia e shënimit mund të vendoset në çdo vlerë nga 4K deri në 1M (me konfigurime shtesë recordsize mund të vendoset edhe më shumë, por kjo rrallë është një ide e mirë).
Çdo bllok referon vetëm në të dhënat e një skedari - nuk mund të futni dy skeda të ndryshme në një bllok. Çdo skedar është i përbërë nga një ose disa blloqe, varësisht nga madhësia. Nëse madhësia e skedarit është më e vogël se madhësia e shënimit, ai do të ruhet në një bllok më të vogël - për shembull, një bllok me një skedar 2 KiB do të marrë vetëm një sektor 4 KiB në disk.
Nëse skedari është mjaft i madh dhe kërkon disa blloqe, atëherë të gjitha shënimet me këtë skedar do të kenë madhësinë recordsize - duke përfshirë shënimin përfundimtar, pjesa kryesore e të cilit mund të rezultojë .
Grupet zvol nuk kanë pronë recordsize - përkundrazi, ato kanë një pronë ekuivalente madhësia e bllokut të volumit.
Sektorët
Sektori, blloku më i fundit, më thelbësor. Ky është njësi fizike më e vogël, e cila mund të shkruhet ose lexohet nga pajisja bazë. Gjatë disa dekadash, shumica e disqeve kanë përdorur sektorë prej 512 byte. Kohët e fundit, shumica e disqeve janë konfiguruar për sektorë 4 KiB, dhe në disa - veçanërisht SSD - sektorët 8 KiB ose madje më shumë.
Në sistemin ZFS ekziston një pronë që lejon të vendosni manualisht madhësinë e sektorit. Kjo pronë ashift. Paksa e ngatërruar, që ashift është një fuqi e dyshes. Për shembull, ashift=9 nënkupton madhësinë e sektorit 2^9, ose 512 byte.
ZFS kërkon nga sistemi operativ informacion të detajuar për çdo pajisje bllok, kur ajo shtohet në një vdev të ri, dhe teorikisht e vendos automatikisht ashift në mënyrë të duhur mbi bazën e këtij informacioni. Fatkeqësisht, shumë disqe gënjejnë për madhësinë e tyre të sektorëve për të ruajtur përputhshmërinë me Windows XP (i cili nuk ishte në gjendje të kuptonte disqe me madhësi të tjera sektorësh).
Kjo do të thotë se administratori i ZFS rekomandohet me ngulm të dijë madhësinë e vërtetë të sektorëve të pajisjeve të tij dhe ta vendosë atë manualisht. ashift. Nëse ashift është vendosur shumë i vogël, atëherë numri i operacioneve të leximit/shkrimit rritet astronomikisht. Pra, shkrimi i "sektorëve" 512-byte në një sektor real 4 KiB nënkupton nevojën për të shkruar "sektorin" e parë, pastaj të lexojë sektorin 4 KiB, ta ndryshojë me "sektorin" e dytë 512-byte, ta shkruajë prapë në sektorin e ri 4 KiB dhe kështu me radhë për çdo shkrim.
Në botën reale, një dënim i tillë ka ndikim tek diskët e ngurtë Samsung EVO, për të cilët duhet të jetë në fuqi ashift=13, por këto SSD gënjejnë për madhësinë e tyre të sektorëve, dhe prandaj vendoset si parazgjedhje ashift=9. Nëse një administrator i avancuar i sistemit nuk e ndryshon këtë parametrin, atëherë ky SSD punon mëngjes si një HDD të zakonshëm.
Për krahasim, nuk ka ndonjë dënim për madhësi tepër të madhe ashift . Përmirësimi real i performancës nuk ka, dhe rritja e hapësirës së papërdorur është përjetësisht e vogël (ose e barabartë me zero kur kompresimi është aktivizuar). Prandaj, ne rekomandojmë ngulmshëm madje edhe për disqet, që me të vërtetë përdorin sektorë 512-byte, të vendosin ashift=12 apo madje ashift=13, për të shikuar me siguri drejt të ardhmes.
Pronësia ashift vendoset për çdo pajisje virtuale vdev, dhe jo për rezervuarin, siç mendojnë shumë, dhe nuk ndryshohet pasi është vendosur. Nëse për fat të keq e keni prishur ashift kur shtoni një vdev të ri në rezervuar, atëherë e keni ndotur përhershmërisht këtë rezervuar me një pajisje me performancë të ulët dhe, për zakon, nuk ka një zgjidhje tjetër përveçse të shkatërroni rezervuarin dhe të filloni gjithçka nga e para. Edhe heqja e vdev-it nuk do të shpëtojë nga konfigurimi i prishur. ashift!
Mekanizmi i kopjimit gjatë shkrimit
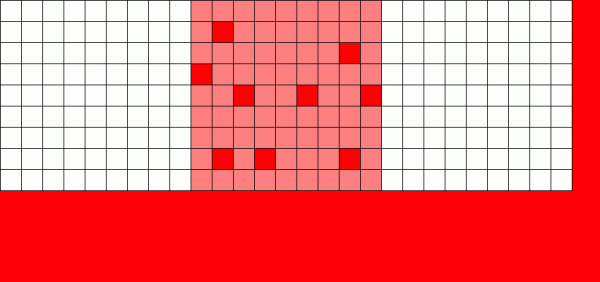
Nëse një sistem i zakonshëm të skedarëve duhet të rishkruajë të dhëna - ai ndryshon çdo bllok aty ku ndodhet.
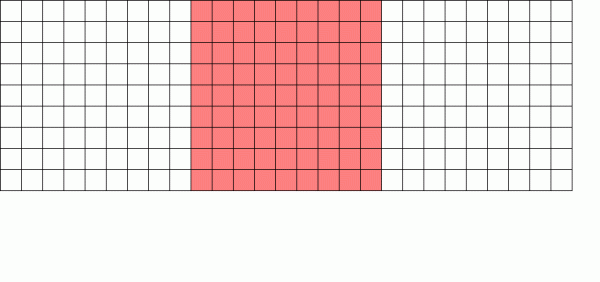
Sistemi i skedarëve me kopjim gjatë shkrimit regjistron një version të ri të bllokut dhe pastaj çel versionin e vjetër
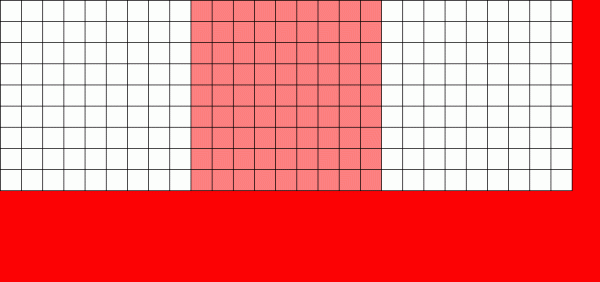
Në një kuptim abstrahues, nëse injorojmë vendndodhjen fizike reale të bllokut, 'kometa e të dhënave' tonë thjeshtohet në një 'krimb të dhënash', i cili lëviz nga e majta në të djathtë në hartën e hapësirës së disponueshme
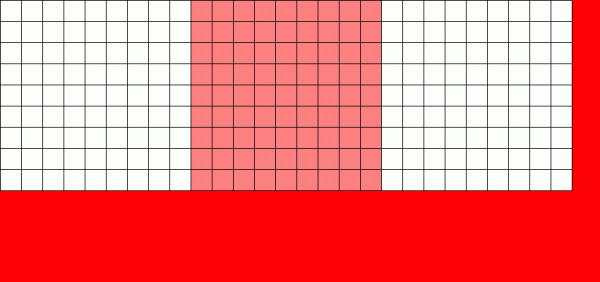
Tani mund të kemi një ide të qartë se si funksionojnë snapshots me kopjim gjatë shkrimit — çdo bllok mund t'i përkasë disa snapshots, dhe do të ruhet deri sa të shkatërrohen të gjithë snapshots e lidhura
Mekanizmi i kopjimit gjatë shkrimit (Copy on Write, CoW) është themeli i asaj që e bën ZFS një sistem kaq të shkëlqyer. Koncepti kryesor është i thjeshtë — nëse i kërkoni një sistem tradicional skedari të ndryshojë një skedar, ai do të bëjë atë që i kërkoni. Nëse i kërkoni një sistem skedari me kopjim gjatë shkrimit të bëjë të njëjtën gjë, ai do të thotë 'mirë' — por do t'ju gënjejë.
Në vend të kësaj, sistemi i skedarëve me kopjim gjatë shkrimit regjistron një version të ri të bllokut të ndryshuar dhe pastaj përditëson meta të dhënat e skedarit për të ndarë lidhjen me bllokun e vjetër dhe për të lidhur me të bllokun e ri që sapo e keni regjistruar.
Shkëputja e bllokut të vjetër dhe lidhja e bllokut të ri realizohet me një operacion, prandaj nuk mund të ndërpritet — nëse nënshkruani energjinë pasi të ndodhë kjo, keni një version të ri të skedarit, dhe nëse nënshkruani energjinë më herët, atëherë keni versionin e vjetër. Në çdo rast, nuk do të ketë konflikte në sistemin e skedarëve.
Kopjimi gjatë shkrimit në ZFS ndodh jo vetëm në nivelin e sistemit të skedarëve, por edhe në nivelin e menaxhimit të disqeve. Kjo do të thotë se ZFS nuk është e prekshme nga hapësira e shkrimit () — fenomeni kur shiriti ka arritur të regjistrohet vetëm pjesërisht deri në dështimin e sistemit, me dëmtimin e grupit pas rinisjes. Këtu, shiriti shkruhet atomikisht, vdev gjithmonë është i rregullt, dhe .
ZIL: e journali i qëllimeve ZFS
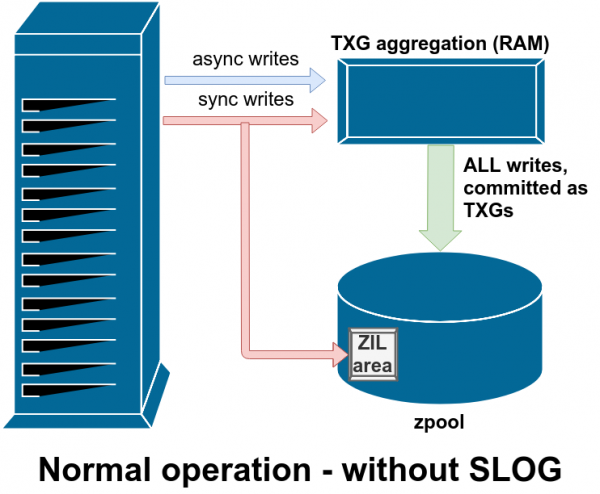
Sistemi ZFS trajton regjistrimet sinkrone në një mënyrë të veçantë — ai përkohësisht, por menjëherë i ruan ato në ZIL, para se më vonë t'i regjistrojë ato në mënyrë të përhershme së bashku me regjistrimet asinkrone
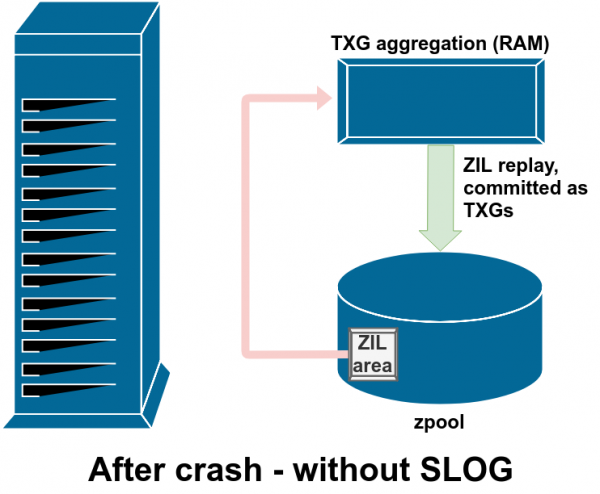
Zakoni është që të dhënat e regjistruara në ZIL kurrë nuk lexohen më. Por është e mundur pas dështimit të sistemit
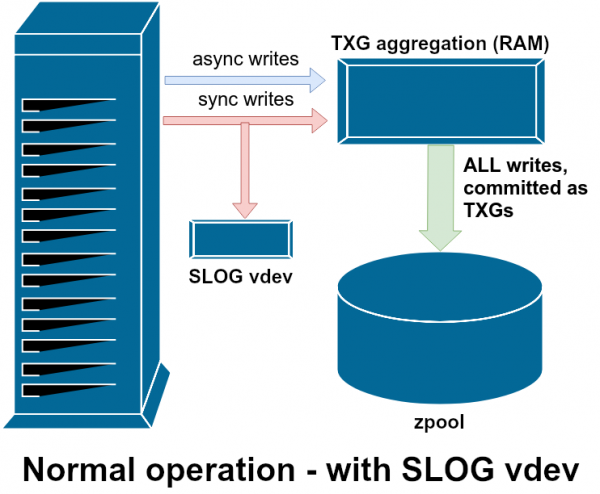
SLOG, ose pajisja e dytë LOG, është thjesht një vdev i veçantë - dhe, preferohet, shumë i shpejtë - ku ZIL mund të ruhet ndaras nga ruajtja kryesore.
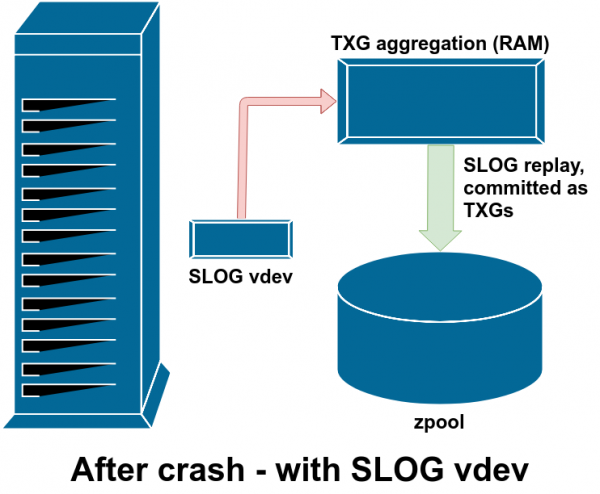
Pas një dështimi, të gjitha të dhënat e ndotura në ZIL riprodhohen - në këtë rast, ZIL ndodhet në SLOG, kështu që ato riprodhohen pikërisht prej aty.
Ka dy kategori kryesore operacionesh shkrimi - sinkronike (sync) dhe asinkronike (async). Për shumicën e ngarkesave të punës, pjesa më e madhe e operacioneve të shkrimit janë asinkronike - sistemi i skedarëve lejon agregimin e tyre dhe t'i japë ato në grup, duke reduktuar fragmentimin dhe duke rritur ndjeshëm kapacitetin.
Shkrimet sinkronike janë një gjë krejt tjetër. Kur një aplikacion kërkon një shkrim sinkronik, ai i thotë sistemit të skedarëve: "Duhet ta regjistrosh këtë në memorien që nuk humbet energjinë, Qiraja e serverit Windows VPS, dhe deri atëherë nuk mund të bëj asgjë tjetër". Prandaj, shkrimet sinkronike duhet të regjistrohen menjëherë në disk - dhe nëse kjo rrit fragmentimin ose zvogëlon kapacitetin, ashtu qoftë.
ZFS e trajton shkrimin sinkronik ndryshe nga sistemet e zakonshme të skedarëve - në vend që t'i derdhë ato menjëherë në ruajtjen e zakonshme, ZFS i regjistron ato në një zonë të veçantë të ruajtjes, e cila quhet Dita e Qëllimit ZFS - ZFS Intent Log, ose ZIL. Truku është që këto shkrime përveç qëndrojnë në memorie, duke u agreguar bashkë me kërkesat e zakonshme asinkronike për shkrim, për t'u derdhur më vonë në ruajtje si TXG të zakonshëm (grupet e transaksionit, Transaction Groups).
Në mënyrën normale të funksionimit, ZIL regjistrohet dhe kurrë më nuk lexohet. Kur pas disa çastesh shkrimet nga ZIL regjistrohen në ruajtjen kryesore në TXG të zakonshme nga memoria, ato shkëputen nga ZIL. E vetmja herë që diçka lexohesh nga ZIL është gjatë importit të grupit.
Nëse ndodh një dështim ZFS - dështim i sistemit operativ ose humbje energjie - kur ka të dhëna në ZIL, këto të dhëna do të lexohen gjatë importit të ardhshëm të grupit (p.sh., kur sistemi rikthehet pas një dështimi). Çdo gjë që ndodhet në ZIL do të lexohet, do të bashkohet në grupet TXG, do të regjistrohet në ruajtjen kryesore dhe pastaj do të shkëputet nga ZIL në procesin e importit.
Një nga klasat ndihmëse vdev quhet LOG ose SLOG, pajisja sekondare LOG. Ai ka një detyrë të vetme — të ofrojë një vdev të veçantë dhe, preferohet, shumë më të shpejtë, me një qëndrueshmëri shumë të lartë në shkrim, për të ruajtur ZIL, në vend që të ruajë ZIL në depozitën kryesore vdev. ZIL vetë sillet në të njëjtën mënyrë pavarësisht nga vendi i ruajtjes, por nëse vdev me LOG ka një performancë shumë të lartë të shkrimit, atëherë shkrimet sincronike do të ndodhin më shpejt.
Shtimi i vdev me LOG në rezervuar nuk do nuk mund të përmirësojë performancën e shkrimit asinkron — madje edhe nëse ju detyroni të ekzekutoni të gjitha shkrimet në ZIL me anë të zfs set sync=always, ato do të jenë gjithsesi të lidhura me depozitën kryesore në TXG në të njëjtën mënyrë dhe me të njëjtin ritëm, ashtu si pa ditar. Përmirësimi i vetëm direkt i performancës është koha e vonesës së shkrimit sinkron (pasi shpejtësia më e lartë e ditarit përshpejton ekzekutimin e operacioneve. sync).
Megjithatë, në një mjedis që tashmë kërkon një numër të madh shkrimesh sinkron, vdev LOG mund të përshpejtojë në mënyrë indirekte shkrimet asinkrone dhe leximet e pa-cache. Shkarkimi i shkrimeve ZIL në një vdev LOG të veçantë do të thotë më pak konkurrencë për IOPS në depozitën primare, çka ndihmon disi përmirësimin e performancës së të gjitha operacioneve të leximit dhe shkrimit.
Snapshotet
Mekanizmi i kopjimit në shkrim gjithashtu është një bazë e nevojshme për snapshotet atomike ZFS dhe replikimin inkremental asinkron. Në një sistem aktiv skedarësh ka një pemë treguesish që tregon të gjitha shkrimet me të dhënat aktuale — kur bëni një snapshot, thjesht bëni një kopje të kësaj peme treguesish.
Kur në një sistem aktiv të skedarëve rishkruhet një shkrim, ZFS së pari shkruan versionin e ri të bllokut në hapësirën e papërdorur. Pastaj ndan versionin e vjetër të bllokut nga sistemi i skedarëve aktual. Por nëse ndonjë snapshot i referohet bllokut të vjetër, ai mbetet gjithsesi i pandryshuar. Blloku i vjetër në fakt nuk do të rikuperohet si hapësirë e lirë derisa të gjitha snapshotet që i referohen këtij blloku të shkatërrohen!
Replikimi
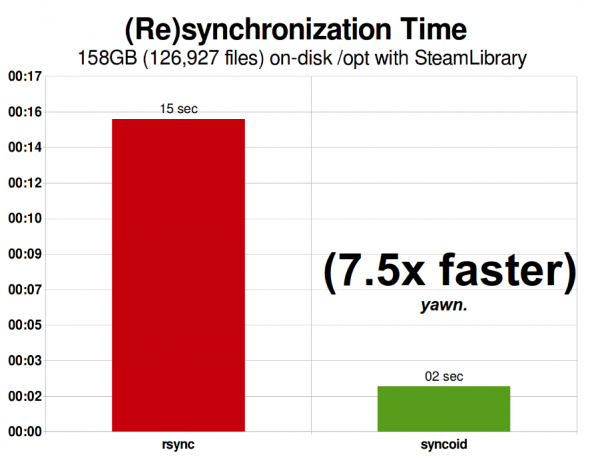
Biblioteka ime e Steam në vitin 2015 zinte 158 GiB dhe përfshinte 126,927 skedarë. Kjo është mjaft afër situatës optimale për rsync — replikimi i ZFS përmes rrjetit ishte "vetëm" 750% më i shpejtë.
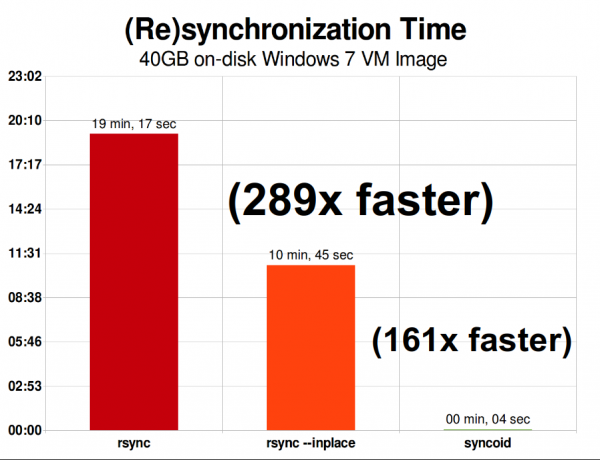
Në të njëjtin rrjet, replikimi i një skedari 40-gigabajtësh të imazhit të makinës virtuale Windows 7 është një histori krejt tjetër. Replikimi ZFS ndodh 289 herë më shpejt se rsync, ose 'thjesht' 161 herë më shpejt nëse jeni mjaft të njohur për të thirrur rsync me çelësin --inplace.
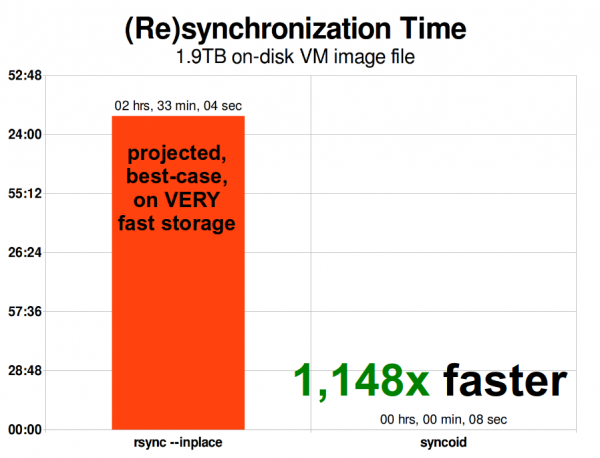
Kur imazhi i makinës virtuale shkallëzohet, problemet e rsync-it shkallëzohen gjithashtu me të. Këndi 1.9 TiB nuk është aq i madh për një imazh modern të makinës virtuale, por është mjaft i madh që replikimi ZFS të rezultojë 1148 herë më i shpejtë se rsync, madje edhe me argumentin rsync --inplace.
Sa herë që kuptoni se si funksionojnë snapshot-et, do të jetë e lehtë të kuptoni thelbin e replikimit. Pasi snapshot-i është thjesht një pemë treguesish për regjistrimet, kjo nënkupton se nëse bëjmë zfs send snapshot, ne dërgojmë këtë pemë dhe të gjitha regjistrimet e lidhura me të. Kur e kalojmë këtë zfs send në zfs receive në objektin e synimit, ai shkruan si përmbajtjen faktike të bllokut, ashtu edhe pemën e treguesve që referohen në blloqet, në grupin e të dhënave të synimit.
Gjërat bëhen edhe më interesante në të dytin zfs send. Tani kemi dy sisteme, secila prej të cilave përmban poolname/datasetname@1, ndërsa po merrni një snapshot të ri poolname/datasetname@2.Prandaj, në grupin burimor keni datasetname@1 dhe datasetname@2, ndërsa në grupin e synimit për momentin vetëm snapshot-i i parë. datasetname@1.
Duke qenë se kemi një snapshot të përbashkët midis burimit dhe qëllimit, ne mund të bëjmë datasetname@1inkrementale mbi të. Kur i themi sistemit zfs send zfs send -i poolname/datasetname@1 poolname/datasetname@2 , ai krahason dy pemë treguesish. Çdo tregues që ekziston vetëm në, referohet qartë në blloqe të reja - prandaj na nevojitet përmbajtja e këtyre blloqeve. @2Në sistemin e largët, procesi i inkrementaleve
është po aq i thjeshtë. Së pari, shkruajmë të gjitha regjistrimet e reja të përfshira në kanalin dërgo , e më pas shtojmë treguesit për këto blloqe. Vua, kemi dërgonë sistemin e ri! @2 Replikimi asinkron inkremental i ZFS është një përmirësim të madh krahasuar me metodat e mëparshme që nuk bëjnë përdorim të snapshot-eve, si rsync. Në të dy rastet, transferohen vetëm të dhënat e ndryshuara - por rsync duhet së pari
nga disku të gjitha të dhënat nga të dyja anët për të verifikuar shumën dhe për ta krahasuar atë. Ndryshe nga kjo, replikimi ZFS nuk lexon asgjë përveç pemëve të treguesve - dhe blloqeve të çdo lloji që nuk janë të paraqitura në snapshot-in e përbashkët. lexohet nga disk, të gjitha të dhënat nga të dyja anët, për të kontrolluar shumën dhe për ta krahasuar atë. Ndryshe nga kjo, replikimi ZFS nuk lexon asgjë, përveç pemëve të treguesve — dhe çdo blloku që nuk paraqitet në snapshots e përbashkëta.
Shtypja e integruar
Mekanizmi i kopjimit gjatë shkrimit gjithashtu thjeshton sistemin e shtypjes së integruar. Në sistemet tradicionale të skedarëve, shtypja është problematike - si versioni i vjetër ashtu edhe versioni i ri i të dhënave të modifikuara ndodhen në të njëjtin hapësirë.
Nëse shqyrtojmë një fragment të të dhënave në mes të skedarit, i cili fillon jetën e tij si një megabajt zero nga 0x00000000 e më pas - është shumë e lehtë ta shtypim këtë në një sektor në disk. Por çfarë do të ndodhë nëse ne zëvendësojmë këtë megabajt zerosh me një megabajt të dhënash që nuk mund të shtypen, si JPEG ose zhurmë pseudo-rastësore? Papritmas, ky megabajt të dhënash do të kërkojë jo një, por 256 sektorë me 4 KiB, ndërsa në këtë vend të diskut është rezervuar vetëm një sektor.
ZFS nuk ka një problem të tillë, pasi të dhënat e modifikuara gjithmonë shkruhen në hapësirë të pavendosur - blloku origjinal zë vetëm një sektor 4 KiB, ndërsa shenja e re do të marrë 256, por kjo nuk është problem - fragmenti i sapo modifikuar nga "mes" i skedarit do të shkruhej në hapësirë të pavendosur pavarësisht nëse ka ndryshuar ose jo, prandaj për ZFS kjo është një situatë krejt normale.
Shtypja e integruar ZFS është e çaktivizuar si parazgjedhje dhe sistemi ofron algoritme të lidhura - aktualisht përfshijnë LZ4, gzip (1-9), LZJB dhe ZLE.
- LZ4 — është një algoritëm i rrjedhshëm, duke ofruar shtypje dhe dekompresim jashtëzakonisht të shpejtë dhe përfitime në performancë për shumicën e rasteve të përdorimit - madje edhe në CPU relativisht të ngadalta.
- GZIP — një algoritëm i njohur, i dashur nga të gjithë përdoruesit e sistemeve Unix. Ai mund të realizohet me nivele shtypjeje 1-9, me rritjen e shkallës së shtypjes dhe përdorimit të CPU-te ndërkohë që i afrohet nivelit 9. Algoritmi është i përshtatshëm për të gjitha variantet e përdorimit të teksteve (ose të tjera që mund të kompresohen shumë), por përndryshe shpesh shkakton probleme me CPU - përdoreni me kujdes, veçanërisht në nivelet më të larta.
- LZJB — algoritmi origjinal në ZFS. Ai është i tejkaluar dhe nuk duhet të përdoret më, LZ4 e tejkalon atë në çdo aspekt.
- ZLE — kodimi i nivelit zero, Zero Level Encoding. Ai në përgjithësi nuk prek të dhënat normale, por kompreson sekuenca të mëdha zeros. E dobishme për grupe të dhënash plotësisht të padihet (p.sh., JPEG, MP4 ose formate të tjera që janë tashmë kompaktuar), pasi injoron të dhënat e pa kompresuara, por kompreson hapësirën e papërdorur në regjistrat përfundimtarë.
Ne rekomandojmë kompresimin LZ4 për pothuajse të gjitha rastet e përdorimit; ndëshkimi për performancën kur haset me të dhëna të pa kompresuara është shumë i vogël, dhe e ndjeshme performanca për të dhënat tipike është e rëndësishme. Kopjimi i imazhit të makinës virtuale për një instalim të ri të sistemit operativ Windows (sistem operativ i sapoinstaluar, pa të dhëna brenda akoma) me compression=lz4 ka kaluar 27% më shpejt se me compression=none, në .
ARC — zëvendësimi adaptiv i caches
ZFS është e vetmja sistem files moderne që dimë që përdor mekanizmin e vet të përmirësimit të leximin, dhe nuk mbështetet në caches të faqeve të sistemit operativ për të mbajtur kopje të blloqeve të lexuara rishtazi në memoria RAM.
Megjithëse cache-ja e vet nuk është pa problemet e saj — ZFS nuk mund të reagojë për kërkesat e reja për ndarje memories aq shpejt sa bërthama, kështu që një thirrje e re malloc() për ndarjen e memories mund të dështojë, nëse i nevojitet memoria RAM e zënë aktualisht nga ARC. Por ka arsye të forta për të përdorur cache-në e vet, të paktën tani.
Të gjitha sistemet operative moderne, përfshirë MacOS, Windows, Linux dhe BSD, përdorin algoritmin LRU (Më pak frekuent përdorur) për të zbatuar caches të faqeve. Ky është një algoritëm primitiv, i cili rrit bllokun e cache-t "lart në rend" pas çdo leximi dhe hedh blloqet "poshtë në rend" sipas nevojës, për të shtuar humbjet e reja të caches (blloqet që duhet të jenë lexuar nga disku, e jo nga cache) lart.
Zakonisht algoritmi funksionon mirë, por në sisteme me grupe të mëdha të dhënash, LRU lehtë të çojë në treshing — heqjen e blloqeve që nevojiten shpesh, për të liruar hapësirë për blloqet që kurrë më nuk do të lexohen nga cache.
— një algoritëm shumë më pak naiv, i cili mund të konsiderohet si një memorie 'e peshkuar'. Pas çdo leximi të bllokut të caches, ai bëhet pak 'më i rëndë' dhe bëhet më e vështirë të dështohet - dhe madje edhe pas dështimit, blloku ndiqet për një periudhë të caktuar kohe. Një bllok që është dëbuar, por pastaj duhet të lexohet përsëri në cache, gjithashtu do të bëhet 'më i rëndë'.
Si rezultat i gjithë këtyre është një cache me një raport shumë më të lartë hit (hit ratio) - raporti midis goditjeve në cache (leximi, që bëhet nga cache) dhe humbjeve (leximi nga disku). Kjo është një statistikë tepër e rëndësishme - jo vetëm që vetë hitet e cache shërbehen me rend të shpejtë, humbjet e caches gjithashtu mund të shërbehen më shpejt, pasi sa më shumë hitet në cache - aq më pak kërkesa paralel për disk dhe aq më pak vonesë për ato humbje të mbetura që duhet të shërbehen nga disku.
Përfundim
Pas studimit të semantikës themelore të ZFS - se si funksionon kopjimi në shkrim, si dhe marrëdhëniet midis grupeve të ruajtjes, pajisjeve virtuale, blloqeve, sectorëve dhe skedarëve - ne jemi gati të diskutojmë performancën reale me numra realë.
Në pjesën tjetër do të shqyrtojmë performancën faktike të grupeve me vdev të pasqyruar dhe RAIDz, njëri në krahasim me tjetrin, si dhe në krahasim me topologjitë tradicionale të RAID të bërthamës Linux, të cilat kemi eksploruar .
Fillimisht ne donim të shqyrtonim vetëm elementet bazë - vetë topologjitë ZFS - por pas e një do të jemi gati të flasim për konfigurimin dhe rregullimin më të avancuar të ZFS, duke përfshirë përdorimin e llojeve ndihmëse të vdev, si L2ARC, SLOG dhe Special Allocation.
Burimi: habr.com
