

Hyrje
 «Duhet të vraposh me të gjitha forcat vetëm për të qëndruar në vend,
në mënyrë që të arrish diku, duhet të vraposh të paktën dy herë më shpejt!»
(s) Aliça në Vendin e Çudirave
Disa kohë më parë, më kërkuan të mbaja një ligjëratë për analistët e kompanisë sonë mbi projektimin e modeleve të dhënash, sepse duke qëndruar për një kohë të gjatë në projekte (ndonjëherë për disa vite) ne humbasim nga vëmendja atë që ndodh përreth në botën e teknologjive IT. Në kompaninë tonë (është njësoj) në shumë projekte nuk përdoren bazat e të dhënave NoSQL (të paktën deri tani), prandaj në ligjëratën time u dedikova veçanërisht atyre në shembullin e HBase dhe përpiqesha të orientoj materialin për ata që nuk kanë punuar kurrë me to. Në veçanti, ilustrova disa veçori të projektimit të modelit të dhënave mbi një shembull që kam lexuar disa vite më parë . Duke shqyrtuar shembujt, krahasova disa mundësi zgjidhjeje për të njëjtën detyrë, për të sjellë më mirë idetë kryesore te dëgjuesit.
Së fundmi, «për shkak të mungesës së gjërave për të bërë», fillova të mendoj (fundjavat e gjata të majit në karantinë e nxisin këtë veçanërisht), sa do të përputhen konkluzionet teorike me praktiken? Në thelb, kështu lindi ideja e këtij artikulli. Një zhvillues që ka disa vite përvojë me NoSQL, ndoshta nuk do të nxjerrë diçka të re nga ajo (dhe prandaj mund të kalojë menjëherë disa etapa të artikullit). Por për analistët, që ende nuk kanë punuar ngushtë me NoSQL, mendoj se do të jetë e dobishme për të marrë konceptet bazë mbi veçoritë e projektimit të modeleve të dhënash për HBase.
Analiza e shembullit
Sipas mendimit tim, para se të filloni të përdorni bazat e të dhënave NoSQL, është e rëndësishme të mendoni mirë dhe të peshojnë "për" dhe "kundër". Shpesh, problemin mund ta zgjidhni edhe me sistemet tradicionale të menaxhimit të të dhënave relacionale. Prandaj, është më mirë të shmangni përdorimin e NoSQL pa arsye të forta. Nëse gjithsesi vendosni të përdorni një bazë të dhënash NoSQL, duhet të keni parasysh se qasjet në dizajn janë paksa të ndryshme. Sidomos, disa prej tyre mund të duken të panjohura për ata që deri tani kanë punuar vetëm me sistemet relacionale të menaxhimit të të dhënave (sipas vëzhgimeve të mia). Në "botën relacionale", zakonisht fillojmë me modelimin e fushës së aplikimit dhe më pas, kur nevojitet, realizojmë denormalizimin e modelit. Ndërsa në NoSQL ne duhet menjëherë të marrim parasysh skenarët e parashikuar të punës me të dhënat dhe fillimisht të denormalizojmë të dhënat. Për më tepër, ka disa dallime të tjera, për të cilat do të shkruhet më poshtë.
Le të shqyrtojmë detyrën e mëposhtme "sintetike", me të cilën do të punojmë më tej:
Duhet të dizajnojmë një strukturë për ruajtjen e listës së miqve të përdoruesve të një rrjeti social abstrakt. Për thjeshtësim, do të supozojmë se të gjitha lidhjet janë të drejtuara (si në Instagram, dhe jo si në Linkedin). Strukturë duhet të lejojë që të:
- Përgjigjemi pyetjes, a e lexon përdoruesi A përdoruesin B (shkema e leximit)
- Të lejojmë shtimin/zhbllokimin e lidhjeve në rastin e ndjekjes/ndaljes së përdoruesit A nga përdoruesi B (shkema e ndryshimit të të dhënave)
Natyrisht, ka shumë mundësi për zgjidhjen e problemit. Në një bazë të dhënash relacionale normale, ne do të bënim një tabelë lidhjesh (ndoshta të tipizuar, nëse, për shembull, ka nevojë për të ruajtur grupin e përdoruesve: familja, puna, etj., në të cilin hyn ky "miku"), dhe për të optimizuar shpejtësinë e aksesit do të shtonim indekse/particionim. Për më tepër, tabela përfundimtare do të dukej ndoshta kështu:
user_id
friend_id
Vasja
Petja
Vasja
Olja
këtu dhe më pas për sqarje dhe kuptim më të mirë në vend të ID do të përcaktoj emrat
Në rastin e HBase e dimë se:
- kërkimi efektiv, i cili nuk çon në një skanim të plotë të tabelës, është i mundshëm përshtatshëm vetëm sipas çelësit
- Prandaj, të shkruash SQL kërkesa të njohura për shumë njerëz me baza të tilla është një ide e keqe; teknikisht, sigurisht, mund të dërgosh një kërkesë SQL me Join dhe logjikë tjetër në HBase nga Impala, por sa e efektshme do të jetë kjo…
Prandaj, ID e përdoruesit ne jemi të detyruar ta përdorim si çelës. Një mendim i parë për temën "ku dhe si të ruajmë ID e miqve?" mund të jetë ideja e ruajtjes së tyre në kolona. Ky variant më i dukshëm dhe "naiv" do të dukej kështu (ta quajmë) Varianti 1 (default), për t'u referuar më pas):
RowKey
Kolonat
Vasja
1: Petja
2: Olya
3: Dasha
Petja
1: Masha
2: Vasya
Këtu, çdo rresht i përkon një përdoruesi të vet në rrjet. Kolonat kanë emra: 1, 2, ... - sipas numrit të miqve, dhe në kolonat ruhen ID e miqve. Është e rëndësishme të theksohet se çdo rresht do të ketë një numër të ndryshëm kolonash. Në shembullin në figurën më sipër, një rresht ka tre kolona (1, 2 dhe 3), ndërsa i dyti ka vetëm dy (1 dhe 2) - këtu ne kemi shfrytëzuar dy vetitë e HBase, të cilat nuk i ka databaza relacional:
- mundësinë për të ndryshuar përbërjen e kolonave dinamikisht (shto mikun -> shto kolonën, hiq mikun -> hiq kolonën)
- për rreshta të ndryshëm, përbërja e kolonave mund të jetë e ndryshme
Le të verifikojmë strukturën tonë në përputhje me kërkesat e detyrës:
- Leximi i të dhënave: për të kuptuar nëse Vasya është i regjistruar tek Olya, na nevojitet të lexojmë të gjithë rreshtin me çelësin RowKey = "Vasya" dhe të kalojmë përmes vlerave të kolonave, derisa të "takojmë" Olya në to. Ose të kalojmë përmes të gjitha vlerave të kolonave, "të mos takojmë" Olya dhe të kthejmë përgjigjen False;
- Ndryshimi i të dhënave: shtimi i mikut: për një detyrë të tillë na nevojitet gjithashtu të lexojmë të gjithë rreshtin me çelësin RowKey = "Vasya", për të llogaritur numrin total të miqve të tij. Ky numër total miqsh është i nevojshëm për të përcaktuar numrin e kolonës ku duhet të shkruhet ID i mikut të ri.
- Ndryshimi i të dhënave: heqja e mikut:
- Duhet të lexojmë të gjithë rreshtin me çelësin RowKey = "Vasya" dhe të kalojmë përmes kolonave për të gjetur atë, ku është regjistruar miku që po hiqet;
- Më pas, pas heqjes së mikut, ne duhet të "zhvendosim" të dhënat e gjitha një kolonë, në mënyrë që të mos marrim "ndarje" në numërimin e tyre.
Tani le të vlerësojmë se sa efikas do të jenë algoritmet që na nevojiten për të zbatuar në anën e "aplikacionit të kushteve", duke përdorur Le të shohim madhësinë e rrjetit tonë hipotetik shoqëror si n. Atëherë numri maksimal i miqve për një përdorues mund të jetë (n-1). Këtë (-1) ne mund ta injorojmë për qëllimet tona, pasi në kuadër të përdorimit të simbolikës O, ajo është e parëndësishme.
- Leximi i të dhënave: nevojitet të lexojmë të gjithë rreshtin dhe të shqyrtojmë në kufijtë të gjitha kolonat e tij. Kështu, vlerësimi i sipërm i kostove do të jetë afërsisht O(n)
- Ndryshimi i të dhënave: shtimi i mikut: për të përcaktuar numrin e miqve, ne duhet të shqyrtojmë të gjitha kolonat e rreshtit, pas së cilës do të insertojmë një kolonë të re => O(n)
- Ndryshimi i të dhënave: heqja e mikut:
- Po ashtu si në rastin e shtimit – kërkohet që në kufijtë të shqyrtojmë të gjitha kolonat => O(n)
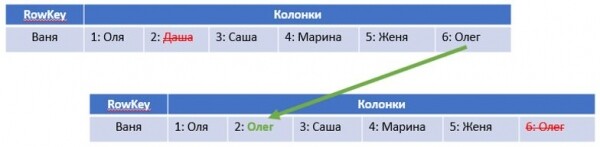
- Pas fshirjes së kolonave, na duhen "skaj" ato. Nëse e realizojmë këtë "drejt" do të nevojiteshin deri në (n-1) operacione. Por këtu dhe më tej në pjesën praktike do të aplikojmë një qasje tjetër, e cila do të realizojë "pseudoskaj" përmes një numri të fiksuar operacionesh – do të thotë se do të shpenzohet një kohë konstante pavarësisht n. Kjo kohë konstante (nëse jemi të saktë, O(2)) në krahasim me O(n) mund të injorohet. Qasja ilustrohet në figurën më poshtë: ne thjesht kopjojmë të dhënat nga kolonat "e fundit" në atë nga e cila duam të fshijmë të dhënat, pas së cilës fshijmë kolonën më të fundit:

Së fundmi, në të gjitha skenaret ne kemi marrë kompleksitetin asimptotik të llogaritjes O(n).
Mbase tashmë e keni vënë re se ne kemi pothuajse gjithmonë nevojë të lexojmë të gjithë rreshtin nga baza, veçanërisht në dy nga tre rastet vetëm për të shqyrtuar të gjitha kolonat dhe për të llogaritur numrin total të miqve. Prandaj, si një përpjekje optimizimi mund të shtojmë një kolonë "count", ku ruhet numri total i miqve për secilin përdorues në rrjet. Në këtë rast, ne mund të mos lexojmë të gjithë rreshtin për të llogaritur numrin e përgjithshëm të miqve, por të lexojmë vetëm një kolonë "count". E rëndësishme është të mos harrojmë të përditësojmë "count" gjatë manipulimeve me të dhënat. Kështu, arrijmë një përmirësim Opsioni 2 (count):
RowKey
Kolonat
Vasja
1: Petja
2: Olya
3: Dasha
count: 3
Petja
1: Masha
2: Vasya
count: 2
Në krahasim me opsionin e parë:
- Leximi i të dhënave: për të marrë përgjigjen për pyetjen "A e lexon Vasja Olën?" nuk ka ndryshuar asgjë => O(n)
- Ndryshimi i të dhënave: shtimi i mikut: E kemi thjeshtuar shtimin e një miku të ri, pasi tani nuk na nevojitet të lexojmë të toda rreshtin dhe të kalojmë kolonat e tij, por mund të marrim vetëm vlerën e kolonës «count» dhe kështu të përcaktojmë menjëherë numrin e kolonës për të shtuar mikun e ri. Kjo çon në uljen e kompleksitetit të llogaritjes në O(1)
- Ndryshimi i të dhënave: heqja e mikut: Gjatë fshirjes së një miku, gjithashtu mund ta përdorim këtë kolonek, për të ulur numrin e operacioneve të hyrjes dhe daljeve kur «shkarkojmë» të dhënat një hap majtas. Por nevoja për të kaluar nëpër kolonat për të gjetur atë që duhet fshirë mbetet, prandaj => O(n)
- Nga ana tjetër, tani gjatë përditësimit të të dhënave, na duhet të përditësojmë çdo herë edhe kolonën «count», por për këtë nevojitet një kohë konstante, të cilën në kuadër të simbolikës O mund ta injorojmë
Në përgjithësi, opsioni 2 duket pak më optimal, por kjo është më shumë «evolucioni në vend të revolucionit». Për të realizuar një «revolucion» na nevojitet Opsioni 3 (col).
Ta kthejmë gjithçka «përmbys»: të caktojmë emrin e kolonës identifikues të përdoruesit! Çfarë do të regjistrohet në vetë kolonën – për ne nuk ka rëndësi, le të jetë numri 1 (në të vërtetë, nga të dhënat e dobishme aty mund të ruhet, për shembull, grupi «familje/mik/etj.». Ky qasje mund të befasojë një «përfitues» të papërgatitur, i cili deri tani nuk ka pasur përvojë pune me bazat NoSQL, por pikërisht kjo i lejon të shfrytëzojë potencialin e HBase në këtë detyrë më efikase:
RowKey
Kolonat
Vasja
Petja: 1
Olja: 1
Dasha: 1
Petja
Masha: 1
Vasia: 1
Këtu ne marrim menjëherë disa avantazhe. Për t'i kuptuar ato, le të analizojmë strukturën e re dhe të vlerësojmë kompleksitetin e llogaritjes:
- Leximi i të dhënave: për të përgjigjur pyetjes, nëse Vasia është regjistruar me Oljën, mjafton të lexojmë një kolonë «Olja»: nëse ajo është atje, përgjigja është True, nëse jo – False => O(1)
- Ndryshimi i të dhënave: shtimi i mikut: Shtimi i një miku: mjafton të shtojmë një kolonë të re «ID miku» => O(1)
- Ndryshimi i të dhënave: heqja e mikut: mjafton të fshijmë kolonën «ID miku» => O(1)
Siç e shohim, një përparësi e madhe e kësaj modeli të ruajtjes është se në të gjitha skenarët e nevojshëm operojmë vetëm me një kolonë, duke shmangur leximin e të dhënave nga e gjithë rreshti dhe sidomos kalimin në të gjitha kolonat e këtij rreshti. Këtu mund të ndalojmë, por…
Mund të shqetësohemi dhe të shkojmë edhe më tej në rrugën e optimizimit të performancës dhe reduktimit të operacioneve të hyrjes-dalinjes kur i drejtohemi bazës. Çfarë ndodh nëse ruajmë informacionin e plotë të lidhjes drejtpërdrejt në çelësin e rreshtit? Domethënë, ta bëjmë çelësin të përbërë nga userID.friendID? Në këtë rast, madje nuk na nevojitet të lexojmë kolonat e rreshtit.Opsioni 4 (rreshti)):
RowKey
Kolonat
Vasja.Petja
Petja: 1
Vasja.Olja
Olja: 1
Vasja.Dasha
Dasha: 1
Petja.Masha
Masha: 1
Petja.Vasja
Vasia: 1
Është e qartë se vlerësimi i të gjithë skenarëve të manipulimit të të dhënave në këtë strukturë, ashtu si në opsionin e mëparshëm, do të jetë O(1). Ndryshimi me opsionin 3 do të jetë thjesht në efikasitetin e operacioneve të hyrjes-dalinjes në DB.
Dhe, përfundimisht, një "kalim i fundit". Është e lehtë të vëresh se në opsionin 4 çelësi i rreshtit do të ketë një gjatësi të ndryshueshme, që ndoshta mund të ndikojë në performancë (këtu kujtojmë se HBase ruan të dhënat si një grup bajtesh dhe rreshtat në tabela janë të renditur sipas çelësit). Plus, kemi një ndarës, i cili në disa skenarë mund të kërkojë trajtim. Për të eliminuar këtë ndikim, mund të përdorim hash-e nga userID dhe friendID, dhe pasi të dy hash-et do të kenë gjatësi fikse, mund thjesht t'i konkatenujmë ato, pa ndarës. Atëherë të dhënat në tavolinë do të duken kështu (Opsioni 5 (hash)):
RowKey
Kolonat
dc084ef00e94aef49be885f9b01f51c01918fa783851db0dc1f72f83d33a5994
Petja: 1
dc084ef00e94aef49be885f9b01f51c0f06b7714b5ba522c3cf51328b66fe28a
Olja: 1
dc084ef00e94aef49be885f9b01f51c00d2c2e5d69df6b238754f650d56c896a
Dasha: 1
1918fa783851db0dc1f72f83d33a59949ee3309645bd2c0775899fca14f311e1
Masha: 1
1918fa783851db0dc1f72f83d33a5994dc084ef00e94aef49be885f9b01f51c0
Vasia: 1
Është e qartë se kompleksiteti algoritmik i punës me një strukturë të tillë për skenarët që po shqyrtojmë do të jetë i njëjtë me opsionin 4 – dmth O(1).
Pra, do ta përmbledhim të gjithë vlerësimin tonë të kompleksitetit të llogaritjeve në një tabelë:
Shtimi i një miku
Kontrollimi i mikut
Fshirja e mikut
Varianti 1 (default)
O(n)
O(n)
O(n)
Opsioni 2 (count)
O(1)
O(n)
O(n)
Opsioni 3 (kolona)
O(1)
O(1)
O(1)
Opsioni 4 (rreshti)
O(1)
O(1)
O(1)
Opsioni 5 (hash)
O(1)
O(1)
O(1)
Siç duket, opsionet 3-5 duken më të preferuara dhe teorikisht sigurojnë përmbushjen e të gjitha skenarëve të nevojshme për manipulimin e të dhënave në një kohë konstante. Në kushtet e detyrës tonë nuk ka kërkesa të qarta për të marrë një listë të të gjitha miqve të përdoruesit, por në aktivitetin tonë të projektit, si analistë të mirë, do të ishte e mençur të "parashikojmë" se një detyrë e tillë mund të lindë dhe ta "përgatitim" vetveten. Prandaj, preferencat e mia janë për opsionin 3. Por është krejtësisht e mundur që në një projekt të vërtetë kjo kërkesë të jetë zgjidhur me mjete të tjera, prandaj pa një vizion të plotë të detyrës, nuk duhet të nxjerrim përfundime të përfundshme.
Përgatitja e eksperimentit
Dëshirojmë t'i verifikojmë këto mendime teorike në praktikë – kjo ishte qëllimi që lindi gjatë fundjavës së gjatë. Për këtë, është e nevojshme të vlerësojmë shpejtësinë e punës së "aplikacionit tonë të kushtuar" në të gjitha skenarët e përshkruar për përdorimin e databazës, si dhe rritjen e këtij koha me rritjen e madhësisë së rrjetit social (n). Parametri i synuar që na intereson dhe që do të masim gjatë eksperimentit, është koha e shpenzuar nga "aplikacioni i kushtuar" për të kryer një "operacion biznesi". Me "operacion biznesi" kuptojmë një nga sa vijon:
- Shtimi i një miku të ri
- Kontrollimi i shtyrjes nëse përdoruesi A është mik i përdoruesit B
- Fshirja e një miku
Prandaj, duke pasur parasysh kërkesat e shtruara në fillim, skenari i kontrollit shfaqet si vijon:
- Shkruaj të dhënat. Të gjenerohet rastësisht një rrjet fillestar me madhësinë n. Për një afërsi më të madhe me "botën reale", numri i miqve të çdo përdoruesi është gjithashtu një vlerë rastësore. Të masim kohën gjatë së cilës "aplikacioni ynë i kushtuar" do të shkrijë të gjitha të dhënat e gjeneruara në HBase. Më pas, të ndajmë kohën e marrë me numrin total të miqve të shtuar – ashtu do të marrim kohën mesatare për një "operacion biznesi".
- Leximi i të dhënave. Për çdo përdorues, përgatitni një listë "identitetesh" për të cilat duhet të kontrolloni nëse përdoruesi është ndjekës i tyre apo jo. Gjatësia e listës është afërsisht sa numri i miqve të përdoruesit, ku për gjysmën e miqve të kontrolluar, përgjigja duhet të jetë "Po", ndërsa për gjysmën tjetër – "Jo". Kontrolli bëhet në një renditje të tillë që përgjigjet "Po" dhe "Jo" të alternohen (dmth. në çdo rast të dytë na duhet të kontrollojmë të gjitha kolonat e rreshtit për variantet 1 dhe 2). Koha e përgjithshme e kontrollit më pas ndahet me numrin e miqve të kontrolluar për të marrë kohën mesatare për kontrollin e një subjekti.
- Fshirja e të dhënave. Fshihni të gjithë miqtë e përdoruesit. Renditja e fshirjes është rastësore (dmth. "përzierim" i listës fillestare që është përdorur për regjistrimin e të dhënave). Koha e përgjithshme e kontrollit më pas ndahet me numrin e miqve të fshirë për të marrë kohën mesatare për një kontroll.
Skenarët duhet të kalohen për çdo një nga 5 variantet e modeleve të të dhënave dhe për madhësi të ndryshme të rrjetit social, për të parë se si ndryshon koha me rritjen e tij. Brenda një n lidhjeje në rrjet dhe lista e përdoruesve për kontroll duhet të jetë, natyrisht, e njëjtë për të gjithë 5 variantet.
Për një kuptim më të mirë, më poshtë po sjell një shembull të të dhënave të gjeneruara për n= 5. "Generatori" i shkruar jep si rezultat tre fjalorë ID-sh:
- i pari – për futjen
- i dyti – për kontrollin
- i tretë – për fshirjen
{0: [1], 1: [4, 5, 3, 2, 1], 2: [1, 2], 3: [2, 4, 1, 5, 3], 4: [2, 1]} # gjithsej 15 miq

{0: [1, 10800], 1: [5, 10800, 2, 10801, 4, 10802], 2: [1, 10800], 3: [3, 10800, 1, 10801, 5, 10802], 4: [2, 10800]} # gjithsej 18 subjekte të kontrolluara

{0: [1], 1: [1, 3, 2, 5, 4], 2: [1, 2], 3: [4, 1, 2, 3, 5], 4: [1, 2]} # gjithsej 15 miq
Siç mund të vëreni, të gjitha ID, të mëdha se 10 000 në fjalorin për kontroll, janë ato që me siguri do të japin përgjigje False. Futja, kontrolli dhe fshirja e "miqve" bëhen pikërisht në rendin e specifikuar në fjalor.
Eksperimenti u zhvillua në një laptop me sistemin Windows 10, ku në një konteiner Docker ishte e vendosur një bazë HBase, ndërsa në konteinerin tjetër – Python me Jupyter Notebook. Docker-it i ishin dhënë 2 bërthama CPU dhe 2 GB përmemorie. E gjithë logjika, si simuluar e funksionit të "aplikacionit të mundshëm", ashtu edhe "mbështetje" për gjenerimin e të dhënave testuese dhe regjistrimin e kohës ishin shkruar në Python. Për punë me HBase u përdor biblioteka , për llogaritjen e hash-ëve (MD5) për variantin 5 — hashlib
Duke marrë parasysh fuqinë computing të laptopit të caktuar, përvojë eksperimentale u zgjodh të fillojë për n = 10, 30, …. 170 – kur koha totale e funksionimit të ciklit të plotë të testimit (të gjitha skenarët për të gjitha variantet për të gjithë n) ishte akoma më shumë ose më pak e arsyeshme dhe përfshihej brenda kohës një çaji (në mesatare 15 minuta).
Këtu është e nevojshme të bëhet një shënim, se në këtë eksperiment ne vlerësojmë kryesisht jo shifrat absolute të performancës. Edhe krahasimi relativ i dy varianteve të ndryshme mund të mos jetë plotësisht korrekt. Aktualisht, na intereson natyra e ndryshimit të kohës në varësi të n, pasi duke marrë parasysh konfigurimin e mësipërm të "testit të qendrës" është shumë e vështirë të merret një vlerësim kohor, "i pastruar" nga ndikimet rastësore dhe faktorë të tjerë (dhe asnjëherë nuk është vendosur një qëllim të tillë).
Rezultati i eksperimentit
Testi i parë – si ndryshon koha e kaluar për mbushjen e listës së miqve. Rezultati – në grafikën më poshtë.
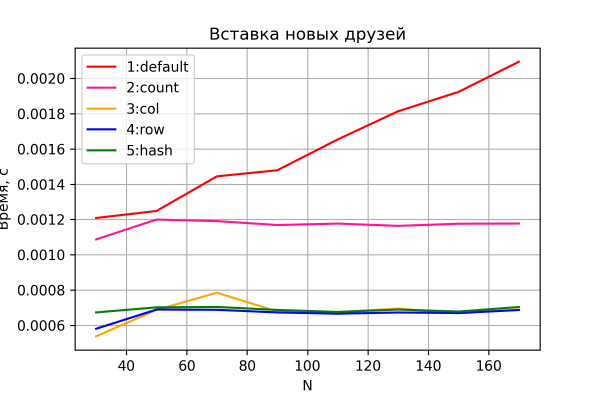
Variantet 3-5 pritet të tregojnë praktikisht një kohë konstante të "veprës afariste", e cila nuk varet nga rritja e madhësisë së rrjetit dhe diferenca e pamundshme në performancë.
Varianti 2 gjithashtu tregon një performancë konstante, por pak më të dobët, dhe në mënyrë të përafërt dyfish në krahasim me variantet 3-5. Dhe kjo nuk mund të mos gëzojë, pasi përputhet me teorinë - në këtë variant numri i operacioneve të hyrjes-daljes në/nga HBase është pikërisht dyfish më i madh. Kjo mund të shërbejë si një dëshmi indirekte se qendra jonë testuese në parim siguron një saktësi të mirë.
Varianti 1 gjithashtu është siç pritej më i ngadalshëm dhe tregon një rritje lineare të kohës së kaluar për shtimin e një miku në varësi të madhësisë së rrjetit.
Tani le të shikojmë rezultatet e testit të dytë.
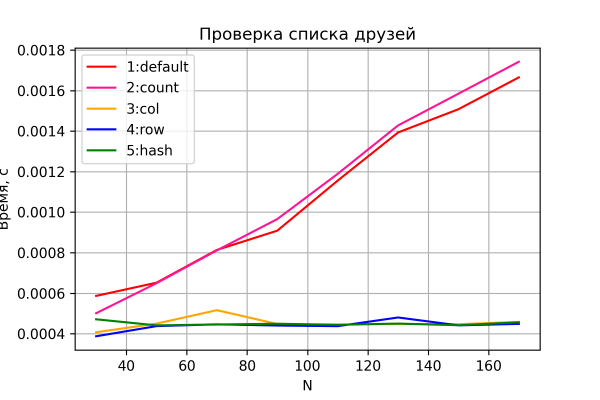
Opsionet 3-5 përsëri veprojnë siç pritej – kohë konstante, e cila nuk varet nga madhësia e rrjetit. Opsionet 1 dhe 2 tregojnë një rritje lineare të kohës me rritjen e madhësisë së rrjetit dhe një performancë të ngjashme. Në veçanti, opsioni 2 rezulton pak më i ngadalshëm – duket se për shkak të nevojës për të lexuar dhe trajtuar një kolonë shtesë "count", e cila bëhet më e dukshme me rritjen e n. Megjithatë, do të përmbahem nga çdo përfundim, pasi saktësia e këtij krahasimi është relativisht e ulët. Për më tepër, këto raporte (cilat opsione, 1 apo 2, janë më të shpejta) ndryshonin nga një ekzekutim në tjetrin (ndërsa ruanin karakterin e varësisë dhe "shkonin krahas")
Dhe grafiku i fundit – rezultati i testit të fshirjes.
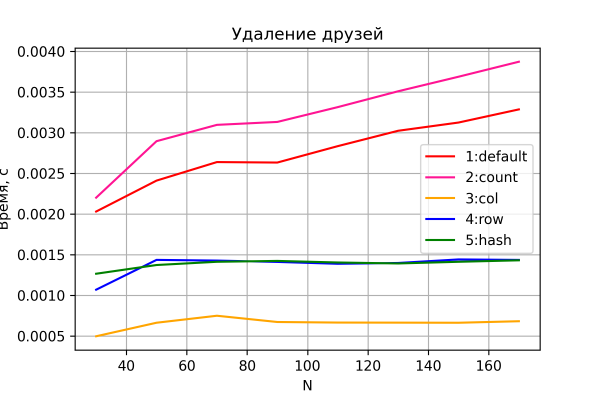
Këtu përsëri pa surpriza. Opsionet 3-5 realizojnë fshirjen në kohë konstante.
Dhe, çka është interesante, opsionet 4 dhe 5, ndryshe nga skenarët e mëparshëm, tregojnë një performancë disi më të ulët se opsioni 3. Dukshëm, operacioni i fshirjes së një rreshti është më i shtrenjtë se operacioni i fshirjes së një kolone, që në përgjithësi është logjike.
Opsionet 1 dhe 2, siç pritej, tregojnë një rritje lineare të kohës. Në këtë rast, opsioni 2 vazhdimisht është më i ngadaltë se opsioni 1 – për shkak të operacionit shtesë të hyrjes dhe daljes për "mirëmbajtjen" e kolonës count.
Përfundimet e përgjithshme të eksperimentit:
- Opsionet 3-5 demonstrojnë një efikasitet më të lartë, pasi ato shfrytëzojnë avantazhet e HBase; ndërsa performanca e tyre ndryshon njëra me tjetrën me një konstant dhe nuk varet nga madhësia e rrjetit.
- Diferenca midis opsioneve 4 dhe 5 nuk është regjistruar. Por kjo nuk do të thotë se opsioni 5 nuk duhet përdorur. Ka shumë mundësi që skenari i përdorur në eksperiment, duke marrë parasysh TTX e vendit të provës, nuk e mundësoi të zbulohej.
- Natyra e rritjes së kohës së nevojshme për të realizuar "operacionet biznesore" me të dhëna, në përgjithësi konfirmoi përfundimet teorike të mëparshme për të gjitha opsionet.
Epilogu
Eksperimet e bëra nuk duhet të merren si e vërtetë absolute. Ekzistojnë shumë faktorë që nuk janë marrë parasysh dhe që kanë sjellë disa devijime në rezultatet (veçanërisht këto fluktuacione duken qartë në grafikë kur dimensioni i rrjetit është i vogël). Për shembull, shpejtësia e Thrift-it, i cili përdoret nga Happybase, volume dhe mënyra e zbatimit të logjikës që kam shkruar në Python (nuk pretendoj se kodi është shkruar në mënyrë optimale dhe që përdor maksimumin e mundësive të të gjithë komponenteve), mundësisht karakteristikat e caching-ut të HBase, aktiviteti në sfond i Windows 10 në laptopin tim etj. Në përgjithësi, mund të mendohet se të gjitha përllogaritjet teorike e kanë dëshmuar vlerën e tyre eksperimentale. Ose të paktën nuk ka qenë e mundur të hedhim poshtë këto përllogaritje me një goditje të tillë të drejtpërdrejtë.
Në përfundim – rekomandime për të gjithë ata që sapo po fillojnë të projektojnë modele të dhënash në HBase: abstrahohuni nga përvoja e mëparshme me bazat e të dhënave relacionale dhe mbani mend "shqiponjat":
- Kur projektojmë, fillojmë nga detyra dhe modelet e manipulimit me të dhënat, dhe jo nga modeli i fushës së subjektit.
- Qasje efikase (pa skanim të plotë të tabelës) - vetëm përmes çelësit.
- Denormalizimi.
- Rreshta të ndryshëm mund të përmbajnë kolona të ndryshme.
- Përbërje dinamike e koloneve.
Burimi: habr.com
