

Në Linux ka shumë mjete për debugin e kernelit dhe aplikacioneve. Shumica prej tyre kanë një ndikim negativ në performancën e aplikacioneve dhe nuk mund të përdoren në prodhim.
Disa para më parë u zhvillua një mjet tjetër Tani ekzistojnë shumë utilitare aplikative që përdorin eBPF, dhe në këtë artikull do të shqyrtojmë se si të shkruajmë utilitarin tonë për profilimin duke u bazuar në bibliotekën
PythonBCC Ceph Is Slow
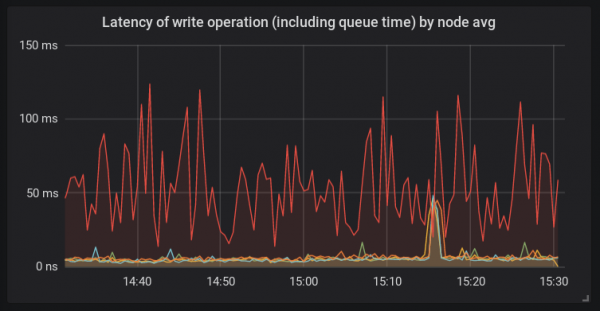
Në klastern Ceph u shtua një host i ri. Pas migrimit të një pjese të të dhënave në të, vërejtëm se shpejtësia e përpunimit të kërkesave për shkrim ishte shumë më e ulët se në serverë të tjerë.
Ndryshe nga platformat e tjera, në këtë host është përdorur bcache dhe një kernel i ri linux 4.15. Host i tillë është përdorur këtu për herë të parë. Dhe atëherë ishte e qartë që shkaku i problemit teorikisht mund të ishte çfarëdo.
Investigating the Host
Të fillojmë duke parë se çfarë ndodh brenda procesit ceph-osd. Për këtë do të përdorim
flamescope dhe Imazhi na tregon se funksioni ):
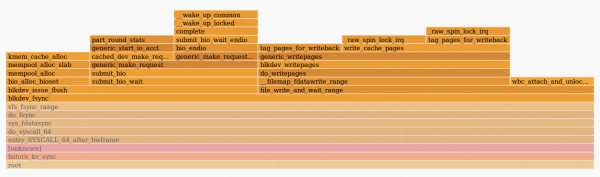
ka shpenzuar shumë kohë gjatë dërgimit të kërkesës në funksionin fdatasync() generic_make_request() . Pra, mendohet se shkaku i problemeve ndodhet jashtë vetë demonit osd. Kjo mund të jetë ose kernel, ose disqet. Dalja e iostat tregoi një vonesë të lartë në përpunimin e kërkesave nga disqet bcache.Gjatë kontrollit të hostit, zbuluam se demoni systemd-udevd po konsumonte një sasi të madhe kohe CPU — rreth 20% në disa bërthama. Ky është një sjellje e çuditshme, kështu që duhet të zbulojmë shkakun e saj. Duke qenë se Systemd-udevd punon me uevent'ë, vendosëm të shikojmë ata përmes
udevadm monitor . Doli se po krijoheshin një sasi e madhe e ngjarjeve të ndryshimit për secilën pajisje blloku në sistem. Kjo është mjaft e pazakontë, prandaj do të duhet të shikojmë se çfarë gjeneron të gjitha këto ngjarje.Using the BCC Toolkit
Siç e kemi zbuluar tashmë, kernel (dhe demoni ceph në thirrjen e sistemit) po shpenzon shumë kohë në
. Le të përpiqemi të matim shpejtësinë e funksionit. Në . Pra, mendohet se shkaku i problemeve ndodhet jashtë vetë demonit osd. Kjo mund të jetë ose kernel, ose disqet. Dalja e iostat tregoi një vonesë të lartë në përpunimin e kërkesave nga disqet bcache.BCC funclatency funclatencyDo të ndjekim demonin sipas PID-it të tij me një interval prej 1 sekonde midis daljeve të informacionit dhe do të tregojmë rezultatin në milisekonda.
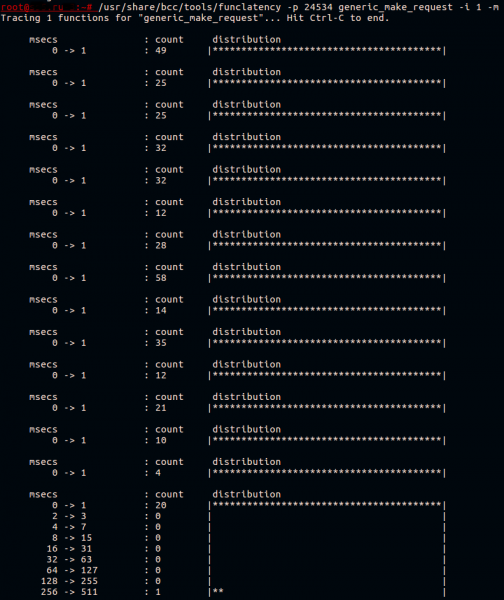
Zakonisht, kjo funksionon shpejt. Gjithçka që bën është të kalojë kërkesën në radhën e shoferëve të pajisjeve.
Bcache është një sistem i komplikuar që përbëhet në të vërtetë nga tre disqe:
- disku mbështetës (disku që mund të ruhet në cache), në këtë rast është një HDD i ngadalshëm;
- disku që ruan në cache, këtu është një ndarje NVMe e pajisjes;
- dispositivo virtual bcache, me të cilin punon aplikacioni.
E dimë që kalimi i kërkesës e ngadalëson, por për cilin nga këto pajisje? Do t’i japim një shpjegim më vonë.
Aktualisht, e dimë se uevent-et, me siguri, shkaktojnë probleme. Të gjejmë se çfarë e shkakton gjenerimin e tyre nuk është aq e thjeshtë. Supozojmë se është ndonjë software që ndizet periodikisht. Do të shikojmë se çfarë softi ndizet në sistem me anë të skriptit execsnoop nga i njëjti . Do ta aktivizojmë dhe do ta drejtojmë daljen në një skedar.
Për shembull kështu:
/usr/share/bcc/tools/execsnoop | tee ./execdump
Nuk do të japim këtu daljen e plotë të execsnoop, por një rresht që na interesonte dukej kështu:
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/] '{print $2}' | sed 's\/^ ([0-9]*) C.*\/1\/'
Kolona e tretë është PPID (PID i prindit) të procesit. Procesi me PID 5802 ishte një nga thread-et e sistemit tonë të monitorimit. Gjatë verifikimit të konfiguracionit të sistemit të monitorimit, u gjetën parametrat e vendosur gabimisht. Temperatura e adaptorit HBA merrej çdo 30 sekonda, që është shumë më shpesh se sa është e nevojshme. Pas ndryshimit të intervalit të kontrollit në një të gjatë, ne zbuluam se vonesa në përpunimin e kërkesave në këtë host nuk u dallua më nga hostet e tjera.
Por ende mbetet e paqartë se pse pajisja bcache po ngadalësonte kaq shumë. Ne përgatitëm një platformë testi me konfigurim identik dhe provuam të riprodhonim problemin duke aktivizuar fio në bcache, duke aktivizuar periodikisht udevadm trigger për të gjeneruar uevents.
Shkrimi i Mjeteve të Bazuar në BCC
Do të përpiqemi të shkruajmë një utilitet të thjeshtë për ndjekjen dhe shfaqjen e thirrjeve më të ngadalta . Pra, mendohet se shkaku i problemeve ndodhet jashtë vetë demonit osd. Kjo mund të jetë ose kernel, ose disqet. Dalja e iostat tregoi një vonesë të lartë në përpunimin e kërkesave nga disqet bcache.. Na intereson gjithashtu emri i diskut për të cilin u thirr kjo funksion.
Plani është i thjeshtë:
- Regjistroheni kprobe në . Pra, mendohet se shkaku i problemeve ndodhet jashtë vetë demonit osd. Kjo mund të jetë ose kernel, ose disqet. Dalja e iostat tregoi një vonesë të lartë në përpunimin e kërkesave nga disqet bcache.:
- Ruajmë në kujtesë emrin e diskut, i disponueshëm përmes argumentit të funksionit;
- Ruajmë shenjën e kohës.
- Regjistroheni kretprobe në kthim nga . Pra, mendohet se shkaku i problemeve ndodhet jashtë vetë demonit osd. Kjo mund të jetë ose kernel, ose disqet. Dalja e iostat tregoi një vonesë të lartë në përpunimin e kërkesave nga disqet bcache.:
- Marrim shenjën e tanishme të kohës;
- Kërkojmë shenjën e ruajtur të kohës dhe e krahasojmë me atë të tanishme;
- Nëse rezultati është më i madh se sa e caktuar, atëherë gjejmë emrin e ruajtur të diskut dhe e shfaqim në terminal.
Kprobes dhe kretprobes përdorin mekanizmin e pikave të ndalimit për të ndryshuar kodin e funksioneve në fluks. Mund të lexoni dhe në këtë temë. Nëse shikoni kodin e mjeteve të ndryshme në , mund të vëreni se ato kanë një strukturë identike. Prandaj në këtë artikull do të anashkalojmë analizimin e argumenteve të skriptit dhe do të kalojmë në programin BPF vetë.
Teksti eBPF brenda skriptit python duket si më poshtë:
bpf_text = """ # Këtu do të jetë kodi i programit bpf """
Për shkëmbimin e të dhënave midis funksioneve, programet e eBPF përdorin . Kështu do të veprojmë edhe ne. Si çelës do të përdorim PID-in e procesit, dhe si vlerë do ta përcaktojmë strukturën:
struct data_t {
	u64 pid;
	u64 ts;
	char comm[TASK_COMM_LEN];
	u64 lat;
	char disk[DISK_NAME_LEN];
};

BPF_HASH(p, u64, struct data_t);
BPF_PERF_OUTPUT(events);
Këtu regjistrojmë një tabelë hash, e cila quhet p, me çelës të tipit u64 dhe vlerë të tipit struct data_t. Tabela do të jetë e aksesueshme në kontekstin e programit tonë BPF. Makroja BPF_PERF_OUTPUT regjistron një tabelë tjetër, e quajtur events, e cila përdoret për në hapësirën e përdoruesit.
Kur matni vonesat midis thirrjes së funksionit dhe kthimit të tij, ose midis thirrjeve të funksioneve të ndryshme, duhet të merret parasysh që të dhënat e marra duhet të përkasin të njëjtit kontekst. Në fjalë të tjera, duhet të kujtojmë për mundësinë e ekzekutimeve paralele të funksioneve. Ne kemi mundësinë të masim vonesën midis thirrjes së funksionit në kontekstin e një procesi dhe kthimin nga ky funksion në kontekstin e një procesi tjetër, por kjo me siguri do të jetë e padobishme. Një shembull i mirë këtu mund të jetë , ku si çelës i tabelës hash caktohet një tregues në struct request, e cila reflekton një kërkesë të vetme për diskun.
Pastaj na nevojitet të shkruajmë kodin që do të ekzekutohet kur thirret funksioni në hulumtim:
void start(struct pt_regs *ctx, struct bio *bio) {
	u64 pid = bpf_get_current_pid_tgid();
	struct data_t data = {};
	u64 ts = bpf_ktime_get_ns();
	data.pid = pid;
	data.ts = ts;
	bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name);
	p.update(&pid, &data);
}
Këtu si argumentin e dytë do të vendoset argumenti i parë i thirrjes së funksionit . Pas kësaj merrni PID-in e procesit, në kontekstin e të cilit punojmë, dhe markën aktuale të kohës në nanosekonda. E regjistrojmë këtë të gjithë në një struct data_t data. Emri i diskut e marrim nga struktura bio, që transmetohet gjatë thirrjes . Pra, mendohet se shkaku i problemeve ndodhet jashtë vetë demonit osd. Kjo mund të jetë ose kernel, ose disqet. Dalja e iostat tregoi një vonesë të lartë në përpunimin e kërkesave nga disqet bcache., dhe e ruajmë në të njëjtën strukturë data. Hapi i fundit është të shtojmë një regjistrim në tabelën hash, për të cilën u përmend më parë.
Funksioni tjetër do të thirret në kthim nga . Pra, mendohet se shkaku i problemeve ndodhet jashtë vetë demonit osd. Kjo mund të jetë ose kernel, ose disqet. Dalja e iostat tregoi një vonesë të lartë në përpunimin e kërkesave nga disqet bcache.:
void stop(struct pt_regs *ctx) {
    u64 pid = bpf_get_current_pid_tgid();
    u64 ts = bpf_ktime_get_ns();
    struct data_t* data = p.lookup(&pid);
    if (data != 0 && data->ts > 0) {
        bpf_get_current_comm(&data->comm, sizeof(data->comm));
        data->lat = (ts - data->ts)/1000;
        if (data->lat > MIN_US) {
            FACTOR
            data->pid >>= 32;
            events.perf_submit(ctx, data, sizeof(struct data_t));
        }
        p.delete(&pid);
    }
}
Ky funksion është i ngjashëm me të kaluarin: kuptojmë PID e procesit dhe stampën kohore, por nuk alokojmë memorie për një strukturë të re data. Në vend të kësaj, kërkojmë në tabelën hash një strukturë ekzistuese me çelësin == PID aktual.
Shtysa binar, që përdorim këtu, është e nevojshme për të marrë GID e thread-it. pra, PID i procesit kryesor që ka nisur thread-in, në kontekstin ku punojmë. Funksioni që thërrasim kthen si GID të thread-it ashtu edhe PID-in e tij në një vlerë 64-bit.
Kur e nxjerrim në terminal, tani nuk na intereson thread-i, por procesi kryesor. Pas krahasimit të vonesës së marrë me pragun e caktuar, ne e kalojmë strukturën tonë data në hapësirën e përdoruesit përmes tabelës events, pas të cilës heqim regjistrimin nga p.
Në skriptin python, i cili do të ngarkojë këtë kod, na nevojitet të zëvendësojmë MIN_US dhe FACTOR me pragjet e vonesës dhe njësi kohore që do t'i kalojmë përmes argumenteve:
bpf_text = bpf_text.replace('MIN_US',str(min_usec))
if args.milliseconds:
	bpf_text = bpf_text.replace('FACTOR','data->lat /= 1000;')
	label = "msec"
else:
	bpf_text = bpf_text.replace('FACTOR','')
	label = "usec"
Tani na nevojitet të përgatisim programin BPF përmes dhe të regjistrojmë provat:
b = BPF(text=bpf_text)
b.attach_kprobe(event="generic_make_request",fn_name="start")
b.attach_kretprobe(event="generic_make_request",fn_name="stop")
Gjithashtu do të duhet ta përcaktojmë struct data_t në skriptin tonë, përndryshe nuk do të mund të lexojmë asgjë:
TASK_COMM_LEN = 16	# linux/sched.h
DISK_NAME_LEN = 32	# linux/genhd.h
class Data(ct.Structure):
	_fields_ = [("pid", ct.c_ulonglong),
            	("ts", ct.c_ulonglong),
            	("comm", ct.c_char * TASK_COMM_LEN),
            	("lat", ct.c_ulonglong),
            	("disk",ct.c_char * DISK_NAME_LEN)]
Hapi i fundit është të nxjerrim të dhënat në terminal:
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# format output
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
Scriptsi është në dispozicion në . Do të përpiqemi ta ekzekutojmë në një platformë testuese, ku është e instaluar fio e cila shkruan në bcache, dhe të thërrasim udevadm monitor:
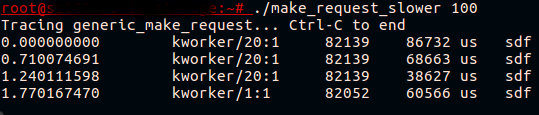
Më në fund! Tani e shikojmë se ajo që dukej si një pajisje bcache që ngadalëson, në të vërtetë është një thirrje ngadalësuese . Pra, mendohet se shkaku i problemeve ndodhet jashtë vetë demonit osd. Kjo mund të jetë ose kernel, ose disqet. Dalja e iostat tregoi një vonesë të lartë në përpunimin e kërkesave nga disqet bcache. për disqin e cache-uar.
Shkoni thellë në Kernel
Çfarë saktësisht shkakton ngadalësim gjatë transferimit të kërkesës? Ne shohim se vonesa ndodh madje edhe para fillimit të llogarizimit të kërkesës, pra, llogaritja e kërkesës specifike për statistikë të mëtejshme ( /proc/diskstats ose iostat) nuk ka filluar ende. Kjo është lehtë për t'u verifikuar, duke ekzekutuar iostat gjatë riprodhimit të problemit, ose , i cili bazohet në fillimin dhe përfundimin e llogarizimit të kërkesave. Asnjë nga këto mjete nuk do të tregojë probleme për kërkesat ndaj disqit të cache-uar.
Nëse ne shikojmë në funksionin . Pra, mendohet se shkaku i problemeve ndodhet jashtë vetë demonit osd. Kjo mund të jetë ose kernel, ose disqet. Dalja e iostat tregoi një vonesë të lartë në përpunimin e kërkesave nga disqet bcache., do të shohim se para fillimit të llogarizimit të kërkesës thirren ende dy funksione të tjera. E para — generic_make_request_checks(), kryen verifikimet e ligjshmërisë së kërkesës në lidhje me cilësimet e disqit. E dyta — , ku ka një thirrje interesante :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
Në të, Kernel-i pret të shkrihet radhët. Le të matim vonesën blk_queue_enter():
~# /usr/share/bcc/tools/funclatency blk_queue_enter -i 1 -m
Duke gjurmuar 1 funksione për "blk_queue_enter"... Shtypni Ctrl-C për të përfunduar.

 	msecs           	: numri 	distribucioni
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: numri 	distribucioni
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: numri 	distribucioni
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Duket se jemi afër zgjidhjes. Funksionet e përdorura për "ngirjen/shkrirjen" e radhës janë dhe . Ato përdoren kur është e nevojshme të ndryshohen cilësimet e radhës së kërkesave, potencialisht të rrezikshme për kërkesat që ndodhen në këtë radhë. Kur thirret blk_mq_freeze_queue() përmes funksionit numri q->mq_freeze_depth. Pas kësaj, bërthama pret zbrazjen e radhës në .
Koha e pritjes për zbrazjen e kësaj radhe është ekuivalente me vonesën e diskut, pasi bërthama pret përfundimin e të gjitha operacioneve të vendosura në radhë. Sapo radhë të bëhet e zbrazët, aplikohen ndryshimet e konfigurimit. Pas kësaj, thirret , e cila ul numëruesin freeze_depth.
Tani dimë mjaftueshëm për të rregulluar situatën. Komanda udevadm trigger, si rezultat, çon në aplikimin e konfigurimeve për pajisjen bllokuese. Këto konfigurime përshkruhen në rregullat e udev. Ne mund të gjejmë se cilat konfigurime 'ngrin' radhën, duke provuar t'i ndryshojmë ato përmes sysfs ose duke parë kodin burimor të bërthamës. Ndërkohë, mund të provojmë utilitarin BCC , e cila do të nxjerrë në terminal të dhënat e grumbullit të bërthamës dhe hapësirës së përdoruesit për secilën thirrje blk_freeze_queue, për shembull:
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	elevator_switch+0x29 [kernel]
    	elv_iosched_store+0x197 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	queue_requests_store+0xb6 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]
Rregullat e udev ndryshojnë mjaft rrallë dhe zakonisht ndodhin nën kontroll. Pra, shohim se edhe aplikimi i vlerave të dhëna tashmë shkakton një shpërthim vonese në dërgimin e kërkesës nga aplikacioni në disk. Sigurisht, të gjenerosh ngjarje udev kur nuk ka ndonjë ndryshim në konfigurimin e disqeve (p.sh., pajisja nuk po lidhet/nuk po shkëputet) nuk është një praktikë shumë e mirë. Megjithatë, ne mund ta ndihmojmë bërthamën të mos bëjë punë të padobishme dhe të mos 'ngrejë' radhën e kërkesave, nëse nuk ka asnjë nevojë. rregullojnë situatën.
Përfundim
eBPF është një mjet shumë fleksibël dhe i fuqishëm. Në këtë artikull, ne shqyrtuam një rast praktik dhe demonstruam një pjesë të vogël të asaj që është e mundur të bëhet. Nëse jeni të interesuar për zhvillimin e utilitarëve BCC, ia vlen të shikoni , i cili përshkruan mirë bazat e funksionimit.
Ka there dhe mjete të tjera interesante për debugging dhe profiling, të bazuara në eBPF. Një prej tyre është , i cili lejon të shkruani script-e të fuqishme dhe programe të vogla në një gjuhë të ngjashme me awk. Tjetra është , e cila lejon mbledhjen e metrikave të nivelit të ulët me një rezolutë të lartë drejtpërdrejt në serverin tuaj prometheus, me mundësinë për të marrë më vonë vizualizime të bukura dhe madje edhe alerte.
Burimi: habr.com
