

Në këtë artikull do të flas për mënyrën si i qasëm cështjes së disponueshmërisë së PostgreSQL, pse ishte e rëndësishme për ne dhe çfarë arritëm përfundimisht.
Ne kemi një shërbim me një ngarkesë të lartë: 2.5 milion përdorues në të gjithë botën, me më shumë se 50,000 përdorues aktivë çdo ditë. Serverat ndodhen në Amazone në një rajon të Irlandës: në punë janë vazhdimisht më shumë se 100 servera të ndryshëm, nga të cilët gati 50 janë me baza të dhënash.
Backend-i ynë është një aplikacion i madh monolit stateful në Java, i cili ruan një lidhje websocket të përhershme me klientin. Kur disa përdorues punojnë në të njëjtin tavolinë, ata e shohin ndryshimin në kohë reale, sepse çdo ndryshim e regjistrojmë në bazën e të dhënave. Ne kemi rreth 10,000 kërkesa në sekondë për bazat tona. Në ngarkesën më të lartë, në Redis regjistrojmë nga 80,000 në 100,000 kërkesa në sekondë.
Pse kaluam nga Redis në PostgreSQL
Fillimisht shërbimi ynë punonte me Redis, një depo key-value që ruan të gjitha të dhënat në memorje. serverë.
Pikat e mira të Redis:
- Shpejtësi e lartë përgjigjeje, pasi gjithçka ruhet në memorje;
- Lehtësia e backup-it dhe replikimit.
Pikat negative të Redis për ne:
- Nuk ka transaksione të vërteta. Ne përpiqeshim t’i imitonim ato në nivelin e aplikacionit tonë. Fatkeqësisht, kjo nuk funksionoi gjithmonë mirë dhe kërkonte shkrimin e një kodi shumë kompleks.
- Volume i të dhënave është i kufizuar nga sasia e memorjes. Me rritjen e sasisë së të dhënave, memoria do të rritet dhe, në fund, ne do të hasim karakteristikat e instancës së zgjedhur, e cila në AWS kërkon ndalimin e shërbimit tonë për të ndryshuar tipin e instancës.
- Nevojitet të ruajmë vazhdimisht një nivel të ulët latency, pasi kemi një numër shumë të madh kërkesash. Niveli optimal i vonesës për ne është 17-20 ms. Nëse niveli arrin 30-40 ms, ne kemi përgjigje të gjata në kërkesat e aplikacionit tonë dhe degradim të shërbimit. Fatkeqësisht, kjo ndodhi në shtator 2018, kur një nga instancat me Redis për një arsye apo tjetrën mori një latency dy herë më të madhe se zakonisht. Për zgjidhjen e problemit, ne ndaluam shërbimin në mes të ditës për një mirëmbajtje të paplanifikuar dhe e zëvendësuam instancën problematike të Redis.
- Është e lehtë të marrësh inkonsistencë të të dhënave, madje edhe me gabime të vogla në kod, dhe pastaj të harxhosh shumë kohë për të shkruar kod për të rregulluar këto të dhëna.
Kemi marrë parasysh disavantazhet dhe kuptuam se duhej të kalonim në diçka më të përshtatshme, me transaksione normale dhe më pak varësi nga latency. Bëmë një kërkimin, analizuam shumë mundësi dhe zgjodhëm PostgreSQL.
Në bazën tonë të dhënash të re po kalojmë tashmë për 1.5 vjet dhe kemi transferuar vetëm një pjesë të vogël të të dhënave, prandaj tani punojmë njëkohësisht me Redis dhe PostgreSQL. Më shumë për fazat e kalimit dhe ndërrimin e të dhënave ndërmjet bazave të të dhënave është shkruar në artikullin e kolegut tim.
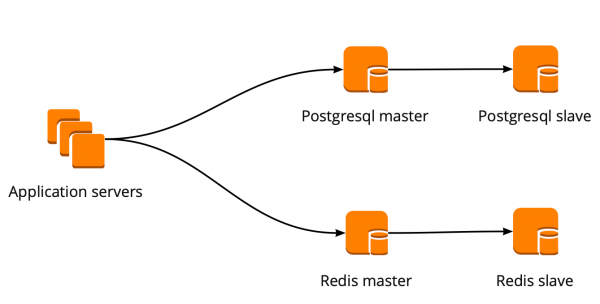
Kur sapo filluam të kalonim, aplikacioni ynë punonte drejtpërdrejt me bazën e të dhënave dhe përfshinte Redis dhe PostgreSQL master. Klasteri PostgreSQL përbëhej nga një master dhe një kopje me replikim asinkron. Kështu dukej skema e punës me bazat e të dhënave:
Zbatimi i PgBouncer
Ndërkohë që po kalonim, produkti gjithashtu po zhvillohej: numri i përdoruesve dhe numri i serverëve që punonin me PostgreSQL po rritej, dhe na mungonin lidhjet. PostgreSQL krijon një proces të veçantë për çdo lidhje dhe konsumon burime. Numri i lidhjeve mund të rritet deri në një moment të caktuar, përndryshe ka rrezik të kemi punë jo optimale të bazës së të dhënave. Zgjedhja ideale në një situatë të tillë do të ishte të zgjidhnim një menaxher lidhjesh që do të vendosej para bazës.
Ne kishim dy mundësi për menaxherin e lidhjeve: Pgpool dhe PgBouncer. Por e para nuk mbështet modalitetin transaksional të punës me bazën, prandaj zgjodhëm PgBouncer.
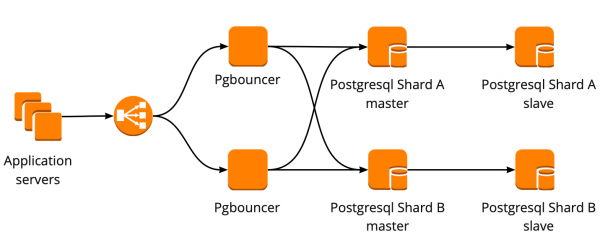
Ne konfiguram skemën e mëposhtme të punës: aplikacioni ynë i drejtohet një PgBouncer, pas të cilit ndodhen masterat PostgreSQL, dhe pas çdo masteri ka një kopje me replikim asinkron.
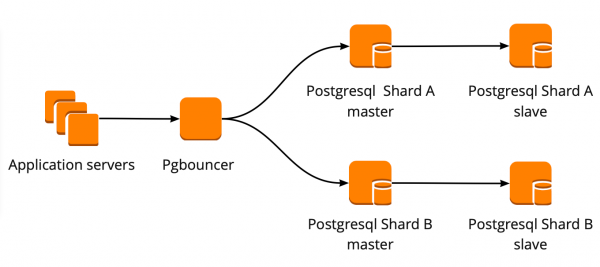
Në këtë mënyrë nuk ishim në gjendje të ruanim të gjithë volumin e të dhënave në PostgreSQL dhe për ne ishte e rëndësishme shpejtësia e punës me bazën, prandaj filluam të shardojmë PostgreSQL në nivelin aplikativ. Skema e përshkruar më sipër është relativisht e përshtatshme për këtë: kur shtohet një shard i ri, mjafton të përditësohet konfigurimi i PgBouncer dhe aplikacioni mund të fillojë menjëherë të punojë me shardin e ri.
Mundësia për të mbijetuar në PgBouncer
Ky kjo skemë funksionoi deri në momentin kur instanca e vetme PgBouncer vdiq. Ne ndodhemi në AWS, ku të gjitha instancat janë të drejtuara në hardware që vdes herë pas here. Në këto raste, instanca thjesht kalon në një hardware të ri dhe rifilloi punën. Kjo ndodhi edhe me PgBouncer, megjithatë ai u bë i paarritshëm. Si rezultat i këtij rënies, shërbimi ynë nuk ishte në dispozicion për 25 minuta. AWS për këto situata rekomandon përdorimin e teprisë nga ana e përdoruesit, e cila nuk ishte implementuar nga ne në atë kohë.
Pas kësaj, ne mendojmë seriozisht për qëndrueshmërinë e PgBouncer dhe klastereve PostgreSQL, pasi një situatë e tillë mund të ripërsëritet me çdo instancë në llogarinë tonë AWS.
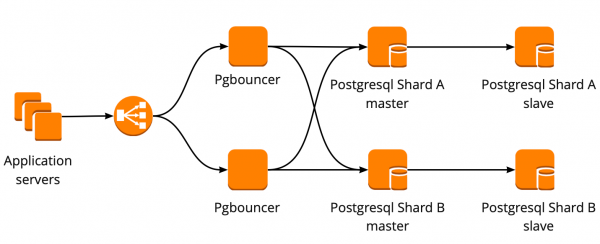
Ne e ndërtuam skemën e qëndrueshmërisë për PgBouncer si më poshtë: të gjitha serverat e aplikacionit i drejtohen Network Load Balancer, pas të cilit qëndrojnë dy PgBouncer. Secili PgBouncer sheh të njëjtit master PostgreSQL të çdo sharde. Në rast përsëritjeje të situatës me rënien e instancës AWS, e gjithë trafiku redirektohet përmes PgBouncer-it tjetër. Qëndrueshmëria e Network Load Balancer sigurohet nga AWS.
Kjo skemë lejon shtimin e serverave të rinj PgBouncer pa probleme.
Krijimi i një klasteri PostgreSQL të qëndrueshëm
Në këtë detyrë ne shqyrtuam opsione të ndryshme: failover i shkruar vetë, repmgr, AWS RDS, Patroni.
Skripte të shkruara vetë
Mund të monitorojnë funksionimin e masterit dhe, në rast rënies së tij, të promovojnë replikën në master dhe të azhurnojnë konfigurimin e PgBouncer.
Avantazhet e këtij qasjeje janë thjeshtësia maksimale, sepse ju vetë shkruani skriptet dhe e kuptoni saktësisht se si funksionojnë ato.
Disavantazhet:
- Masteri mund të mos jetë ndalur, por në vend të kësaj mund të ketë ndodhur një ndërprerje rrjeti. Failover, pa e ditur këtë, do të promovonte replikën në master, dhe masteri i vjetër do të vazhdojë të funksionojë. Si rezultat, ne do të kemi dy serverë si master dhe nuk do të dimë se në cilin prej tyre ndodhen të dhënat më të fundit. Kjo situatë njihet gjithashtu si split-brain;
- Ne mbetëm pa replikë. Në konfigurimin tonë kemi një master dhe një replikë, pas kalimit, replikat promovohen në master dhe nuk kemi më replika, kështu që na duhet të shtojmë një replikë të re në mënyrë manuale;
- Kërkohet monitorim të dhënash të mëtejshëm rreth funksionimit të failover, dhe ne kemi 12 sharde PostgreSQL, kështu që duhet të monitorojmë 12 klasterë. Me rritjen e numrit të shardeve, nuk duhet të harrojmë të azhurnojmë gjithashtu failover.
Krijimi i një sistemi të shkruar nga vetë për dështimin duket shumë i komplikuar dhe kërkon mbështetje jo triviale. Duke përdorur një grup PostgreSQL, ky do të ishte opsioni më i thjeshtë, por nuk është i shkallëzueshëm, prandaj nuk na përshtatet.
Repmgr
Menaxhuesi i Replikimit për grupet PostgreSQL, i cili din të menaxhojë funksionimin e grupit PostgreSQL. Megjithatë, nuk ofron dështim automatik "nga kutia", kështu që do të nevojitet të shkruhet një "mbështjellës" mbi zgjidhjen e gatshme. Prandaj, gjithçka mund të bëhet edhe më e komplikuar se me skriptet e shkruara nga vetë, kështu që ne nuk e provuam madje edhe Repmgr.
AWS RDS
Mbështet gjithçka që na nevojitet, din të bëjë kopje rezervë dhe mbështet grupimin e lidhjeve. Ka kalim automatik: kur masteri vdes, një replikë bëhet masteri i ri, dhe AWS ndryshon regjistrimin DNS për masterin e ri, me replikat që mund të ndodhen në AZ të ndryshme.
Një nga të metat është mungesa e parametrave të hollësishëm të konfigurimit. Si shembull të parametrave të hollësishëm: në instancat tona kanë përllogaritje për lidhjet TCP, gjë që, fatkeqësisht, nuk mund të realizohet në RDS:
net.ipv4.tcp_keepalive_time=10
net.ipv4.tcp_keepalive_intvl=1
net.ipv4.tcp_keepalive_probes=5
net.ipv4.tcp_retries2=3
Për më tepër, çmimi për AWS RDS është pothuajse dy herë më i shtrenjtë se çmimi i zakonshëm i instancës, që ka qenë shkaku kryesor i refuzimit të kësaj zgjidhjeje.
Patroni
Ky është një template për python për menaxhimin e PostgreSQL me dokumentacion të mirë, dështim automatik dhe kod burimor në github.
Avantazhet e Patroni:
- Çdo parametr i konfigurimit është i detajuar, kuptohet si funksionon gjithçka;
- Dështimi automatik funksionon nga kutia;
- Është shkruar në python, dhe pasi ne vetë shkruajmë shumë në python, do të na jetë më e lehtë të kuptojmë problemet dhe, ndoshta, madje të ndihmojmë në zhvillimin e projektit;
- Menaxhon plotësisht PostgreSQL-in, lejon ndryshimin e konfiguracionit menjëherë në të gjitha nodet e grupit, dhe nëse kërkohet rinisja e grupit për të aplikuar një konfigurim të ri, kjo mund të bëhet gjithashtu me ndihmën e Patroni.
Disavantazhet:
- Nga dokumentacioni nuk është e qartë se si të punoni saktësisht me PgBouncer. Megjithatë, nuk është e lehtë ta quash këtë një të metë, pasi detyra e Patroni është të menaxhojë PostgreSQL-in, dhe se si do të kalojnë lidhjet te Patroni është problemi ynë;
- Ka pak shembuj të implementimit të Patroni në volume të mëdha, ndërkohë që ka shumë shembuj implementimi nga zero.
Përfundimisht, për të krijuar një grup që është rezistent ndaj dështimeve, ne zgjodhëm pikërisht Patroni.
Procesi i implementimit të Patroni
Para Patroni kishim 12 shard-e PostgreSQL me një konfigurim një master dhe një replikë me replikim asinkron. Serverët e aplikacionit i drejtoheshin bazave të të dhënave përmes Network Load Balancer, për të cilin ishin dy instance me PgBouncer, dhe pas tyre ndodheshin të gjithë serverët PostgreSQL.
Për të futur Patroni na nevojitej të zgjedhim një ruajtje të shpërndara të konfiguracionit të klasterit. Patroni funksionon me sisteme të shpërndara të ruajtjes së konfiguracioneve si etcd, Zookeeper, Consul. Mënyra si jemi në prodhimin tonë, kemi një klaster të plotë Consul, i cili funksionon në bashkëpunim me Vault dhe nuk e përdorim më tej. Një rast i shkëlqyer për të filluar përdorimin e Consul për qëllimin e tij.
Si funksionon Patroni me Consul
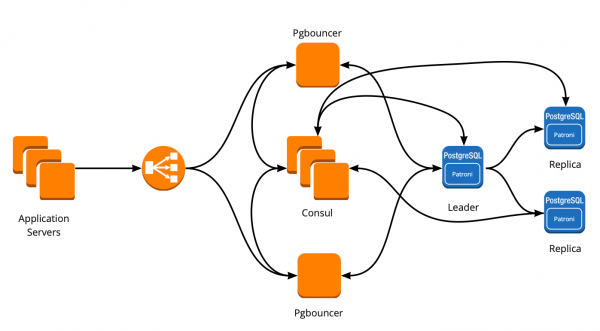
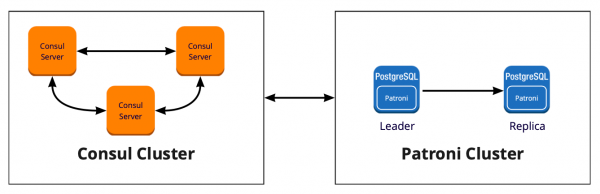
Ne kemi një klaster Consul, i cili përbëhet nga tre nodë dhe një klaster Patroni, i cili përbëhet nga një lider dhe një replikë (në Patroni, masteri quhet lider i klasterit dhe skllavët - replika). Çdo instancë e klasterit Patroni dërgon vazhdimisht në Consul informacion mbi gjendjen e klasterit. Prandaj nga Consul gjithmonë mund të mësohet konfiguracioni aktual i klasterit Patroni dhe kush është lideri në atë moment.
Për të lidhur Patroni me Consul, mjafton të studiohet dokumentacioni zyrtar, ku shkruhet se është e nevojshme të specifikohet host-i në formatin http ose https në varesi të mënyrës si punojmë me Consul, dhe skema e lidhjes është opsionale:
host: hosti:port për pikën e fundit të Consul, në formatin: http(s)://host:port
scheme: (opsionale) http ose https, parazgjedhje është http
Duket e thjeshtë, por këtu fillojnë problemet. Ne punojmë me Consul përmes një lidhjeje të sigurt përmes https dhe konfigurimi ynë i lidhjes do të duket si më poshtë:
consul:
  host: https://server.production.consul:8080
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Por ashtu nuk funksionon. Gjatë nisjes së Patroni nuk mund të lidhet me Consul sepse përpiqet gjithsesi të shkojë nëpërmjet http.
Të kuptojmë problemin ndihmoi kodi burimor i Patroni. Fatmirësisht, ai është shkruar në python. Duke u zbuluar, parametri host nuk analizohet ashtu si duhet, dhe protokolli duhet të specifikohet në scheme. Ja si duket blloku i punueshëm i konfigurimit për të punuar me Consul për ne:
consul:
  host: server.production.consul:8080
  scheme: https
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Consul-template
Pra të gjitha, kemi zgjedhur ruajtjen për konfigurimin. Tani duhet të kuptojmë se si PgBouncer do të kalojë konfigurimin e tij gjatë ndryshimit të liderit në klasterin Patroni. Dokumentacioni nuk ofron përgjigje për këtë, pasi nuk e përshkruan punën me PgBouncer në tërësi.
Në kërkim të zgjidhjes, ne gjetëm një artikull (emrin, fatkeqësisht, nuk e mbaj mend) ku ishte shkruar se Sconsul-template ndihmon shumë në lidhjen ndërmjet PgBouncer dhe Patroni. Kjo na shtyu në kërkimin për funksionimin e Consul-template.
Doli se Sconsul-template monitoron vazhdimisht konfigurimin e klasterit PostgreSQL në Consul. Gjatë ndryshimit të liderit, ai përditëson konfigurimin e PgBouncer dhe dërgon një komandë për ta rindezur.
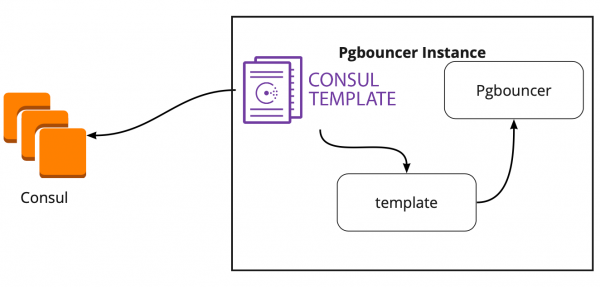
Një përparësi e madhe e template është se ajo ruhet si kod, kështu që kur shtohet një shard i ri, mjafton të bëhet një commit i ri dhe të përditësohet template në mënyrë automatike, duke mbajtur parimin e Infrastrukturës si Kod.
Arkitektura e re me Patroni
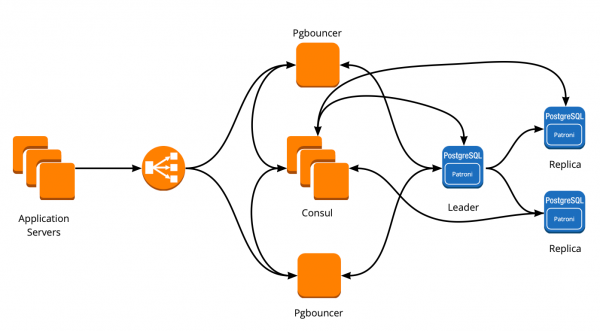
Si rezultat, ne morëm këtë skemë pune:
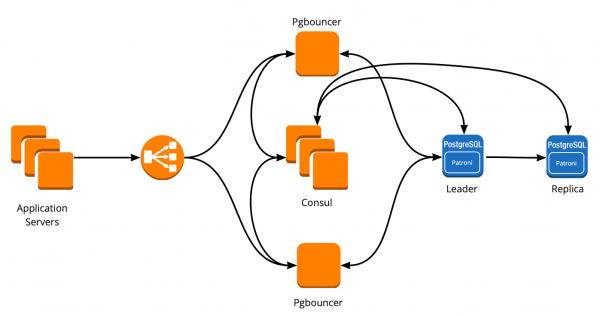
Të gjitha serverat e aplikacionit iu drejtohen balancuesit → pas tij qëndrojnë dy instance PgBouncer → në çdo instance është aktivizuar Sconsul-template, i cili monitoron gjendjen e çdo klasteri Patroni dhe ndjek aktualitetin e konfigurimit PgBouncer, i cili drejton kërkesat te lideri aktual i çdo klasteri.
Testim manual
Këtë skemë, para se ta nxjerrim në prodhim, e kemi ekzekutuar në një mjedis testimi të vogël dhe kontrolluam funksionimin e kalimit automatik. Hapur boardin, lëvizëm sticker dhe në atë moment “vramë” liderin e klasterit. Në AWS, për këtë mjafton të fiket instanca përmes konsolës.
Sticker-i kthehej pas 10-20 sekondash, dhe pastaj fillonte sërish të lëvizte normalisht. Kjo tregon se klasteri Patroni funksionoi siç duhet: ndërroi liderin, dërgoi informacionin në Sconsul, dhe Sconsul-template menjëherë e kapte këtë informacion, zëvendësoi konfigurimin e PgBouncer dhe dërgoi komandën për reload.
Si të mbijetosh nën një ngarkesë të lartë dhe të ruash downtime minimal?
Të gjitha funksionon shkëlqyeshëm! Por po shfaqen pyetje të reja: Si do të funksionojë kjo nën një ngarkesë të lartë? Si të shpërndajmë gjithçka në prodhim shpejt dhe sigurt?
Për të përgjigjur pyetjes së parë, na ndihmon një mjedis testimi, ku ne kryejmë testim ngarkese. Ai është plotësisht identik me production në arkitekturë dhe ka të dhëna testuese të gjeneruara, të cilat në vëllim janë afërsisht të barabarta me ato në production. Ne vendosim thjesht "ta vrasim" një nga masterat e PostgreSQL gjatë testit dhe të shohim se çfarë do ndodhë. Por para këtij momenti është e rëndësishme të kontrollojmë automatikisht përhapjen, pasi në këtë mjedis kemi disa shard-e të PostgreSQL, kështu që do të kemi një testim të shkëlqyer të skenarëve të konfigurimit përpara prodhimit.
Të dy detyrat duken ambicioze, por ne kemi PostgreSQL 9.6. Po nuk vepruam direkt dhe e përditësuam në 11.2?
Ne vendosim ta bëjmë këtë në 2 etapa: së pari përditësimin në versionin 11.2, pastaj të drejtojmë Patroni.
Përditësimi i PostgreSQL
Për të përditësuar versionin e PostgreSQL sa më shpejt, është e nevojshme të përdoret opsioni -k, në të cilin krijohen lidhje të forta në disk dhe nuk ka nevojë për kopjimin e të dhënave tuaja. Në baza me 300-400 GB, përditësimi zgjat 1 sekondë.
Ne kemi shumë shard-e, kështu që përditësimi duhet të bëhet automatikisht. Për këtë, ne shkruam një Ansible playbook, i cili kryen të gjithë procesin e përditësimit për ne:
/usr/lib/postgresql/11/bin/pg_upgrade
<b>--link </b>
--old-datadir='' --new-datadir=''
 --old-bindir=''  --new-bindir=''
 --old-options=' -c config_file='
 --new-options=' -c config_file='
Këtu është e rëndësishme të theksohet se para se të filloni përmirësimin, duhet ta kryeni atë me parametrin —check, për të qenë të sigurt në mundësinë e përmirësimit. Po ashtu, skenari ynë bën zëvendësimin e konfigurimeve gjatë përmirësimit. Skenari ynë u ekzekutua për 30 sekonda, ky është një rezultat i shkëlqyer.
Nisja e Patroni
Për të zgjidhur problemin e dytë, mjafton të shohim konfigurimin e Patroni. Në depozitat zyrtare ka një shembull konfigurimi me initdb, i cili përgjigjet për inicializimin e një baze të re gjatë nisjes së parë të Patroni. Por pasi që ne kemi një bazë të gatshme, thjesht e hoqëm këtë pjesë nga konfigurimi.
Kur filluam të instalonim Patroni në një klaster të gatshëm PostgreSQL dhe ta nisim atë, u përballëm me një problem të ri: të dy serverët nisnin si lider. Patroni nuk di asgjë për gjendjen e mëparshme të klasterit dhe përpiqet të nisë të dy serverët si dy klasterë të veçantë me të njëjtin emër. Për të zgjidhur këtë problem, është e nevojshme të hiqet директория e të dhënave në slave:
rm -rf /var/lib/postgresql/Kjo duhet bërë vetëm në slave!
Kur lidhet një replikë e pastër, Patroni bën backup bazor të liderit dhe e rikthen atë në replikë, pastaj e përditëson gjendjen e tanishme përmes wal-log-ëve.
Një vështirësi tjetër me të cilën u përballëm është se të gjithë klasterat PostgreSQL默认 quhen main. Kur çdo klaster nuk di asgjë për një tjetër, është në rregull. Por kur dëshiron të përdorësh Patroni, të gjithë klasterat duhet të kenë një emër unik. Zgjidhja është të ndryshosh emrin e klasterit në konfigurimin e PostgreSQL.
Testim ngarkese
Ne filluam një test që imiton punën e përdoruesve në tabela. Kur ngarkesa arriti niveli tonë mesatar ditor, ne përsëritëm të njëjtin test, duke fikur një instancë me liderin PostgreSQL. Failover-i automatik funksionoi ashtu siç e prisnim: Patroni ndryshoi liderin, Konsul-template përditësoi konfigurimin PgBouncer dhe dërgoi një komandë për rifreskimin. Të dhënat tona në Grafana treguan se kishte vonesa prej 20-30 sekondash dhe një sasi të vogël gabimesh nga serverët, të lidhura me lidhjen në bazë. Kjo është një situatë normale, këto vlera janë të pranueshme për failover-in tonë dhe sigurisht janë më të mira se ndalesa e shërbimit.
Dalja e Patroni në prodhim
Si përfundim, plani ynë ishte si vijon:
- Deploy-i i Konsul-template në serverat PgBouncer dhe nisja;
- Përditësimi i PostgreSQL në versionin 11.2;
- Ndryshimi i emrit të klasterit;
- Nisja e klasterit Patroni.
Në të njëjtën kohë, skema jonë lejon që të realizojmë pikën e parë pothuajse në çdo moment, ne mund të heqim një nga një secilin PgBouncer nga funksionimi dhe të realizojmë deploy-në dhe nisjen e konsul-template. Kështu e bëmë.
Për një shpërndarje të shpejtë, ne përdorëm Ansible, pasi të gjithë playbook-ët i kishim verifikuar tashmë në mjedisin e testimit, dhe koha e realizimit të skenarit të plotë ishte nga 1.5 deri në 2 minuta për çdo shard. Ne mundëm ta shpërndanim secilën shard një nga një pa ndaluar shërbimin tonë, por do të na duhej të fiknim çdo PostgreSQL për disa minuta. Në këtë rast, përdoruesit, të cilët kishin të dhëna në këtë shard, nuk do të mund të punonin plotësisht në atë kohë, dhe kjo për ne është e papranueshme.
Zgjidhja për këtë situatë ishte një mirëmbajtje e planifikuar, që zhvillohet çdo 3 muaj. Ky është një interval për punët e planifikuara, kur ne e fikim plotësisht shërbimin tonë dhe përditësojmë instancat e bazës së të dhënave. Ishte mbetur një javë deri në intervalin e radhës, dhe ne vendosëm të prisnim dhe të përgatiteshim më tej. Gjatë kohës së pritjes, ne morëm masa shtesë: për çdo shard PostgreSQL ngritëm një replikë rezervë për rast të dështimit, për të ruajtur të dhënat më të fundit, dhe shtuam një instancë të re për çdo shard, e cila do të bëhej një replikë e re në klasterin Patroni, për të mos ekzekutuar komandën për të fshirë të dhënat. E gjithë kjo ndihmoi të reduktojmë sa më shumë rrezikun e gabimeve.
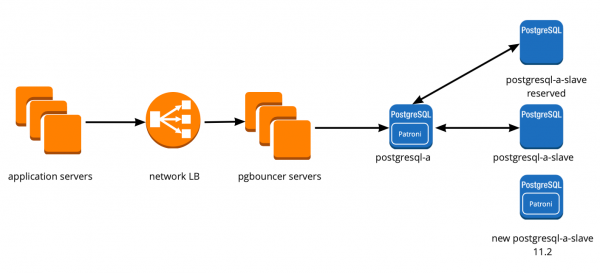
Ne riluajtëm shërbimin tonë, gjithçka funksionoi siç duhej, përdoruesit vazhduan punën, por në grafikë ne vërejta një ngarkesë anomalisht të lartë në serverët e Consul.
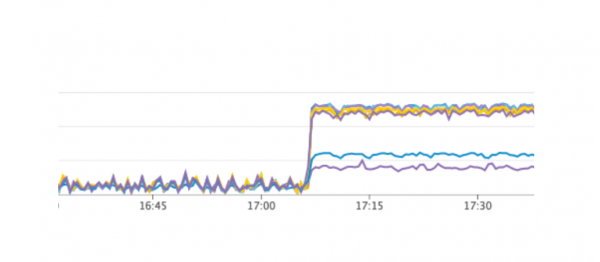
Pse nuk e pamë këtë në mjedisin testues? Ky problem ilustron shumë mirë nevojën për të ndjekur parimin e Infrastrukturës si Kod dhe për të përmirësuar të gjithë infrastrukturën, duke filluar nga mjediset testuese deri te prodhimi. Ndryshe, është shumë e lehtë të përballesh me një problem të tillë siç ishte rasti ynë. Çfarë ndodhi? Consul u shfaq fillimisht në prodhim, e më pas në mjediset testuese, si rezultat, në mjediset testuese versioni i Consul ishte më i lartë se në prodhim. Pikërisht në një nga rrelease-t u zgjidh një rrjedhje CPU gjatë punës me consul-template. Kështu që thjesht përditësuam Consul, duke zgjidhur kështu problemin.
Riluaj klasterin Patroni
Megjithatë, ne morëm një problem të ri, për të cilin nuk kishim as një ide. Gjatë përditësimit të Consul, thjesht heqim nodën e Consul nga klasteri me komandën consul leave → Patroni lidhet me një server tjetër të Consul → gjithçka funksionon. Por kur arritëm në instancën e fundit të klasterit të Consul dhe i dërguam asaj komandën consul leave, të gjithë klasteret e Patroni thjesht u riluajtën, dhe në log e shohim gabimin në vazhdim:
Gabim: merrni_kostum
Zgjidhja më e fundit e thirrjes së fundit:
...
GabimNëTentativë: 'Kaluar afatin e ri-tre hedo'
Gabim: Gabim në komunikim me DCS
<b>LOG: sistemi i bazës së të dhënave është mbyllur</b>
Klasteri Patroni nuk arriti të marrë informacion për klasterin e tij dhe u riluajt.
Për të gjetur një zgjidhje, ne u drejtuam tek autorët e Patroni përmes një problemi në github. Ata sugjeruan përmirësime të skedave tona të konfigurimit:
consul:
 consul.checks: []
bootstrap:
 dcs:
   retry_timeout: 8
Ne arritëm të përsërisim problemin në mjedisin testues dhe e testuam atje, por, fatkeqësisht, ato nuk funksionuan.
Problemi është ende pa zgjidhje. Ne planifikojmë të provojmë këto mundësi zgjidhjeje:
- Të përdorim Sconsul-agent në çdo instancë të klasterit Patroni;
- Të rregullojmë problemin në kod.
Na është e qartë vendi i shfaqjes së gabimit: ndoshta problemi është në përdorimin e default timeout, i cili nuk ri-shkruhet nëpërmjet dosjes së konfigurimit. Kur hiqet serveri i fundit Sconsul nga klasteri, ndodh një ngecje e tërë klasterit Sconsul, që zgjas më shumë se një sekondë, për këtë arsye Patroni nuk mund të marrë gjendjen e klasterit dhe e rinis tërë klasterin.
Fatmirësisht, nuk hasëm më asnjë gabim tjetër.
Përmbledhja e përdorimit të Patroni
Pas fillimit të suksesshëm të Patroni, kemi shtuar nga një replikë shtesë në çdo klaster. Tani në çdo klaster ka një ngjashmëri të kvorumit: një lider dhe dy replika, për të siguruar në rastin e split-brain gjatë kalimit.
Në prodhim, Patroni ka funksionuar për më shumë se tre muaj. Gjatë kësaj kohe ai ka arritur të na ndihmojë. Së fundmi në AWS vdiq lideri i njërit prej klasterëve, dhe failover automatik u aktivizua dhe përdoruesit vazhduan të punojnë. Patroni realizoi detyrën e tij kryesore.
Një përmbledhje e vogël e përdorimit të Patroni:
- Lehtësia e ndryshimit të konfigurimit. Mjafton të ndryshoni konfigurimin në një instancë dhe ai do të aplikohet në tërë klasterin. Nëse nevojitet rinisja për të aplikuar konfigurimin e ri, Patroni do ta njoftojë për këtë. Patroni mund të rinisi tërë klasterin me një komandë, që gjithashtu është shumë e përshtatshme.
- Failover automatik funksionon dhe na ka ndihmuar tashmë.
- Përditësimi i PostgreSQL pa ndërprerje të aplikacionit. Së pari, është e nevojshme të përditësohen replikat në versionin e ri, pastaj të ndryshohet lideri në klasterin Patroni dhe të përditësohet lideri i vjetër. Gjatë kësaj, bëhet testimi i nevojshëm i failover-it automatik.
Burimi: habr.com
