

Disa vite më parë, Kubernetes në blogun zyrtar të GitHub. Që atëherë, ai është bërë teknologjia standarde për vendosjen e shërbimeve. Tani Kubernetes menaxhon një pjesë të konsiderueshme të shërbimeve të brendshme dhe publike. Si klasterat tanë u rritën dhe kërkesat për performancë u bënë më të rrepta, ne filluam të vëmë re se në disa shërbime në Kubernetes qe herë pas here kishte vonesa, të cilat nuk mund të justifikoheshin nga ngarkesa e vetë aplikacionit.
Në thelb, në aplikacione ndodhin vonesa të rastësishme në rrjet deri në 100 ms apo më shumë, që shpijnë në skadime ose përpjekje të përsëritura. Pritej që shërbimet të mund të përgjigjeshin më shpejt se 100 ms. Por kjo nuk është e mundur nëse vetë lidhja merr kaq shumë kohë. Përveç kësaj, ne vrojtuam kërkesa shumë të shpejta MySQL që duhej të merrnin milisekonda, dhe MySQL vërtet e menaxhonte brenda milisekondave, por nga këndvështrimi i aplikacioneve që kërkonin përgjigja merrte 100 ms apo më shumë.
Menjëherë u bë e qartë se problemi ndodhte vetëm kur lidhej me një nod Kubernetes, edhe nëse thirrja vinte nga jashtë Kubernetes. Më e lehtë për ta riprodhuar problemin në test. , që kryhet nga çdo host të brendshëm, teston shërbimin Kubernetes në një port të caktuar dhe regjistron herë pas here vonesa të mëdha. Në këtë artikull do të shqyrtojmë se si arritëm të gjurmojmë shkakun e këtij problemi.
Eliminimi i kompleksitetit të panevojshëm në zinxhirin e dështimit
Duke riprodhuar të njëjtin shembull, ne doja të ngushtonim fokusin e problemit dhe të hiqnim katër shtresa të panevojshme të kompleksitetit. Fillimisht, në rrjedhën midis Vegeta dhe pod'ave në Kubernetes kishte shumë elementë. Për të përcaktuar një problem më të thellë në rrjet, duhet të përjashtojmë disa prej tyre.
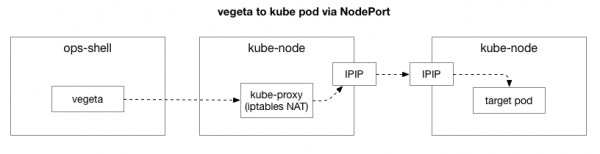
Klijenti (Vegeta) krijon një lidhje TCP me çdo nod në klaster. Kubernetes funksionon si një rrjet overlay (mbi rrjetin ekzistues të qendrës së të dhënave), i cili përdor , domethënë inkapsulon paketat IP të rrjetit overlay brenda paketave IP të qendrës së të dhënave. Kur lidhet me nodin e parë, kryhet një transformim i adresave rrjetit. (NAT) me ndjekjen e statusit për të transformuar adresën IP dhe portin e nodit Kubernetes në adresën IP dhe portin në rrjetin e mbështjellë (veçanërisht, pod-in me aplikacionin). Për paketat që arrijnë, ekzekutohet një renditje e kundërt. Kjo është një sistem kompleks me shumë gjendje dhe shumë elemente që azhurnohen dhe ndryshojnë vazhdimisht me shpërndarjen dhe lëvizjen e shërbimeve.
Mjeti tcpdump në testin Vegeta jep vonesë gjatë përshëndetjes TCP (midis SYN dhe SYN-ACK). Për të eliminuar këtë kompleksitet të tepruar, mund të përdorim hping3 për pingje të thjeshta me paketa SYN. Kontrollojmë nëse ka vonesë në paketën e përgjigjes dhe pastaj e nxjerrim lidhjen. Mund të filtrojmë të dhënat, duke përfshirë vetëm paketat mbi 100 ms, dhe të marrim një variant më të thjeshtë për riprodhimin e problemit, sesa testi i plotë në nivelin e rrjetit 7 në Vegeta. Këtu janë "pingjet" e nodit Kubernetes duke përdorur TCP SYN/SYN-ACK në "portin e nodit" të shërbimit (30927) me interval 10 ms, të filtruar sipas përgjigjeve më të ngadalta:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -S -p 30927 -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1485 win=29200 rtt=127.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1486 win=29200 rtt=117.0 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1487 win=29200 rtt=106.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1488 win=29200 rtt=104.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5024 win=29200 rtt=109.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5231 win=29200 rtt=109.2 ms
Menjëherë mund të bëjmë vërejtjen e parë. Nga numrat e rendit dhe kohët duket se këto nuk janë bllokime të vetme. Vonesa shpesh akumulohet dhe përfundimisht përpunohen.
Më pas, duam të zbulojmë se cilat komponente mund të jenë të përfshira në shfaqjen e bllokimit. Mund të jenë disa nga qindra rregullave të iptables në NAT? Apo ndonjë problem me tunelizimin IPIP në rrjet? Një nga mënyrat për ta kontrolluar këtë është të kontrolloni çdo hap të sistemit, duke e përjashtuar atë. Çfarë do të ndodhte nëse hiqnim NAT-in dhe logjikën e firewall-it, duke lënë vetëm pjesën IPIP:
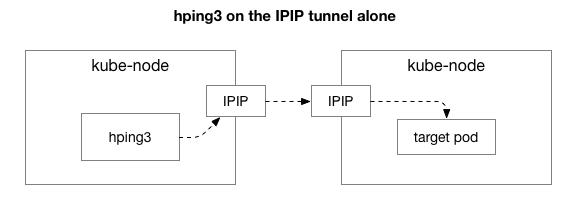
Fatmirësisht, Linux-i lejon që të adresohet lehtësisht drejtpërdrejt në nivelin IP të mbështjellësit, nëse makina është në të njëjtin rrjet:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7346 win=0 rtt=127.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7347 win=0 rtt=117.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7348 win=0 rtt=107.2 ms
Sipas rezultateve, problemi ende mbetet! Kjo përjashton iptables dhe NAT. Pra, problemi është në TCP? Le të shohim si shkon pingu i zakonshëm ICMP:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=28 ip=10.125.20.64 ttl=64 id=42594 icmp_seq=104 rtt=110.0 ms
len=28 ip=10.125.20.64 ttl=64 id=49448 icmp_seq=4022 rtt=141.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49449 icmp_seq=4023 rtt=131.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49450 icmp_seq=4024 rtt=121.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49451 icmp_seq=4025 rtt=111.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49452 icmp_seq=4026 rtt=101.1 ms
len=28 ip=10.125.20.64 ttl=64 id=50023 icmp_seq=4343 rtt=126.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50024 icmp_seq=4344 rtt=116.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50025 icmp_seq=4345 rtt=106.8 ms
len=28 ip=10.125.20.64 ttl=64 id=59727 icmp_seq=9836 rtt=106.1 ms
Rezultatet tregojnë se problemi nuk ka zhdukur. Ndoshta, kjo është një tunel IPIP? Le të thjeshtojmë testin:
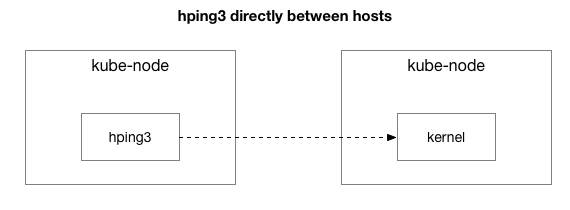
A ndodhin të gjitha paketat midis këtyre dy hosteve?
theojulienne@kube-node-client ~ $ sudo hping3 172.16.47.27 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 id=41127 icmp_seq=12564 rtt=140.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41128 icmp_seq=12565 rtt=130.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41129 icmp_seq=12566 rtt=120.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41130 icmp_seq=12567 rtt=110.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41131 icmp_seq=12568 rtt=100.7 ms
len=46 ip=172.16.47.27 ttl=61 id=9062 icmp_seq=31443 rtt=134.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9063 icmp_seq=31444 rtt=124.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9064 icmp_seq=31445 rtt=114.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9065 icmp_seq=31446 rtt=104.2 ms
Ne e kemi thjeshtuar situatën në dy node Kubernetes, duke dërguar ndonjë paketë, përfshirë pingu ICMP, njëri-tjetrit. Ata prapë shohin vonesë nëse hosti target është "i keq" (disa më keq se të tjerët).
Tani këtu është pyetja përfundimtare: pse ndodh vonesa vetëm në serverat kube-node? Dhe ndodh kur kube-node është dërguesi apo marrësi? Fatmirësisht, kjo është gjithashtu mjaft e lehtë për t'u zbuluar, duke dërguar një paketë nga një host jashtë Kubernetes, por me të njëjtin marrës "të njohur të keq". Siç e shohim, problemi nuk ka zhdukur:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=312 win=0 rtt=108.5 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=5903 win=0 rtt=119.4 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=6227 win=0 rtt=139.9 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=7929 win=0 rtt=131.2 ms
Pastaj, do të kryejmë të njëjtat kërkesa nga kube-node origjinal te hosti jashtë (çka përjashton hostin origjinal, pasi pingu përfshin si komponent RX, ashtu edhe TX):
theojulienne@kube-node-client ~ $ sudo hping3 172.16.33.44 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
 ^C
 --- 172.16.33.44 hping statistika ---
 22352 paketa të dërguara, 22350 paketa të marrë, 1% humbje paketi
 kohë e kthimit minimale/mesatare/maksimale = 0.2/7.6/1010.6 ms
Pas studimit të kapjeve të paketave me vonesë, morëm disa informacione të tjera. Në veçanti, dërguesi (në fund) sheh këtë vonesë, ndërsa marrësi (në krye) nuk e sheh – shihni kolonën Delta (në sekonda):
Për më tej, nëse e shqyrtojmë diferencën në rendin e paketave TCP dhe ICMP (sipër numrave të rendit) nga ana e marrësit, paketat ICMP gjithmonë arrijnë në të njëjtin rend siç u dërguan, por me ndëryshime të ndryshme. Në të njëjtën kohë, paketat TCP ndonjëherë alternohen dhe disa prej tyre ngecin. Në veçanti, nëse shqyrtojmë portet e pakove SYN, ato nga ana e dërguesit vijnë në radhë, ndërsa nga ana e marrësit jo.
Ka një ndryshim të vogël në atë se si e serverëve modernë (si në qendrën tonë të të dhënave) trajtojnë paketat që përmbajnë TCP ose ICMP. Kur një paketë arrin, adapti rrjetor "hashon atë sipas lidhjes", që do të thotë se përpiqet të ndajë lidhjet në radhë dhe të dërgojë çdo radhë në një bërthamë të veçantë të procesorit. Për TCP, ky hash përfshin si adresën IP burimore ashtu edhe adresën IP përfundimtare dhe portin. Me fjalë të tjera, çdo lidhje hash-ohet (potencialisht) ndryshe. Për ICMP, hashohen vetëm adresat IP, pasi nuk ka porte.
Një vëzhgim tjetër i ri: gjatë këtij periudhe ne shohim vonesa ICMP në të gjitha komunikimet midis dy hosteve, ndërsa për TCP nuk ka. Kjo na tregon se arsyeja, për siguri, lidhet me hashimin e radhëve RX: pothuajse me siguri bllokimi ndodh në përpunimin e pakove RX, jo në dërgimin e përgjigjeve.
Kjo e përjashton nga lista e mundësive dërgimin e pakove. Tani e dimë se problemi i përpunimit të pakove është nga ana e pranimit në disa serverë kube-node.
Po e shqyrtojmë përpunimin e pakove në bërthamën Linux
Për të kuptuar pse problemi ndodh tek marrësi në disa serverë kube-node, le të shikojmë se si bërthama Linux përpunon paketat.
Duke u kthyer tek e thjeshta zbatimi tradicional, karta rrjetë merr paketën dhe dërgon bërthamës Linux, që është një paketë që duhet përpunuar. Bërthama ndalon punën tjetër, kalon kontekstin te trajtuesi i ndërprerjeve, përpunon paketën dhe pastaj kthehet në detyrat aktuale.
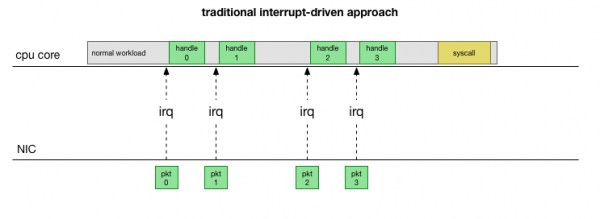
Kyçja e kontekstit ndodh ngadalë: ndoshta, vonesat ishin të padukshme në kartat rrjet 10-megabit në vitet '90, por në kartat moderne 10G me kapacitet maksimal prej 15 milion paketash në sekondë, çdo bërthamë e një serveri të vogël tetë-ndërpritet miliona herë në sekondë.
Për të mos u angazhuar vazhdimisht me përpunimin e ndërprerjeve, shumë vite më parë në Linux u shtua : një API rrjeti që përdorin të gjitha driverat modernë për të rritur performancën në shpejtësi të larta. Në shpejtësi të ulëta, bërthama ende merr ndërprerje nga karta rrjet në mënyrën e vjetër. Sapo të arrijë një numër domethënës paketash që tejkalon pragun, bërthama ndalon ndërprerjet dhe në vend të kësaj fillon të anketojë adapterin rrjet dhe të mbledhë paketat në grupe. Përpunimi bëhet në softirq, domethënë në pas thirrjeve sistemore dhe ndërprerjeve harduerike, kur bërthama (ndryshe nga hapësira e përdoruesit) tashmë është e lansuar.
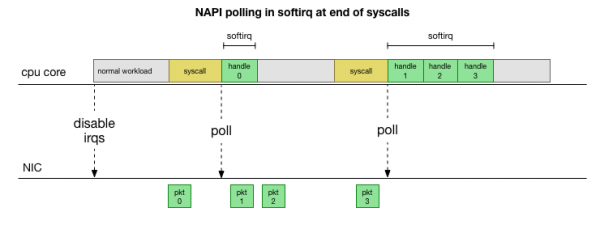
Kjo është shumë më e shpejtë, por sjell një problem tjetër. Nëse ka shumë paketa, tërë koha shkon për përpunimin e paketave nga karta rrjet, dhe proceset e hapësirës së përdoruesit nuk arrijnë të zbrazin në fakt këto radhë (leximi nga lidhjet TCP, etj.). Fundja, radhët mbushen, dhe ne fillojmë të hedhim paketa. Duke u munduar të gjejë një bilanc, bërthama vendos një buxhet për numrin maksimale të paketave që përpunohen në kontekstin e softirq. Sapo ky buxhet tejkalohet, zgjidhet një fije e veçantë ksoftirqd (do të shihni një nga ata në ps për secilën bërthamë), e cila përpunon këto softirq jashtë rrugës normale syscall/interruption. Kjo fije planifikohet me menaxherin e zakonshëm të proceseve, i cili përpiqet të ndajë burimet në mënyrë të ndershme.
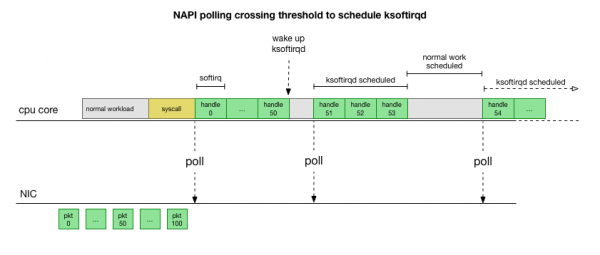
Duke studiuar se si bërthama përpunon paketat, mund të vërehet se ekziston një probabilitet i caktuar i krijimit të kolapsit. Nëse thirrjet softirq vijnë më rrallë, paketat do të duhet të presin pak për përpunimin në radhën RX në kartën rrjet. Ndoshta, kjo ndodh për shkak të ndonjë detyre që bllokon bërthamën e procesorit, ose diçka tjetër pengon bërthamën që të lansojë softirq.
Shtrojmë përpunimin në bërthama ose metoda
Përfundimet e softirq janë ende vetëm një supozim. Por kjo ka kuptim, dhe ne e dimë se diçka shumë e ngjashme po ndodh. Prandaj, hapi tjetër është të konfirmojmë këtë teori. Dhe nëse ajo konfirmohet, atëherë të gjejmë shkakun e vonesave.
Le të kthehemi te paketat tona të ngadalta:
len=46 ip=172.16.53.32 ttl=61 id=29573 icmp_seq=1953 rtt=99.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29574 icmp_seq=1954 rtt=89.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29575 icmp_seq=1955 rtt=79.2 ms
len=46 ip=172.16.53.32 ttl=61 id=29576 icmp_seq=1956 rtt=69.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29577 icmp_seq=1957 rtt=59.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29790 icmp_seq=2070 rtt=75.7 ms
len=46 ip=172.16.53.32 ttl=61 id=29791 icmp_seq=2071 rtt=65.6 ms
len=46 ip=172.16.53.32 ttl=61 id=29792 icmp_seq=2072 rtt=55.5 ms
Siç u diskutua më parë, këto paketa ICMP janë të hash-uar në një rradhe NIC RX dhe përpunohen nga një bërthamë CPU. Nëse duam të kuptojmë si funksionon Linux, është e dobishme të dimë se ku (në cilën bërthamë CPU) dhe si (softirq, ksoftirqd) përpunohen këto paketa, në mënyrë që të ndjekim procesin.
Tani është koha të përdorim mjetet që lejojnë ndjekjen në kohë reale të punës së bërthamës Linux. Këtu kemi përdorur . Ky set mjetesh lejon të shkruajmë programe të vogla në C, të cilat kapin funksione të rastit në bërthamë dhe buferizojnë ngjarjet në një program Python të hapësirës së përdoruesit, i cili mund t'i përpunojë dhe t'ju kthejë rezultatin. Këto këso funksionesh në bërthamë janë të komplikuara, por utiliteti është projektuar me maksimumin e sigurisë dhe është i destinuar për ndjekjen e problemeve prodhimore, të cilat nuk janë të lehta për t'u riprodhuar në një mjedis testi ose zhvillimi.
Plani këtu është i thjeshtë: ne e dimë se bërthama përpunon këto ping ICMP, prandaj do të ngremë një hook në funksionin e bërthamës , i cili pranon një paketë të ardhur ICMP "echo request" dhe iniciates një përgjigje ICMP "echo response". Ne mund të identifikojmë paketën nga rritja e numrit icmp_seq, i cili tregon hping3 më lart.
Kodi duket e komplikuar, por nuk është aq e frikshme sa duket. Funksioni icmp_echo kalon struct sk_buff *skb: kjo është paketa me kërkesën "echo request". Ne mund ta ndjekim atë, të nxjerrim sekuencën echo.sequence (e cila përputhet me icmp_seq nga hping3 më sipër), dhe ta dërgojmë atë në hapësirën e përdoruesit. Gjithashtu është e dobishme të kapim emrin aktual të procesit/id të identifikuesit. Më poshtë janë rezultatet që ne shohim drejtpërdrejt gjatë përpunimit të paketimeve nga bërthama:
TGID    PID     EMRI I PROCESIT    ICMP_SEQ
0       0       swapper/11      770
0       0       swapper/11      771
0       0       swapper/11      772
0       0       swapper/11      773
0       0       swapper/11      774
20041   20086   prometheus      775
0       0       swapper/11      776
0       0       swapper/11      777
0       0       swapper/11      778
4512    4542   spokes-report-s  779
Këtu duhet të theksohet se në kontekstin softirq proceset që bënë thirrje sistemore do të shfaqen si «procese», edhe pse realisht është bërthama që trajton sigurt paketat në kuadër të bërthamës.
Me këtë mjet, mund të vendosim një lidhje ndërmjet procesit të veçantë dhe paketave specifike që tregojnë vonesë në hping3. Të bëjmë një kapje të thjeshtë grep në këtë kapje për vlera të caktuara icmp_seq. Paketat që përputhen me vlerat e mësipërme të icmp_seq u shënuan së bashku me RTT që i vëzhguam më lartë (vlerat e pritura RTT të paketave që i filtruam për shkak të vlerave RTT më të vogla se 50 ms janë treguar në kllapa):
TGID    PID     EMRI I PROCESIT    ICMP_SEQ ** RTT
--
10137   10436   cadvisor        1951
10137   10436   cadvisor        1952
76      76      ksoftirqd/11    1953 ** 99ms
76      76      ksoftirqd/11    1954 ** 89ms
76      76      ksoftirqd/11    1955 ** 79ms
76      76      ksoftirqd/11    1956 ** 69ms
76      76      ksoftirqd/11    1957 ** 59ms
76      76      ksoftirqd/11    1958 ** (49ms)
76      76      ksoftirqd/11    1959 ** (39ms)
76      76      ksoftirqd/11    1960 ** (29ms)
76      76      ksoftirqd/11    1961 ** (19ms)
76      76      ksoftirqd/11    1962 ** (9ms)
--
10137   10436   cadvisor        2068
10137   10436   cadvisor        2069
76      76      ksoftirqd/11    2070 ** 75ms
76      76      ksoftirqd/11    2071 ** 65ms
76      76      ksoftirqd/11    2072 ** 55ms
76      76      ksoftirqd/11    2073 ** (45ms)
76      76      ksoftirqd/11    2074 ** (35ms)
76      76      ksoftirqd/11    2075 ** (25ms)
76      76      ksoftirqd/11    2076 ** (15ms)
76      76      ksoftirqd/11    2077 ** (5ms)
Rezultatet na tregojnë për disa gjëra. Së pari, të gjitha këto paketa trajtohen nga konteksti ksoftirqd/11. Kjo do të thotë se për këtë çift të caktuar të makinave paketat ICMP u hodhën në bërthamën 11 të palës marrëse. Shohim gjithashtu se në çdo ngarkesë ka paketa që trajtohen në kontekstin e thirrjes sistemore cadvisor. Pastaj ksoftirqd e merr përsipër këtë detyrë dhe përpunon radhën e mbledhur: pikërisht numri i paketave që është akumuluar pas cadvisor.
Fakti që para kësaj gjithmonë funksionon cadvisor, nënkupton përfshirjen e tij në problem. Për ironi, qëllimi është «të analizojë përdorimin e burimeve dhe karakteristikat e performancës së konteinerëve të aktivizuar», e jo të shkaktojë këtë problem me performancën.
Si me aspekte të tjera të funksionimit të kontejnerëve, ky është një mjet shumë avangard që mund të presim që të sjellë probleme me performancën në disa rrethana të papritura.
Çfarë bën cadvisor që ndalon radhën e paketave?
Tani kemi një kuptim të mirë se si ndodh dështimi, cili proces e shkakton dhe në cilin CPU. Shikojmë se për shkak të bllokimit të fortë, bërthamja Linux nuk arrin të planifikojë me kohë. ksoftirqd. Dhe shikojmë se paketat përpunohen në kontekstin cadvisor. Është logjike të supozojmë se cadvisor teknologjia e ngadaltë syscall, pas së cilës përpunohen të gjitha paketat e akumuluara gjatë atij kohe:
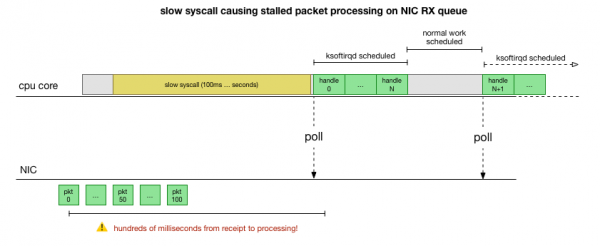
Kjo është një teori, por si ta verifikojmë? Ajo që mund të bëjmë është të ndjekim punën e bërthamës CPU gjatë gjithë këtij procesi, të gjejmë pikën ku ndodh tejkalimi i buxhetit për numrin e paketave dhe aktivizohet ksoftirqd, dhe pastaj të shikojmë pak më përpara - çfarë po funksiononte në bërthamën CPU pikërisht para këtij momenti. Kjo është si një rentgen i CPU çdo disa milisekonda. Ai do të duket kështu:
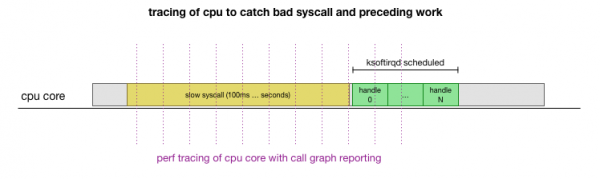
Është e këndshme se e gjithë kjo mund të bëhet me mjetet ekzistuese. Për shembull, me një periudhë të caktuar kontrollon një bërthamë të caktuar CPU dhe mund të gjenerojë një grafik të thirrjeve të sistemit në punë, duke përfshirë hapësirën e përdoruesit dhe bërthamën Linux. Mund ta marrim këtë regjistrim dhe ta procesojmë me një fork të vogël të programit nga Brendan Gregg, i cili ruan rendin e gjurmimeve të stack-ut. Ne mund të ruajmë gjurmimet e stack-ut një rresht çdo 1 ms, dhe pastaj të nxjerrim dhe ruajmë një mostër për 100 milisekonda përpara se të hyjë në gjurmim ksoftirqd:
# record 999 times a second, or every 1ms with some offset so not to align exactly with timers
 sudo perf record -C 11 -g -F 999
 # take that recording and make a simpler stack trace.
 sudo perf script 2>/dev/null | ./FlameGraph/stackcollapse-perf-ordered.pl | grep ksoftir -B 100
Ja rezultatet:
(qindra gjurmime që duken të ngjashme)
cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_iter cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;ixgbe_poll;ixgbe_clean_rx_irq;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;bond_handle_frame;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;ipip_tunnel_xmit;ip_tunnel_xmit;iptunnel_xmit;ip_local_out;dst_output;__ip_local_out;nf_hook_slow;nf_iterate;nf_conntrack_in;generic_packet;ipt_do_table;set_match_v4;ip_set_test;hash_net4_kadt;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;hash_net4_test ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;gro_cell_poll;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;dev_queue_xmit_nit;packet_rcv;tpacket_rcv;sch_direct_xmit;validate_xmit_skb_list;validate_xmit_skb;netif_skb_features;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;__dev_queue_xmit;dev_hard_start_xmit;__bpf_prog_run;__bpf_prog_run
Kaì shumë gjëra, por e rëndësishmja është se gjejmë modelin "cadvisor para ksoftirqd", i cili e kemi parë më parë në ndjekësin ICMP. Çfarë do të thotë kjo?
Çdo rresht është një ndjekje CPU në një moment të caktuar. Çdo thirrje në fund të stack-ut në rresht ndahet me një pikë dhe presje. Në mes të rreshtave shohim thirrjen e syscall: read(): .... ;do_syscall_64;sys_read; .... Në këtë mënyrë, cadvisor kalon shumë kohë në thirrjen sistemike read(), e lidhur me funksionet mem_cgroup_* (pjesa e sipërme e stack-ut të thirrjeve/fundi i rreshtit).
Në ndjekjen e thirrjeve, është e pakëndshme të shohësh se çfarë po lexohet, prandaj do të startojmë strace dhe do të shohim se çfarë bën cadvisor, dhe do të gjejmë thirrjet sistemike që zgjatin më shumë se 100 ms:
theojulienne@kube-node-bad ~ $ sudo strace -p 10137 -T -ff 2>&1 | egrep '<0.[1-9]'
 [pid 10436]  ) = 0
 [pid 10432]  ) = 0
 [pid 10137]  ) = 0
 [pid 10384]  ) = 0
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 658
 [pid 10384]  ) = 0
 [pid 10436]  ) = 0
 [pid 10436]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10427]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10411]  ) = 0
 [pid 10382]  ) = 0 (Timeout)
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 660
 [pid 10417]  ) = 0
 [pid 10436]  ) = 0
 [pid 10417]  ) = 0
 [pid 10417]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 576
Siç mund të pritej, këtu shohim thirrje të ngadalta read(). Nga përmbajtja e operacioneve të leximet dhe kontekstit mem_cgroup duket se këto thirrje read() i përkasin skedarit memory.stat, i cili tregon përdorimin e memories dhe kufizimet e cgroup (teknologjia e izolimit të resurseve në Docker). Instrumenti cadvisor pyet këtë skedar për të marrë informacione mbi përdorimin e resurseve për kontejnerët. Le të kontrollojmë, nëse bërthama ose cadvisor bën diçka të papritur:
theojulienne@kube-node-bad ~ $ time cat /sys/fs/cgroup/memory/memory.stat > /dev/null
real 0m0.153s
user 0m0.000s
sys 0m0.152s
theojulienne@kube-node-bad ~ $
Tani mund të riprodhojmë defektin dhe kuptojmë se bërthama Linux përballet me një patologji.
Pse është kaq e ngadaltë operacioni i leximit?
Në këtë pikë është shumë më e lehtë të gjeje mesazhe nga përdorues të tjerë për probleme të ngjashme. Siç duket, në tracker-in e cadvisor është raportuar për këtë defekt si , thjesht askush nuk e vuri re se vonesa gjithashtu reflektohet rastësisht në stekën e rrjetit. Në të vërtetë është vënë re se cadvisor konsumon më shumë kohë procesori sesa pritej, por nuk i është kushtuar rëndësi të madhe, pasi serverët tanë kanë shumë burime procesori, kështu që problemi nuk u hetua në detaje.
Problemi qëndron në faktin se grupet e kontrollit (cgroups) llogarisin përdorimin e memories brenda hapësirës emri (kontejnerit). Kur të gjitha proceset në këtë cgroup përfundojnë, Docker çliron grupin e kontrollit të memories. Megjithatë, "memoria" nuk është thjesht memoria e procesit. Edhe pse vetë memoria e proceseve nuk përdoret më, rezulton se bërthama akordon gjithashtu përmbajtje të cached, si dentries dhe inodes (metadata për dosjet dhe katalogët), të cilat cached në cgroup-in e memories. Nga përshkrimi i problemit:
cgroups-zombi: grupe kontrolli, në të cilat nuk ka procese dhe ato janë të fshira, por për të cilat ende është ndarë memoria (në rastin tim, nga cache dentry, por mund të ndahen gjithashtu nga cache faqesh ose tmpfs).
Kontrolli nga bërthama i të gjitha faqeve në cache gjatë çlirimit të cgroup mund të jetë shumë i ngadaltë, kështu që është zgjedhur një proces lenient: pritur për sa këto faqe të kërkohen përsëri, dhe vetëm atëherë, kur memoria vërtet kërkohet, së fundmi të pastrohet cgroup. Deri në atë moment, cgroup vazhdon të llogaritet gjatë mbledhjes së statistikave.
Nga këndvështrimi i performancës, ata sakrifikuan memorie për performancën: përshpejtimi i pastrimit fillestar përmes faktit që mbetet pak memorie e кешuar. Kjo është në rregull. Kur bërthama përdor pjesën e fundit të memories së кешuar, cgroup në fund pastrohet, kështu që nuk mund të quhet "ikje". Fatkeqësisht, realizimi specifik i mekanizmit të kërkimit memory.stat në këtë version bërthamë (4.9), së bashku me volumin e madh të memories në serverët tanë, çon në faktin se rikuperimi i të dhënave të fundit të кешuara dhe pastrimi i cgroup-zombie kërkon shumë më tepër kohë.
Ka rezultuar se në disa nga nodet tona kishte kaq shumë cgroup-zombie sa leximi dhe vonesa tejkaluan një sekondë.
Një mënyrë për të anashkaluar problemin cadvisor është të lirohet menjëherë cache-t e dentries/inodes në të gjithë sistemin, e cila menjëherë eliminojnë vonesën e leximit, si dhe vonesën rrjet në host, sepse largimi i cache përfshin faqe të кешuara cgroup-zombie, dhe ato gjithashtu lirohen. Kjo nuk është një zgjidhje, por konfirmon shkakun e problemit.
Ka rezultuar se në versionet më të reja të bërthamës (4.19+) është përmirësuar performanca e thirrjes memory.stat, kështu që kalimi në këtë bërthamë e eliminonte problemin. Po ashtu, kishim mjete për të zbuluar nodet problematike në klasterat Kubernetes, shkrirjen e tyre elegante dhe ripërsëritjen. Ne kontrolluam të gjithë klasterat, gjetëm nodet me vonesë të mjaftueshme të lartë dhe i rindërtuam ato. Kjo na dha kohë për të përditësuar sistemin operativ në serverat e tjerë.
Në përfundim
Për shkak se ky defekt ndalonte përpunimin e radhëve NIC RX për qindra milisekonda, ai njëkohësisht shkaktonte një vonesë të madhe në lidhjet e shkurtra dhe një vonesë në mes të lidhjeve, për shembull, mes kërkesave MySQL dhe paketave përgjigjëse.
Kuptimi dhe mbështetje e performancës së sistemeve më themelore, si Kubernetes, është thelbësore për besueshmërinë dhe shpejtësinë e të gjithë shërbimeve mbi bazën e tyre. Të gjitha sistemet që drejtohen përfitojnë nga përmirësimet e performancës së Kubernetes.
Burimi: habr.com
