

Sa më e ndërlikuar është sistemi, aq më shumë ai përfshihet me alerte të ndryshme. Dhe lind nevoja për të reaguar ndaj këtyre alerts, për t'i agreguar ato dhe për t'i vizualizuar. Mendoj, situatë e njohur për shumë njerëz deri në një tik nervor.
Zgjidhja që do të diskutojmë nuk është e papritur, por nuk gjen një artikull të plotë mbi këtë temë.
Prandaj, vendosa të ndaj përvojën e FunCorp dhe të flas për mënyrën se si është ndërtuar procesi i rojeve, kush telefonon, pse dhe si mund të shikohet gjithçka kjo.
Çfarë është PagerDuty?
Pra, për të zgjidhur të gjitha këto probleme, filluam të kërkojmë një mjet të rehatshëm. Pas pak kërkimesh, e zgjodhëm PagerDuty. PD na dukej si një zgjidhje mjaft e plotë dhe konçize me shumë integrime dhe cilësime. Çfarë është ajo?
Në shkurt, PagerDuty është një platformë për përpunimin e incidenteve, e cila mund të trajtojë incidente të ardhura përmes integrimeve të ndryshme, të konfiguronte radhën e rojave dhe më pas të përmbushte alarmin ndaj inxhinierit të roje në varësi të nivelit të incidentit (në nivel të lartë - telefonatë, në nivel të ulët - njoftim nga aplikacioni/sms).
Kush është roja?
Besoj, kjo është gjëja e parë me të cilën duhet të fillojmë konfigurimin e PD.
Në FunCorp, siç është në kompanitë e tjera, ka një pozitë nderi për rojën. Ajo kalon nga inxhinieri në inxhinier çdo ditë. Ka një linjë të parë dhe një të dytë të reagimit ndaj alarmeve nga PagerDuty. Supozoni se vjen një alarm me prioritet të lartë, dhe nëse pas 10 minutash pas telefonatës ndaj rojës nga linja e parë nuk ka reagim (dmth. nuk është kaluar në statusin e pranuar ose të zgjidhur), telefonata shkon te inxhinieri i dytë i rojes. Kjo është e konfigurueshme në vetë PagerDuty përmes Politika të Eskalimit.
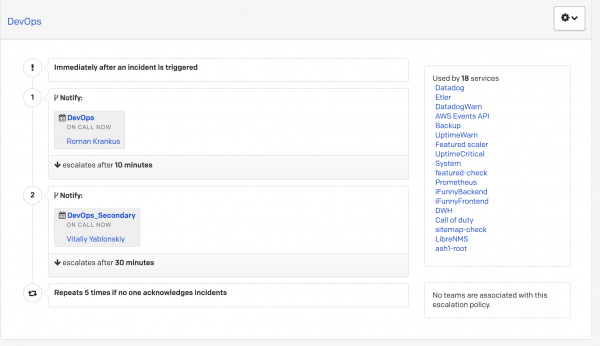
Nëse as roja e dytë nuk përgjigjet, njoftimi kthehet përsëri te roja kryesore. Kështu, çdo alarm i ardhur me prioritet të lartë nuk mund të mbetet pa u trajtuar.
Tani le të shohim nga mund të vijnë incidentet.
Cilat janë integrimet që përdorim?
Në PD, vijnë shumë incidente të ndryshme nga shërbime të ndryshme. Aktualisht, kemi rreth 25 shërbime të tillë, dhe për t'i përpunuar ato përdorim disa integrime të gatshme.
Në PD ndodhin shumë incidente të ndryshme nga shërbime të ndryshme. Tani kemi rreth 25 shërbime të tilla, dhe për t'i përpunuar ata përdorim disa integrime të gatshme.
- Prometheus
Sistemi kryesor për mbledhjen e të dhënave është Prometheus. Më shumë është shkruar për të në Habrë, unë vetëm do të them se kemi disa prej tyre për mjedise të ndryshme: një mbledh të dhënat nga virtualizimet dhe dockerat, një tjetër - nga shërbimet e Amazonit, dhe e treta - nga "makinat metalike". Në përgjithësi, Telegraf përdoret si eksportues i të dhënave.
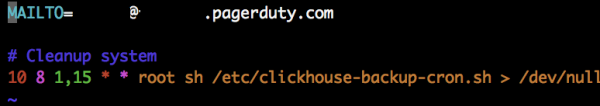
Edhe këtu, mendoj, gjithçka është e qartë nga emri. Ky integrim përdoret për të dërguar njoftime nga disa skripte që ekzekutohen përmes cron-it. PD ju jep një adresë, në të cilën dërgoni email-et. Kur krijoni një shërbim me një integrim të tillë, mund të configuroni prioritetet se në cilin rend do të përpunohen incidentet e ardhshme, siç do të krijohet alerthi (për çdo email që vjen, për email-in e ardhshëm + një rregull, etj.).
- Slack
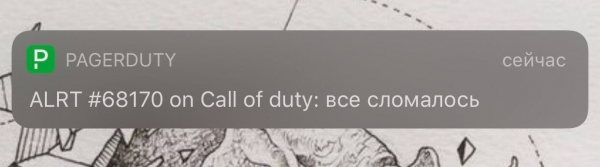
Në mendimin tim, një integrim shumë interesant. Ka raste kur ndodhin disa gjëra, por nuk mbulohen nga incidentet. Prandaj, ne shtuam një integrim nga Slack për krijimin e incidentit. Domethënë, në Slack-in korporativ mund të shkruani /callofduty все тормозит и скоро сломается dhe PD do ta përpunojë këtë dhe do t'i dërgojë incidentin inxhinierit të disponueshëm.
Po bëjmë:
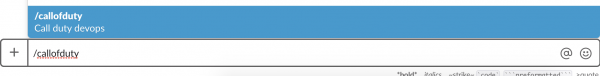
Po shohim:
- API
Integrimi përmes HTTP. Këtu, në të vërtetë, nuk ka asgjë interesante, thjesht është një POST-request me trupin në formatin JSON. Për shembull, nga të interesantat: ne e përdorim atë për monitorim të jashtëm me anë të . Ky shërbim kontrollon disponueshmërinë e faqeve tona nga pika të ndryshme të botës. Në rast se marrim një kod përgjigje të papranueshëm (p.sh., 502), krijohet një incident dhe më pas gjithçka shkon sipas zinxhirit të përshkruar më sipër. Në StatusCake ekziston mundësia për monitorimin e URL-ve të brendshme, skadimit të certifikatave SSL ose domenëve.
- LibreNMS
Kjo është një tjetër sistem monitorimi, për më tepër rreth saj mund të lexoni në faqen e tyre . Me të kemi realizuar monitorimin e ndërfaqeve rrjetore dhe iDRAC nga serverët.
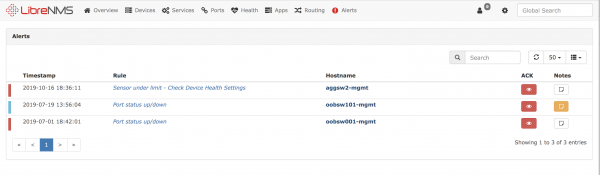
Janë pasur edhe integrime të tilla si Datadog, CloudWatch. Për më shumë rreth asaj se çfarë ndodhi me to, mund të shikoni .
Vizualizimi
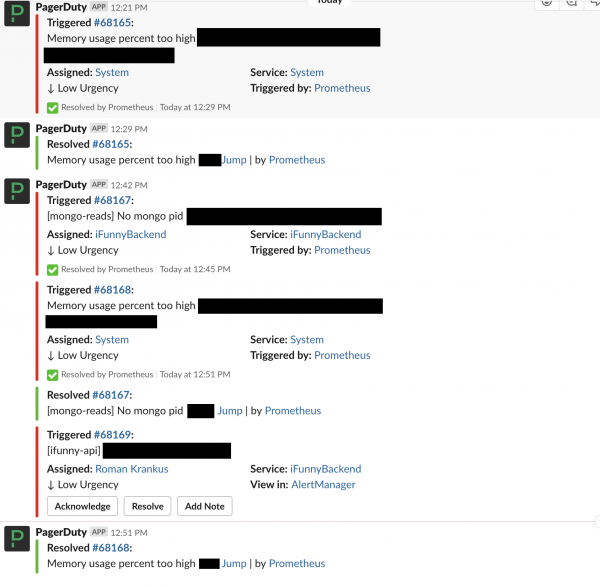
Sistemi kryesor i informacionit për incidentet është Slack. Në një chat të veçantë shkruhen të gjitha incidentet që arrijnë në PD, dhe nëse ndryshon statusi i tyre, kjo gjithashtu pasqyrohet në chat.
Kur u shfaq mundësia për të shfaqur të dhënat e dobishme në ekranet që varen nga tavani, papritmas kuptuam se ne (në departamentin devops) nuk kishim asgjë për t'i shfaqur atyre. Ka një Grafana të mrekullueshme, por ajo nuk mund të mbulojë gjithçka, dhe punonjësit reagojnë ndaj alerteve, jo ndaj grafikëve.
Pas një kërkimi të kujdesshëm, por pa sukses në GitHub për një 'board' të shkurtër dhe informuese për PD, ne vendosëm të krijojmë tonën - vetëm me atë që na nevojitet. Edhe pse fillimisht kishte ide për të shfaqur në ekran të gjithë ndërfaqen e PD, por kjo dukej edhe më e pamundur.
Për ta shkruar atë, mjafton të merrni një çelës nga PD me të drejta vetëm për lexim.
Dhe ja çfarë arritëm:
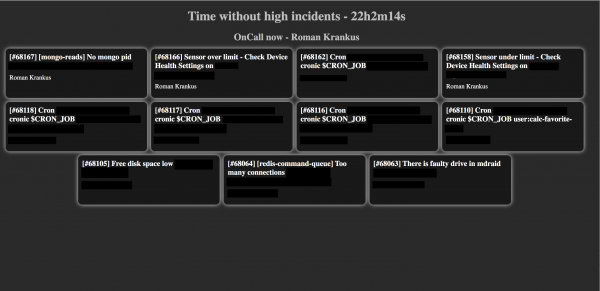
Në ekran shfaqen incidentet e hapura aktuale, emri i inxhinierit të shërbimit aktual nga orari i zgjedhur dhe koha pa incident me prioritet të lartë (panairi me incidentin me prioritet të lartë do të shfaqet me ngjyrë të kuqe).
.
Në fund, morëm një dashboard të përshtatshëm për të parë të gjithë incidentet tona. Do të isha i lumtur nëse ndihma jonë do t'i shërbejë dikujt nga ju.
Burimi: habr.com
