

Qëllimi kryesor i Patroni-s është të sigurojë Disponueshmëri të Lartë për PostgreSQL. Por Patroni është vetëm një template, dhe jo një mjet gati i gatshëm (çka gjithashtu është e shkruar në dokumentacion). Në shikim të parë, duke e konfiguruar Patroni-n në një laborator testimi, mund të shikoni se sa mjet i shkëlqyer është dhe si e trajton lehtësisht përpjekjet tona për të prishur klusterin. Megjithatë, në praktikë në një ambient prodhimi, gjithmonë gjërat nuk ndodhin kaq bukur dhe elegante si në laboratorin testues.
Do të flas pak për veten time. Kam filluar si administrator sistemi. Kam punuar në zhvillimin e websajteve. Që nga viti 2014, punoj në Data Egret. Kompania merret me konsulencë në fushën e Postgres. Ne angazhohemi pikërisht me Postgres dhe çdo ditë punojmë me Postgres, kështu që kemi ekspertizë të ndryshme të lidhur me operimin.
Dhe në fund të vitit 2018, filluam ngadalë të përdorim Patroni. Dhe krijuam një përvojë të caktuar. Ne siç e diagnostikojmë, e optimizojmë, arritëm në praktikat tona më të mira. dhe në këtë prezantim do të flas për to.
Përveç Postgres, unë e dua Linux-in. Më pëlqen të eksperimentoj dhe të bëj kërkime në të, kam pasion për ndërtimin e bërthamave. Më pëlqen virtualizimi, kontejnerët, Docker, Kubernetes. Më intereson gjithçka, sepse ndikojnë zakonët e vjetra të administratorëve. Më pëlqen të merrem me monitorimet. Dhe më pëlqejnë gjërat e Postgre-s që lidhen me administrimin, pra, replikimi, kopjimi rezervë. Dhe në kohën e lirë shkruaj në Go. Nuk jam programues, vetëm për vete shkruaj në Go. Dhe më sjell kënaqësi.
- Mendoj se shumë prej jush e dinë se në Postgres nuk ka HA (Disponueshmëri e Lartë) nga kutia. Për të marrë HA, duhet të vendosni diçka, ta konfigurojeni, të investoni përpjekje dhe ta merrni atë.
- Ka disa mjete dhe Patroni është një nga ato që zgjidh HA mjaft mirë. Por duke e instaluar këtë në laboratorin testues dhe duke e nisur, mund të shikojmë që gjithçka funksionon, mund të riprodhojmë disa probleme, të shohim si i trajton ato Patroni. Dhe do të shohim se gjithçka funksionon mrekullisht.
- Por në praktikë përballeshim me probleme të ndryshme. Dhe mbi këto probleme do të flas.
- Do të tregoj si i kemi diagnostikuar, çfarë kemi ajustuar – na ndihmoi apo jo.
- Nuk do të flas për mënyrën e instalimit të Patroni, sepse mund ta gjejësh lehtësisht në internet, mund të shikosh skedarët e konfigurimit për të kuptuar se si fillon dhe si konfigurrohet gjithçka. Mund të kuptosh skemat, arkitekturën duke gjetur informacion rreth tyre në internet.
- Nuk do të flas për përvojën e të tjerëve. Do të flas vetëm për problemet me të cilat u përballëm ne.
- Dhe nuk do të flas për problemet që janë jashtë Patroni dhe PostgreSQL. Nëse, për shembull, problemet e lidhura me balancimin, kur klasteri ynë u prish, nuk do të flas për këtë.
Dhe një disclaimër të vogël para se të fillojmë leksionin tonë.
Të gjitha këto probleme me të cilat përballeshim ndodhën në gjashtë-mujorin e parë të përdorimit. Me kalimin e kohës arritëm në praktikat tona më të mira. Dhe problemet na u zhdukën. Prandaj, ky tregim u paralajmërua rreth gjashtë muaj më parë, kur gjithçka ishte ende e freskët në mendje dhe unë e mbaja mend si duhet.
Në përgatitjen e leksionit, unë rishtazi rishikoja postmortemët e vjetra dhe shikoja logët. Disa detaje mund të jenë harruar, ose disa detaje mund të mos kenë qenë të hulumtuara plotësisht gjatë analizës së problemeve, prandaj në disa momente mund të duket se problemet nuk janë shqyrtuar plotësisht, ose ka një mangësi të informacionit. Prandaj ju kërkoj ndjesë për këtë moment.
Çfarë është Patroni?
- Është një model për ndërtimin e HA. Kështu është shkruar në dokumentacion. Dhe nga këndvështrimi im, kjo është një saktësim shumë i duhur. Patroni nuk është një plumb argjendi që do të zgjidhë të gjitha problemet tuaja, domethënë, nevojitet një përpjekje për ta bërë që të funksionojë dhe të sjellë dobi.
- Është një shërbim agjent që instalohet në çdo shërbim me bazë të dhënash, dhe që është një lloj sistemi init për PostgreSQL tuaj. Ai nis PostgreSQL, e ndalon, e ribën në punë, ndryshon konfigurimin dhe ndryshon topologjinë e klasterit tuaj.
- Për pasojë, për të ruajtur gjendjen e klasterit, përfaqësimin e tij aktual, si duket, nevojitet një depo. Dhe nga ky këndvështrim, Patroni zgjodhi rrugën e ruajtjes së gjendjes në një sistem të jashtëm. Ky është një sistem i ruajtjes së konfigurimeve të shpërndara. Kjo mund të jetë Etcd, Consul, ZooKeeper, ose Etcd i kubernetes, dmth, ndonjë nga këto mundësi.
- Një nga karakteristikat e Patroni është se auto-failover e merrni direkt nga kutia, duke e konfiguruar atë. Në krahasim me Repmgr, failover vjen si paketë. Me Repmgr marrim switchover, por nëse duam auto-failover, duhet ta konfigurojmë atë përveç. Në Patroni, auto-failover është i pranishëm nga kutia.
- Ka shumë gjëra të tjera gjithashtu. Për shembull, menaxhimi i konfigurimeve, shtimi i replikave të reja, backup-et, etj. Por këto janë jashtë këtij raporti, dhe nuk do të flas për to.
Një përmbledhje e vogël është se detyra kryesore e Patroni është të realizojë auto-failover në një mënyrë të besueshme, duke siguruar që klasteri ynë të mbetet funksional dhe aplikacioni të mos vërejë ndryshimet në topologjinë e klasterit.
Por kur fillojmë të përdorim Patroni, sistemi ynë bëhet pak më kompleks. Një herë e një kohë kemi pasur Postgres, ndërsa me përdorimin e Patroni marrim Patronin vetë, marrim DCS, ku ruhet gjendja. Dhe gjithçka duhet të funksionojë siç duhet. Për këtë, çfarë mund të dështojë?
Mund të dështojë:
- Mund të dështojë Postgres. Mund të jetë master ose replikë, ndonjëra prej tyre mund të dalë jashtë funksionit.
- Mund të dështojë vetë Patroni.
- Mund të dështojë DCS, ku ruhet gjendja.
- Dhe mund të dështojë rrjeti.
Të gjitha këto çështje do t'i shqyrtoj në raport.
Do të shqyrtoj rastet sipas kompleksitetit të tyre, jo nga këndvështrimi se çfarë rasti përfshin shumë komponente. Por nga këndvështrimi i ndjenjave subjektive, se ky rast ishte i komplikuar për mua, ishte e vështirë ta analizoja... dhe përkundrazi, ndonjë rast ishte i lehtë dhe ishte e lehtë ta analizoja.
Rasti i parë është më i thjeshtë. Është ai rast kur morëm një klaster të bazave të të dhënave dhe në të njëjtin klaster çelëm ruajtjen tonë DCS. Kjo është një gabim shumë i zakonshëm. Është një gabim në ndërtimin e arkitekturave, pra kombinimi i komponentëve të ndryshëm në një vend.
Pra, ndodhi një failover, le të shohim çfarë ndodhi.
Dhe këtu na intereson momenti kur ndodhi failover. Pra, na intereson ky moment i kohës, kur u ndryshua gjendja e klasterit.
Por failover-i nuk është gjithmonë momental, pra nuk zë një njësi kohe, ai mund të zgjatet. Ai mund të jetë i gjatë në kohë.
Prandaj, ai ka kohën e fillimit dhe kohën e përfundimit, dmth, është një ngjarje, e vazhdueshme. Dhe ne i ndajmë të gjitha ngjarjet në tre intervale: kemi kohën para dështimit, gjatë dështimit dhe pas dështimit. Pra, ne shqyrtojmë të gjitha ngjarjet në këtë shkallë kohore.
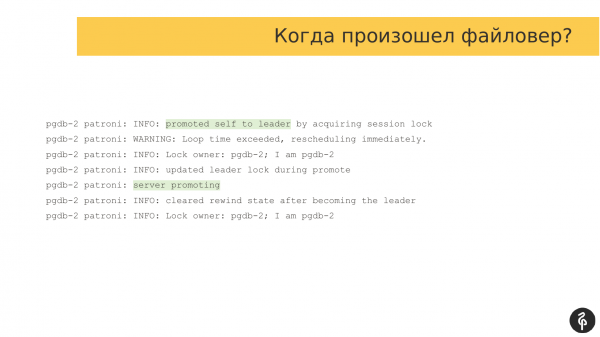
Dhe e para gjë, kur ndodhi dështimi, ne kërkojmë shkakun, çfarë ndodhi, çfarë e shkaktoi dështimin.
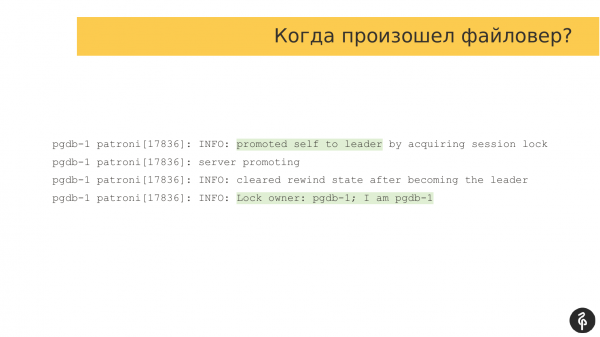
Nëse shikojmë logjet, ato do të jenë logjet klasike të Patroni. Ai na njofton atje se serveri u bë master dhe roli i masterit kaloi në këtë nyje. Këtu është e shënuar.
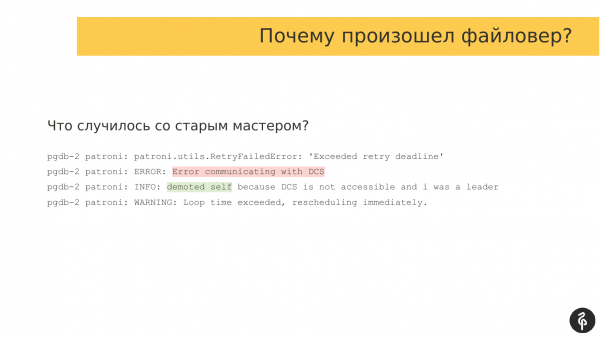
Më pas, ne duhet të kuptojmë pse ndodhi dështimi, dmth, cilat ndodhi që e detyruan rolin e masterit të kalonte nga një nyje në një tjetër. Dhe në këtë rast, gjithçka është e thjeshtë. Kemi një gabim në ndërveprimin me sistemin e ruajtjes. Masteri e kuptoi se nuk mund të punonte me DCS, dmth, ndodhi një problem në ndërveprim. Dhe ai thotë se nuk mund të jetë më master dhe heq dorë nga autorizimet. Kjo rresht «demoted self» flet saktësisht për këtë.
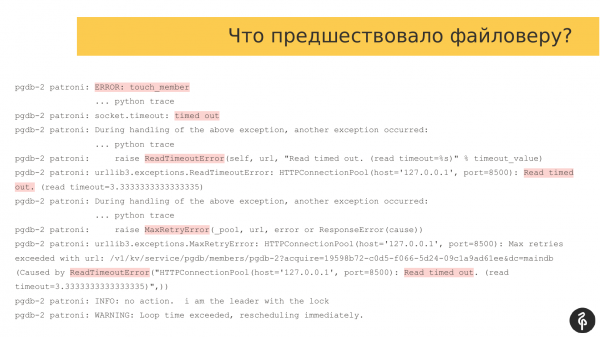
Nëse shohim ngjarjet që i paraprinë dështimit, ne mund të shohim ato shkakton që ishin problemet për vazhdimin e punës së masterit.
Nëse shohim logjet e Patroni, do të shohim se kemi një shumëllojshmëri gabimesh, kohëzgjatjesh, dmth, agjenti Patroni nuk mund të punonte me DCS. Në këtë rast, kjo është agjenti Consul, me të cilin komunikimi bëhet përmes portit 8500.
Dhe problemi këtu është se Patroni dhe baza e të dhënave janë të nisura në të njëjtin host. Dhe në këtë nyje janë nisur serverët Consul. Duke krijuar ngarkesë në server, ne krijuam probleme edhe për serverësh Consul. Ata nuk arritën të komunikojnë normalisht.
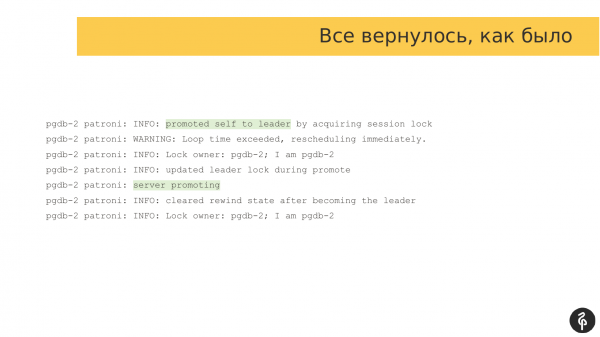
Pas disa kohësh, kur ngarkesa u ul, Patroni ynë mundi sërish të komunikonte me agjentët. Puna normale rifilloi. Dhe i njëjti server Pgdb-2 u bë sërish master. DMTH, kishte një flip të vogël, për shkakun e të cilit nyja hoqi dorë nga autorizimet e masterit dhe më pas i mori sërish, dmth, gjithçka u kthye siç ishte.
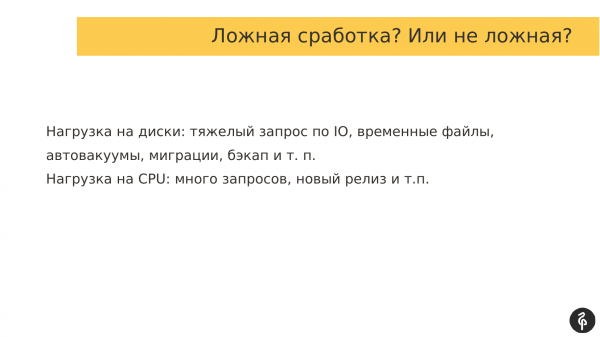
Dhe kjo mund të interpretohet si një aktivizim të rremë, ose mund të interpretohet si Patroni bëri gjithçka siç duhet. DMTH, ai e kuptoi se nuk mund të mbante gjendjen e klasterit dhe hoqi dorë nga autorizimet.
Dhe këtu çështja erdhi për shkak se serverat Consul ndodhen në të njëjtin ekip me bazat. Së fundi, çdo ngarkesë: qoftë ngarkesë në disqe ose procesorë, gjithashtu ndikon në ndërveprimin me klasterin Consul.
Dhe ne vendosëm se kjo nuk duhet të jetojë bashkë, ne dedikuam një klaster të veçantë për Consul. Dhe Patroni tashmë punonte me një Consul të veçantë, dmth, kishte një klaster Postgres të veçantë, një klaster Consul të veçantë. Kjo është një udhëzim bazë se si duhet të ndajmë dhe mbajmë këto gjëra që të mos jetojnë bashkë.
Si një mundësi, mund të rregullojmë parametrat ttl, loop_wait, retry_timeout, dmth. të përpiqemi që duke rritur këto parametra të kalojmë këto pikëngarkesash të përkohshme. Por kjo nuk është opsioni më i përshtatshëm, sepse kjo ngarkesë mund të jetë e vazhdueshme me kohë. Dhe thjesht do të dalim përtej këtyre kufijve të parametrave. Dhe kjo mund të mos ndihmojë aq shumë.
Problemi i parë, siç e kuptuat, është i thjeshtë. Ne morëm dhe DCS e vendosëm me bazën, dhe morëm një problem.
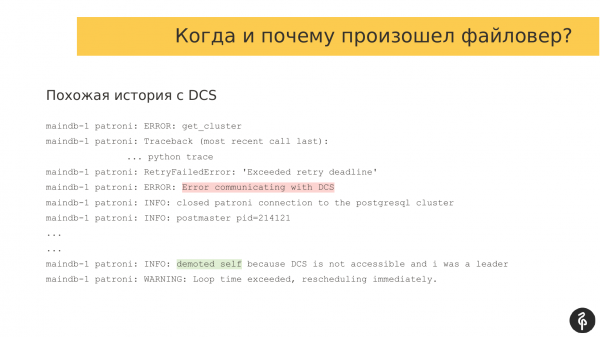
Problemi i dytë është i ngjashëm me të parin. Ai është i ngjashëm sepse kemi sërish probleme me ndërveprimin me sistemin DCS.
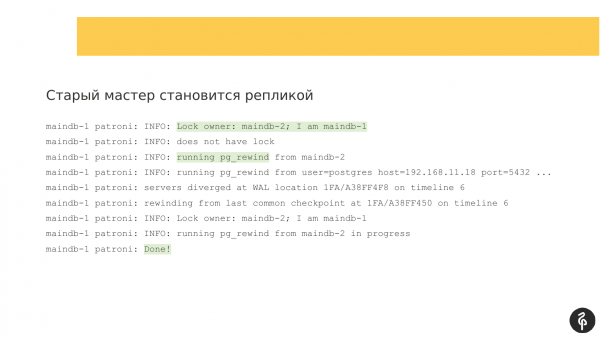
Nëse shohim logët, do të shohim se sërish kemi gabime komunikimi. Dhe Patroni thotë se nuk mund të ndërveprojë me DCS, prandaj masteri aktual kalon në modin e replikës.
Masteri i vjetër bëhet replikë, këtu Patroni vepron siç duhet. Ai nis pg_rewind për të kthyer regjistrin e transaksioneve dhe më pas të lidhet me masterin e ri, dhe pastaj të arrijë masterin e ri. Këtu Patroni vepron ashtu siç duhet.
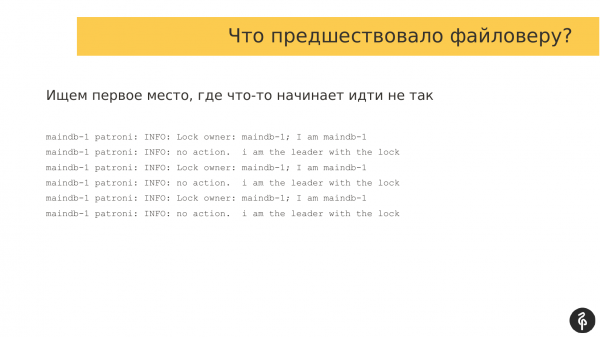
Këtu duhet të gjejmë vendin që i parapriu fileserver-it, dmth. ato gabime që shërbyen si shkak se përse ndodhi fileserver-i. Dhe në këtë kontekst, punuar me logët e Patronit është mjaft e lehtë. Ai shkruan mesazhe të njëjta me një interval të caktuar. Dhe nëse fillojmë të rrotullojmë shpejt këto log-e, do të shohim se logët janë ndryshuar, që do të thotë se kanë filluar disa probleme. Kthehemi shpejt në këtë vend, shikojmë se çfarë ndodh.
Dhe në një situatë normale, logët duket më shumë kështu. Kontrollohet pronari i bllokimit. Dhe nëse pronari, për shembull, është ndryshuar, mund të ndodhin disa ngjarje, për të cilat Patroni duhet të reagojë. Por në këtë rast, gjithçka është në rregull. Ne kërkojmë vendin kur filluan gabimet.
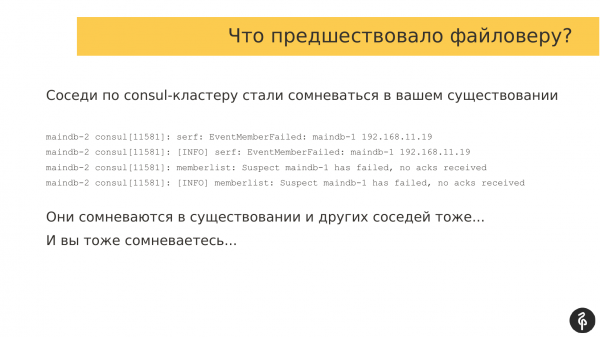
Dhe duke shkuar deri në atë pikë ku filluan të shfaqeshin gabimet, ne shohim se ndodhi një auto-failover. Dhe për shkak se gabimet tona ishin të lidhura me ndërveprimin me DCS dhe në rastin tonë ne përdorëm Consul, ne gjithashtu shohim në log-et e Consul, se çfarë ndodhi atje.
Duke përputhur më afër kohën e failover-it dhe kohën në log-et e Consul, ne shohim se fqinjët tanë në klasterin Consul filluan të dyshojnë për ekzistencën e anëtarëve të tjerë të klasterit Consul.
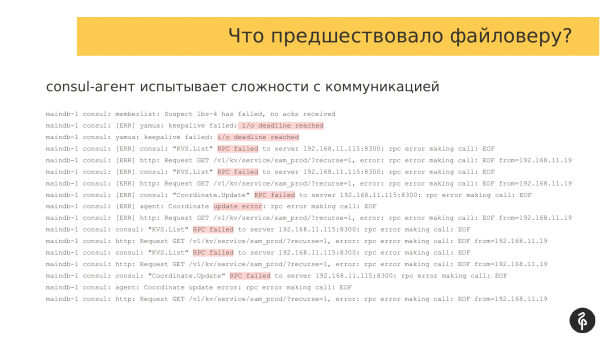
Dhe nëse shohim log-et e agjentëve të tjerë të Consul, gjithashtu duket se po ndodh një kolaps rrjetesh. Të gjithë anëtarët e klasterit Consul dyshojnë për ekzistencën e njëri-tjetrit. Dhe kjo ishte një nxitje për failover-in.
Nëse shohim se çfarë ndodhi para këtyre gabimeve, mund të shohim se ka gjithfarë gabimesh, për shembull, deadlinë, RPC falled, pra, duket qartë se ka një problem të dukshëm në ndërveprimin e anëtarëve të klasterit Consul me njëri-tjetrin.
Përgjigjja më e lehtë është të rregullojmë rrjetin. Por për mua, duke qëndruar në tribunë, është e lehtë të deklaroj këtë. Por rrethanat janë të tilla që nuk gjithmonë klienti mund të lejojë të rregullojë rrjetin. Ai mund të jetë në DC dhe mund të mos ketë mundësi të rregullojë rrjetin, të ndikojë në pajisjet. Dhe prandaj ne kemi nevojë për disa mundësi të tjera.
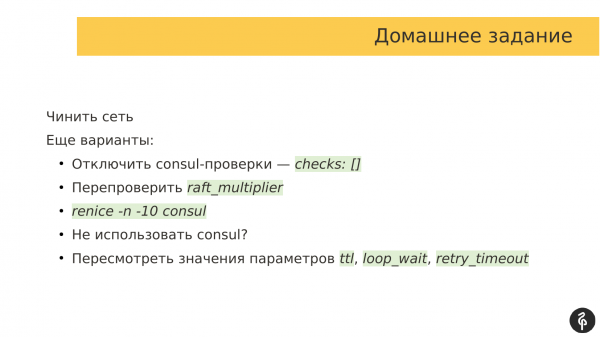
Mundësitë janë:
- Mundësia më e thjeshtë, e cila është shkruar, mendoj, madje edhe në dokumentacion, është të çaktivizosh kontrollimet e Consul, pra thjesht të kalosh një masiv të zbrazët. Dhe ne i themi agjentit të Consul-it të mos përdorë asnjë kontrollim. Nëpërmjet këtyre kontrollimeve ne mund të injorojmë këto stuhi rrjetesh dhe të mos inicijojmë një failover.
- Mundësia tjetër është të rishikoni raft_multiplier. Ky është një parametër i vetë serverit të Consul. Në mënyrë që ai të jetë në një vlerë prej 5. Kjo vlerë rekomandohet sipas dokumentacionit për mjediset staging. Në thelb, kjo ndikon në frekuencën e shkëmbimit të mesazheve midis anëtarëve të rrjetit Consul. Në thelb, ky parametër ndikon në shpejtësinë e komunikimit të shërbimit midis anëtarëve të klasterit Consul. Dhe për prodhim tashmë rekomandohet ta ulet këtë që nyjat të komunikojnë më shpesh.
- Një opsion tjetër që kemi filluar të përdorim është rritja e përparësisë së proceseve Consul midis proceseve të tjera për planifikuesin e proceseve të sistemit operativ. Ekziston një parametr «nice», i cili përcakton saktësisht përparësinë e proceseve që merret parasysh nga planifikuesi i OS gjatë planifikimit. Ne e kemi ulur vlerën e nice për agjentët e Consul, dmth. e rritëm përparësinë, në mënyrë që sistemi operativ t'u japë proceseve Consul më shumë kohë për të punuar dhe për të ekzekutuar kodin e tyre. Në rastin tonë, kjo e zgjidhi problemin tonë.
- Një opsion tjetër është të mos përdorim Consul. Kam një mik që është një mbështetës i madh i Etcd. Dhe ne diskutojmë rregullisht se çfarë është më mirë, Etcd apo Consul. Por në lidhje me atë që është më e mira, ne zakonisht pajtohemi se Consul ka një agjent që duhet të jetë i aktivizuar në çdo nyje me bazën e të dhënave. Kështu, ndërveprimi i Patroni me klasterin Consul kalon përmes këtij agjenti. Dhe ky agjent bëhet pika kritike. Nëse ndodhi diçka me agjentin, atëherë Patroni nuk mund të punojë më me klasterin Consul. Dhe kjo është një problem. Në rastin e Etcd, nuk ka asnjë agjent. Patroni mund të punojë drejtpërdrejt me listën e serverëve Etcd dhe të komunikoj me ta. Në këtë aspekt, nëse përdorni Etcd në kompaninë tuaj, atëherë ndoshta Etcd do të ishte zgjedhja më e mirë se Consul. Por ne te klientët tanë jemi gjithmonë të kufizuar nga ajo që ka zgjedhur dhe po përdor klienti. Dhe në shumicën e rasteve, Consul është te të gjitha klientët.
- Dhe pika e fundit është rishikimi i vlerave të parametrave. Ne mund t'i rrisim këto parametra në një nivel më të lartë në shpresë se problemet tona të momentit në rrjet do të jenë të shkurtra dhe nuk do të bien brenda intervalit të këtyre parametrave. Kështu, ne mund të reduktojmë agresivitetin e Patroni në realizimin e autoshkarkimeve, nëse ndodhin disa probleme në rrjet.
Mendoj se shumë ata që përdorin Patroni janë të njohur me këtë komandë.
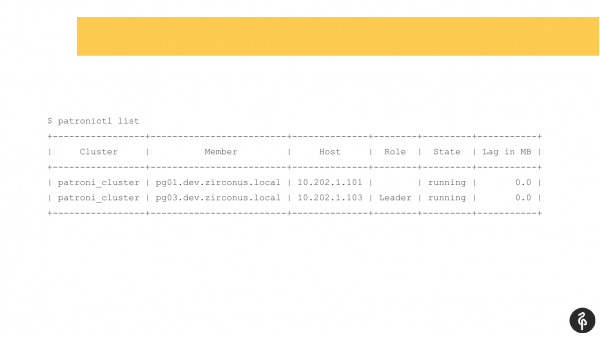
Kjo komandë tregon gjendjen aktuale të klasterit. Dhe me sa duket, kjo pamje mund të duket normale. Ne kemi një master, kemi një replikë, nuk ka as një vonesë në replikim. Por kjo pamje është normale deri në atë moment kur nuk e dimë se në këtë klaster duhen të jenë tre nyje, e jo dy.
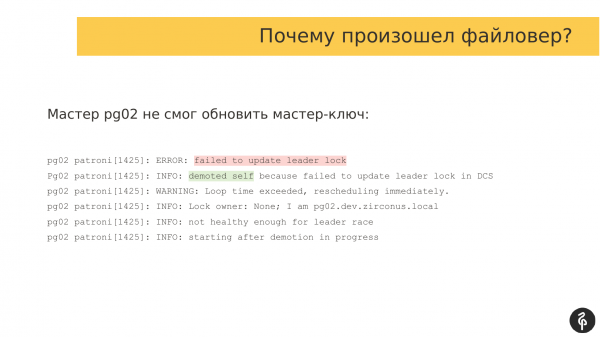
Si përfundim, ka ndodhur një autofailover. Dhe pas këtij autofailoveri, na ka humbur një replika. Duhet të kuptojmë pse ndodhi kjo dhe ta rikuperojmë atë. Përsëri shikojmë logët dhe shohim pse ndodhi autofailoveri.
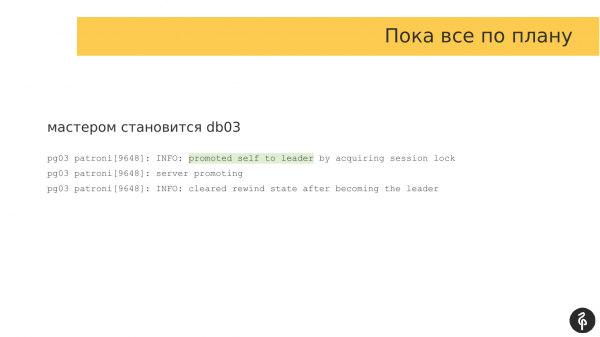
Në këtë rast, replica e dytë u bë master. Këtu gjithçka është në rregull.
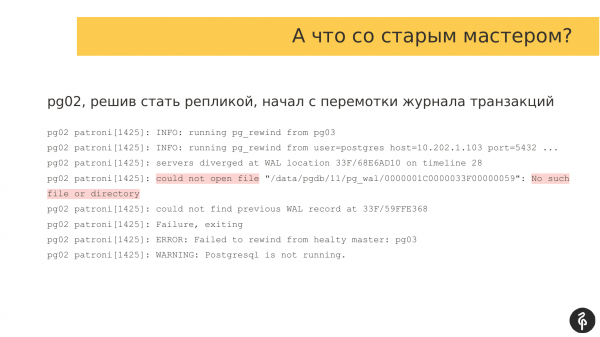
Dhe duhet të shohim për replikën që ka humbur dhe nuk është në klaster. Hapim logët e Patroni dhe shohim se çfarë ka ndodhur gjatë përpjekjes për t'u lidhur me klasterin, kishte një problem në fazën e pg_rewind. Për t'u lidhur me klasterin, duhet të rikthejmë regjistrin e transaksioneve, të kërkojmë regjistrin e nevojshëm nga masteri dhe për atë të arrijmë masterin.
Në këtë rast nuk kemi regjistrin e transaksioneve dhe replika nuk mund të startohet. Si rrjedhojë, ndalojmë Postgres me një gabim. Prandaj, ajo nuk është në klaster.
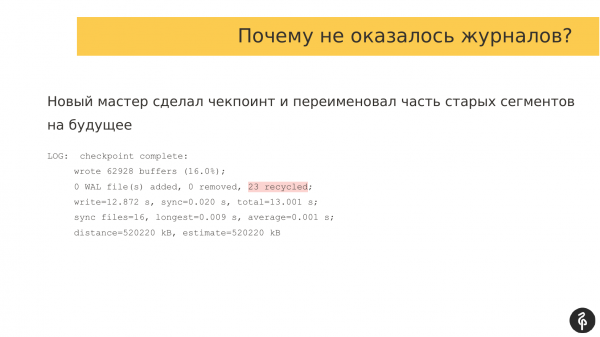
Duhet të kuptojmë pse ajo nuk është në klaster dhe pse nuk kishte logë. Shkojmë te masteri i ri dhe shohim çfarë ka në logët e tij. Dhe rezulton se kur u bë pg_rewind ka ndodhur një checkpoint. Dhe një pjesë e regjistrave të vjetër të transaksioneve u riemëruan. Kur masteri i vjetër përpiqej të lidhej me masterin e ri dhe kërkonte këto logë, ato tashmë ishin riemëruar dhe thjesht nuk ekzistonin.
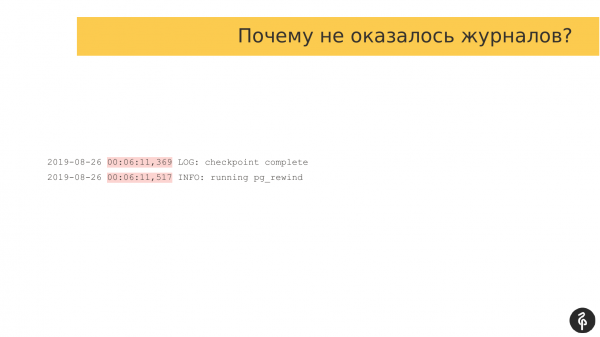
Krahasova timestamp-et kur ndodhën këto ngjarje. Dhe dallimi ishte vetëm 150 milisekonda, pra, në 369 milisekonda përfundoi checkpoint-i, dhe seksionet WAL u riemëruan. Dhe vetëm 517 milisekondash pas 150 milisekondave rifilloi rewind në replikën e vjetër. Pra, realisht 150 milisekonda ishin të mjaftueshme për të parandalur replikën që të lidhej dhe të punonte.
Cilat janë opsionet?
Fillimisht kemi përdorur slotet e replikimit. Na dukej se ishte mirë. Megjithatë, në fazën e parë të operimit i ndaluam slotet. Na dukej se nëse slotet do të grumbullonin shumë seksione WAL, mund të rrezikonim masterin. Ai do të bie. Pas një kohe pa slot, kuptuam se na duheshin slotet dhe i rikthyer.
Por këtu ka një problem, që kur ngelësi kalon në kopje, ai fshin slotet dhe së bashku me slotet fshin segmentet WAL. Dhe për të shmangur shfaqjen e këtij problemi, ne vendosëm të rrisim parametrin wal_keep_segments. Ai fillimisht është 8 segmente. Ne e rritëm në 1,000 dhe shikuan sa hapësirë kishte në dispozicion. Dhe ne i dhamë 16 gigabajt për wal_keep_segments. Pra, gjatë kalimit, ne gjithmonë kemi një rezervë prej 16 gigabajtësh të regjistrimeve të transaksioneve në të gjitha nyjat.
Dhe plus – kjo është gjithashtu e rëndësishme për detyrat e zgjatura të mirëmbajtjes. Le të themi se na nevojitet të përditësojmë një nga replikat. Dhe duam ta ndalim atë. Duhet të përditësojmë softuerin, ndoshta sistemin operativ, diçka tjetër. Dhe kur ndalim replikën, për këtë replikë fshihet gjithashtu sloti. Dhe nëse përdorim një wal_keep_segments të vogël, atëherë gjatë mungesës së zgjatur të replikës, regjistrimet e transaksioneve do të humbin. Ne do ta rishikojmë replikën, ajo do të kërkojë ato regjistrime transaksionesh, ku ishte ndalur, por në ngelës ato mund të mos jenë. Dhe replika nuk do të mund të lidhë. Prandaj, mbajmë një rezervë të madhe të regjistrimeve.
Kemi një bazë prodhimi. Aty tashmë funksionojnë projekte.
Ka ndodhur një dështim i skedarëve. Hymë dhe shikuan – çdo gjë është në rregull, replikat janë në vend, nuk ka vonesë në replikim. Po ashtu, nuk ka gabime në regjistrat, çdo gjë është në rregull.
Ekipa produkti thotë se duket se duhet të ketë ndonjë të dhënë, por ne i shohim ato në një burim të vetëm, ndërsa në bazë ne nuk i shohim. Dhe duhet të kuptojmë çfarë ndodhi me to.
E qartë, pg_rewind i ka fshirë ato. Ne e kuptuam menjëherë këtë, por shkuam për të parë çfarë ndodhi.
Në loge gjithmonë mund të gjejmë, kur ka ndodhur dështimi i skedarëve, kush u bë ngelësi dhe mund të përcaktojmë kush ishte ngelësi i vjetër dhe kur ai vendosi të bëhej kopje, pra na duhen këto loge, për të zbuluar sasinë e regjistrimeve të transaksioneve që janë humbur.
Ngeli ynë i vjetër u rinovua. Dhe në autostart ishte shpallur Patroni. Patroni u aktivizua. Ai më pas aktivizoi Postgres. Me saktësi, përpara aktivizimit të Postgres-it dhe para se ta bënte atë të replikës, Patroni aktivizoi procesin pg_rewind. Si pasojë, ai fshiu një pjesë të regjistrimeve të transaksioneve, shkarkoi të reja dhe u lidh. Këtu Patroni punoi shkëlqyer, pra ashtu siç duhej. Klasteri ynë u rikuperua. Kishim 3 nyje, pas dështimit të skedarëve 3 nyje – çdo gjë është e shkëlqyer.
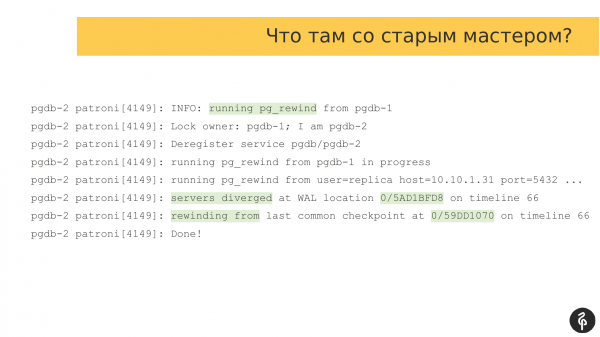
Kemi humbur një pjesë të të dhënave. Dhe na nevojitet të kuptojmë sa kemi humbur. Po kërkojmë pikërisht momentin kur ndodhi rewind. Mund ta gjejmë këtë përmes regjistrimeve në ditar. U aktivizua rewind, bëri diçka dhe përfundoi.
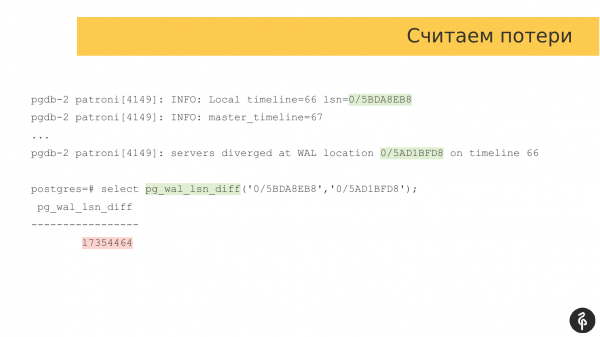
Na nevojitet të gjejmë pozitat në regjistrin e transaksioneve ku ndali masteri i vjetër. Në këtë rast – kjo është shenja këtu. Dhe na nevojitet një shenjë tjetër, pra ajo distancë me të cilën dallohet masteri i vjetër nga ai i ri.
Marrim diferencën e zakonshme të pg_wal_lsn_diff dhe e krahasojmë këto dy shenja. Në këtë rast, marrim 17 megabajt. Çfarë është shumë ose pak e vendos secili për vete. Sepse për dikë 17 megabajt është pak, për dikë tjetër është shumë dhe e papranueshme. Këtu secili e përcakton individualisht në përputhje me nevojat e biznesit.
Por çfarë kemi zbuluar për vete?
Së pari, duhet të vendosim nëse gjithmonë na nevojitet autostart-i i Patroni pas rinisjes së sistemit. Shpesh ndodh që duhet të hyjmë te masteri i vjetër, të shohim sa larg ka shkuar. Ndoshta të hedhim një sy në segmentet e regjistrit të transaksioneve, të shohim se çfarë ka aty. Dhe të kuptojmë nqs mund t’i humbasim këto të dhëna apo na nevojitet të aktivizojmë masterin e vjetër në modalitetin standalone për të nxjerrë këto të dhëna.
Dhe vetëm pas kësaj duhet të marrim vendime se a mund të hedhim këto të dhëna ose mund t'i rikthejmë, duke lidhur këtë nyjë si një replikë në klasterin tonë.
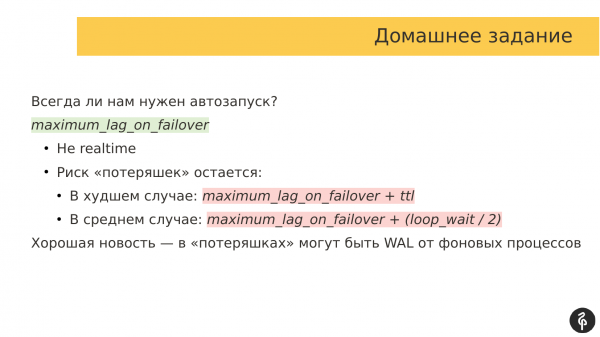
Përveç kësaj, ekziston parametri ‘maximum_lag_on_failover’. Në përllogaritjen time, ky parametër ka një vlerë prej 1 megabajt.
Si funksionon? Nëse replika jonë është prapa me 1 megabajt të dhënash në lagun e replikimit, atëherë kjo replikë nuk merr pjesë në zgjedhje. Dhe nëse ndodhi një failover, Patroni sheh se cilat replika janë prapa. Nëse ato janë prapa me një numër të madh regjistrimesh të transaksioneve, nuk mund të bëhen master. Kjo është një funksion mbrojtës shumë i mirë, i cili ndihmon për të mos humbur shumë të dhëna.
Por këtu ka një problem se lagun e replikimit në klasterin Patroni dhe DCS e përditëson me një interval të caktuar. Mendoj se vlera e ttl sipas default është 30 sekonda.
Kështu, mund të ndodhë një situatë ku vonesa e replikimit për replikat në DCS është një, ndërsa në të vërtetë mund të jetë krejtësisht ndryshe ose nuk ka vonesë fare, pra kjo gjë nuk është në kohë reale. Dhe ajo nuk gjithmonë reflekton realitetin. Prandaj, nuk ka sens të krijoni logjikë të ndërlikuar mbi të.
Dhe rreziku i humbjeve gjithmonë mbetet. Në rastin më të keq një formulë, ndërsa në rastin mesatar një formulë tjetër. Kështu, kur planifikojmë implementimin e Patroni dhe vlerësojmë sa të dhëna mund të humbasim, duhet të mbështetemi në këto formule dhe të kemi një ide të përafërt se sa të dhëna mund të humbasim.
Dhe ka lajme të mira. Kur masteri i vjetër është larguar përpara, ai mund të largohet për shkak të disa proceseve të prapaskenës. Kështu, ndoshta kishte një avokum automatik, ai shkroi të dhënat dhe i ruajti ato në ditarin e transaksioneve. Dhe ne mund t’i injorojmë këto të dhëna dhe t'i humbasim pa asnjë problem.
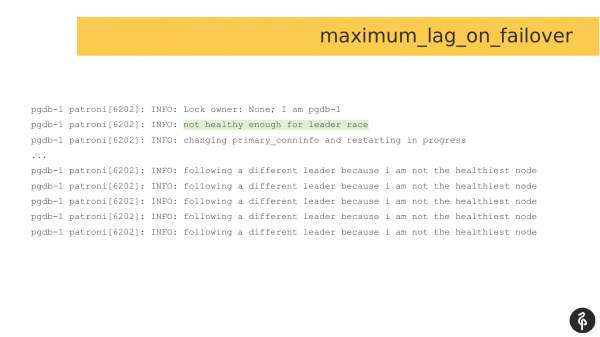
Kështu duket logu në rastin kur është vendosur maximum_lag_on_failover dhe ka ndodhur një failover, duke qenë se duhet të zgjidhet një master i ri. Republika e vlerëson veten si të paaftë për të marrë pjesë në zgjedhje. Dhe ajo refuzon të marrë pjesë në garën për liderin. Ajo pret deri sa të zgjidhet një master i ri për t'u lidhur më pas me të. Kjo është një masë shtesë për të shmangur humbjen e të dhënave.
Këtu ekipi ynë produktiv ka shkruar se produkti i tyre ka probleme kur punon me Postgres. Ndërkohë, nuk mund të qasemi në masterin për shkak se ai nuk është i aksesueshëm përmes SSH. Dhe auto-failover gjithashtu nuk ndodhi.
Ky host u dërgua me forcë për të rifilluar. Për shkak të rifillimit ndodhi një auto-failover, ndonëse mund të kishte ndodhur një auto-failover manual, ashtu siç e kuptoj tani. Dhe pas rifillimit, ne shkuam të shihnim se çfarë ndodhi me masterin aktual.
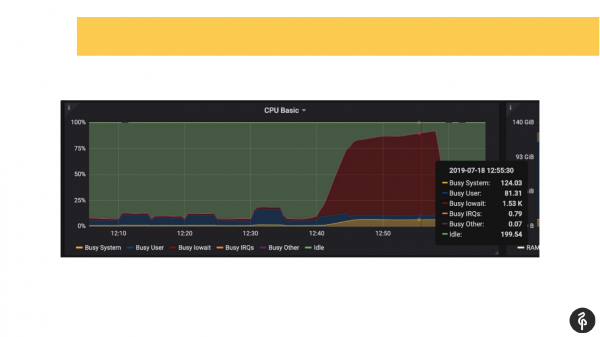
Gjatë kësaj kohe, ne e dinim paraprakisht se kishim probleme me diskët, pra ne kishim tashmë informacion nga monitorimi për ku duhet të kërkonim dhe çfarë duhet të gjenim.
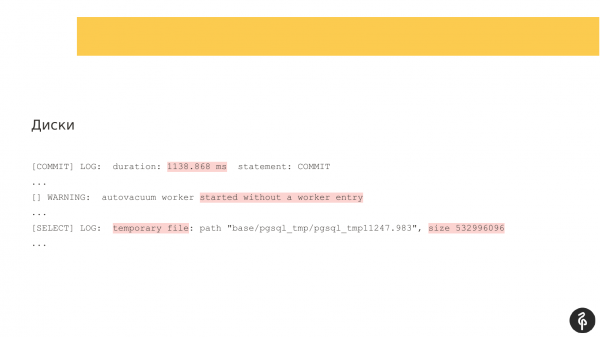
Ne kontrolluam logun e postgres-it dhe filluam të shihnim se çfarë po ndodhte. Pashë komitetet që zgjatnin një, dy, tre sekonda, gjë që nuk është normale. Pashë se avokumi automatik fillonte shumë ngadalë dhe në një mënyrë të çuditshme. Dhe pashë skedarë përkohësorë në disk. Pra, këto janë të gjitha tregues të problemeve me diskët.
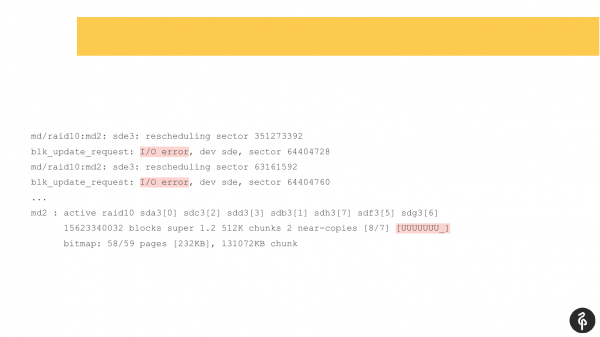
Ne ne shkuam në sistemin dmesg (në logun e mesazheve të bërthamës). Dhe pamë se kishim probleme me një nga disqet. Sistemi i disqeve përbënte një RAID softuerësh. Shikuam /proc/mdstat dhe panë se na mungonte një disk. Domethënë, këtu ishte një RAID me 8 disqe, dhe na mungonte një. Nëse e shikoni me kujdes slajdin, në dalje mund të shihni se sde mungon. Në mënyrë figurative, na ka rënë një disk. Kjo shkaktoi Probleme me disqet, dhe aplikacionet gjithashtu patën probleme në punën me klasterin Postgres.
Dhe në këtë rast, Patroni nuk do të na ndihmonte, sepse Patroni nuk ka detyrën të monitorojë gjendjen e serverit, gjendjen e disqeve. Dhe ne duhet të monitorojmë këto situata me monitorim të jashtëm. Ne e shtuam monitorimin e disqeve në monitorimin e jashtëm me shpejtësi.
Dhe ishte një mendim – a do të na ndihmonte fencing, ose ndonjë watchdog softuerësh? Ne mendojmë se nuk do të na ndihmonte në këtë rast, sepse gjatë problemeve Patroni vazhdoi të bashkëpunonte me klasterin DCS dhe nuk pa asnjë problem. Domethënë, nga pikëpamja e DCS dhe Patroni me klasterin gjithçka ishte mirë, ndonëse në fakt kishte probleme me diskun, kishte probleme me disponueshmërinë e bazës.
Mendoj se kjo është një nga problemet më të çuditshme që kam shqyrtuar për një kohë të gjatë, kam lexuar shumë loge, kam shqyrtuar dhe e quajta klaster-simuluese.
Problemi ishte që master i vjetër nuk mund të bëhej një replika normale, pra, Patroni e nisi atë, Patroni tregoi se ky nyje ishte prezent si replika, por në të njëjtën kohë ai nuk ishte një replika normale. Tani do të shihni pse. Kjo më ka mbetur nga analiza e atij problemi.
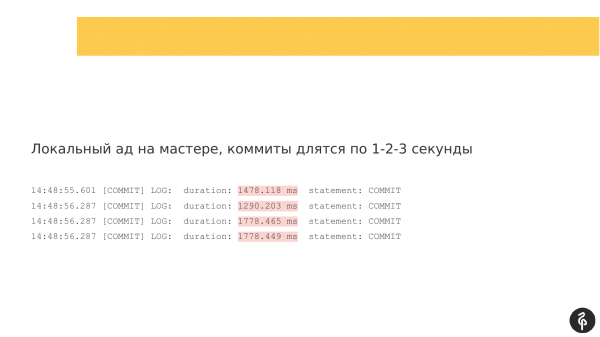
Çfarë filloi gjithçka? Filloi, si në problemin e mëparshëm, me ngadalësim të disqeve. Kishim komitete një herë në sekondë, ndonjëherë dy.
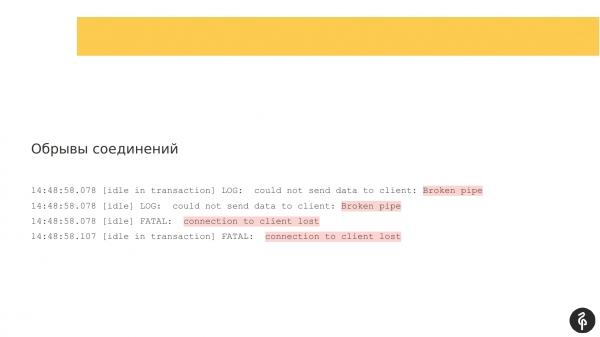
Ishin ndërprerje lidhjesh, domethënë, klientët po ndërpresin.
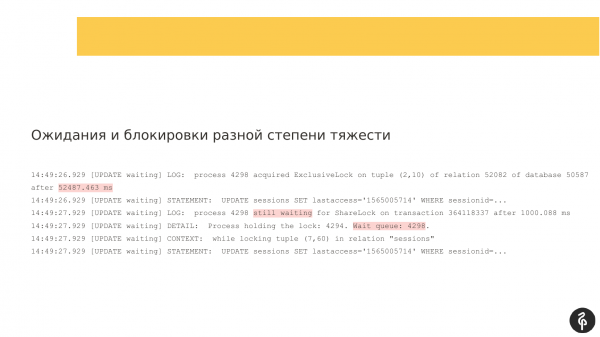
Ishin bllokime të ndryshme rëndësie.
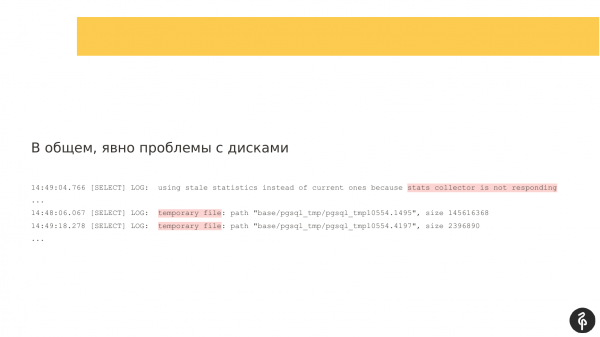
Dhe, për rrjedhojë, sistemi i disqeve nuk ishte shumë i përgjegjshëm.
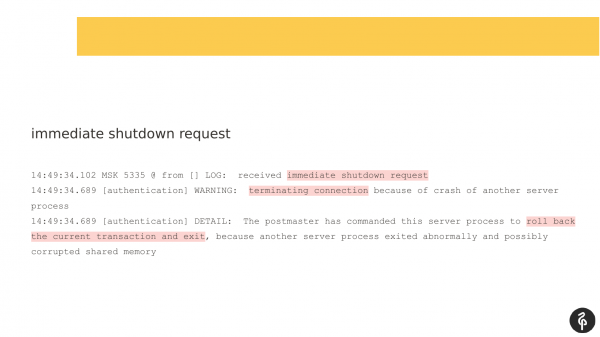
Dhe më misterioza për mua – është kërkesa e menjëhershme për ndalim. Postgres ka tre mënyra ndalimi:
- Kjo është graceful, kur presim që të gjithë klientët të çaktivizohen vetë.
- Ka fast, kur i detyrojmë klientët të çaktivizohen, sepse po shkojmë për ndalim.
- Kjo është immediate. Në këtë rast, immediate nuk i informon as klientët se duhet të çaktivizohen, thjesht lidhen pa paralajmërim. Të gjithë klientët tashmë marrin një mesazh RST nga sistemi operativ (mesazh TCP që lidhja është ndërprerë dhe klientit nuk ka më asgjë për të kapur).
Kush dërgoi këtë sinjal? Proceset në sfond të Postgres-it nuk dërgojnë njëri-tjetrit të tillë sinjale, dmth. është kill-9. Ata nuk dërgojnë kështu njëri-tjetrit, ata vetëm reagojnë ndaj kësaj, dmth. është një ri-start urgjent i Postgres. Kush e dërgoi atë, nuk e di.
Pashë me komandën “last” dhe pashë një person tjetër, i cili gjithashtu u lidh me këtë server bashkë me ne, por u turpërova të bëja pyetje. Ndoshta ishte kill -9. Do ta shihja në log-et kill -9, pasi Postgres shkruan se mori kill -9, por nuk e pashë këtë në log-e.
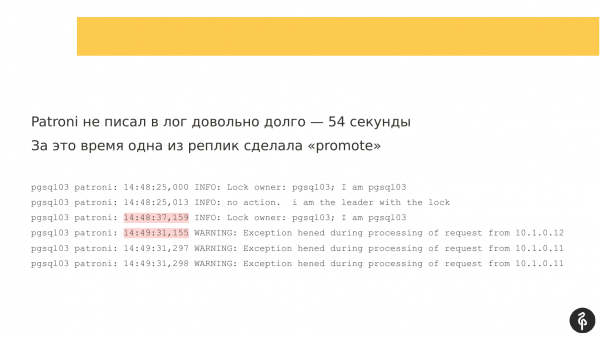
Duke e hetuar më tej, pashë se Patroni nuk kishte shkruar në log për një kohë të gjatë – 54 sekonda. Dhe nëse krahasoj dy timestamp, këtu ishin afërsisht 54 sekonda pa mesazhe.
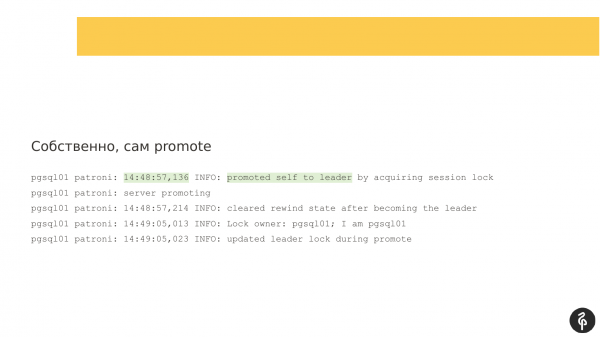
Dhe gjatë kësaj kohe ndodhi auto-failover. Patroni përsëri punoi jashtëzakonisht mirë. Mjeshtri ynë i vjetër nuk ishte në dispozicion, diçka po ndodhte me të. Dhe filluan zgjedhjet për një master të ri. Këtu çdo gjë funksionoi mirë. Ne pgsql01 u bë lideri i ri.
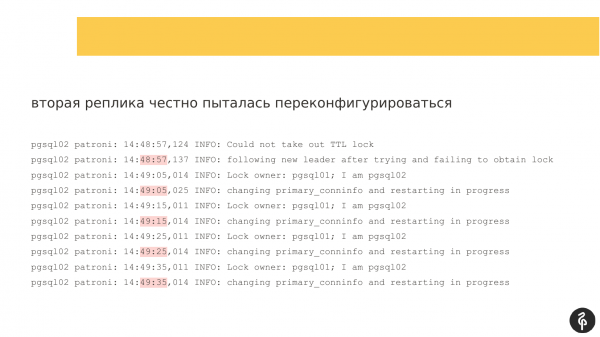
Kemi një replikë që u bë master. Dhe ka një replikë të dytë. Dhe me replikën e dytë pikërisht pati probleme. Ajo përpiqej të ri-konfigurohej. Siç kuptoj, ajo përpiqej të ndryshonte recovery.conf, të ri-startonte Postgres dhe të lidhej me masterin e ri. Ajo shkruan mesazhe çdo 10 sekonda se po përpiqet, por nuk ia del.
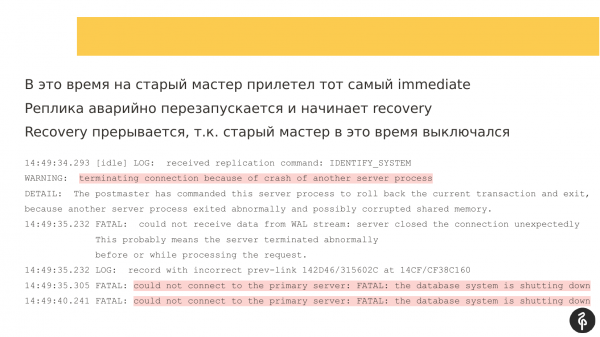
Dhe gjatë këtyre përpjekjeve, një sinjal immediate-shutdown arrin te masteri i vjetër. Masteri ri-startohet. Po ashtu, rikuperimi ndalohet, sepse masteri i vjetër po bëhet ri-start. Dmth. replikja nuk mund të lidhet me të, sepse ai është në modalitetin e fikjes.
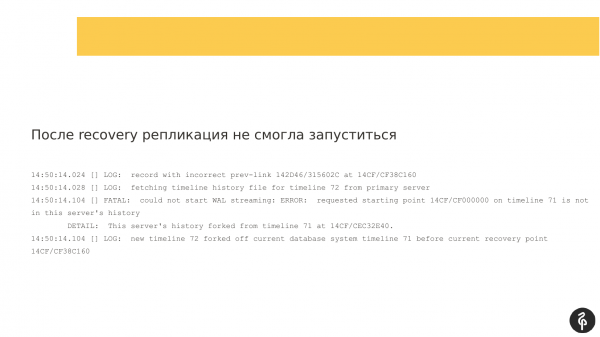
Në një moment, ajo funksionoi, por replikimi nuk u ndërlidh.
Kam një hipotezë të vetme, që në recovery.conf ishte adresa e masterit të vjetër. Dhe kur u shfaq masteri i ri, replikja e dytë vazhdonte të përpiqej të lidhej me masterin e vjetër.
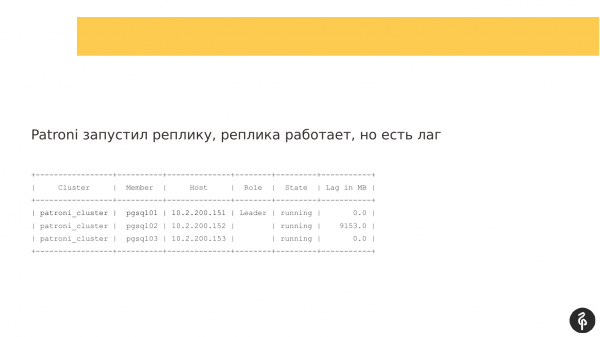
Kur Patroni u aktivizua në replikën e dytë, nënkërkesa u aktivizua, por nuk mundi të lidhej përmes replikimit. Dhe u krijua një vonesë replikimi, e cila dukej kështu. Dmth. të tre nënkërkesat ishin të pranishme, por nënkërkesa e dytë kishte vonesë.
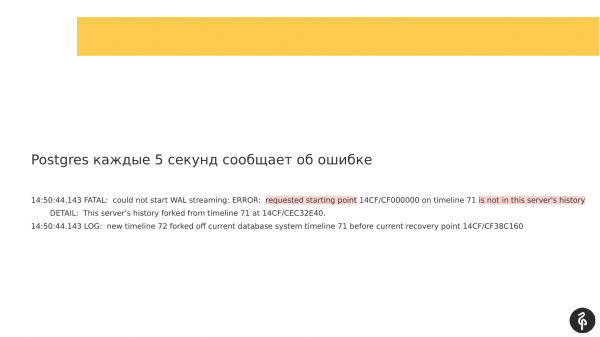
Në të njëjtën kohë, nëse shikoni loget që ishin shkruar, mund të shihni se replicimi nuk mund të fillonte, sepse regjistrat e transaksionit janë të ndryshëm. Dhe ato regjistra transaksionesh, që ofron masteri, të cilat përshkruhen në recovery.conf, thjesht nuk i përshtaten nyjës sonë aktuale.
Dhe këtu e bëra një gabim. Duhet të kisha shkuar të shihja se çfarë kishte në recovery.conf, për të verifikuar hipotezën time se ne po lidhej me masterin e gabuar. Por atëherë sapo po merja vesh këtë dhe nuk më erdhi në mendje, ose pashë që replicimi po vonohej dhe do të duhej të riinstalohej, dmth e punova disi me dorë të lirë. Ky ishte gabimi im.
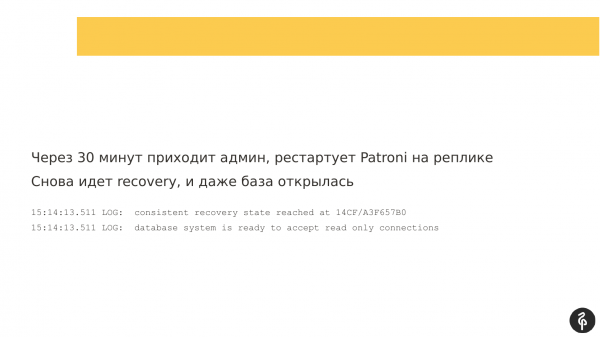
Pas 30 minutash erdhi admini, dmth unë e ripara Patroni në replikë. E kisha hequr dorë prej saj, mendoja se duhet të riinstalohej. Dhe mendova – do ta riparoj Patroni, ndoshta do ndodhi diçka e mirë. U aktivizua rikuperimi. Dhe baza u hap, ishte gati për të pranuar lidhje.
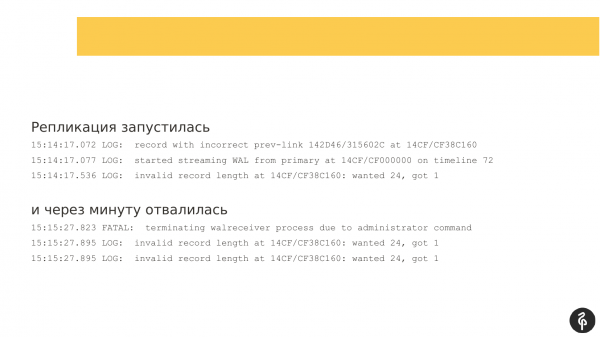
Replicimi filloi. Por pas një minute u ndal me një gabim, se nuk i përshtateshin regjistrat e transaksioneve.
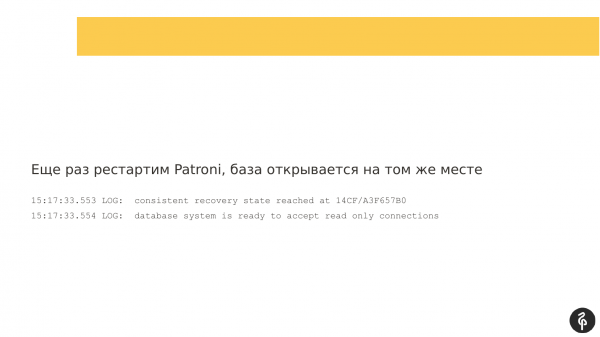
Mendoja se do ta riparoj sërish. E ripara përsëri Patroni, dhe nuk e ripara Postgres, por e ripara pikërisht Patroni në shpresën se do ta aktivizonte bazën si me magji.
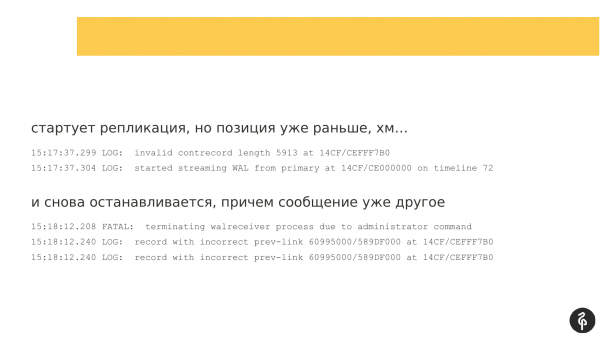
Replicimi u aktivizua sërish, por shenjat në regjistrat e transaksioneve ishin të ndryshme, nuk ishin ato që ishin në përpjekjen e kaluar për aktivizimin. Replicimi u ndal sërish. Dhe mesazhi ishte pak ndryshe. Dhe nuk ishte shumë informues për mua.
Dhe këtu më vjen në mendje – çfarë, nëse e riparoj Postgres, në atë kohë në masterin aktual bëj një checkpoint, për të avancuar pikën në regjistrin e transaksioneve pak përpara, për të filluar rikuperimin nga një moment tjetër? Plus atje kishim disa rezervë WAL.
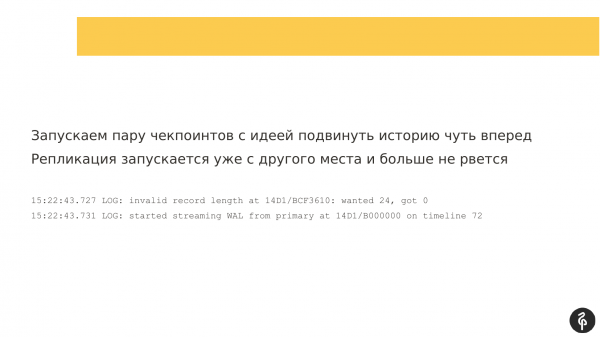
E ripara Patroni, bëra disa checkpoints në master, disa pikë restart në replikë, kur ajo u hap. Dhe kjo ndihmoi. Mendova gjatë se pse kjo ndihmoi dhe si funksionoi. Dhe replikimi filloi. Dhe replikimi nuk u ndal më.
Kjo problem për mua është një nga më misteret, mbi të cilin ende po mendoj, çfarë po ndodhte në të vërtetë.
Cilat janë përfundimet këtu? Patroni mund të funksionojë siç është menduar dhe pa asnjë gabim. Por megjithatë – kjo nuk është 100% garanci që gjithçka është në rregull. Një replikë mund të nisë, por mund të jetë në një gjendje gjysmë-funksionuese, dhe aplikacioni nuk mund të punojë me një replikë të tillë, sepse do të ketë të dhëna të vjetra.
Dhe pas çdo skenar të skadarit, gjithmonë duhet të verifikojmë se gjithçka është në rregull me klastri, dmth. ka numrin e nevojshëm të replikave, nuk ka vonesë në replikim.
Dhe gjatë shqyrtimit të këtyre problemeve do të formuloj rekomandime. Kam tentuar të bashkoj ato në dy slide. Ndoshta, të gjitha historitë mund të ishin bashkuar në dy slide dhe vetëm ato të tregonim.
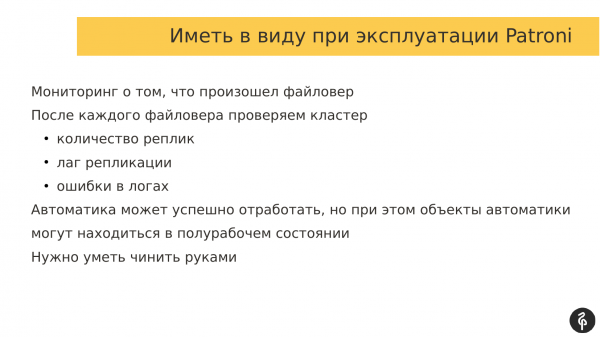
Kur përdorni Patroni, ju duhet patjetër të keni monitorim. Ju gjithmonë duhet të dini kur ka ndodhur autofilimi, sepse nëse nuk e dini që keni pasur autofilim, nuk e kontrolloni klastrin. Dhe kjo është e keqe.
Pas çdo autofilimi, gjithmonë duhet të kontrollojmë manualisht klastrin. Duhet të sigurohemi që gjithmonë kemi numrin e saktë të replikave, nuk ka vonesë në replikim, dhe në log nuk ka gabime që lidhen me replikimin e transmetimit, me Patroni, me sistemin DCS.
Automatizimi mund të funksionojë me sukses, Patroni është një mjet shumë i mirë. Ai mund të funksionojë, por kjo nuk do ta çojë klastrin në gjendjen e nevojshme. Dhe nëse ne nuk e zbulojmë këtë, do të kemi probleme.
Dhe Patroni nuk është një plumb argjendi. Ne akoma duhet të kemi një ide se si funksionon Postgres, si funksionon replikimi dhe se si Patroni bashkëpunon me Postgres, dhe si sigurohet ndërveprimi midis nyjeve. Kjo është e nevojshme për të ditur si të zgjidhim manualisht problemet që dalin.
Si qasëm çështjes së diagnostikimit? Ka ndodhur që ne punojmë me klientë të ndryshëm dhe asnjë nuk ka një stek ELK, dhe duhet të merremi me logjet duke hapur 6 konsola dhe 2 tab. Në një tab – janë logjet e Patroni për çdo nyje, në tab tjetër – janë logjet e Consul ose Postgres kur është e nevojshme. Diagnostikimi i kësaj është shumë i vështirë.
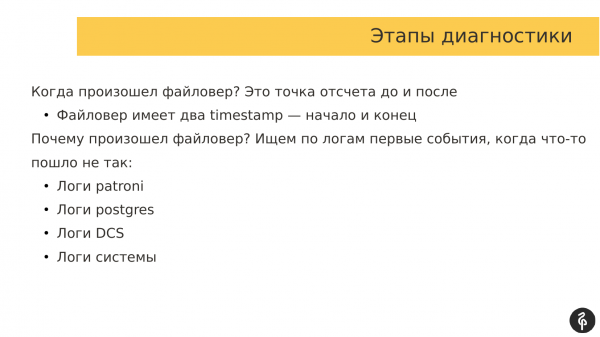
Cilat janë qasjet që kam zhvilluar? Së pari, gjithmonë shikoj kur ka ardhur autofilimi. Dhe për mua, kjo është një ndarje e rëndësishme. Shikoj se çfarë ka ndodhur para autofilimit, gjatë autofilimit dhe pas autofilimit. Autofilimi ka dy shënime: koha e fillimit dhe e përfundimit.
Pastaj unë shikoj ngjarjet në logje përpara se të ndodhë failoveri, pra kërkoj arsyet se përse ndodhi failoveri.
Dhe kjo e jep një pasqyrë të asaj që ndodhi dhe çfarë mund të bëhet në të ardhmen për të shmangur qëndrim të tillë (dhe si pasojë të mos ndodhë failoveri).
Dhe ku shikojmë zakonisht? Unë shikoj:
- Së pari në logjet e Patroni.
- Më pas shikoj logjet e Postgres, ose logjet e DCS në varësi të asaj që është gjetur në logjet e Patroni.
- Dhe ndonjëherë logjet e sistemit gjithashtu ofrojnë informacion mbi arsyen që çoi në failover.
Si e shoh Patroni? E shoh shumë mirë. Në mendimin tim, është më e mira që ekziston sot. Unë njoh shumë produkte të tjera. Këto janë Stolon, Repmgr, Pg_auto_failover, PAF. 4 mjete. I kam provuar të gjithë. Patroni më pëlqeu më shumë.
Nëse dikush më pyet: "A e rekomandoj Patroni?". Unë do të them po, sepse Patroni më pëlqen. Dhe, më duket, kam mësuar ta përgatis atë.
Nëse ju intereson të shihni çfarë lloj problemesh ka me Patroni, përveç problemeve që kam përmendur, gjithmonë mund të shkoni në faqen në GitHub. Aty janë shumë histori të ndryshme dhe diskutohen shumë probleme interesante. Dhe në fund disa bbug do të regjistrohen dhe do të zgjidhen, pra është një lexim interesant.
Aty ka histori të interesant se si njerëzit godasin vetën në këmbë. Shumë edukative. Lexon dhe kupton që nuk duhet ta bësh atë. E kam shënuar këtë.
Dhe do të doja të falenderoj shumë kompaninë Zalando për zhvillimin e këtij projekti, konkretisht Aleksandër Kukuškinin dhe Aleksej Kljukin. Aleksej Kljukin është një nga bashkëautorët, ai tashmë nuk punon në Zalando, por këta janë dy njerëz që filluan të punojnë me këtë produkt.
Dhe unë mendoj se Patroni është një gjë shumë e shkëlqyer. Jam i kënaqur që ekziston, është interesante me të. Dhe falenderoj të gjithë kontribuesit që shkruajnë patch-ët në Patroni. Shpresoj që Patroni me kalimin e kohës të bëhet më i pjekur, më tërheqës dhe më funksional. Ai tashmë është funksional, por shpresoj që të bëhet akoma më i mirë. Prandaj, nëse planifikoni ta përdorni Patroni, mos kini frikë. Është një zgjidhje e mirë, mund të implementohet dhe përdoret.
Këtu është gjithçka. Nëse keni pyetje, pyetni.
Pyetje
Faleminderit për paraqitjen! Nëse pas një failover-i është e nevojshme të shikoni atje me vëmendje, përse na nevojitet një failover automatik?
Sepse kjo është një gjë e re. Ne kemi punuar me të vetëm për një vit. Më mirë të jemi të sigurt. Duam të hyjmë dhe të shohim nëse gjithçka ka funksionuar siç duhet. Kjo është një shkallë e mosbesimit të rritur - më mirë ta kontrollojmë dhe të shohim.
Për shembull, mëngjesin hyjmë dhe shohim, apo jo?
Jo mëngjesin, ne zakonisht bëjmë të ditur për auto-fileover-in pothuajse menjëherë. Ne marrim njoftime, shohim që ka ndodhur auto-fileover. Ne hyjmë dhe shohim pothuajse menjëherë. Por të gjitha këto kontrolle duhet të jenë në nivelin e monitorimit. Nëse kontaktojmë Patroni përmes REST API, ka histori. Përmes historisë mund të shohim shenjat kohore kur ka ndodhur fileover-i. Në bazë të kësaj mund të bëjmë monitorimin. Mund të shohim historinë, sa ngjarje ka pasur. Nëse na janë shtuar ngjarje, do të thotë se ka ndodhur auto-fileover. Mund të kontrollojmë dhe të shohim. Ose automatikisht në monitorim kemi kontrolluar që të gjitha replikat janë në vend, nuk ka vonesa dhe gjithçka është në rregull.
Faleminderit!
Faleminderit shumë për tregimin e shkëlqyer! Nëse ne e kemi zhvendosur klasterin DCS larg klasterit Postgres, a duhet ta mbajmë këtë klaster gjithashtu periodikisht? Cilat janë praktikat më të mira në lidhje me ndihmën e disa pjesëve të klasterit DCS, që duhet të fikim, çfarë duhet të bëjmë, etj.? Si jeton e gjithë kjo përbërje në të njëjtën kohë? Dhe si t'i realizojmë këto gjëra?
Për një kompani, ishte e nevojshme të bëhej një matricë problemesh, çfarë ndodh nëse ndonjë nga komponentët ose disa komponentë dështojnë. Sipas kësaj matrice, ne përshkojmë rregullisht të gjithë komponentët dhe ndërtuam skenarët në rast të dështimit të këtyre komponentëve. Kështu për çdo skenar dështimi mund të ketë një plan veprimi për rikuperim. Dhe në rastin e DCS, kjo është si një pjesë e infrastrukturës standarde. Dhe admini e administron këtë, dhe ne tashmë mbështetemi tek adminët që e administrin atë dhe aftësitë e tij për ta riparuar këtë në rast të një aksidenti. Nëse DCS nuk ekziston, atëherë ne e vendosim atë, por në të njëjtën kohë nuk e ndjekim shumë, sepse nuk jemi përgjegjës për infrastrukturën, por ofrojmë rekomandime se si dhe çfarë të monitorohet.
Pra, a e kuptova saktë që duhet të fikim Patroni, të fikim fileover-in, të fikim gjithçka përpara se të bëjmë diçka me hostet?
Kjo varet nga numri i nyjeve që kemi në klasterin DCS. Nëse ka shumë nyje dhe ne çaktivizojmë vetëm një nyje (replikë), atëherë klasteri ruan kuorumin. Dhe Patroni mbetet funksional. Dhe asgjë nuk aktivizohet. Nëse kemi ndonjë operacion të komplikuar që përfshin më shumë nyje, mungesa e të cilave mund të prishë kuorumin, atëherë – po, ndoshta ka kuptim ta vendosim Patronin në pauzë. Ai ka komandën përkatëse – patronictl pause, patronictl resume. Ne thjesht e vendosim në pauzë, dhe autofailover nuk aktivizohet për këtë kohë. Ne bëjmë mirëmbajtjen në klasterin DCS, pastaj e heqim pauzën dhe vazhdojmë jetën.
Faleminderit shumë!
Faleminderit shumë për paraqitjen! Si e sheh ekipi i produktit humbjen e të dhënave?
Ekipet e produkteve nuk e ndiejnë, por liderët e ekipeve janë të shqetësuar.
Çfarë garancish ka aty?
Me garancitë është shumë e vështirë. Ka një paraqitje nga Alexander Kukushkin "Si të llogarisim RPO dhe RTO", dmth. koha e rikuperimit dhe sa të dhëna mund të humbasim. Mendoj se duhet të gjejmë këto slajde dhe t'i studiojmë. Sa më kujtohet, atje ka hapa konkretë për llogaritjen e këtyre gjërave. Sa transaksione mund të humbasim, sa të dhëna mund të humbasim. Si një opsion mund të përdorim replikimin sinkron në nivelin e Patroni, por kjo është një gjithnjë e dyshimtë: ose kemi besueshmëri të dhënash, ose humbasim në shpejtësi. Ka replikim sinkron, por ai gjithashtu nuk garanton mbrojtje 100% nga humbja e të dhënave.
Alexei, faleminderit për paraqitjen e shkëlqyer! A keni përvojë në përdorimin e Patroni për mbrojtjen e nivelit zero? Domethënë, në bashkëpunim me qëndrim sinkron? Ky është pyetje e parë. Dhe pyetja e dytë. Keni përdorur zgjidhje të ndryshme. Ne kemi përdorur Repmgr, por pa autofailover dhe tani po planifikojmë të lidhim autofailover. Dhe po shqyrtojmë Patronin si një zgjidhje alternative. Çfarë mund të thoni si avantazhe krahasuar me Repmgr?
Pyetja e parë ishte për replikat sinkrone. Askush nga ne nuk e përdor replikimin sinkron, sepse të gjithëve u frikësohen (Tani disa klientë e përdorin, nuk kanë vërejtur probleme me performancën — Shënim nga referuesi). Por ne për ne kemi zhvilluar një rregull, që në klasterin e replikimit të sinkronizuar të ketë të paktën tre nyje, sepse, nëse kemi dy nyje dhe nëse masteri ose replikimi dështojnë, atëherë Patroni e kalon këtë nyje në modin Standalone, që aplikacioni të vazhdojë të punojë. Në këtë rast ka rreziqe për humbjen e të dhënave.
Sa i përket pyetjes së dytë, ne kemi përdorur Repmgr dhe akoma e përdorim tek disa klientë për arsye historike. Çfarë mund të thuhet? Në Patroni auto-failover vjen direkt në kuti, kurse në Repmgr auto-failover është një veçori shtesë, që duhet aktivizuar. Duhet të nisim daemon-in e Repmgr në çdo nyje dhe atëherë mund të konfigurojmë auto-failover.
Repmgr kontrollon – a janë të gjalla nyjet Postgres. Proceset e Repmgr kontrollojnë ekzistencën e njëri-tjetrit, kjo nuk është një qasje shumë efektive pasi mund të ketë raste të komplikuara të izolimit rrjetor, në të cilat një kluster i madh Repmgr mund të shpërbëhet në disa të vogla dhe të vazhdojë punën. Nuk kam ndjekur Repmgr për një kohë të gjatë, ndoshta e kanë zgjidhur këtë... apo ndoshta jo. Ndërsa, nxjerrja e informacionit mbi gjendjen e klustrit në DCS, siç bën Stolon dhe Patroni, është një variant më i qëndrueshëm.
Aleksej, kam një pyetje, ndoshta e thjeshtë. Ju në një nga shembujt e parë DCS e transferuat nga makina lokale në një nyje të largët. E kuptojmë që rrjeti – është një gjë që ka karakteristikat e tij, ai vetë jeton. Çfarë do të ndodhë, nëse për ndonjë arsye klusteri DCS bëhet i padisponueshëm? Nuk do të flas për arsyet, mund të jenë shumë: nga duar të gabuara të rrjetarëve deri në probleme reale.
Nuk e kam thënë këtë me zë të lartë, por klusteri DCS gjithashtu duhet të jetë i qëndrueshëm ndaj dështimeve, dmth. një numër të çuditshëm nyjesh, që të mund të mblidhet kuorumi. Çfarë ndodh, nëse klusteri DCS bëhet i padisponueshëm, ose nuk mund të mblidhet kuorumi, dmth. ndonjë ndarje rrjetore ose dështimi i nyjeve? Në këtë rast, klusteri Patroni kalon në modin read-only. Klusteri Patroni nuk mund të përcaktojë gjendjen e klustrit dhe çfarë të bëjë. Ai nuk mund të lidhet me DCS-në dhe ruajë aty gjendjen e re të klustrit, prandaj të gjithë klustri kalon në read-only. Dhe pret ose ndërhyrjen manuale nga operatori ose kur DCS-në të rikuperohet.
Thënë në mënyrë të thjeshtë, DCS për ne bëhet një shërbim po aq i rëndësishëm sa vetë baza?
Po, po. Në shumë kompani moderne, Shërbimi i Zbulimit është një pjesë e pandashme e infrastrukturës. Ai implementohet madje përpara se të ketë ndonjë bazë të dhënash në infrastrukturë. Të themi, kemi nisur infrastrukturën, kemi ngritur në qendrën e të dhënave, dhe menjëherë kemi Shërbimin e Zbulimit. Nëse është Consul, mund të ndërtohet edhe DNS mbi të. Nëse është Etcd, mund të jetë pjesë e një klasteri Kubernetes, ku do të zhvillohet gjithçka tjetër. Më duket se Shërbimi i Zbulimit është tashmë një pjesë e pandashme e infrastrukturave moderne. Dhe për të mendojnë shumë më përpara sesa për bazat e të dhënave.
Faleminderit!
Burimi: habr.com
