

Përshëndetje, Habr!
Ju kujtojmë se kemi publikuar një tjetër artikull tepër interesant dhe të dobishëm për modelet Kubernetes. E gjithë kjo filloi me "" të Brendan Burns, dhe megjithatë, puna në këtë segment është . Sot, ne ju ofrojmë të lexoni një artikull nga blogu MinIO, i cili paraqet shkurtimisht tendencat dhe specifikat e modeleve të ruajtjes së të dhënave në Kubernetes.
Kubernetes ka ndryshuar në mënyrë themelore modelet tradicionale të zhvillimit dhe implementimit të aplikacioneve. Tani ekipi mund të shpenzojë vetëm disa ditë për të zhvilluar, testuar dhe implementuar një aplikacion – në mjedise të ndryshme, dhe gjithçka brenda klastereve Kubernetes. Puna me teknologjitë e brezave të kaluar zakonisht merrte javë të tëra, nëse jo muaj.
Ky përshpejtim është bërë i mundur falë abstraksionit që ofron Kubernetes — dmth, falë faktit se Kubernetes ndërvepron me detalet e ulëta të pajisjeve fizike ose virtuale, duke lejuar përdoruesit të shpallin, përveç parametrave të tjerë, procesorin e nevojshëm, sasinë e kujtesës, numrin e instancave të kontejnerëve. Duke qenë se një komunitet i madh është i angazhuar në mbështetje të Kubernetes dhe shkalla e përdorimit të Kubernetes vazhdon të zgjerohet, ai është në mënyrë të dukshme lider në mesin e të gjitha platformave të orkestrimit të kontejnerëve.
Me rritjen e përdorimit të Kubernetes, rritet edhe konfuzioni në lidhje me modelet e ruajtjes së të dhënave të aplikuara atje..
Me gjithë konkurrencën për një copë të tortës Kubernetes (dmth, për ruajtjen e të dhënave), kur bëhet fjalë për ruajtjen e të dhënave, sinjali këtu humbet në një zhurmë të madhe.
Kubernetes përmbush modelin modern të zhvillimit dhe implementimit të aplikacioneve, si dhe menaxhimin e tyre. Ky model modern ndan ruajtjen e të dhënave nga llogaritjet. Për të kuptuar plotësisht këtë ndarje në kontekstin e Kubernetes, është e nevojshme gjithashtu të kuptohet se çfarë përfaqësojnë aplikacionet me ruajtje gjendjeje dhe pa ruajtje gjendjeje, si dhe se si lidhen kjo me ruajtjen e të dhënave. Këtu është vendi ku qasja REST API e aplikuar nga S3 ka avantazhe të qarta krahasuar me qasjen POSIX/CSI, tipike për zgjidhjet e tjera.
Në këtë artikull do të flasim për modelet e ruajtjes së të dhënave në Kubernetes dhe do të trajtojmë veçmas debatin në lidhje me aplikacionet që punojnë me gjendje dhe pa gjendje, për të kuptuar saktësisht se çfarë përbën dallimin mes tyre dhe pse është i rëndësishëm. Më tej, do të shqyrtohen aplikacionet dhe modelet e ruajtjes së të dhënave që përdoren në to në dritën e praktikave më të mira të punës me kontejnerët dhe Kubernetes.
Kontejnerë pa gjendje
Kontejnerët natyrshëm janë të lehtë dhe efemer. Ata mund të ndalen, hiqen ose vendosen pa mundim në një nod tjetër - të gjitha këto kërkojnë vetëm disa sekonda. Në një sistem të madh orkestrimi të kontejnerëve, këto operacione ndodhin vazhdimisht dhe përdoruesit nuk e vërejnë asnjëherë këto ndryshime. Megjithatë, lëvizjet janë të mundshme vetëm nëse kontenieri nuk ka asnjë varësi nga nodi në të cilin ndodhet. Për këta kontejnerë thuhet se ata punojnë pa gjendje.
Kontejnerë me gjendje
Nëse një kontenier ruan të dhëna në pajisje të lidhura lokalisht (ose në një pajisje bllok), atëherë ruajtja e të dhënave, në të cilën ndodhet, do të duhet të lëvizi në një nod të ri së bashku me vetë kontenierin - në rast se ndodh një dështim. Kjo është e rëndësishme, sepse në të kundërt aplikacioni që ekzekutohet në kontenier nuk do të funksionojë siç duhet, pasi i nevojitet të aksesojë të dhënat e ruajtura në médhjet lokale. Për këta kontejnerë thuhet se ata punojnë me gjendje.
Nga një këndvështrim tërësor teknik, kontejnerët me gjendje gjithashtu mund të lëvizin në nod të tjerë. Kjo zakonisht sigurohet përmes sistemeve të shpërndara të skedarëve ose ruajtjeve të dhënash të lidhura me rrjet të bllokut, të cilat janë të lidhura me të gjithë nodet ku punojnë kontejnerët. Kështu, kontejnerët aksesojnë volumin për ruajtjen e qëndrueshme të të dhënave, dhe informacioni ruhet në disqe që ndodhen në të gjithë rrjetin. Ky metodë unë do ta quaj "përqasje konteinerike me gjendje", dhe në pjesën tjetër të artikullit do ta quaj ashtu për shkak të uniformitetit.
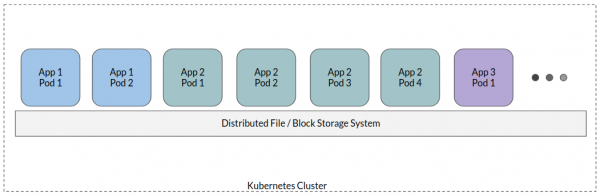
Me qasja tipike me kontejnerë që ruajnë gjendjen, të gjitha pods e aplikacioneve lidhen me një sistem të shpërndarë skedarësh - duke krijuar një lloj ruajtjeje të përbashkët, ku gjenden të dhënat e të gjitha aplikacioneve. Megjithëse mund të ketë disa variacione, ky është një qasje me nivel të lartë.
Tani le të shqyrtojmë se pse qasja me kontejnerë që ruajnë gjendjen në botën e orientuar drejt cloud-it është një antipattern.
Projektimi i aplikacioneve të orientuara drejt cloud-it
Tradicionalisht, aplikacionet përdornin bazat e të dhënave për ruajtjen e strukturuar të informacionit dhe disqet lokale ose sistemet e shpërndara të skedarëve, ku mblidheshin të gjitha të dhënat e pa-strukturuara ose madje gjysmë-strukturuara. Ndërsa volumi i të dhënave të pa-strukturuara rritej, zhvilluesit kuptuan se POSIX ishte tepër "i zëshëm", përfshirë kosto të konsiderueshme dhe, përfundimisht, pengonte funksionimin e aplikacionit kur kalonte në nivele të vërteta të mëdha.
Kjo kryesisht ndihmoi në shfaqjen e një standardi të ri për ruajtjen e të dhënave, që do të thotë, ruajtje të orientuar drejt cloud-it, që funksionon kryesisht mbi REST API dhe çliron aplikacionin nga mbikqyrja e ngarkuar e ruajtjes lokale të të dhënave. Në këtë rast, aplikacioni në fakt kalon në një mod të punës që nuk ruan gjendjen (pasi gjendja është në ruajtjen e largët). Aplikacionet moderne ndërtohen me këtë faktor në mendje. Si rregull, çdo aplikacion modern që proceson të dhëna të ndonjë lloji (logs, metadata, blobs, etj.) është ndërtuar mbi paradigmen e orientuar drejt cloud-it, ku gjendja transferohet në një sistem softuerik të veçantë për ruajtjen e saj.
Qasja me kontejnerë që ruajnë gjendjen e kthen tërë këtë paradigëm saktësisht atje ku filloi!
Duke përdorimi të ndërfaqeve POSIX për ruajtjen e të dhënave, aplikacionet punojnë ashtu siç do të bëjnë nëse do të ruanin gjendjen, dhe për këtë arsye, ata largohen nga postulatat më të rëndësishme të projektimit të orientuar ndaj cloud, pra, nga mundësia për të variuar përmasat e rrjedhave të punës të aplikacionit në varësi të ngarkesës së hyrjes, të kalojnë në një nyje të re sapo nyja aktuale të dështojë, e kështu me radhë.
Duke e shqyrtuar këtë situatë më afër, zbulojmë se kur zgjedhim ruajtjen e të dhënave, përsëri dhe përsëri hasim në dilemmën "POSIX kundër REST API", POR me një komplikim shtesë të problemeve POSIX të shkaktuara nga natyra e shpërndarë e mjediseve Kubernetes. Në veçanti,
- POSIX flet shumë: semantika POSIX kërkon të asociohet çdo operacion me metadatat dhe deshifruesit e skedarëve, të cilat ndihmojnë në mbështetje të gjendjes së operacionit. Kjo çon në shpenzime të konsiderueshme, pa ndonjë vlerë reale. API për ruajtjen e objekteve, në veçanti, S3 API, e ka hequr këtë kërkesë, duke lejuar që aplikacioni të punojë, e më pas "ta harrojë" thirrjen. Përgjigjja e sistemit të ruajtjes së të dhënave tregon nëse veprimi është përfunduar me sukses apo jo. Në rast dështimi, aplikacioni mund të bëjë një përpjekje të re.
- Kufizimet e rrjetit: Në një sistem të shpërndarë, supozohet se mund të ekzistojnë shumë aplikacione që përpiqen të shkruajnë të dhëna në të njëjtin mbajtës të lidhur. Prandaj, përveç se aplikacionet do të konkurrojnë me njëra-tjetrën për bandwidth (për të dërguar të dhëna në mbajtës), sistemi i ruajtjes së të dhënave vetë do të konkurrojë për këtë bandë, duke shpërndarë të dhëna përmes disqeve fizike. Për shkak të fjalëshkruarjes së POSIX, numri i thirrjeve rrjetit rritet disa herë. Nga ana tjetër, S3 API ofron një ndarje të qartë të thirrjeve rrjetore midis atyre që vijnë nga klienti në server, dhe atyre që ndodhin brenda serverit.
- Siguria: Modeli i sigurisë POSIX parashikon një angazhim aktiv të njeriut: administratorët konfigurojnë nivelet e veçanta të aksesit për çdo përdorues ose grup. Kjo paradigëm është e vështirë të përshtatet me botën cloud-oriented. Aplikacionet moderne varen nga modelet e sigurisë të lidhura me API, ku të drejtat e aksesit përcaktohen si një grup politikash, llogaritë e shërbimeve, kredencialet e përkohshme etj.
- Menaxhueshmëria: Konteinerët me ruajtje të qëndrueshme sjellin kosto të caktuara të lidhura me menaxhimin. Këtu flasim për sinkronizimin e aksesit të paralel për të dhënat, për të siguruar koherencën e të dhënave, gjithçka kjo kërkon një vlerësim të kujdesshëm të modeleve të aksesit të të dhënave që do të përdoren. Nështë e nevojshme të instalojmë, të kontrollojmë dhe konfigurojmë programe të tjera, pa përmendur përpjekjet shtesë të shpenzuara për zhvillim.
Interfaci i ruajtjes së të dhënave të konteinerëve
Ndërsa interfaci i ruajtjes së të dhënave të konteinerëve (CSI) ka ndihmuar shumë në shpërndarjen e nivelit të volumit të Kubernetes, duke e kaluar pjesërisht atë te ofruesit e tjerë të ruajtjes, por gjithashtu me rastin ndihmoi në bindjen se qasja e konteinerëve me ruajtje të qëndrueshme është metoda e rekomanduar për ruajtjen e të dhënave në Kubernetes.
CSI është zhvilluar si një standard për ofrimin e sistemeve të ruajtjes me bllok dhe skedarë të rastësishëm për aplikacionet e trashëguara gjatë punës me Kubernetes. Dhe, siç u tregua në këtë artikull, situata e vetme në të cilën qasja e konteinerëve me ruajtje të qëndrueshme (dhe CSI në formën e saj aktuale) është e arsyeshme – është kur vetë aplikacioni është një sistem i trashëguar, në të cilin nuk është e mundur të shtohet mbështetje për API-në e ruajtjes së objektit.
Është e rëndësishme të kuptohet se, duke përdorur CSI në formën e saj aktuale, pra, duke montuar volumin gjatë punës me aplikacionet moderne, ne do të përballemi me probleme të ngjashme me ato që shfaqeshin në sistemet ku ruajtja e të dhënave është organizuar në stilin POSIX.
Qasje më cilësore
Në këtë rast, është e rëndësishme të kuptojmë se shumica e aplikacioneve, në thelb, nuk janë të dizajnuara për të punuar me ruajtjen e gjendjes ose pa ruajtjen e gjendjes. Ky tipar varet nga arkitektura e përgjithshme e sistemit dhe nga variantet e veçanta të zgjedhura gjatë projektimit. Le të flasim pak rreth aplikacioneve që ruajnë gjendjen.
Në parim, të gjitha të dhënat e aplikacioneve mund të ndahen në disa kategori të gjera:
- Të dhëna log-esh
- Të dhëna të etiketave të kohës
- Të dhëna transaksionesh
- Metadatot
- Imazhe kontejnerësh
- Të dhëna blob-esh (objekte binarë të mëdhenj)
Të gjitha këto lloje të dhënash mbështeten shumë mirë në platformat moderne të ruajtjes së të dhënave, dhe ekzistojnë disa platforma të orientuara nga reja të përshtatura për të ofruar të dhëna në secilin nga këto formate specifike. Për shembull, të dhënat e transaksioneve dhe metadat e mund të ndodhen në një bazë të dhënash moderne të orientuar nga reja, siç janë CockroachDB, YugaByte, etj. Imazhet e kontejnerëve ose të dhënat e blob-eve mund të ruhen në regjistrin docker, të bazuar në MinIO. Të dhënat e etiketave të kohës mund të ruhen në një bazë të dhënash të serive të kohës, si InfluxDB, etj. Nuk do të futemi këtu në detajet e secilit lloj të dhënash dhe aplikacionet përkatëse, por ideja kryesore është të shmangim ruajtjen përhershme të të dhënave që bazohet në montimin lokal të disqeve.
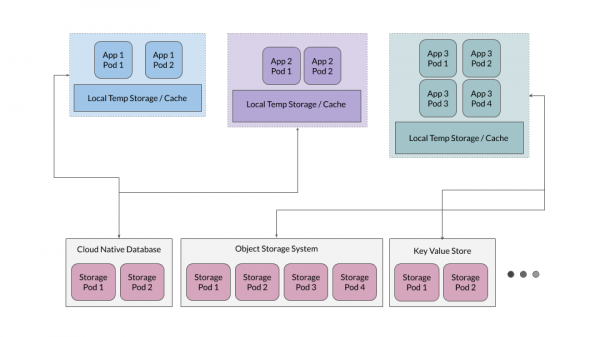
Për më tepër, shpesh është efektiv të ofrohet një nivel përkohësisht të ruajtjes, që shërben si një magazinë për skedarët përkohësisht, por aplikacionet nuk duhet të varen nga ky nivel si burimi i të vërtetës.
Ruajtja për aplikacione që ruajnë gjendjen
Ndërkohë që në shumicën e rasteve është e dobishme të kemi aplikacione pa gjendje, ato aplikacione që janë të destinuara për ruajtjen e të dhënave – si bazat e të dhënave, magazinat e objekteve, magazinat e çelësave dhe vlerave – duhet të ruajnë gjendjen. Le të shqyrtojmë arsyet pse këto aplikacione janë implementuar në Kubernetes. Si një shembull, le të marrim MinIO, por principe të ngjashme janë të aplikueshme edhe për çdo sistem tjetër të madh të ruajtjes së të dhënave të orientuara nga reja.
Aplikacionet e orientuara nga reja projektohen për të shfrytëzuar maksimalisht fleksibilitetin që ofrojnë kontejnerët. Kjo do të thotë se nuk bëhen asnjë supozim në lidhje me mjedisin në të cilin do të shpërndahen. Për shembull, MinIO përdor një mekanizëm të brendshëm të kodimit të tepruar (erasure coding) që siguron një qëndrushmëri të mjaftueshme për sistemin në mënyrë që të mbetet funksional edhe në rast dështimi të gjysmë të hard diskëve. Po ashtu, MinIO menaxhon integritetin dhe sigurinë e të dhënave duke përdorur hashing dhe enkriptim të vetin në anën e serverit.
Për aplikacionet e tilla të orientuara nga reja, volumi i qëndrueshëm lokal (PV) është zgjidhja më e përshtatshme për ruajtjen e rezervave. PV lokal ofron mundësinë për ruajtjen e të dhënave të papërpunuara, ndërsa aplikacionet që punojnë mbi këto PV mbledhin vetë informacionin që lejon që të dhënat të shkallëzohen dhe të menaxhohen kërkesat në rritje për të dhëna.
Ky qasje është shumë më e thjeshtë dhe shkallëzohet ndjeshëm më mirë se PV-të e bazuara në CSI, të cilat sjellin në sistem nivele të veta të menaxhimit të të dhënave dhe tepricave; problemi është se këto nivele zakonisht bien në kontradiktë me aplikacionet e dizajnuara sipas parimit të ruajtjes së gjendjes.
Lëvizje e sigurt drejt shkëputjes së të dhënave nga llogaritjet
Në këtë artikull diskutuam se si aplikacionet po riorientohen për të punuar pa ruajtje të gjendjes, ose, në fjalë të tjera, ruajtja e të dhënave ndahen nga llogaritjet mbi to. Në përfundim, le të shqyrtojmë disa shembuj realë të këtij trendi.
, platforma e njohur për analizën e të dhënave, tradicionalisht është përdorur me ruajtje gjendjeje dhe me shpërndarje në sistemin e skedarëve HDFS. Megjithatë, ndërsa Spark kalon në botën e orientuar nga reja, kjo platformë po përdoret gjithnjë e më shumë pa ruajtje gjendjeje duke përdorur `s3a`. Spark përdor s3a për të transferuar gjendjen në sisteme të tjera, ndërsa vetë kontejnerët e Spark punojnë në mënyrë të plotë pa ruajtje gjendjeje. Aktorë të tjerë të mëdhenj në fushën e analizës së të dhënave të mëdha, përkatësisht, , , po ashtu po kalojnë në punë me ndarjen e ruajtjes së të dhënave dhe llogaritjeve mbi to.
Modelet e ngjashme gjithashtu vërehen në platforma të tjera të mëdha analitike, përfshirë Presto, Tensorflow për R, Jupyter. Duke eksportuar gjendjen në sisteme të ruajtjes së të dhënave në re, bëhet shumë më e lehtë të menaxhosh aplikacionin tënd dhe ta shkallëzosh atë. Për më tepër, kjo ndihmon në portabilitetin e aplikacionit në mjedise të ndryshme.
Burimi: habr.com
