

Në këtë artikull do të flas për mënyrën se si projekti në të cilin punoj u transformua nga një monolit i madh në një grup mikroshërbimesh.
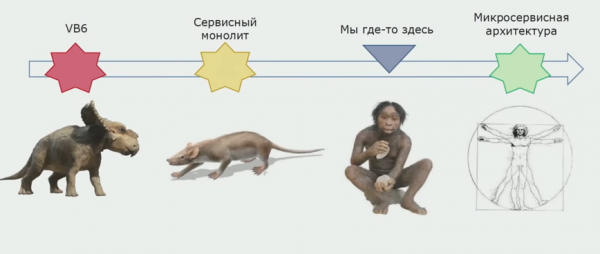
Projekti filloi historinë e tij mjaft kohë më parë, në fillim të viteve 2000. Versionet e para ishin shkruar në Visual Basic 6. Me kalimin e kohës, u bë evidente se zhvillimi në këtë gjuhë do të ishte i vështirë për t'u mbajtur, pasi IDE dhe vetë gjuha zhvilloheshin ngadalë. Në fund të viteve 2000, u vendos të kalojmë në një C# më të perspektivë. Versioni i ri u shkruajt paralelisht me përmirësimin e atij të vjetër, duke u bërë gradualisht më shumë kod në .NET. Backend në C# fillimisht ishte orientuar në një arkitekturë shërbimi, megjithatë gjatë zhvillimit u përdorën biblioteka të përbashkëta me logjikë, dhe shërbimet u startuan në një proces të vetëm. U krijua një aplikacion, të cilin e quajtëm "monolit shërbimi".
Një nga pak përfitimet e këtij kombinimi ishte mundësia e shërbimeve për të thirrur njëra-tjetrën përmes një API të jashtme. Kishin ekzistuar premisa të dukshme për kalimin në një arkitekturë më të drejtë shërbimi, dhe në perspektivë në arkitekturën mikroshërbimore.
Ne e filluam punën tonë për dekompozimin rreth vitit 2015. Ndërsa ende nuk kemi arritur një gjendje ideale - kanë mbetur pjesë të mëdha të projektit, të cilat tashmë është e vështirë t'i quajmë monolite, por as që ngjajnë me mikroshërbime. Megjithatë, progresi është i dukshëm.
Për këtë do të flas në artikull.
Përmbajtja
Arkitektura dhe problemet e zgjidhjes existente
Fillimisht, arkitektura dukej si më poshtë: UI - një aplikacion i veçantë, pjesa monolit është shkruar në Visual Basic 6, aplikacioni në .NET ishte një grup shërbimesh të lidhura, që punonin me një bazë të dhënash mjaft të madhe.
Disavantazhet e zgjidhjes së mëparshme
Pika e vetme e dështimit
Ne kemi pasur një pikë të vetme të dështimit: aplikacioni në .NET ekzekutohej në një proces. Nëse ndodhte ndonjë dështim në një prej moduleve, gjithë aplikacioni dështonte dhe duhej riaktivizuar. Duke qenë se kemi automatizuar një numër të madh procesesh për përdorues të ndryshëm, për shkak të një dështimi në njërin prej tyre, të gjithë nuk mund të punonin për një periudhë. As rezervimi nuk ndihmonte në rast të një gabimi programor.
Rradha e rregullimeve
Ky mangësi është më shumë organizativ. Në aplikacionin tonë ka shumë porositës, dhe të gjithë ata duan ta rregullojnë atë sa më shpejt që të jetë e mundur. Më parë, nuk ishte e mundur ta bënim këtë paralelisht, dhe të gjithë porositësit prisnin në rradhe. Ky proces shkaktonte negativitet për biznesin, pasi ata duhej të provonin se detyra e tyre kishte vlerë. Dhe ekipi i zhvillimit e kalonte kohën për të organizuar këtë rradhe. Kjo merrte shumë kohë dhe forcë, dhe produkti në fund nuk mund të ndryshonte aq shpejt sa dëshironin.
Përdorim i papërshtatshëm i burimeve
Kur vendosnim shërbimet në një proces të vetëm, gjithmonë e kopjonim plotësisht konfigurimin nga serveri në server. Na pëlqente të vendosnim shërbimet më të ngarkuara veçmas, për të mos humbur burimet kot dhe për të fituar një menaxhim më të fleksibël të skemës tonë të shpërndarjes.
E vështirë të implementosh teknologji moderne
Një problem që të gjithë zhvilluesit e njohin: ka dëshirë për të implementuar teknologji moderne në projekt, por nuk ka mundësi. Në një zgjidhje të madhe monolite, çdo përditësim i bibliotekës aktuale, duke mos përmendur kalimin në një të re, shndërrohet në një detyrë të mjaftueshme jo triviale. Duhet të argumentohet gjatë përpara liderit të ekipit, që kjo do të sjellë më shumë përfitime se sa nerva të shpenzuara.
Vështirësi në dhënien e ndryshimeve
Kjo ishte problemi më i rëndësishëm - ne lëshonim versionet çdo dy muaj.
Çdo lëshim shndërrohej në një katastrofë reale për bankën, pavarësisht testimeve dhe përpjekjeve të zhvilluesve. Biznesi e dinte se në fillim të javës do të kishte një pjesë të funksionaliteteve që nuk do të punonin. Dhe zhvilluesit e dinin se i priste një javë me incidente serioze.
Të gjithë kishin dëshirën për të ndryshuar situatën.
Pritet nga mikroshërbimet
Lëshimi i komponentëve sipas gatishmërisë. Lëshimi i komponentëve sipas gatishmërisë falë dekompozimit të zgjidhjes dhe ndarjes së proceseve të ndryshme.
Ekipet e vogla të produkteve. Kjo është e rëndësishme, sepse menaxhimi i një ekipi të madh që punon mbi një monolit të vjetër ishte e vështirë. Një ekip i tillë detyrohej të punonte sipas një procesi të rreptë, ndërsa do të dëshironin më shumë krijimtari dhe pavarësi. Këtë mund ta lejonin vetëm ekipet e vogla.
Izolimi i shërbimeve në procese të veçanta. Idealisht do të dëshironim të izolonim në kontejnerë, por numri i madh i shërbimeve të shkruara në .NET Framework funksionon vetëm nën Windows. Tani po shfaqen shërbime të reja në .NET Core, por janë ende të pakta.
Fleksibiliteti i implementimit. Do të donim të kombinonim shërbimet ashtu siç na nevojitet, dhe jo ashtu siç e detyron kodi.
Përdorimi i teknologjive të reja. Kjo është interesante për çdo programues.
Problemet e kalimit
Sigurisht, nëse ndarja e monolit në mikroshërbime do të ishte e lehtë, nuk do të flitej për këtë në konferenca dhe nuk do të shkruheshin artikuj. Ky proces ka shumë pengesa, do të përshkruaj ato kryesoret që na penguan.
Problemi i parë është tipik për shumicën e monoliteve: lidhshmëria e logjikës së biznesit. Kur shkruajmë monolit, ne duam të ripërdorim klasat tona për të mos shkruar kod të tepërt. Por, kur kalojmë në mikroshërbime, kjo bëhet një problem: i gjithë kodi është mjaft i lidhur ngushtë, dhe është e vështirë të ndajmë shërbimet.
Në momentin e fillimit të punës, në depo kishte më shumë se 500 projekte dhe më shumë se 700 mijë rreshta kodi. Kjo është një zgjidhje mjaft e madhe dhe problemi i dytë. Thjesht ta ndajmë atë në mikroshërbime nuk ishte e mundur.
Problemi i tretë është mungesa e infrastrukturës së nevojshme. Në thelb, ne ishim duke bërë kopjimin manual të kodit burimor në servera.
Si të kaloni nga monoliti në mikroshërbime
Dalja e mikroshërbimeve
Së pari, ne e përcaktuam menjëherë se ndarja e mikroshërbimeve është një proces iterativ. Na kërkohej gjithmonë të zhvilloheshim paralelisht me detyrat e biznesit. Si do ta realizonim këtë teknikisht – kjo ishte problemi ynë. Prandaj, ne u përgatitëm për një proces iterativ. Nuk do të funksiononte ndryshe, nëse keni një aplikacion të madh dhe ai fillimisht nuk është i gatshëm për t'u shkruar nga e para.
Cilat jemi ne mënyrat që përdorim për të dalë mikroshërbimet?
Mënyra e parë — të rregullojmë modulet ekzistuese si shërbime. Në këtë plan, kishim fat: shërbimet e gatshme ishin të dizajnuara duke punuar me protokollin WCF. Ato ishin të shpërndara në ndarje të veçanta. Ne i transferuam ato veçmas, duke i shtuar çdo ndarje një modul të vogël nisës. Ai ishte shkruar me bibliotekën e shkëlqyer Topshelf, e cila lejon të ekzekutohet aplikacioni si shërbim dhe si konsolë. Kjo është e përshtatshme për debugimin, pasi nuk kërkon projekte të tjera në zgjidhje.
Shërbimet ishin të lidhura me logjikën e biznesit, pasi përdornin ndarje të zakonshme dhe punonin me një bazë të përbashkët të të dhënave. Ishin të vështira për t'u quajtur mikrosherbime në sensin e pastër. Megjithatë, ne mund të shpërndanim këto shërbime veçmas, në procese të ndryshme. Kjo tashmë lejonte të zvogëlohej ndikimi i njëri-tjetrit, duke ulur problemin e zhvillimit paralel dhe pikës së vetme të dështimit.
Ndarja me hostin është vetëm një rresht kodi në klasën Program. Puna me Topshelf ishte fshehur në një klasë ndihmëse.
namespace RBA.Services.Accounts.Host
{
   internal class Program
   {
      private static void Main(string[] args)
      {
        HostRunner.Run("RBA.Services.Accounts.Host");

       }
    }
}
Mënyra e dytë e ndarjes së mikrosherbimeve: të krijojmë ato për të zgjidhur detyra të reja. Nëse në këtë rast monoliti nuk rritet, kjo është një gjë e shkëlqyer, që do të thotë se po lëvizim në drejtimin e duhur. Për zgjidhjen e detyrave të reja ne përpiqeshim të bënim shërbime të veçanta. Nëse kishte mundësi, atëherë krijonim shërbime më "kanonike", të cilat menaxhojnë plotësisht modelin e tyre të të dhënave, një bazë të dhënash të veçantë.
Ne, si shumë të tjerë, filluam me shërbimet e autentifikimit dhe autorizimit. Ato janë të përshtatshme për këtë. Ato janë të pavarura, zakonisht kanë një model të veçantë të të dhënave. Ato vetë nuk ndërveprojnë me monolitin, vetëm ai iu drejtohet atyre për të zgjidhur ndonjë detyrë. Në këto shërbime mund të fillojmë kalimin në një arkitekturë të re, t'i përshtatnim infrastruktura, të provonim disa qasje të lidhura me bibliotekat e rrjetit, etj. Në organizatën tonë nuk ka ekipe të cilat nuk do të mund të krijonin një shërbim autentifikimi.
Mënyra e tretë e ndarjes së mikrosherbimeve, i cili është pak specifik për ne. Kjo është nxjerrja e logjikës biznesore nga shtresa UI. Aplikacioni ynë kryesor i UI është desktop, i shkruar në C# si backend-u. Zhvilluesit ndonjëherë gabonin dhe sillnin pjesë të logjikës në UI, që duhej të ekzistonin në backend dhe të ripërdoren.
Nëse shohim një shembull real nga kodi i pjesës UI, shihet se shumica e këtij zgjidhjeje përmban logjikën reale të biznesit, e cila është e dobishme në procese të tjera, jo vetëm për ndërtimin e formularëve UI.
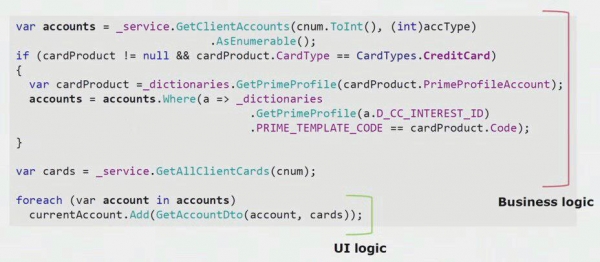
Logjika reale të UI aty ka vetëm dy rreshta të fundit. Ne e kemi transferuar atë në server për ta bërë të ripërdorshme, duke reduktuar kështu UI-në dhe arritur një arkitekturë të duhur.
Mënyra e katërt, më e rëndësishme për të ndarë mikroshërbimet, e cila lejon të reduktojë monolit, është nxjerrja e shërbimeve ekzistuese me ripërpunim. Kur ne nxjerrim module ekzistuese ashtu si janë, rezultati nuk i pëlqen gjithmonë zhvilluesve, dhe procesi i biznesit mund të jetë kthyer pas nga koha e krijimit të funksionalitetit. Falë refaktorizimit, ne mund të mbështesim një proces të ri biznesi, sepse kërkesat e biznesit vazhdimisht ndryshojnë. Ne mund të përmirësojmë kodin burimor, të hoqim defekte të njohura, të krijojmë një model më cilësor të të dhënave. Përfitime të shumta grumbullohen.
Ndarja e shërbimeve me ripërpunim është e lidhur ngushtë me konceptin e kontekstit të kufizuar. Ky është një koncept nga dizajni i orientuar nga subjekti. Ai do të thotë një pjesë e modelit të fushës, ku të gjitha termat e gjuhës së njëjtë janë të përcaktuara qartë. Le ta ilustrojmë me shembullin e konteksteve të sigurimeve dhe faturave. Ne kemi një aplikacion monolit dhe është e nevojshme të punojmë me faturën në sigurime. Ne presim që zhvilluesi të gjejë në një ndërrim të ndryshëm klasën ekzistuese 'Faturë', të bëjë një lidhje me të nga klasa 'Sigurim', dhe të marrim kod në punë. Parimi DRY do të respektohet, detyra do të realizohet më shpejt përmes përdorimit të kodit ekzistues.
Si përshtatet, kontekstet e llogarive dhe të sigurimeve janë të lidhura. Kur të shfaqen kërkesa të reja, kjo lidhje do t'i pengojë zhvillimet, duke e rritur kompleksitetin e logjikës së biznesit tashmë të ndërlikuar. Për të zgjidhur këtë problem, duhet të gjejmë kufijtë midis konteksteve në kod dhe të heqim shkeljet e tyre. Për shembull, konteksti i sigurimeve do të mjaftonte me një numër llogarie 20-shifror të BQK-së dhe datën e hapjes së llogarisë.
Për të ndarë këto kontekste të kufizuar nga njëri-tjetri dhe për të filluar procesin e veçimit të mikroservicëve nga zgjidhja monolitike, ne kemi përdorur një qasje si krijimi i API-ve të jashtme brenda aplikacionit. Nëse e dinim se një modul duhej të bëhej mikroservic, dhe do të ndryshonte në kuadër të procesit, ne menjëherë bënim thirrjet e logjikës së që i takon një konteksti tjetër të kufizuar, përmes thirrjeve të jashtme. Për shembull, përmes REST ose WCF.
Ne e kemi bërë një vendim të fortë për ta shmangur kodin që do të kërkonte të bënte transaksione të shpërndara. Në rastin tonë ka rezultuar mjaft e lehtë ta respektojmë këtë rregull. Akoma nuk kemi hasur situata ku do të nevojiteshin transaksione të rrepta të shpërndara — mjafton konsistenca përfundimtare midis moduleve.
Le të shqyrtojmë një shembull konkret. Ne kemi konceptin e orkestratorit — një konvej që përpunon entitetin e "kërkesës". Ai për radhë krijon klientin, llogarinë dhe kartelën bankare. Nëse klienti dhe llogaria krijohen me sukses, por krijimi i kartelës dështoi, kërkesa nuk kalon në statusin "me sukses" dhe mbetet në statusin "kartela nuk u krijua". Në të ardhmen, aktiviteti në sfond do ta kapë dhe do ta përfundojë. Sistemi ndodhet për një kohë në një gjendje të papërshtatshmërisë, por kjo na përmbush përgjithësisht.
Në rast se ndodh një situatë ku duhet të ruajmë një pjesë të të dhënave në mënyrë të akorduar, ne, me shumë gjasa, do të shkojmë në një konsolidim të shërbimit për ta përpunuar këtë në një proces të vetëm.
Le të shqyrtojmë shembullin e veçimit të një mikroservici. Si mund ta çojmë atë në prodhim në një mënyrë relativisht të sigurt? Në këtë shembull kemi një pjesë të veçantë të sistemit — modul të shërbimeve të pagave, një nga pjesët e kodit të cilit dëshirojmë ta bëjmë mikroservic.
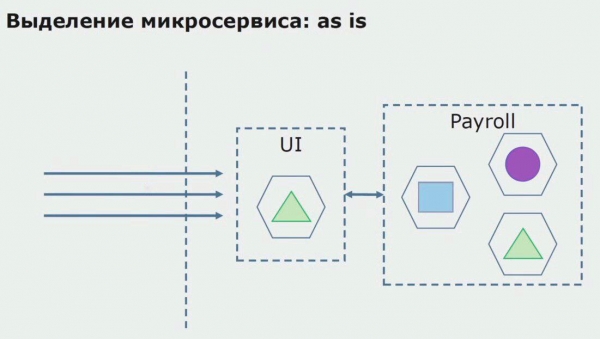
Së pari krijojmë një mikroshërbim, duke e rishkruar kodin. Përmirësojmë disa nga aspektet që nuk na kënaqin. Realizojmë kërkesat e reja të biznesit nga klienti. Shtojmë një API Gateway në lidhjen midis UI dhe backend-i, e cila do të sigurojë kalimin e thirrjeve.
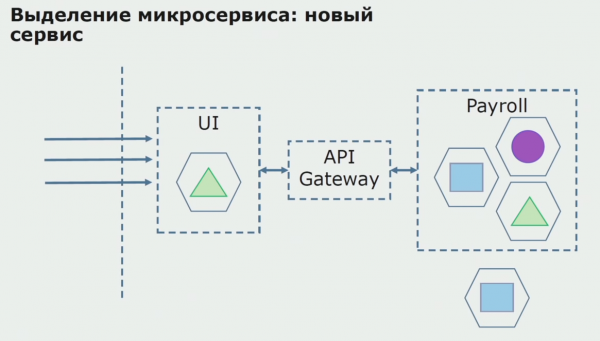
Më pas e lëshojmë këtë konfigruacion në prodhim, por në gjendje piloti. Shumica e përdoruesve tanë ende punojnë me proceset e vjetra të biznesit. Për përdoruesit e rinj, ne zhvillojmë një version të ri të aplikacionit monolit, i cili këtë proces nuk e përmban më. Në fakt, në formë piloti kemi një lidhje midis monolit dhe mikroshërbimit.
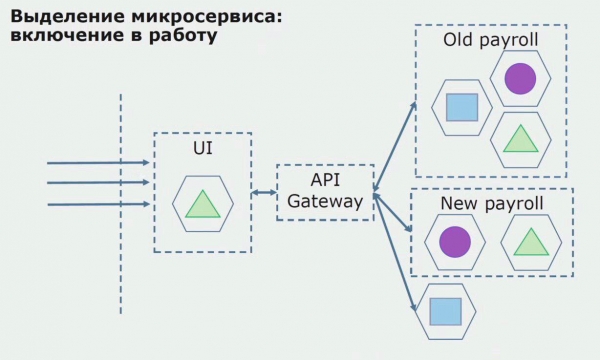
Me një pilot të suksesshëm kuptojmë se konfiguracioni i ri është në të vërtetë funksional, mund të heqim monolitin e vjetër nga ekuacioni dhe të lëmë konfiguracionin e ri në vend të zgjidhjes së vjetër.
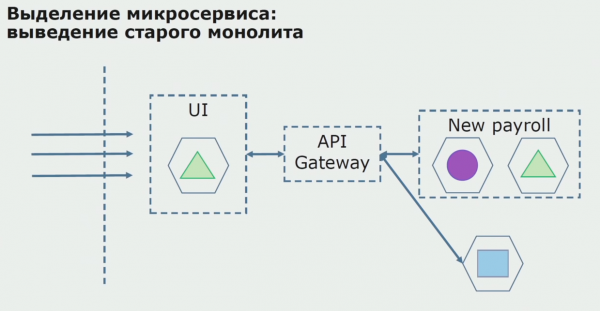
Pra, ne përdorim praktikisht të gjitha metodat ekzistuese për ndarjen e kodit burimor të monolitit. Të gjitha këto na lejojnë të zvogëlojmë madhësinë e pjesëve të aplikacionit dhe t'i kalojmë ato në bibliotekat e reja, duke bërë kodin burimor më cilësor.
Puna me DB
Baza e të dhënave ndahet më keq se kodi burimor, pasi ajo përmban jo vetëm skemën aktuale, por edhe të dhënat historike të grumbulluara.
Baza e të dhënave tonë, si shumë të tjera, kishte një tjetër të metë të rëndësishme — madhësinë e saj të madhe. Kjo Baze të Dhënash u projektua sipas logjikës së ndërlikuar të biznesit të monolitit, dhe midis tabelave të konteksteve të ndryshme të kufizuara u grumbulluan lidhje.
Në rastin tonë, përveç të gjitha problemeve (baza e madhe e të dhënave, shumë lidhje, ndonjëherë kufij të paqartë midis tabelave) u shfaq një problem i zakonshëm në shumë projekte të mëdha: përdorimi i modelit të bazës së të dhënave të ndarë. Të dhënat merren nga tabelat përmes view-s, përmes replikimit dhe dërgohen në sisteme të tjera, ku nevojitet kjo replikim. Si rezultat, ne nuk mund të nxjerrim tabelat në një skemë të veçantë, sepse ato ishin aktivisht të përdorura.
Në ndarjen na ndihmon ai ndarje në kontekste të kufizuara në kod. Kjo, në përgjithësi, na jep një ide mjaft të mirë se si i ndajmë të dhënat në nivelin e bazës së të dhënave. Ne kuptojmë se cilat tabela i përkasin një konteksti të kufizuar dhe cilat të tjerave.
Ne kemi aplikuar dy mënyra globale të ndarjes së bazës së të dhënave: ndarjen e tabelave ekzistuese dhe ndarjen me përpunim.
Ndarja e tabelave ekzistuese është një metodë që është mirë të aplikohet kur struktura e të dhënave është e mirë, përmbush kërkesat e biznesit dhe të gjithë janë të kënaqur. Në këtë rast, ne mund të nxjerrim tabelat ekzistuese në një skemë të veçantë.
Ndarja me përpunim është e nevojshme kur modeli i biznesit ka ndryshuar ndjeshëm dhe tabelat nuk na plotësojnë më.
Ndarja e tabelave ekzistuese. Na nevojitet të përcaktojmë se çfarë do të ndajmë. Pa këtë njohuri, asgjë nuk do të jetë e mundur, dhe këtu do të na ndihmojë ndarja e konteksteve të kufizuara në kod. Zakonisht, nëse arrijmë të kuptojmë kufijtë e konteksteve në kodin burimor, bëhet e qartë se cilat tabela duhet të përfshihen në listën për ndarje.
Le të imagjinojmë se kemi një zgjidhje, në të cilën dy module të monolit ndërveprojnë me një bazë të dhënash. Na nevojitet të bëjmë që me pjesën e tabelave të ndara të ndërveprojë vetëm një modul, ndërsa tjetri të fillojë të ndërveprojë me të përmes API. Në fillim, mjafton që të ketë vetëm shkrim përmes API. Ky është një kusht i nevojshëm për të diskutuar mbi pavarësinë e mikroshërbimeve. Lidhjet për lexim mund të mbeten, derisa nuk ka ndonjë problem të madh.
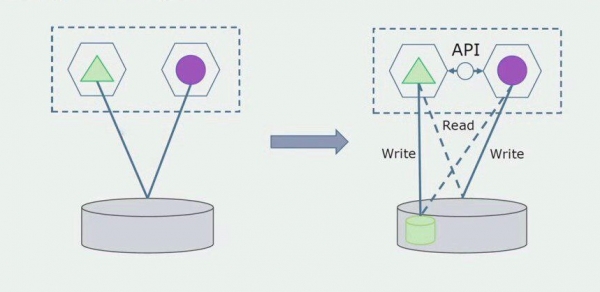
Hapi tjetër është që ne mund ta ndajmë kodin që punon me tabelat e ndara, me përpunim ose pa përpunim, në një mikroshërbim të veçantë dhe ta ekzekutojmë në një proces të veçantë, kontejner. Ky do të jetë një shërbim i veçantë me lidhje me bazën e të dhënave të monolit dhe ato tabela që nuk i përkasin drejtpërdrejt atij. Monoliti akoma ndërvepron për lexim me pjesën e ndarë.
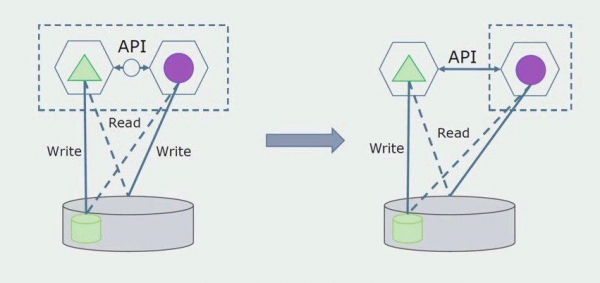
Më vonë ne do ta heqim këtë lidhje, domethënë leximin e të dhënave nga aplikacioni monolit nga tabelat e ndara gjithashtu do ta transferojmë në API.
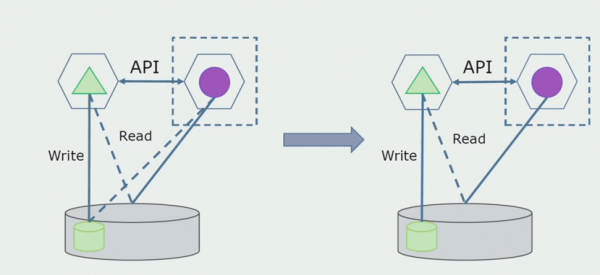
Më pas do të ndajmë nga Baza e Dhënash e përgjithshme tabelat me të cilat punon vetëm mikroshërbimi i ri. Ne mund të nxjerrim tabelat në një skemë të veçantë ose madje në një Baza të Dhënash fizike të veçantë. Ka një lidhje për lexim midis mikroshërbimit dhe Baza e Dhënash të monolit, por në këtë nuk ka asgjë të keqe, në një konfiguratë të tillë ai mund të jetojë mjaft gjatë.
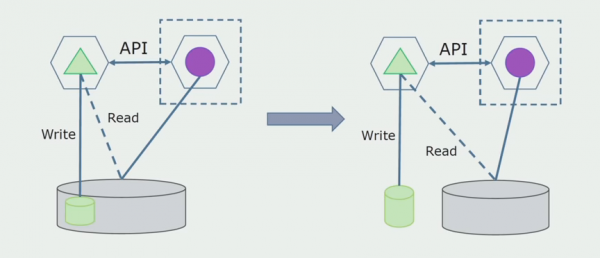
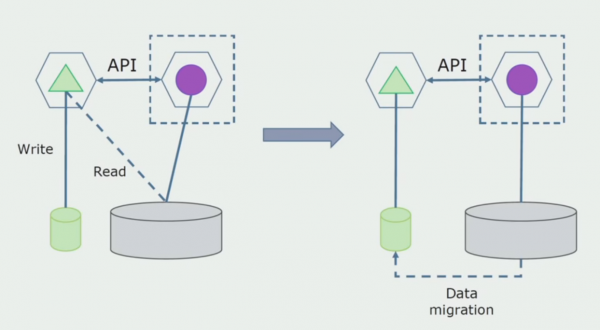
Hapi i fundit është të hiqni plotësisht të gjitha lidhjet. Në këtë rast, ndoshta do të na nevojitet migrimi i të dhënave nga baza kryesore. Ndonjëherë do të duam të ripërdorim disa të dhëna ose lista të cilat janë replikuar nga sisteme të jashtme në disa baza. Kjo na ndodh periodikisht.
Departamenti i tepërishëm. Ky metod është shumë i ngjashëm me të parin, por shkon në anën e kundërt. Ne menjëherë krijojmë një bazë të re të dhënash dhe një mikro-shërbim të ri që komunikon me monolitin përmes API-t. Por me këtë, ngelen një set tabelash në bazën e të dhënave që dëshirojmë t'i heqim në të ardhmen. Kjo nuk na nevojitet më, në modelin e ri e kemi zëvendësuar atë.
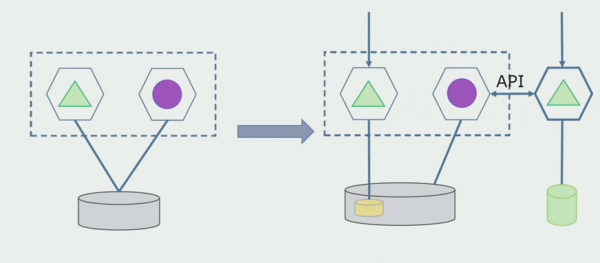
Për që kjo skemë të funksionojë, ndoshta do të na nevojitet një periudhë kalimi.
Më pas ka dy qasje të mundshme.
First: ne kopjojmë të gjitha të dhënat në bazat e reja dhe të vjetra. Në këtë rast na krijohet tepërsi të dhënash, mund të ndodhin probleme me sinkronizimin. Por kështu mund të kemi dy klientë të ndryshëm. Një do të punojë me versionin e ri, tjetri me versionin e vjetër.
E dyta: ndajmë të dhënat sipas ndonjë kriteri biznesi. Për shembull, në sistemin tonë kishte 5 produkte që ruheshin në bazën e të dhënave të vjetra. Një e gjashtë në kuadër të detyrës së re të biznesit e vendosim në bazën e re. Por do na nevojitet një API Gateway që sinkronizon këto të dhëna dhe tregon klientit se nga e ku mund të marrë.
Të dy qasjet janë funksionale, zgjidhni në varësi të situatës.
Pasi të jemi siguruar që gjithçka funksionon, pjesa e monolitit që punon me strukturat e vjetra të bazës së të dhënave mund të fiket.
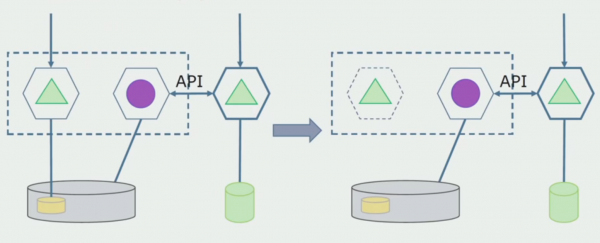
Hapi i fundit do të jetë shpërbërja e strukturave të vjetra të të dhënave.
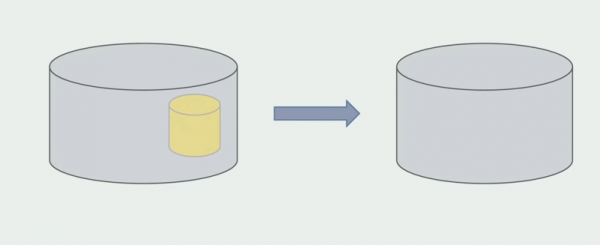
Duke përmbledhur, mund të themi se kemi probleme me bazën e të dhënave: është e vështirë të punosh me të krahasuar me kodin burimor, ndarja është më e komplikuar, por kjo është diçka që mund dhe duhet të bëhet. Ne kemi gjetur disa mënyra që lejojnë ta bëjmë këtë mjaft të sigurt, megjithatë, të gabosh me të dhënat është më e lehtë sesa me kodin burimor.
Puna me kodin burimor
Ja si dukej skema e kodit burimor kur filluam të analizojmë projektin monolit.
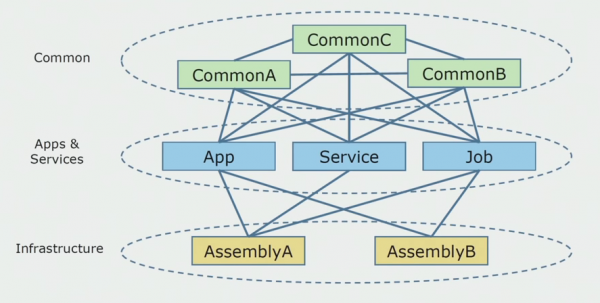
Ajo mund ta ndajmë në tre shtresa. Kjo është shtresa e moduleve të aktivizueshëm, e plogjeve, shërbimeve dhe aktiviteteve të veçanta. Faktikisht, këto ishin pikënisje brenda një zgjidhjeje monolite. Të gjitha ato ishin të lidhura ngushtë me shtresën e Common. Ajo përmbante logjikën e biznesit që shërbimet e përdornin së bashku, dhe shumë lidhje. Çdo shërbim dhe plog përdorte deri në 10 dhe më shumë mbledhje të zakonshme, në varësi të madhësisë së tyre dhe ndërgjegjësisë së zhvilluesve.
Na ndodhi me fat, kishim biblioteka infrastrukturore që mund të përdoren veçmas.
Ndonjëherë ndodhte që disa objekte të Common në të vërtetë nuk i përkisnin kësaj shtrese, por ishin biblioteka infrastrukturore. Kjo zgjidhej me riemërim.
Konceptet e kufizuara ngjanin më shqetësuese. Ndonjëherë 3-4 kontekste përziheshin në një mbledhje të Common dhe përdornin njëri-tjetrin brenda funksioneve të biznesit. Duhej të kuptonim se ku mund të ndaheshin dhe çfarë të bënim më pas me kartelat për këtë ndarje në mbledhjet e kodit burim.
Ne formuluam disa rregulla për procesin e ndarjes së kodit.
E para: ne nuk donim më ndarjen e logjikës së biznesit midis shërbimeve, aktiviteteve dhe plogjeve. Donim ta bënim logjikën e biznesit të pavarur brenda mikrosherbimeve. Nga ana tjetër, mikrosherbimet, në ideale, perceptohen si shërbime që ekzistojnë krejtësisht pavarur. Unë mendoj se ky qasje është disi e shtrenjtë dhe e vështirë për t'u arritur, pasi, për shembull, shërbimet në C# do të lidhen ndonjëherë me bibliotekën standarde. Sistemi ynë është shkruar në C#, nuk kemi pasur nevojë të përdorim teknologji të tjera për momentin. Prandaj, ne vendosëm se mund ta lejonim veten të përdornim mbledhje teknike të zakonshme. E rëndësishme është që në to të mos ketë asnjë fragment të logjikës së biznesit. Nëse keni një mbulesë të përshtatshme mbi ORM që përdorni, atëherë kopjimi i saj nga shërbimi në shërbim është shumë i shtrenjtë.
Ekipi ynë është adhurues i dizajnit të orientuar drejt objektit, prandaj "arkitektura e qepës" na përshtatet shumicës. Një bazë në shërbimet tona nuk është layer-i i aksesit në të dhëna, por një ndërtim me logjikën e domenit, e cila përmban vetëm logjikën biznesore dhe është e lirë nga lidhjet me infrastrukturën. Në të njëjtën kohë, ne mund të zhvillojmë në mënyrë të pavarur ndërtimin e domenit për të zgjidhur problemet që lidhen me framorkat.
Në këtë fazë, ne u përballëm me problemin e parë serioz. Shërbimi duhet të referohet në një ndërtim të vetëm të domenit, dhe ne donim ta bamisnim logjikën si të pavarur, por këtu na pengonte fort principi DRY. Zhvilluesit donin, për të shmangur përsëritjen, të ripërdornin klasat nga ndërtimet fqinj, dhe si rezultat, domenet filluan sërish të lidhen me njëra-tjetrën. Ne analizuam rezultatet dhe vendosëm se ndoshta problemi ishte edhe në ndërtimin e sistemit të ruajtjes së kodit burimor. Ne kishim një depo të madhe, ku ndodheshin të gjithë kodet burimore. Zgjidhja për tërë projektin ishte shumë e vështirë të mblidhej në makinat lokale. Prandaj, për pjesët e projektit krijoheshin ndërtime të vogla të veçanta, dhe askush nuk ndalonte të shtonte ndonjë ndërtim Common ose të domenit dhe ta ripërdorte atë. Vegla e vetme që nuk na lejonte ta bënim këtë ishte shqyrtimi i kodit. Por ndonjëherë edhe ai dështonte.
Atëherë ne filluam kalimin në modelin me depo të veçanta. Logjika biznesore nuk filloi më të rrjedhë nga shërbimi në shërbim, domenet vërtet u bënë të pavarura. Konceptet e kufizuara mbështeten më qartë. Si i ripërdorim bibliotekat infrastrukturore? Ne i përjashtuam ato në një depo të veçantë dhe më pas i vendosëm në paketat Nuget, të cilat i vendosëm në Artifactory. Me çdo ndryshim, ndërtimi dhe publikimi ndodhin automatikisht.
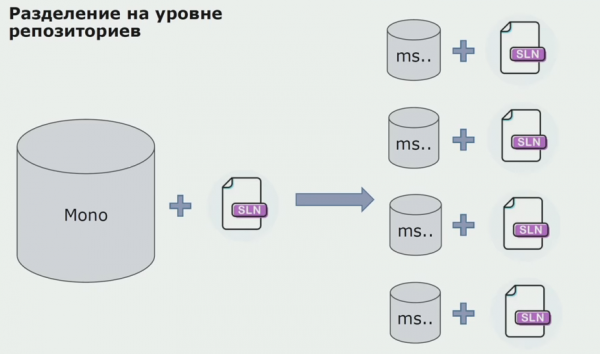
Shërbimet tona filluan të referohen në paketat e brendshme infrastrukturore në të njëjtën mënyrë si edhe në ato të jashtme. Bibliotekat e jashtme i shkarkojmë nga Nuget. Për të punuar me Artifactory, ku i vendosnim këto paketa, ne përdorëm dy menaxherë paketash. Edhe në depo të vogla ne përdorim Nuget. Në depo me disa shërbime përdorëm Paket, i cili ofron më shumë koherencë versioni midis moduleve.
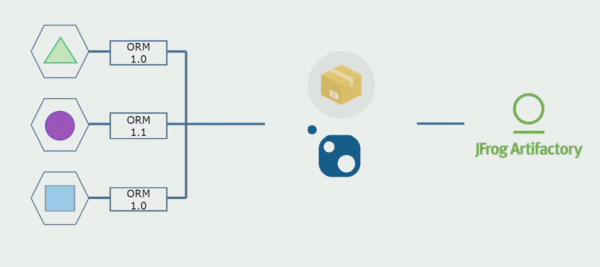
Kështu, duke punuar mbi kodin burimor, duke e ndryshuar pak arkitekturën dhe duke ndarë repository-t, ne bëjmë shërbimet tona më të pavarura.
Problemet e Infrastrukturës
Shumica e disavantazheve kur kaloni në mikroshërbime lidhen me infrastrukturën. Do t'ju duhet një implementim automatizuar, dhe do t'ju nevojiten biblioteka të reja për të punuar me infrastrukturen.
Instalimi manual në mjedise
Fillimisht, ne e vendosnim zgjidhjen në mjedise manualisht. Për ta automatizuar këtë proces, krijuam një pipeline CI/CD. Zgjodhëm procesin e dërgimit vazhdimës për shkak se dërgimi i vazhdueshëm për ne ende nuk është i pranueshëm nga pikëpamja e proceseve biznesore. Prandaj, dërgimi në prodhim bëhet me një buton, ndërsa testimi — automatikisht.
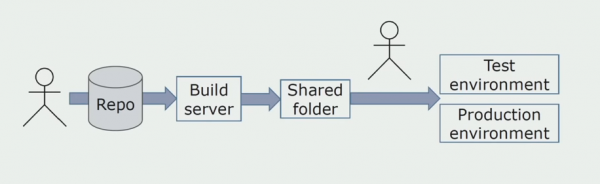
Ne përdorim Atlassian, Bitbucket për ruajtjen e kodit burimor dhe Bamboo për ndërtimin. Na pëlqen të shkruajmë skripta ndërtimi në Cake, sepse është e njëjta gjuhë si C#. Paketat përfundojnë në Artifactory, dhe Ansible automatikisht dërgon në serverat e testimit, pas së cilës ato mund të testohet menjëherë.
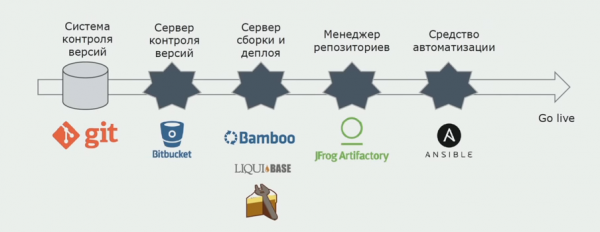
Logimi i veçuar
Në kohën e tij, një nga idetë e monolit ishte sigurimi i regjistrimit të përbashkët. Ne gjithashtu duhej të kuptonim se çfarë të bënim me regjistrat e veçantë që ndodheshin në disqe. Regjistrat tanë shkruhen në skedarë tekstualë. Vendosëm të përdorim stakun standard ELK. Nuk u futëm direkt në ELK përmes ofruesve, por vendosëm që do të përmirësonim regjistrat tekstualë dhe do të shkruanim ID-në e gjurmimit si një identifikues, duke shtuar emrin e shërbimit, në mënyrë që këta regjistra më pas të ishin të analizueshëm.
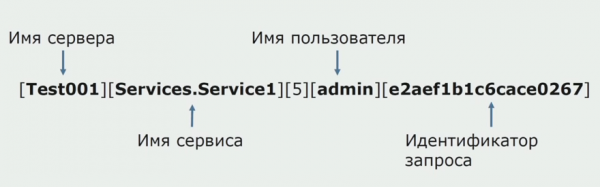
Me ndihmën e Filebeat ne marrim mundësinë të mbledhim regjistrat tanë nga serverësh, pastaj t'i konvertojmë, me Kibana të krijojmë kërkesa në UI dhe të shohim se si ndodhi thirrja midis shërbimeve. Këtë e ndihmon shumë ID e gjurmimit.
Testimi dhe debagimi i shërbimeve të lidhura
Në fillim, nuk e kuptonim plotësisht se si të rregullonim shërbimet që po zhvillonim. Me monolitin gjithçka ishte e thjeshtë, e lançonim atë në makinën lokale. Në fillim, përpiqeshim të bënim të njëjtën gjë me mikroshërbimet, por ndonjëherë për të lansuar plotësisht një mikroshërbim, duhet të lansosh edhe disa të tjerë, dhe kjo ishte e papraktikueshme. E kuptuam se duhej të kalonim në një model ku lëmë në makinën lokale vetëm shërbimin ose shërbimet që dëshirojmë të rregullojmë. Shërbimet e tjera përdoren nga servera që përputhen me konfigurimin e prodhimit. Pas rregullimit, gjatë testimit, për çdo detyrë në serverin testues lëshohen vetëm shërbimet e ndryshuara. Kështu, testi bëhet në formën që do të jetë në prodhim në të ardhmen.
Janë serverë ku qëndrojnë vetëm versionet e prodhimit të shërbimeve. Këta serverë janë të nevojshëm në rast incidentesh, për verifikimin e dërgesave para shpërndarjes dhe për trajnime të brendshme.
Ne kemi shtuar një proces të testimit automatizuar duke përdorur bibliotekën e njohur Specflow. Testet ekzekutohen automatikisht me NUnit menjëherë pas lançimit nga Ansible. Nëse mbulimi i detyrës është plotësisht automatizuar, atëherë nuk ka nevojë për testim manual. Megjithatë, ndonjëherë kërkohet akoma testim manual shtesë. Për të përcaktuar se cilat teste të ekzekutohen për një detyrë të caktuar, ne përdorim etiketat në Jira.
Ndërkohë, është rritur nevoja për testimin e ngarkesës, i cili më parë bëhej vetëm në raste të veçanta. Për të ekzekutuar testet, ne përdorim JMeter, për ruajtjen e tyre — InfluxDB, dhe për ndërtimin e grafikëve të procesit — Grafana.
Çfarë kemi arritur?
Së pari, ne u shliruan nga koncepti i 'lëshimit'. U zhdukën lëshimet monstruoze dy mujore, kur kjo makineri lëshohej në ambientin e prodhimit, duke dëmtuar përkohësisht proceset biznesore. Tani ne lëshojmë shërbimet në mesatare çdo 1.5 ditë, duke i grupuar ato, sepse ato dalin në operim pas miratimit.
Në sistemin tonë nuk ka dështime fatale. Nëse lëshojmë një mikroshërbim me një gabim, atëherë funksionaliteti i lidhur do të dëmtohet, ndërsa të gjitha funksionalitetet e tjera nuk do të preken. Kjo e përmirëson ndjeshëm përvojën e përdoruesit.
Ne mund të menaxhojmë skemën e shpërndarjes. Mund të ndahen grupe shërbimesh nga zgjidhja e përgjithshme nëse ka nevojë.
Për më tepër, kemi reduktuar ndjeshëm problemin e radhës së gjatë të përmirësimeve. Kemi krijuar ekipe të veçanta produktesh që punojnë me disa shërbime në mënyrë të pavarur. Procesi Scrum i përshtatet plotësisht këtu. Një ekip konkret mund të ketë një pronar produkti të veçantë që i jep atij detyra.
CV
- Mikroshërbimet janë të përshtatshme për dekompozimin e sistemeve komplekse. Në proces, fillojmë të kuptojmë se çfarë ka në sistemin tonë, cilat janë kufizimet, dhe ku janë kufijtë e tyre. Kjo lejon ndarjen e rregullt të përmirësimeve midis moduleve dhe shmang ndërlikimin e kodit.
- Mikroshërbimet ofrojnë përfitime organizative. Shpesh flitet për to vetëm si një arkitekturë, por çdo arkitekturë është e nevojshme për të përmbushur nevojat e biznesit dhe jo për vete. Prandaj, mund të themi se mikroshërbimet janë të përshtatshme për zgjidhjen e detyrave nga ekipe të vogla, duke pasur parasysh se tani është shumë popullor Scrum.
- Ndarja është një proces iterativ. Nuk mund të merren aplikacione dhe thjesht të ndahet në mikroshërbime. Produkti i marrë vështirë se do të jetë funksional. Kur ndahen mikroshërbimet, është e dobishme të rishkruhet kodet ekzistuese legacy, që do të thotë ta kthejmë atë në kodin që na pëlqen dhe që plotëson më mirë nevojat e biznesit për funksionalitet dhe shpejtësi.
Një paralajmërim i vogël: kostot e kalimit në mikroshërbime janë mjaft të konsiderueshme. Vetëm për të zgjidhur problemin e infrastrukturës u kërkua shumë kohë. Prandaj, nëse keni një aplikacion të vogël që nuk kërkon një shkallëzim specifik, dhe nuk ka shumë klientë që konkurrojnë për vëmendjen dhe kohën e ekipit tuaj, ndoshta mikroshërbimet nuk janë kjo që ju nevojitet sot. Kjo është mjaft e kushtueshme. Nëse e filloni procesin me mikroshërbime, costet fillimisht do të jenë më të larta se sa nëse do të filloni të njëjtin projekt me zhvillimin e një monolite.
P.S. Një tregim më emocional (siç duket për ju) – mbi .
Këtu është versioni i plotë i raportit.
Burimi: habr.com
