

Pakëm një diskutim së fundmi rreth asaj se si të rrisim performancën e pyetjeve SQL "për lexim" se si mund të bëjmë regjistrimin në DB pa përdorur ndonjë "rrëzë" në konfigurim — thjesht duke organizuar në mënyrë të duhur rrjedhat e të dhënave. Ky është një artikull mbi mënyrat dhe arsyet për të organizuar
#1. Секционирование
segmentimin aplikativ "në teori" shërbimit tonë të monitorimit të qindra serverëve PostgreSQL .
Fillimisht, si çdo MVP, projekti ynë ka filluar me një ngarkesë të vogël — monitorimi u bë vetëm për disa serverë kritikë, të gjitha tabelat ishin relativisht kompakte... Por koha kalonte, hostet e monitoruar po bëheshin gjithnjë e më shumë dhe, ashtu si herët e tjera, përpiqeshim të bënim diçka me njëra nga
tabelat me madhësi 1.5TB , ku kuptuam se mund të vazhdojmë, por ishte shumë e papërshtatshme.Koha ishte pothuajse si në legjenda, versionet e ndryshme të PostgreSQL 9.x ishin të zakonshme, prandaj të gjitha segmentimet duhej të bëheshin "në dorë" - përmes
trashëgimisë së tabelave dhe trigger-ave të rrugës me dinamik. Zgjidhja që morëm rezultoi mjaft universale, për t'u aplikuar mbi të gjitha tabelat: EKZEKUTO.
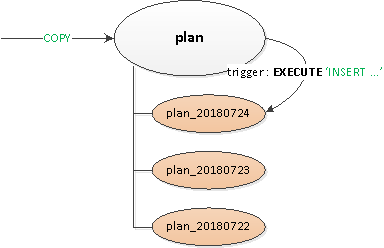
Ishte shpallur një tabelë e "prazët" prindërore, ku përshkruheshin të gjitha
- indeksit dhe triggerat e nevojshëm. Regjistrimi nga pikëpamja e klientit bëhej në tabelën "rrënjë", dhe brenda me anë të.
- trigger-it të rrugës BEFORE INSERT
regjistrimi "fizikisht" iu ngjit në seksionin e duhur. Nëse ajo nuk ekzistonte ende — ne zbulonim një përjashtim dhe …… me ndihmën e - CREATE TABLE ... (LIKE ... INCLUDING ...) një seksion me kufizimin e datës së dëshiruar , që gjatë nxjerrjes së të dhënave, leximi të bëhej vetëm aty.PG10: përpjekja e parë
Por segmentimi përmes trashëgimisë historikisht nuk ishte shumë i përshtatshëm për punë me një fluks aktiv regjistrimi ose numër të madh seksionesh pasardhëse. Për shembull, duhet të kujtojmë që algoritmi i zgjedhjes së seksionit të duhur kishte
kompleksitet katror , që me 100+ seksione punon, e kuptohet si…Në PG10 kjo situatë u optimizua ndjeshëm, duke implementuar mbështetje për
segmentimin natyror Prandaj, ne humbëm kohe dhe e provuam menjëherë pas migrimit të ruajtjes, por…
Siç u zbulua pas shfletimit të manualit, tabela e ndarë natyrale në këtë version:
- nuk mbështet përshkrimin e indekseve
- nuk mbështet aktivizimin e tyre
- nuk mund të jetë vetë asnjë "trashëguese"
- nuk mbështet
INSERT ... ON CONFLICT - nuk di të krijojë një seksion automatikisht
Pas një goditjeje në ballë nga gjethet, kuptuam se pa modifikimin e aplikacionit nuk do t'ia dilnim, dhe e shtymë kërkimin për gjashtë muaj.
PG10: një mundësi e dytë
Pra, filluam të zgjidhim problemet që kishim njëri pas tjetrit:
- Pasi që aktivizimet dhe
ON CONFLICTna u dukën të nevojshme në disa raste, për t'i përballuar ato krijuam një tabelë ndërmjetëse. - U shpëtuam "routings" në aktivizime - pra nga
EKZEKUTO. - Ndarëm veçmas një tabelë-model me të gjitha indekset, që ato të mos ishin të pranishme as në tabelën ndërmjetëse.
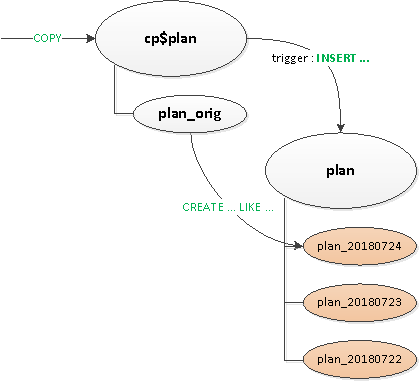
Përfundimisht, pas gjithë kësaj, ndamë tabelën kryesore natyralisht. Krijimi i një seksioni të ri mbeti në duar të aplikacionit.
"Dizem" fjalorët
Si në çdo sistem analitik, ne gjithashtu kishim "fakte" dhe "ndarje" (fjalorë). Në rastin tonë, në këtë rol u paraqitën, për shembull, të pyetjeve të ngadalta ose teksti i vetë pyetjes.
"Faktet" tona ishin ndarë sipas ditëve prej kohësh, prandaj ne i fshimë pa problem seksionet e vjetra, dhe ato nuk na penguan (të dhënat bëhen!). Megjithatë, me fjalorët rezultoi të ishte një problem...
Nuk mund të thuhet se kishte shumë, por rreth për çdo 100TB "faktesh" kishte një fjalor 2.5TB.Nga një tabelë e tillë nuk është e lehtë të hiqet apo të kompresohet ndonjë gjë në një kohë të arsyeshme, dhe regjistrimi në të bëhej gjithnjë e më i ngadalshëm.
Duket si një fjalor… çdo regjistrim duhet të jetë i pranishëm një herë saktësisht… dhe kjo është e saktë, por!.. Askush nuk na ndalon të kemi një fjalor të veçantë për çdo ditë! Po, kjo sjell një tepricë të caktuar, por lejon:
- të shkruajmë / lexojmë më shpejt për shkak të madhësisë më të vogël të seksionit
- të konsumojmë më pak memorie për shkak të punës me indekse më kompakte
- të ruajmë më pak të dhëna për shkak të mundësisë për të fshirë shpejt të dhënat e vjetra
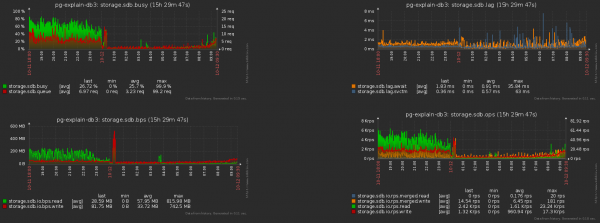
Si rezultat i gjithë kompleksit të masave ngarkesa e CPU u ul me ~30%, ngarkesa për disk - me ~50%:
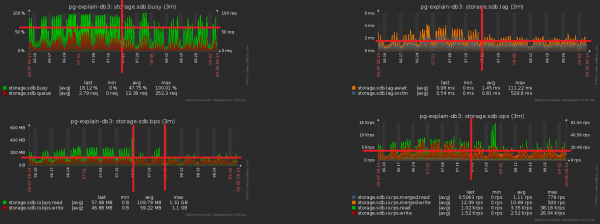
Në të njëjtën kohë vazhduam të shkruajmë në bazë pikërisht të njëjtat gjëra, thjesht me ngarkesë më të vogël.
#2. Эволюция и рефакторинг БД
Pra ndaj, ne u ndalëm tek se kemi një seksion për çdo ditë me të dhëna. Në fakt, CHECK (dt = '2018-10-12'::date) – dhe ky është çelësi i seksionimit dhe kushti për të hyrë regjistrimin në seksionin përkatës.
Duke qenë se të gjitha raportet në shërbimin tonë ndërtohen sipas datës specifike, indeksat e krijuar që nga "koha pa seksionim" për ato ishin gjithmonë të tipit (Server, Data, Shablloni i planit), (Server, Data, Nodi i planit), (Data, Klasë Gabimi, Server),…
Por tani në çdo seksion janë instancat e veta të çdo indeksi të tillë... Dhe në kuadër të çdo seksioni data është një konstantë... Kështu që tani ne në çdo indeks të tillë thjesht e shkruajmë konstantën si një nga fushat, çka rrit si madhësinë e tij, ashtu edhe kohën e kërkimit për të, por nuk sjell asnjë rezultat. Vetë i kemi lënë gabimet, ups...
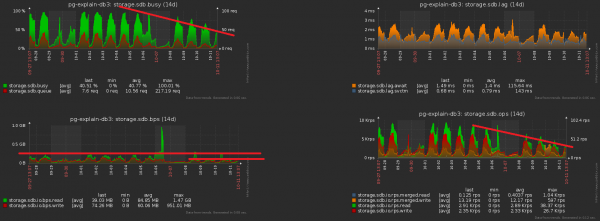
Drejtimi i optimizimit është evident — thjesht heqim fushën me datë nga të gjithë indeksat në tabelat e seksionuara. Me volume tona, fitimi është rreth 1TB/ja në javë!
Dhe tani le të vëmë re se ky terabajt ende duhet të regjistrohet ndonjëherë. Pra, ne gjithashtu duhet ta ngarkojmë disku tani më pak! Në këtë imazh duket mirë efekti i arritur nga pastrimi i kryer, të cilin ia kushtuam një javë:
#3. «Размазываем» пиковую нагрузку
Një nga fatkeqësitë e mëdha të sistemeve të ngarkuara është sinkronizimi i tepruar i disa operacioneve që nuk e kërkojnë atë. Nganjëherë "sepse nuk e vunë re", nganjëherë "ishte më e thjeshtë", por në një moment duhet të heqim dorë prej saj.
Afrojmë imazhin e mëparshëm — dhe shohim se disku ynë “ngarkon” në ngarkesë me amplitudë dyfish në mes të matjeve fqinjësore, gjë që dukshëm "statistikisht" nuk duhet të ndodhte me një numër të tillë operacionesh:
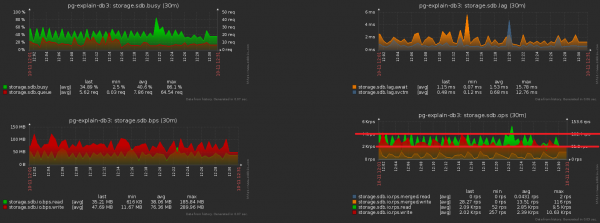
Të arrijmë këtë është mjaft e thjeshtë. Ne kishim tashmë praktikisht 1000 servera, secili përpunon një rrjedhë logjike të veçantë, dhe secila rrjedhë lëshon informacionin e akumuluar për t'u dërguar në bazën e të dhënave me një periodicitet të caktuar, më pak si kjo:
setInterval(sendToDB, interval)Problemi këtu qëndron në faktin se të gjitha rrjedhat nisin në një kohë të ngjashme, prandaj momentet e dërgimit pothuajse gjithmonë përputhen "deri në pikë". Ups №2...
Për fat, kjo rregullohet mjaft lehtë, duke shtuar "rastësisht" distancën në kohë:
setInterval(sendToDB, interval * (1 + 0.1 * (Math.random() - 0.5)))#4. Кэшируем, что нужно можно
Problemi i tretë tradicional i highload - mungesa e caches atje ku duhej mund të të jetë.
Për shembull, ne kemi bërë të mundur analizën në katrorët e planetit (të gjitha këto Seq Scan mbi përdoruesit), por menjëherë të mendojmë se ato, në masë, janë të njëjtat — kemi harruar.
Jo, sigurisht, në bazë nuk shkruhet asgjë përsëri, kjo e ndalon triggerin me INSERT ... ON CONFLICT DO NOTHING. Por deri te baza, këto të dhëna prapë arrijnë, madje edhe me një lexim të tepruar për të verifikuar konfliktin duke bërë detyrë. Ups №3…
Diferença në numrin e shënimeve të dërguara në bazë përpara/pas aktivizimit të caching-ut është e qartë:
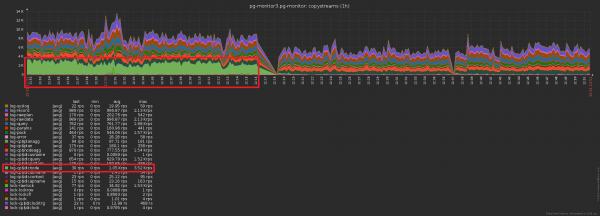
Dhe kjo është një rënie shoqëruese e ngarkesës në depo:
Përveç kësaj
«Tera-byty në ditë» vetëm tingëllon tmerrshëm. Nëse bëni gjithçka siç duhet, atëherë kjo është vetëm 2^40 byte / 86400 sekonda = ~12.5MB/s, që e mbajnë madje edhe hard diskët IDE të tavolinës. 🙂
Dhe nëse jemi serioz, edhe me një ‘ferkim’ dhjetëfish të ngarkesës në një ditë, ju mund të përputheni lehtësisht me mundësitë e SSD-ve moderne.
Burimi: habr.com
