

Gëzuar të premten! Miq, sot vazhdojmë serinë e publikimeve që i kushtohen kursit , sepse mësimet në grupin e ri për kursin fillojnë tashmë në fund të javës së ardhshme. Pra, le të fillojmë!
Monitorimi — është thjesht. Kjo është një fakt i njohur. Aktivizoni Nagios, nisni NRPE në sistemin e largët, konfiguroni Nagios për portin NRPE TCP 5666 dhe keni monitorim.
Është kaq e lehtë, saqë nuk është interesante. Tani keni metrikat bazë për kohën e procesorit, sistemin e diskut, memorjen e operativ, të cilat vijnë me default në Nagios dhe NRPE. Por në të vërtetë, kjo nuk është «monitorim» si i tillë. Kjo është vetëm fillimi.
(Zakonisht vendosin PNP4Nagios, RRDtool dhe Thruk, konfiguroni njoftime në Slack dhe shkojnë drejtpërdrejt në nagiosexchange, por le të kalojmë këtë për momentin).
Një monitorim i mirë në të vërtetë është mjaft i ndërlikuar, duhet vërtet të dini brendësinë e aplikacionit që po monitoroni.
A është monitorimi i vështirë?
Çdo server, qoftë Linux apo Windows, për nga përkufizimi do të shërbejë për ndonjë qëllim. Apache, Samba, Tomcat, ruajtja e skedarëve, LDAP — të gjitha këto shërbime janë më shumë ose më pak unike në një ose disa mënyra. Secili ka funksionin e vet, veçoritë e saj. Ka mënyra të ndryshme për të marrë metrika, KPI (të dhëna kyçe të performancës), të cilat ju interesojnë kur serveri është nën ngarkesë.
Autori i fotos në
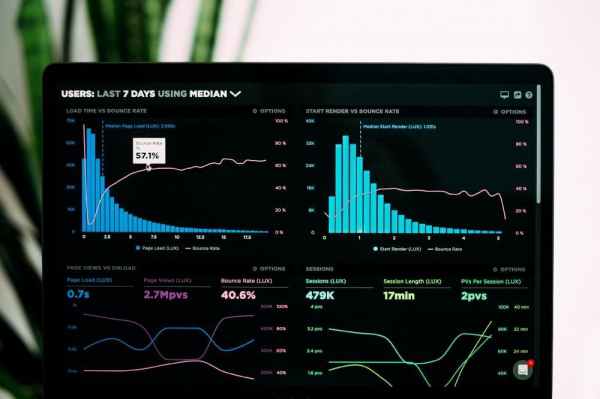
(do të dëshiroja që dashboard-et e mia të ishin ngjyrë neon blu — duke kujtuar me ëndje —… hm...)
Cdo program që ofron shërbime duhet të ketë një mekanizëm për mbledhjen e metrikave. Apache ka modulin mod-status, i cili tregon faqen e gjendjes së serverit. Nginx ka stub_status. Tomcat ka JMX ose aplikacione të veçanta Web që tregojnë metrikat kryesore. Në MySQL ka komandën «show global status» etj.
Pse nuk i përfshijnë programuesit mekanizma të tillë në aplikacionet që krijojnë?
A e bëjnë këtë vetëm programuesit?
Një nivel i caktuar indiference ndaj integrimit të metrikave nuk kufizohet vetëm te programuesit. Kam punuar në kompani ku zhvillonin aplikacione duke përdorur Tomcat dhe nuk lëshonin asnjë metrikë të veta, asnjë log të aktivitetit të shërbimit, përveç regjistrave të përgjithshëm të gabimeve të Tomcat. Disa programues gjenerojnë një mori logs, të cilat nuk kanë asnjë kuptim për administratorin e sistemit, i cili ka pasur fatin t'i lexojë në orën 3:15 të mëngjesit.
Autori i fotos në
Inxhinierët sistemorë, të cilët lejojnë që produkte të tilla të dalin në treg, gjithashtu duhet të mbajnë një përgjegjësi të caktuar për situatën. Pak inxhinierë sistemorë kanë kohë dhe janë të interesuar të përpiqen të fitojnë metrika kuptimplota nga logët, pa kontekstin e këtyre metricave dhe mundësinë për t'i interpretuar ato në dritën e aktivitetit të aplikacionit. Disa nuk e kuptojnë se çfarë dobi mund të kenë nga kjo, përveç treguesve të tipit "diçka aktualisht (ose do të jetë së shpejti) nuk është në rregull".
Ndryshimi i mendësisë mbi nevojën për metrika duhet të ndodhë jo vetëm në mesin e zhvilluesve, por edhe në mesin e inxhinierëve sistemorë.
Për çdo inxhinier sistemor, i cili duhet jo vetëm të reagojë në ngjarje kritike, por edhe të garantojë që ato të mos ndodhin, mungesa e metricave zakonisht është një pengesë për këtë.
Megjithatë, inxhinierët sistemorë zakonisht nuk kalojnë nëpër kod, duke fituar para për kompaninë e tyre. Ata kanë nevojë për zhvillues të liderëve që kuptojnë rëndësinë e përgjegjësisë së inxhinierëve sistemorë në zbulimin e problemeve, rritjen e ndërgjegjësimit për problemet e performancës dhe gjëra të tjera të ngjashme.
Kjo e gjëja devops
Mentaliteti devops përshkruan sinergjinë e mendësisë së zhvilluesve (dev) dhe operacioneve (ops). Çdo kompani që thotë se "bënë devops" duhet të:
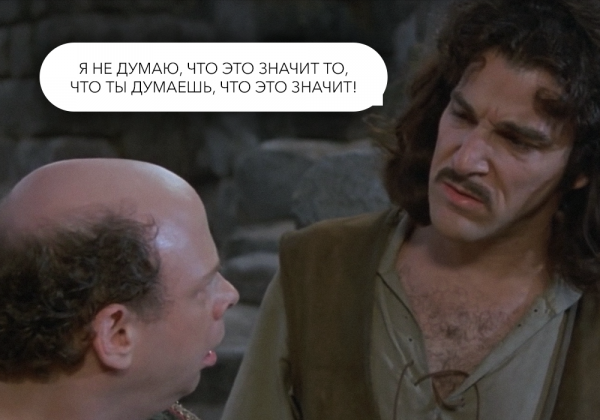
- thotë ato që ata, me shumë mundësi, nuk po e bëjnë (aluzion në memin nga filmi "Princesha Nefesuar" — "Nuk mendoj se kjo do të thotë atë që mendon se do të thotë!")
- nxisë pozitat e përmirësimit të vazhdueshëm të produktit.
Nuk mund të përmirësosh produktin dhe të dish se ai është përmirësuar, nëse nuk di si funksionon aktualisht. Nuk do të jesh në gjendje të kuptosh se si funksionon produkti, nëse nuk kupton si funksionojnë komponentët e tij, shërbimet nga të cilat varet, dhimbjet e tij kryesore dhe ngushticat.
Nëse nuk vëzhgon ngushticat e mundshme, nuk do të jesh në gjendje të ndjekësh teknikën "Pesë pse" gjatë shkrimit të Postmortem-it. Nuk do të jesh në gjendje të mbledhësh gjithçka në një ekran, për të parë si funksionon produkti ose për të ditur se si duket "më në rregull dhe i lumtur".
Lëvizja majtas, MAJLAT, E THA LEEEEEEEE—
Për mua, një nga parimet kyçe të Devops është "Lëvizja majtas" (shift left). Lëvizja majtas në këtë kontekst do të thotë zhvendosja e mundësisë (dhe jo përgjegjësinë, por mundësi) për të bërë atë për të cilën kujdesen zakonisht inxhinierët sistemorë, për shembull, të krijojnë matjet e performancës, të përdorin më efektiv logjet etj., në procesin e dërgimit të software-it (Software Delivery Life Cycle).
Autori i fotos në
Zhvilluesit e software-it duhet të kenë mundësinë të përdorin dhe të dinë mjetet e monitorimit që përdor kompania, për të realizuar monitorimin në të gjitha format e tij, metricat, logimin, ndërfaqet e monitorimit dhe, çka është më e rëndësishme, të vëzhgojnë si funksionon produkti i tyre në prodhim. Ju nuk mund ta detyroni zhvilluesin të angazhohet dhe të investojë kohë në monitorim, derisa ata të kenë mundësinë të shohin metricat dhe të ndikojnë në atë se si duken, si do t'i prezantojë ato CTO-i në bisedimin e ardhshëm etj.
Në shkurt
- Sillni kalin te uji. Tregoni zhvilluesve sa shumë probleme mund të shmangin për veten e tyre, ndihmohuni të identifikojnë KPI-të dhe metricat e duhura për aplikacionet e tyre, në mënyrë që të ketë më pak të ulur nga pronari i produktit, i cili është i qortuar nga CTO. Njihni ata me qetësi dhe butësi. Nëse kjo nuk funksionon, atëherë është nevoja të korruptoni, kërcënoni dhe bindni ose ata ose pronarin e produktit për të realizuar sa më shpejt marrjen e këtyre metricave nga aplikacionet, dhe pastaj vizatoni grafika. Kjo do të jetë sfiduese, pasi nuk do të konsiderohet si prioritet, dhe në hartën e produktit do të ketë shumë projekte që presin të realizohen dhe sjellin të ardhura. Prandaj, do t'ju nevojitet një arsyetim ekonomik për të justifikuar kohën dhe burimet e shpenzuara për implementimin e monitorimit në produkt.
- Ndihmni inxhinierëve sistemikë të flenë mirë. Tregoni atyre se përdorimi i listës së kontrollit "në lëshimin e produktit" për çdo produkt të lëshuar është e mirë. Dhe kontrollimi i metrikave për të gjitha aplikacionet në prodhim do të ndihmojë që ata të flenë mirë në natë, duke u lejuar zhvilluesve të shohin se çfarë nuk funksionon dhe ku. Megjithatë, mënyra e duhur për të irrituar dhe shqetësuar çdo zhvillues, pronar produkti dhe drejtori teknik është të vulosni gjeografi dhe të shkoni përpara. Kjo sjellje do të ndikojë në datën e lëshimit të çdo produkti, nëse pritet deri në minutën e fundit, prandaj bëni përsëri një lëvizje të majtë dhe përfshini këto çështje sa më shpejt në planin e projektit. Nëse është e nevojshme, kaloni në takimet që i kushtohen produktit. Vishni mustaqe false dhe ndonjë gjë të tillë, kjo nuk do të dështojë kurrë. Raportoni problemet tuaja, tregoni përfitimet e dukshme dhe evangelizoni.
- Sigurohuni që si zhvilluesit (dev), ashtu edhe operacionet (ops) të kuptojnë rëndësinë dhe pasojat e kalimit të metrikave të produktit në "zonën e kuqe". Mos e lini operacionin si roje të vetme të funksionalitetit të produktit, sigurohuni që zhvilluesit të përfshihen gjithashtu (#productsquads).
- Log-et janë një gjë e shkëlqyer, por metrikat gjithashtu. Bashkoni ato dhe mos lejoni që log-et tuaja të kthehen në mbeturina në një top gjigand zjarrfikës pa kuptim. Shpjegoni dhe tregoni zhvilluesve pse askush përveç tyre nuk do të kuptojë log-et e tyre, tregoni atyre si është të shohin log-e të padobishme në orën 3:15 të mëngjesit.
Autori i fotos në
Kjo është gjithçka. Materiali i ri do të dalë javën e ardhshme. Nëse dëshironi të mësoni më shumë rreth kursit, ju ftojmë në , i cili do të zhvillohet tashmë të hënën. Dhe tani, tradicionalisht presim komentet tuaja.
Burimi: habr.com
