

Përshëndetje të gjithëve! Unë jam zhvillues backend, shkruaj mikrosherbime në Java + Spring. Punoj në një nga ekipet e zhvillimit të produkteve të brendshme në kompaninë Tinkoff.
Në ekipin tonë shpesh ngrihet çështja e optimizimit të kërkesave në DBMS. Gjithmonë dëshirojmë që të jemi pak më të shpejtë, por nuk është gjithmonë e mundur të merremi me indekse të menduara mirë — na duhet të kërkojmë disa rruge alternative. Gjatë një nga këtyre kërkimeve online për optimizime të arsyeshme në punën me DB, gjeta , autori i librit SQL Performance Explained. Ky është një lloj blogu të rrallë, ku mund të lexosh të gjitha artikujt një pas një.
Dua të përkthej për ju një artikull të vogël nga Markus. Ajo mund të quhet në një farë mënyre një manifest, që synon tërheqjen e vëmendjes ndaj një problemi të vjetër, por ende aktual, të performancës së operacionit offset sipas standardit SQL.
Në disa vende, do të shtoj shpjegime dhe vërejtje nga autori. Të gjitha këto vende do t'i ndërlidh si «prij.» për më shumë qartësi.
Një hyrje e shkurtër
Mendoj se shumë e dinë se sa problematike dhe ngadalësuese mund të jetë puna me selektimin me faqe përmes offset. A e dini se mund ta zëvendësoni atë me një konstrukcion më të performueshëm?
Pra, fjala kyçe offset i thotë bazës të anashkalojë regjistrimet e para n në kërkesë. Megjithatë, baza ende duhet të lexojë këto n regjistrime të para nga disku, dhe kjo në rendin e caktuar (prij.: të aplikoni renditjen, nëse është e caktuar), dhe vetëm pas kësaj do të jetë e mundur të kthehen regjistrimet duke filluar nga n+1 e më tej. E më e rëndësishmja, problemi nuk është në realizimin e caktuar në DBMS, por në definicionin origjinal sipas standardit:
…rregullat e para renditen sipas <klauzolës order by> dhe pastaj kufizohen duke hequr numrin e rreshtave të specifikuar në <klauzolën offset të rezultatit> nga fillimi…
-SQL:2016, Pjesa 2, 4.15.3 Të dhëna të nxjerra (prij.: standardi që përdoret aktualisht më shumë)
Pika kryesore këtu është se offset merr një parametër të vetëm — numrin e regjistrimeve që duhet të anashkalohen, dhe kjo është gjithçka. Duke ndjekur një përkufizim të tillë, DBMS mund vetëm të nxjerrë të gjitha regjistrimet, dhe pastaj të heqë ato të panevojshme. Është e dukshme se një përkufizim i tillë i offset-it e detyron atë të bëjë punë të tepërt. Dhe këtu nuk ka rëndësi nëse është SQL apo NoSQL.
Pak dhimbje më shumë
Problemet me offset nuk përfundojnë këtu, dhe kjo është arsyeja. Nëse mes leximit të dy faqeve të dhënash nga disku, një operacion tjetër shton një regjistër të ri, çfarë do të ndodhte në këtë rast?
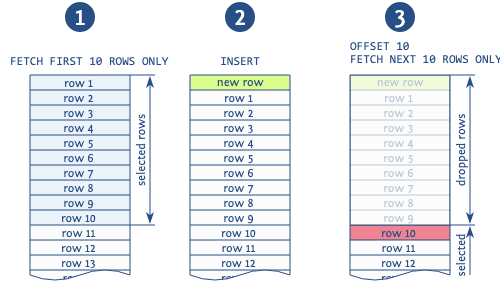
Kur përdoret offset për të kaluar regjistrat nga faqet e mëparshme, në situatën e shtimit të një regjistri të ri mes operacioneve të leximit të faqeve të ndryshme, me siguri do të merrni kopje (shënim: kjo është e mundur kur lexojmë faqët nga një konstrukcion me renditje, atëherë një regjistër i ri mund të kalojë mes rezultatit tonë).
Figura ilustron këtë situatë. Baza lexon 10 regjistrat e parë, pastaj shtohet një regjistër i ri, i cili zhvendos të gjithë regjistrat e lexuar për 1. Pastaj, baza merr një faqe të re nga 10 regjistra të tjerë dhe fillon jo nga i 11-ti, siç duhet, por nga i 10-ti, duke e kopjuar këtë regjistër. Ka edhe anomali të tjera të lidhura me përdorimin e këtij shprehjeje, por kjo është më e zakonshmja.
Siç e kemi zbuluar tashmë, këto nuk janë probleme specifike të ndonjë DBMS ose implementimeve të tyre. Problemi është në përcaktimin e paginimit sipas standardit SQL. Ne i themi DBMS-it se cilën faqe duhet të marrim ose sa regjistra të kalojmë. Baza thjesht nuk është në gjendje të optimizojë një kërkesë të tillë, pasi ka shumë pak informacion.
Vlen të saktësohet se ky është një problem jo i ndonjë fjale kyçe specifike, por më shumë i semantikës së kërkesës. Ka disa sintaksa të tjera identike në problematikë:
- Fjalë kyçe offset, siç u tha më parë.
- Konstrukti me dy fjalë kyçe limit [offset] (ndonëse limit vetë nuk është aq i keq).
- Filtrimi sipas kufijve të poshtëm, i ndërtuar mbi numërimin e rreshtave (p.sh. row_number(), rownum etj.).
Të gjitha këto shprehje thjesht tregojnë se sa rreshta duhet të kalohen, pa ndonjë informacion ose kontekst shtesë.
Më tej në këtë artikull, fjala kyçe offset përdoret si një përmbledhje e të gjitha këtyre variantëve.
Jeta pa OFFSET
Tani imagjinoni se si do të ishte bota jonë pa të gjitha këto probleme. Del se jeta pa offset nuk është aq e komplikuar: me selektimin mund të zgjidhni vetëm ato rreshta që ende nuk i kemi parë (shënim: pra ato, që nuk ishin në faqen e kaluar), me kushtin në where.
Në këtë rast, ne mbështetemi në faktin se selektimet kryhen mbi një grup të renditur (e vjetër e mirë order by). Meqenëse kemi një grup të renditur, mund të përdorim një filter mjaft të thjeshtë për të marrë vetëm të dhënat që ndodhen pas regjistrimit të fundit të faqes paraardhëse:
    SELECT ...
    FROM ...
    WHERE ...
    AND id < ?last_seen_id
    ORDER BY id DESC
    FETCH FIRST 10 ROWS ONLY
Këtu është dhe gjithë parimi i këtij qasjeje. Sigurisht, kur renditja bëhet sipas disa kolonave, gjithçka bëhet më argëtuese, por ideja mbetet e njëjtë. Është e rëndësishme të theksohet se kjo konstruktion është e aplikueshme në shumë -zgjidhje.
Kjo qasje quhet metoda seek ose pagination me set çelësash. Ajo zgjidh problemin me rezultatet që lëvizin (shënim: situata e regjistrimit midis leximeve të faqeve, e përshkruar më parë) dhe, natyrisht, që ne të gjithë e duam, funksionon më shpejt dhe më qëndrueshëm se offset klasik. Qëndrueshmëria qëndron në faktin se koha e përpunimit të kërkesës nuk rritet proporcionalisht me numrin e tabelës kërkuese (shënim: nëse dëshiron të mësosh më shumë rreth punës së metodave të ndryshme të pagination, mundesh . Aty mund të gjeni gjithashtu benchmarket krahasuese për metoda të ndryshme).
Një nga slidet , pagination sipas çelësave, sigurisht, nuk është allbërues — ajo ka kufizimet e saj. E rëndësishmja — ajo nuk ka mundësinë të lexojë faqe të rastësishme (shënim: në mënyrë jo të rregullt). Megjithatë, në epokën e skrollimit të pafund (shënim: në front-end) kjo nuk është një problem aq i madh. Caktimi i numrit të faqes për klikim — në çdo rast një zgjidhje e keqe gjatë zhvillimit të UI (shënim: mendimi i autorit të artikullit).
E çfarë është me mjetet?
Pagination sipas çelësave shpesh nuk është e përshtatshme për shkak të mungesës së mbështetjes instrumentale për këtë metodë. Shumica e mjeteve të zhvillimit, përfshirë framework të ndryshme, nuk ofrojnë një zgjedhje se si do të kryhet pagination.
Situata përkeqësohet nga fakti se metoda e përshkruar kërkon mbështetje të plotë në teknologjitë e përdorura — duke filluar nga DBMS dhe përfundon me ekzekutimin e kërkesave AJAX në shfletues gjatë skrollimit të pafund. Në vend që të caktohet vetëm numri i faqes, tani do të duhet të caktohet një grup çelësh për të gjitha faqet për një herë.
Megjithatë, numri i frameworkeve që mbështesin ndarjen në kyç është duke u rritur gradualisht. Këtu është ajo që kemi deri më tani:
- për Java;
- për Ruby;
- dhe për Django;
- për Python;
- — API kriteresh për realizimet JPA;
- për Perl;
- , мапер для Node.js .
(Shënim: disa lidhje u hoqën për shkak se në momentin e përkthimit disa biblioteka nuk ishin përditësuar që nga viti 2017–2018. Nëse jeni të interesuar, mund të shikoni burimin fillestar.)
Pikërisht në këtë moment nevojitet ndihma juaj. Nëse po zhvilloni ose mbani një framework që në njëfarë mënyre përdor ndarjen, ju lutem, ju kërkoj, ju bëj thirrje të shprehim mbështetje native për ndarjen në kyç. Nëse keni pyetje ose keni nevojë për ndihmë, do të jem i lumtur të ndihmoj (, , ) (shënim: nga përvoja ime e bisedës me Markus-in, mund të them se ai vërtet iu qaset me entuziazëm për përhapjen e kësaj teme).
Nëse po përdorni zgjidhje të gatshme që, sipas jush, meritojnë mbështetje për ndarjen në kyç, krijoni një kërkesë ose madje propozoni një zgjidhje të gatshme, nëse është e mundur. Mund të specifikoni gjithashtu këtë artikull në lidhje.
Përfundim
Arsyeja pse një qasje aq e thjeshtë dhe e dobishme si ndarja në kyç është pak e përhapur, nuk është sepse është e vështirë në realizimin teknik ose kërkon ndonjë përpjekje të madhe. Arsyeja kryesore është se shumë njerëz janë mësuar të shohin dhe të punojnë me offset — ky qasje midis një standardi të caktuar.
Si pasojë, pak njerëz mendojnë të ndryshojnë qasjen e ndarjes dhe për këtë arsye, mbështetja instrumentale nga frameworket dhe bibliotekat zhvillohet ngadalë. Prandaj, nëse ideja dhe qëllimi i ndarjes pa offset ju janë të afërta, ndihmoni në përhapjen e saj!
Burimi:
Autori: Markus Winand
Burimi: habr.com
