

Cili version i firmware-it është më “i duhuri” dhe më “stabili”? Nëse sistemi i ruajtjes garanton tolerancë ndaj dështimeve prej 99,9999%, a do të thotë kjo se do të funksionojë pa ndërprerje edhe pa përditësim të softuerit? Apo, përkundrazi, për të arritur tolerancën maksimale ndaj dështimeve duhet instaluar gjithmonë firmware-i më i fundit? Do të përpiqemi t’u përgjigjemi këtyre pyetjeve duke u mbështetur në përvojën tonë.
Një hyrje e shkurtër
Të gjithë e kuptojmë se çdo version i softuerit, qoftë sistem operativ apo driver për një pajisje të caktuar, shpesh përmban mangësi/bug-e dhe “veçori” të tjera, të cilat mund të mos shfaqen deri në fund të jetës së pajisjes, ose të dalin në pah vetëm në kushte të caktuara. Numri dhe rëndësia e këtyre nuancave varen nga kompleksiteti (funksionaliteti) i softuerit dhe nga cilësia e testimit gjatë zhvillimit të tij.
Shpesh përdoruesit qëndrojnë te “firmware-i nga fabrika” (shprehja e njohur: «nëse funksionon, mos e prek») ose instalojnë gjithmonë versionin më të fundit (sipas tyre, më i fundit do të thotë edhe më i qëndrueshmi). Ne përdorim një qasje tjetër — shqyrtojmë release notes për të gjithë pajisjen që përdorim dhe zgjedhim me kujdes firmware-in e përshtatshëm për secilën njësi.
Në këtë përfundim kemi arritur, siç thuhet, me përvojë. Nga praktika jonë e përdorimit do të shpjegojmë pse 99,9999 % e besueshmërisë së premtuar për sistemin e ruajtjes nuk do të thonë asgjë nëse nuk ndiqni në kohë përditësimet dhe përshkrimet e softuerit. Rasti ynë është i vlefshëm për përdoruesit e sistemeve të ruajtjes të çdo prodhuesi, sepse një situatë e tillë mund të ndodhë me pajisje të çdo marke.
Zgjedhja e një sistemi të ri të ruajtjes së të dhënave
Në fund të vitit të kaluar, infrastrukturës sonë iu shtua një sistem interesant i ruajtjes së të dhënave: modeli bazë i linjës IBM FlashSystem 5000, i cili në momentin e blerjes quhej Storwize V5010e. Tani ai shitet me emrin FlashSystem 5010, por në thelb është e njëjta platformë harduerike me të njëjtin Spectrum Virtualize brenda.
Prania e një sistemi të unifikuar menaxhimi është, në fakt, edhe dallimi kryesor i IBM FlashSystem. Te modelet e serisë bazë, ai pothuajse nuk ndryshon nga modelet më të fuqishme. Zgjedhja e një modeli të caktuar thjesht siguron bazën përkatëse harduerike, karakteristikat e së cilës bëjnë të mundur përdorimin e këtij apo atij funksionaliteti ose ofrimin e një niveli më të lartë shkallëzueshmërie. Ndërkohë, softueri identifikon pjesën harduerike dhe ofron funksionalitetin e nevojshëm dhe të mjaftueshëm për këtë platformë.
 IBM FlashSystem 5010
Shkurtimisht për modelin tonë 5010. Kjo është një sistem ruajtjeje të dhënash me blloqe, me dy kontrollues, i nivelit fillestar. Ai mbështet disqe NLSAS, SAS dhe SSD. Vendosja e NVMe në të nuk është e disponueshme, pasi ky model i sistemit të ruajtjes pozicionohet për zgjidhjen e detyrave që nuk kërkojnë performancën e disqeve NVMe.
Sistemi i ruajtjes u ble për vendosjen e informacionit arkivor ose të dhënave që nuk aksesohen shpesh. Prandaj, për ne ishte i mjaftueshëm seti standard i funksioneve të tij: tiering (Easy Tier), Thin Provision. Edhe performanca prej 1000–2000 IOPS në disqet NLSAS na përshtatej plotësisht.
Përvoja jonë — si nuk e përditësuam firmware-in në kohë
Tani, konkretisht për vetë përditësimin e softuerit. Në momentin e blerjes, sistemi kishte tashmë një version disi të vjetëruar të softuerit Spectrum Virtualize, përkatësisht, 8.2.1.3.
Ne studiuam përshkrimin e firmware-eve dhe planifikuam përditësimin në 8.2.1.9. Po të kishim qenë pak më të shpejtë, ky artikull nuk do të ekzistonte — në një firmware më të ri ky bug nuk do të ishte shfaqur. Megjithatë, për arsye të caktuara, përditësimi i këtij sistemi u shty.
Si rezultat, një vonesë e vogël në përditësim çoi në një situatë jashtëzakonisht të pakëndshme, siç përshkruhet në lidhjen më poshtë: .
Po, në firmware-in e atij versioni ishte pikërisht aktual i ashtuquajturi APAR (Authorized Program Analysis Report) HU02104. Ai shfaqet në këtë mënyrë. Nën ngarkesë, në rrethana të caktuara, cache fillon të mbushet tej mase; më pas sistemi kalon në modalitet mbrojtës, në të cilin çaktivizon input/output për Pool-in. Në rastin tonë, kjo u duk si çaktivizim i 3 disqeve për grupin RAID në modalitetin RAID 6. Çaktivizimi zgjat 6 minuta. Më pas, qasja te Volumet në Pool rikthehet.
Nëse dikush nuk është i njohur me strukturën dhe emërtimin e entiteteve logjike në kontekstin e IBM Spectrum Virtualize, do ta shpjegoj shkurt tani.
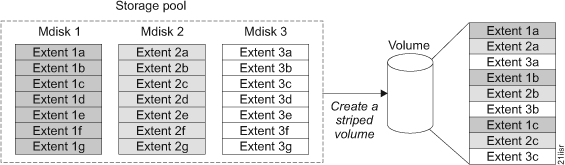 Struktura e elementeve logjike të sistemit të ruajtjes
Disqet grupohen në njësi që quhen MDisk (Managed Disk). MDisk mund të përfaqësojë një RAID klasik (0,1,10,5,6) ose një variant të virtualizuar – DRAID (Distributed RAID). Përdorimi i DRAID lejon rritjen e performancës së array-t, pasi përdoren të gjithë disqet e grupit, dhe ul kohën e rebuild-it, sepse duhet të rikthehen vetëm blloqe të caktuara, jo të gjitha të dhënat nga disku që ka dalë jashtë funksionit.
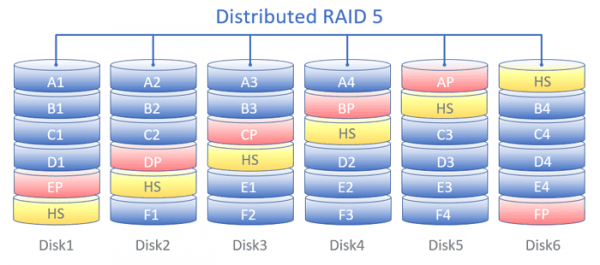 Shpërndarja e blloqeve të të dhënave nëpër disqe gjatë përdorimit të Distributed RAID (DRAID) në modalitetin RAID-5.
Ndërsa kjo skemë tregon logjikën e funksionimit të rebuild-it të DRAID në rast të dështimit të një disku:
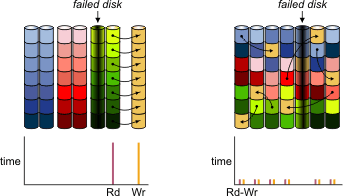 Logjika e funksionimit të rebuild-it të DRAID në rast të dështimit të një disku
Më pas, një ose disa MDisk formojnë të ashtuquajturin Pool. Brenda të njëjtit pool, nuk rekomandohet përdorimi i MDisk me nivele të ndryshme RAID/DRAID mbi disqe të të njëjtit lloj. Nuk do të hyjmë shumë në këtë temë, pasi planifikojmë ta trajtojmë në një nga artikujt e ardhshëm. Dhe, në thelb, Pool ndahet në Volumes, të cilat prezantohen drejt hosteve përmes njërit ose tjetrit protokoll të aksesit në nivel blloku.
Kështu, si rezultat i situatës së përshkruar në APAR HU02104, për shkak të dështimit logjik të tre disqeve, MDisk pushoi së funksionuari, gjë që nga ana e vet shkaktoi ndërprerjen e funksionimit të Pool dhe Volumes përkatëse.
Meqenëse këto sisteme janë mjaft “inteligjente”, ato mund të lidhen me sistemin cloud të monitorimit IBM Storage Insights, i cili, në mënyrë automatike, kur ndodh një defekt, dërgon një kërkesë shërbimi te mbështetja e IBM. Krijohet një tiketë dhe specialistët e IBM kryejnë diagnostikim në distancë dhe kontaktojnë përdoruesin e sistemit.
Falë kësaj, çështja u zgjidh mjaft shpejt dhe nga shërbimi i mbështetjes morëm një rekomandim të menjëhershëm për të përditësuar sistemin tonë në firmware-in 8.2.1.9, të zgjedhur më herët prej nesh, ku në atë kohë ky problem ishte tashmë i korrigjuar. Këtë e konfirmon .
Përfundimet dhe rekomandimet tona
Siç thuhet: «çdo gjë është mirë kur përfundon mirë». Defekti në firmware nuk shkaktoi probleme serioze — funksionimi i serverëve u rikthye në kohën më të shkurtër dhe pa humbje të të dhënave. Për disa klientë u desh të ristartonim makinat virtuale, por në përgjithësi ishim të përgatitur për pasoja më negative, pasi çdo ditë krijojmë kopje rezervë të të gjithë elementëve të infrastrukturës dhe të makinave të klientëve.
Morëm konfirmimin se edhe sistemet e besueshme me 99,9999% disponueshmëri të premtuar kërkojnë vëmendje dhe mirëmbajtje në kohë. Nisur nga kjo situatë, nxorëm disa përfundime dhe po ndajmë rekomandimet tona:
Duhet patjetër të ndiqni publikimin e përditësimeve, të shqyrtoni Release Notes për korrigjimet e çështjeve potencialisht kritike dhe të kryeni në kohë përditësimet e planifikuara.
Ky është një aspekt organizativ dhe madje mjaft i dukshëm, ndaj në pamje të parë duket sikur nuk ia vlen të ndalemi te ai. Megjithatë, pikërisht në një situatë të tillë të thjeshtë mund të gabosh lehtësisht. Në fakt, ishte pikërisht ky moment që solli vështirësitë e përshkruara më sipër. Qasjuni hartimit të rregullores së përditësimit me shumë kujdes dhe po aq me përpikëri monitoroni zbatimin e saj. Kjo pikë lidhet më shumë me nocionin e «disiplinës».
Është gjithmonë më mirë ta mbani sistemin me versionin më aktual të softuerit. Për më tepër, aktual nuk është ai që ka një numër më të madh versioni, por ai me datën më të vonshme të publikimit.
Për shembull, IBM për sistemet e saj të ruajtjes së të dhënave mban të përditësuara të paktën dy release të softuerit. Në momentin e shkrimit të këtij artikulli, këto janë 8.2 dhe 8.3. Përditësimet për 8.2 publikohen më herët. Më pas, zakonisht me një vonesë të vogël, del edhe përditësimi analog për 8.3.
Release 8.3 ka një sërë përparësish funksionale, për shembull mundësinë e zgjerimit të MDisk (në modalitetin DRAID) duke shtuar një ose më shumë disqe të reja (kjo mundësi është në dispozicion që nga versioni 8.3.1). Ky është një funksionalitet mjaft bazë, por në 8.2, për fat të keq, kjo mundësi mungon.
Nëse për çfarëdo arsye përditësimi nuk është i mundur, atëherë për versionet e Spectrum Virtualize para 8.2.1.9 dhe 8.3.1.0 (ku defekti i përshkruar më sipër është i pranishëm), për të ulur rrezikun e shfaqjes së tij, mbështetja teknike e IBM rekomandon kufizimin e performancës së sistemit në nivel pool-i, siç tregohet në figurën më poshtë (pamja është marrë nga versioni i lokalizuar në rusisht i GUI-së). Vlera 10000 IOPS jepet si shembull dhe përcaktohet sipas karakteristikave të sistemit tuaj.
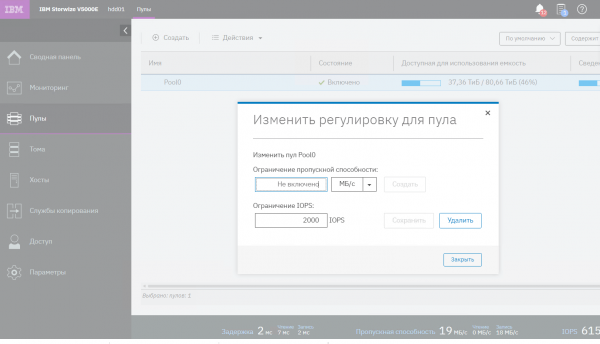 Kufizimi i performancës së sistemit të ruajtjes IBM
Ngarkesa mbi sistemet e ruajtjes duhet llogaritur saktë dhe nuk duhet lejuar mbingarkesa. Për këtë mund të përdorni ose mjetin e dimensionimit të IBM-së (nëse keni qasje në të), ose ndihmën e partnerëve, ose burime të palëve të treta. Njëkohësisht, është thelbësore të kuptohet profili i ngarkesës së sistemit të ruajtjes, sepse performanca në MB/s dhe IOPS ndryshon ndjeshëm të paktën në varësi të parametrave të mëposhtëm:
lloji i operacionit: lexim apo shkrim,
madhësia e bllokut të operacionit,
raporti përqindor i operacioneve të leximit dhe shkrimit në fluksin e përgjithshëm të hyrje-daljes.
Në shpejtësinë e ekzekutimit të operacioneve ndikon edhe mënyra se si lexohen blloqet e të dhënave: në mënyrë sekuenciale apo rastësore. Gjatë kryerjes së disa operacioneve të aksesit në të dhëna nga ana e aplikacionit ekziston edhe koncepti i operacioneve të varura. Edhe kjo është e dëshirueshme të merret parasysh. E gjithë kjo mund të ndihmojë për të parë panoramën e plotë bazuar në të dhënat nga numëruesit e performancës së OS, të sistemit të ruajtjes, serverëve/hipervizorëve, si edhe nga kuptimi i veçorive të funksionimit të aplikacioneve, DBMS-ve dhe konsumatorëve të tjerë të burimeve të diskut.
Dhe së fundi, është e domosdoshme të keni kopje rezervë në gjendje aktuale dhe funksionale. Orari i kopjimit rezervë duhet të konfigurohet sipas vlerave të RPO që janë të pranueshme për biznesin, dhe integriteti i kopjeve rezervë duhet të kontrollohet periodikisht (mjaft prodhues të softuerëve për backup e kanë zbatuar verifikimin e automatizuar në produktet e tyre) për të siguruar një vlerë të pranueshme të RTO.
Faleminderit që lexuat deri në fund.
Jemi gati t’u përgjigjemi pyetjeve dhe komenteve tuaja në komente. Gjithashtu, ku organizojmë rregullisht promocione (ulje për IaaS dhe shpërndarje kodesh promocionale deri në 100% për VPS), publikojmë lajme interesante dhe njoftojmë për artikuj të rinj në blogun e Habr.
Burimi: habr.com
