

Vazhdimi i përkthimit të një libri të vogël:
«Understanding Message Brokers»,
autor: Jakub Korab, botues: O’Reilly Media, Inc., data e botimit: qershor 2017, ISBN: 9781492049296.
Pjesa e mëparshme e përkthyer:
KAPITULLI 3
Kafka
Kafka u zhvillua në LinkedIn për të kapërcyer disa kufizime të brokerëve tradicionalë të mesazheve dhe për të shmangur nevojën për të konfiguruar disa brokerë mesazhesh për ndërveprime të ndryshme «pikë më pikë», siç përshkruhet në këtë libër te seksioni «Shkallëzimi vertikal dhe horizontal» në faqen 28. Rastet e përdorimit në LinkedIn bazoheshin kryesisht në përthithjen njëkahëshe të vëllimeve shumë të mëdha të të dhënave, si klikimet në faqe dhe regjistrat e aksesit, duke u mundësuar njëkohësisht disa sistemeve t’i përdorin këto të dhëna pa ndikuar në performancën e prodhuesve ose të konsumatorëve të tjerë. Në fakt, arsyeja pse ekziston Kafka është krijimi i asaj arkitekture të shkëmbimit të mesazheve që përshkruhet nga Universal Data Pipeline.
Duke pasur parasysh këtë qëllim përfundimtar, natyrshëm lindën edhe kërkesa të tjera. Kafka duhet:
- Të jetë jashtëzakonisht e shpejtë
- Të ofrojë throughput të lartë gjatë punës me mesazhe
- Të mbështesë modelet «Publisher-Subscriber» dhe «Point-to-Point»
- Të mos ngadalësohet me shtimin e konsumatorëve. Për shembull, performanca si e radhës ashtu edhe e topic në ActiveMQ bie me rritjen e numrit të konsumatorëve te destinacioni
- Të jetë e shkallëzueshme horizontalisht; nëse një broker i vetëm që ruan (persists) mesazhet mund ta bëjë këtë vetëm me shpejtësinë maksimale të diskut, atëherë për të rritur performancën ka kuptim të kalohet përtej një instance të vetme brokeri
- Të ndajë aksesin ndaj ruajtjes dhe ririkthimit të mesazheve
Për të arritur të gjitha këto, Kafka përdor një arkitekturë që ka ripërcaktuar rolet dhe përgjegjësitë e klientëve dhe brokerëve të mesazheve. Modeli JMS është shumë i përqendruar te brokeri, ku ai është përgjegjës për shpërndarjen e mesazheve, ndërsa klientët duhet të kujdesen vetëm për dërgimin dhe marrjen e tyre. Kafka, nga ana tjetër, është e përqendruar te klienti, ku klienti merr përsipër shumë funksione të brokerit tradicional, siç është shpërndarja e drejtë e mesazheve përkatëse te konsumatorët, duke marrë në këmbim një broker jashtëzakonisht të shpejtë dhe të shkallëzueshëm. Për ata që kanë punuar me sisteme tradicionale të mesazheve, puna me Kafka kërkon një ndryshim thelbësor në mënyrën e të menduarit.
Kjo qasje inxhinierike çoi në krijimin e një infrastrukture mesazhesh që është në gjendje të rrisë throughput-in me shumë rende madhësie krahasuar me një broker të zakonshëm. Siç do të shohim, kjo qasje sjell edhe kompromise, që do të thotë se Kafka nuk është e përshtatshme për disa lloje ngarkesash dhe software-i të instaluar.
Modeli i unifikuar i adresimit
Për të përmbushur kërkesat e përshkruara më sipër, Kafka bashkoi modelet e mesazheve «publish-subscribe» dhe «point-to-point» brenda një lloji të vetëm adresimi — topic. Kjo mund të ngatërrojë ata që kanë punuar me sisteme mesazhesh ku fjala «topic» i referohet një mekanizmi broadcast, nga i cili leximi nuk është i qëndrueshëm (is nondurable). Topic-et në Kafka duhen parë si një lloj hibrid adresimi, sipas përkufizimit të dhënë në hyrje të këtij libri.
Në pjesën e mbetur të këtij kapitulli, nëse nuk e specifikojmë qartë ndryshe, termi «topic» do t’i referohet topic-ut të Kafka.
Për të kuptuar plotësisht si sillen topic-et dhe çfarë garancish ofrojnë ato, fillimisht duhet të shqyrtojmë se si zbatohen ato në Kafka.
Çdo topic në Kafka ka log-un e vet.
Prodhuesit që dërgojnë mesazhe në Kafka shkruajnë në këtë log, ndërsa konsumatorët lexojnë nga logu duke përdorur tregues që lëvizin vazhdimisht përpara. Herë pas here, Kafka fshin pjesët më të vjetra të logut, pavarësisht nëse mesazhet në ato pjesë janë lexuar apo jo. Një pjesë qendrore e arkitekturës së Kafka është se brokeri nuk merret me faktin nëse mesazhet janë lexuar apo jo — kjo është përgjegjësi e klientit.
Termat «log» dhe «tregues» nuk përdoren në . Këta terma të njohur përdoren këtu për ta bërë kuptimin më të qartë.
Ky model është krejtësisht i ndryshëm nga ActiveMQ, ku mesazhet nga të gjitha radhët ruhen në një log të vetëm dhe brokeri i shënon mesazhet si të fshira pasi të jenë lexuar.
Tani le të hyjmë pak më thellë dhe ta shqyrtojmë më në detaje logun e topic.
Logu i Kafka përbëhet nga disa particione (). Kafka garanton renditje strikte brenda çdo particioni. Kjo do të thotë se mesazhet e shkruara në një particion në një rend të caktuar do të lexohen në të njëjtin rend. Çdo particion zbatohet si një skedar logu ciklik (rolling), i cili përmban një nëngrup (subset) të të gjitha mesazheve të dërguara në topic nga prodhuesit e tij. Topic i krijuar përmban si parazgjedhje një particion. Ideja e particioneve është thelbësore në Kafka për shkallëzim horizontal.
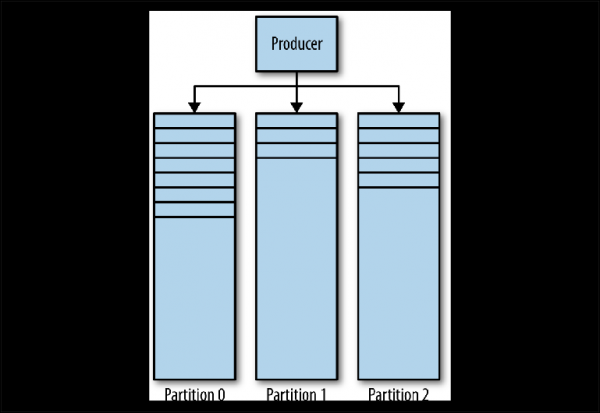
Figure 3-1. Particionet e Kafka
Kur prodhuesi dërgon një mesazh në një topic të Kafka, ai vendos se në cilin particion do ta dërgojë mesazhin. Këtë do ta shqyrtojmë më në detaje më vonë.
Leximi i mesazheve
Klienti që dëshiron të lexojë mesazhe menaxhon një tregues të emërtuar, i quajtur grup konsumatorësh (consumer group), i cili tregon te zhvendosja (offset) e mesazhit në particion. Zhvendosja është një pozicion me numër në rritje, që fillon nga 0 në fillim të particionit. Ky grup konsumatorësh, të cilit i referohet API përmes identifikuesit group_id të përcaktuar nga përdoruesi, korrespondon me një konsumator ose sistem logjik të vetëm.
Shumica e sistemeve që përdorin shkëmbimin e mesazheve i lexojnë të dhënat nga marrësi përmes disa instancave dhe rrjedhave për përpunim paralel të mesazheve. Prandaj, zakonisht ka shumë instanca consumer që ndajnë të njëjtin grup consumerësh.
Problemi i leximit mund të paraqitet si më poshtë:
- Topic ka disa particione
- Një topic mund të përdoret njëkohësisht nga shumë grupe consumerësh
- Një grup consumerësh mund të ketë disa instanca të veçanta
Kjo është një problematikë jo e thjeshtë «shumë me shumë». Për të kuptuar se si Kafka i trajton marrëdhëniet midis grupeve të consumerëve, instancave të consumerëve dhe particioneve, le të shqyrtojmë një sërë skenarësh leximi që bëhen gradualisht më kompleksë.
Consumerët dhe grupet e consumerëve
Le të marrim si pikënisje një topic me një particion ().
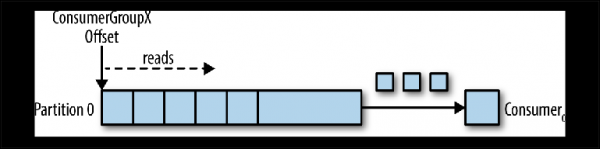
Figura 3-2. Consumer lexon nga particioni
Kur një instancë consumer lidhet me këtë topic me group_id-në e vet, asaj i caktohet një particion për lexim dhe një offset në atë particion. Pozicioni i këtij offset-i konfigurohet te klienti si tregues i pozicionit më të fundit (mesazhi më i ri) ose i pozicionit më të hershëm (mesazhi më i vjetër). Consumer kërkon (polls) mesazhe nga topic, gjë që çon në leximin e tyre në mënyrë sekuenciale nga log-u.
Pozicioni i offset-it komitohet rregullisht përsëri në Kafka dhe ruhet si mesazhe në topic-un e brendshëm _consumer_offsets. Mesazhet e lexuara gjithsesi nuk fshihen, ndryshe nga një broker i zakonshëm, dhe klienti mund ta kthejë mbrapa (rewind) offset-in për të ripërpunuar mesazhet e shqyrtuara më parë.
Kur lidhet një consumer i dytë logjik, duke përdorur një group_id tjetër, ai menaxhon një tregues të dytë që është i pavarur nga i pari (). Kështu, topic-u Kafka vepron si një radhë ku ekziston një consumer dhe, njëkohësisht, si një topic i zakonshëm publisher-subscriber (pub-sub), në të cilin janë abonuar disa consumerë, me avantazhin shtesë që të gjitha mesazhet ruhen dhe mund të përpunohen disa herë.
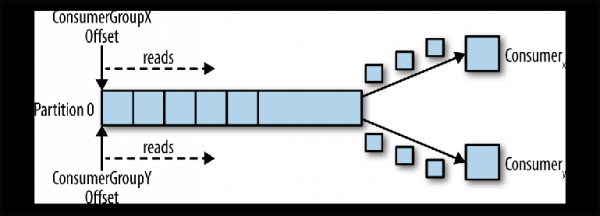
Figura 3-3. Dy consumerë në grupe të ndryshme consumerësh lexojnë nga i njëjti particion
Consumerët në një grup consumerësh
Kur një instancë e consumer-it lexon të dhëna nga një particion, ajo e kontrollon plotësisht pointer-in dhe përpunon mesazhet, siç përshkruhet në seksionin e mëparshëm.
Nëse disa instanca consumer-ësh janë lidhur me të njëjtin group_id në një topic me një particion, kontrolli mbi pointer-in do t’i kalojë instancës që është lidhur e fundit dhe që nga ai moment ajo do të marrë të gjitha mesazhet ().
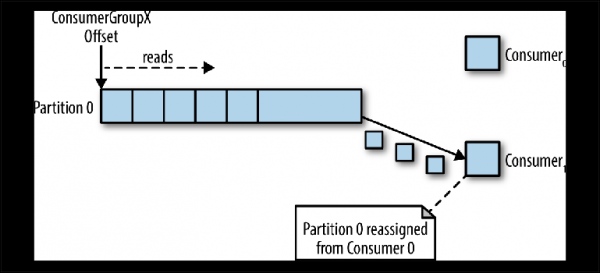
Figura 3-4. Dy consumer në të njëjtin grup consumer-ësh lexojnë nga një particion
Ky regjim përpunimi, ku numri i instancave të consumer-it tejkalon numrin e particioneve, mund të konsiderohet si një variant i konsumatorit monopol. Kjo mund të jetë e dobishme nëse ju nevojitet klasterizim «active-passive» (ose «hot-warm») i instancave tuaja consumer, megjithëse funksionimi paralel i disa consumer-ëve («active-active» ose «hot-hot») është shumë më tipik sesa consumer-ët në gjendje pritjeje.
Kjo sjellje e shpërndarjes së mesazheve, e përshkruar më sipër, mund të duket e pazakontë krahasuar me mënyrën se si sillet një radhë e zakonshme JMS. Në këtë model, mesazhet e dërguara në radhë do të shpërndahen në mënyrë të barabartë midis dy consumer-ëve.
Më së shpeshti, kur krijojmë disa instanca consumer-ësh, e bëjmë këtë ose për përpunim paralel të mesazheve, ose për të rritur shpejtësinë e leximit, ose për të përmirësuar qëndrueshmërinë e procesit të leximit. Meqenëse të dhënat nga një particion mund të lexohen njëkohësisht vetëm nga një instancë consumer-i, si arrihet kjo në Kafka?
Një nga mënyrat për ta bërë këtë është përdorimi i një instance consumer-i për të lexuar të gjitha mesazhet dhe për t’ia kaluar ato një pool-i threads. Edhe pse kjo qasje rrit kapacitetin e përpunimit, ajo e shton kompleksitetin e logjikës së consumer-it dhe nuk bën asgjë për të përmirësuar qëndrueshmërinë e sistemit të leximit. Nëse një instancë consumer-i ndalet për shkak të ndërprerjes së energjisë ose një ngjarjeje të ngjashme, leximi ndërpritet.
Mënyra kanonike për ta zgjidhur këtë problem në Kafka është përdorimi i një numri më tëQmadh particionesh.
Particionimi
Particionet janë mekanizmi kryesor për paralelizimin e leximit dhe për shkallëzimin e topic përtej kapacitetit të një instance të vetme brokeri. Për ta kuptuar më mirë këtë, le të shqyrtojmë situatën kur ekziston një topic me dy particione dhe në këtë topic është abonuar një consumer ().
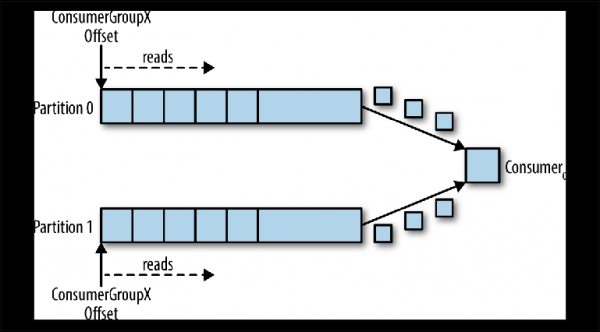
Figura 3-5. Një consumer lexon nga disa particione
Në këtë skenar, consumer-it i jepet kontrolli mbi offset-et që korrespondojnë me group_id e tij në të dy particionet dhe nis leximi i mesazheve nga të dy particionet.
Kur këtij topic i shtohet një consumer tjetër për të njëjtin group_id, Kafka ricakton (reallocate) njërin nga particionet nga consumer-i i parë te i dyti. Pas kësaj, secila instancë consumer-i do të lexojë nga një particion i topic ().
Për të siguruar përpunimin paralel të mesazheve në 20 rrjedha, do t’ju duhen të paktën 20 particione. Nëse particionet janë më pak, do të mbeten consumer-a pa punë, siç u përshkrua më herët në diskutimin për consumer-at monopol.
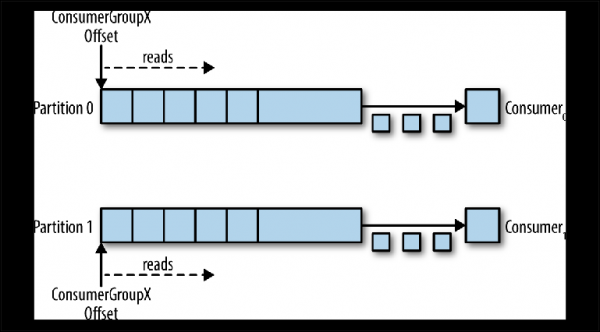
Figura 3-6. Dy consumer-a në të njëjtin grup consumer-ash lexojnë nga particione të ndryshme
Kjo skemë e ul ndjeshëm kompleksitetin e punës së brokerit Kafka krahasuar me shpërndarjen e mesazheve që kërkohet për të mbështetur një radhë JMS. Këtu nuk ka nevojë të shqetësoheni për pikat e mëposhtme:
- Cili consumer duhet ta marrë mesazhin e radhës, bazuar në shpërndarjen ciklike (round-robin), kapacitetin aktual të buffer-ëve të prefetch-it ose mesazhet e mëparshme (si te grupet e mesazheve JMS).
- Cilat mesazhe u janë dërguar cilëve consumer-ave dhe nëse ato duhet të ridërgohen në rast dështimi.
Gjithçka që duhet të bëjë brokeri Kafka është t’i dorëzojë mesazhet consumer-it në mënyrë sekuenciale, kur ky i fundit i kërkon ato.
Megjithatë, kërkesat për paralelizimin e leximit dhe ridërgimin e mesazheve të dështuara nuk zhduken askund — përgjegjësia për to thjesht kalon nga brokeri te klienti. Kjo do të thotë se ato duhet të merren parasysh në kodin tuaj.
Dërgimi i mesazheve
Përgjegjësia për të vendosur se në cilin particion të dërgohet mesazhi i takon producer-it të atij mesazhi. Për të kuptuar mekanizmin me të cilin bëhet kjo, fillimisht duhet të shqyrtojmë se çfarë po dërgojmë në të vërtetë.
Ndërsa në JMS përdorim një strukturë mesazhi me metadata (header-a dhe veti) dhe një trup që përmban ngarkesën e dobishme (payload), në Kafka mesazhi është një çift «çelës-vlerë». Ngarkesa e dobishme e mesazhit dërgohet si vlera (value). Çelësi, nga ana tjetër, përdoret kryesisht për particionim dhe duhet të përmbajë një çelës specifik për logjikën e biznesit, në mënyrë që mesazhet e lidhura të vendosen në të njëjtin particion.
Në Kapitullin 2 diskutuam skenarin e basteve online, ku ngjarjet e lidhura duhet të përpunohen sipas radhës nga një consumer i vetëm:
- Llogaria e përdoruesit konfigurohet.
- Paratë kreditohen në llogari.
- Vendoset një bast, i cili i tërheq paratë nga llogaria.
Nëse çdo ngjarje përfaqëson një mesazh të dërguar në një topic, atëherë në këtë rast çelësi natyror do të ishte identifikuesi i llogarisë.
Kur një mesazh dërgohet duke përdorur Kafka Producer API, ai i kalon funksionit të particionimit, i cili, duke marrë parasysh mesazhin dhe gjendjen aktuale të klasterit Kafka, kthen identifikuesin e particionit ku duhet të dërgohet mesazhi. Ky funksion zbatohet në Java përmes ndërfaqes Partitioner.
Kjo ndërfaqe duket si më poshtë:
interface Partitioner {
    int partition(String topic,
        Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster);
}
Implementimi i Partitioner për përcaktimin e particionit përdor si parazgjedhje algoritmin e hash-it mbi çelësin (general-purpose hashing algorithm over the key) ose round-robin, nëse çelësi nuk është specifikuar. Kjo vlerë e parazgjedhur funksionon mirë në shumicën e rasteve. Megjithatë, në të ardhmen mund të dëshironi të shkruani një implementim tuajin.
Shkrimi i strategjisë suaj të particionimit
Le të shqyrtojmë një shembull kur dëshironi të dërgoni metadata së bashku me ngarkesën e dobishme të mesazhit. Ngarkesa e dobishme në shembullin tonë është një udhëzim për të bërë një depozitë në llogarinë e lojës. Udhëzimi është ajo që duam të garantojmë se nuk modifikohet gjatë transmetimit dhe duam të jemi të sigurt se vetëm një sistem i besuar në rrjedhën sipër mund ta iniciojë këtë udhëzim. Në këtë rast, sistemi dërgues dhe ai marrës bien dakord për përdorimin e një nënshkrimi për të verifikuar autenticitetin e mesazhit.
Në JMS të zakonshëm, thjesht përcaktojmë një veti «nënshkrimi i mesazhit» dhe ia shtojmë mesazhit. Megjithatë, Kafka nuk na ofron një mekanizëm për të transmetuar metadata — vetëm çelësin dhe vlerën.
Meqenëse vlera është payload-i i transferimit bankar, integritetin e së cilës duam ta ruajmë, nuk na mbetet zgjidhje tjetër veçse të përcaktojmë një strukturë të dhënash për përdorim te çelësi. Duke supozuar se na duhet identifikuesi i llogarisë për particionim, pasi të gjitha mesazhet që lidhen me llogarinë duhet të përpunohen sipas radhës, do të përdorim strukturën e mëposhtme JSON:
{
  "signature": "541661622185851c248b41bf0cea7ad0",
  "accountId": "10007865234"
}
Meqenëse vlera e nënshkrimit do të ndryshojë në varësi të payload-it, strategjia e parazgjedhur e hash-it e ndërfaqes Partitioner nuk do t’i grupojë në mënyrë të besueshme mesazhet e lidhura. Prandaj, do të na duhet të shkruajmë strategjinë tonë, e cila do ta analizojë këtë çelës dhe do të bëjë partition sipas vlerës accountId.
Kafka përfshin checksum-e për zbulimin e dëmtimit të mesazheve në ruajtje dhe ofron një gamë të plotë funksionesh sigurie. Edhe kështu, ndonjëherë shfaqen kërkesa specifike për industri të caktuara, si ajo e përmendur më sipër.
Një strategji e personalizuar e particionimit duhet të garantojë që të gjitha mesazhet e lidhura të përfundojnë në të njëjtën particion. Edhe pse kjo duket e thjeshtë, kërkesa mund të ndërlikohet për shkak të rëndësisë së renditjes së mesazheve të lidhura dhe nga fakti sa i pandryshueshëm është numri i particioneve në topic.
Numri i particioneve në topic mund të ndryshojë me kalimin e kohës, pasi ato mund të shtohen nëse trafiku tejkalon pritshmëritë fillestare. Si rrjedhojë, çelësat e mesazheve mund të lidhen me particionin ku janë dërguar fillimisht, duke nënkuptuar një pjesë gjendjeje që duhet të shpërndahet midis instancave të producer-it.
Një faktor tjetër që duhet marrë parasysh është njëtrajtshmëria e shpërndarjes së mesazheve midis particioneve. Në përgjithësi, çelësat nuk shpërndahen në mënyrë të barabartë nëpër mesazhe dhe funksionet hash nuk garantojnë shpërndarje të drejtë të mesazheve për një grup të vogël çelësash.
Është e rëndësishme të theksohet se, pavarësisht si vendosni t’i ndani mesazhet, vetë ndarësi mund të duhet të përdoret sërish.
Le të shqyrtojmë kërkesën për replikimin e të dhënave midis klasterëve Kafka në vendndodhje të ndryshme gjeografike. Për këtë qëllim, Kafka ofron një mjet të linjës së komandës të quajtur MirrorMaker, i cili përdoret për të lexuar mesazhe nga një klaster dhe për t’i dërguar ato në një tjetër.
MirrorMaker duhet të kuptojë çelësat e topic-ut që replikohet, në mënyrë që të ruajë rendin relativ midis mesazheve gjatë replikimit ndërmjet klasterëve, pasi numri i particioneve për këtë topic mund të mos përputhet në të dy klasterët.
Strategjitë e personalizuara të particionimit hasen relativisht rrallë, sepse hash-i i parazgjedhur ose round-robin funksionojnë mirë në shumicën e skenarëve. Megjithatë, nëse ju duhen garanci strikte për renditjen ose duhet të nxirrni metadata nga payload-et, atëherë particionimi është diçka që duhet ta shqyrtoni më nga afër.
Përparësitë e shkallëzueshmërisë dhe performancës së Kafka vijnë nga kalimi i disa përgjegjësive të broker-it tradicional te klienti. Në këtë rast, merret vendimi se si të shpërndahen mesazhet potencialisht të lidhura te disa consumer-a që punojnë paralelisht.
Edhe broker-ët JMS duhet të përballojnë kërkesa të tilla. Interesante është se mekanizmi i dërgimit të mesazheve të lidhura te i njëjti consumer, i realizuar përmes JMS Message Groups (një variant i strategjisë sticky load balancing (SLB)), gjithashtu kërkon që dërguesi t’i shënojë mesazhet si të lidhura. Në rastin e JMS, broker-i është përgjegjës për dërgimin e këtij grupi mesazhesh të lidhura te një consumer nga shumë të tillë dhe për transferimin e pronësisë së grupit nëse consumer-i bie.
Marrëveshje nga ana e producer-it
Particionimi nuk është e vetmja gjë që duhet marrë parasysh gjatë dërgimit të mesazheve. Le të shqyrtojmë metodat send() të klasës Producer në Java API:
Future  send(ProducerRecord  record);
Future  send(ProducerRecord  record, Callback callback);
Duhet theksuar menjëherë se të dyja metodat kthejnë Future, çka tregon se operacioni i dërgimit nuk kryhet menjëherë. Në praktikë, mesazhi (ProducerRecord) shkruhet në buffer-in e dërgimit për çdo particion aktiv dhe i transmetohet broker-it nga një thread në sfond në bibliotekën e klientit Kafka. Edhe pse kjo e bën punën jashtëzakonisht të shpejtë, do të thotë gjithashtu se një aplikacion i shkruar pa përvojë mund t’i humbasë mesazhet nëse procesi i tij ndalet.
Si gjithmonë, ekziston një mënyrë për ta bërë operacionin e dërgimit më të besueshëm në kurriz të performancës. Madhësia e këtij buffer-i mund të vendoset në 0, dhe thread-i i aplikacionit që dërgon do të detyrohet të presë derisa transmetimi i mesazhit te broker-i të përfundojë, si më poshtë:
RecordMetadata metadata = producer.send(record).get();Edhe një herë për leximin e mesazheve
Leximi i mesazheve sjell vështirësi shtesë, për të cilat duhet të ndalemi pak. Ndryshe nga API i JMS, i cili mund të nisë një message listener si përgjigje ndaj mbërritjes së një mesazhi, ndërfaqja Consumer në Kafka përdor vetëm polling. Le ta shqyrtojmë më nga afër metodën poll (), e cila përdoret për këtë qëllim:
ConsumerRecords poll(long timeout);Vlera e kthyer nga metoda është një strukturë-kontejner që përmban disa objekte ConsumerRecord nga potencialisht disa particione. ConsumerRecord në vetvete është një objekt mbajtës për një çift kyç-vlerë me metadata përkatëse, si p.sh. particioni nga i cili është marrë.
Siç u diskutua në Kapitullin 2, duhet të mbajmë vazhdimisht parasysh se çfarë ndodh me mesazhet pas përpunimit të tyre me sukses ose pa sukses, për shembull nëse klienti nuk mund ta përpunojë mesazhin ose nëse ndërpret punën. Në JMS kjo trajtohej përmes acknowledgement mode. Broker-i ose do ta fshijë mesazhin e përpunuar me sukses, ose do ta ridërgojë mesazhin e papërpunuar ose të dështuar (me kusht që të jenë përdorur transaksione).
Kafka funksionon krejt ndryshe. Mesazhet nuk fshihen në broker pas leximit, dhe përgjegjësia për atë që ndodh në rast dështimi i takon vetë kodit që i lexon.
Siç e kemi thënë tashmë, grupi i consumer-ëve është i lidhur me offset-in në log. Pozicioni në log i lidhur me këtë offset korrespondon me mesazhin e radhës që do të kthehet si përgjigje ndaj poll ()Koha kur kjo zhvendosje rritet është vendimtare gjatë leximit.
Duke iu rikthyer modelit të leximit të shqyrtuar më parë, përpunimi i mesazhit përbëhet nga tre faza:
- Nxirrni mesazhin për lexim.
- Përpunoni mesazhin.
- Konfirmoni mesazhin.
Konsumatori Kafka ofrohet me opsionin e konfigurimit enable.auto.commit. Ky është një konfigurim i parazgjedhur që përdoret shpesh, siç ndodh zakonisht me cilësimet që përmbajnë fjalën «auto».
Deri në Kafka 0.10, klienti që përdorte këtë parametër dërgonte offset-in e mesazhit të fundit të lexuar në thirrjen e radhës të poll () pas përpunimit. Kjo do të thoshte se çdo mesazh që ishte nxjerrë tashmë (fetched) mund të ripërpunohej nëse klienti e kishte përpunuar tashmë, por ishte ndërprerë papritur përpara thirrjes së poll (). Meqenëse broker-i nuk ruan asnjë gjendje lidhur me sa herë është lexuar një mesazh, konsumatori i radhës që e nxjerr këtë mesazh nuk do të dijë se ka ndodhur diçka e gabuar. Kjo sjellje ishte pseudo-transaksionale. Offset-i komitohej vetëm në rast të përpunimit të suksesshëm të mesazhit, por nëse klienti ndërpritej, broker-i ia dërgonte sërish të njëjtin mesazh një klienti tjetër. Kjo sjellje përputhej me garancinë e dorëzimit të mesazheve «të paktën një herë«.
Në Kafka 0.10, kodi i klientit u ndryshua në mënyrë të tillë që commit të nisej periodikisht nga biblioteka e klientit, në përputhje me cilësimin auto.commit.interval.ms. Kjo sjellje ndodhet diku mes mënyrave JMS AUTO_ACKNOWLEDGE dhe DUPS_OK_ACKNOWLEDGE. Kur përdoret auto-commit, mesazhet mund të konfirmohen pavarësisht nëse janë përpunuar realisht apo jo — kjo mund të ndodhë në rastin e një konsumatori të ngadaltë. Nëse konsumatori ndërpritej, mesazhet nxirreshin nga konsumatori pasues duke filluar nga pozicioni i komituar, gjë që mund të çonte në kapërcimin e një mesazhi. Në këtë rast, Kafka nuk i humbte mesazhet; kodi që lexonte thjesht nuk i përpunonte ato.
Ky regjim ka të njëjtat pasoja si në versionin 0.9: mesazhet mund të përpunohen, por në rast dështimi, offset-i mund të mos komitohet, gjë që mund të çojë potencialisht në dublim të dorëzimit. Sa më shumë mesazhe të nxirrni gjatë ekzekutimit të poll (), aq më i madh bëhet ky problem.
Siç u diskutua në seksionin «Leximi i mesazheve nga radha» në faqen 21, në një sistem mesazhesh nuk ekziston koncepti i dorëzimit të mesazhit vetëm një herë, nëse merren parasysh skenarët e dështimit.
Në Kafka ka dy mënyra për të konfirmuar (commit) offset-in: automatikisht dhe manualisht. Në të dyja rastet, mesazhet mund të përpunohen disa herë nëse mesazhi është përpunuar, por ka ndodhur një dështim përpara commit-it. Gjithashtu, mund të ndodhë që mesazhi të mos përpunohet fare, nëse commit-i është kryer në sfond dhe kodi juaj është ndërprerë para se të fillonte përpunimin (e mundur në Kafka 0.9 dhe versionet më të hershme).
Procesi i commit-it të offset-it mund të menaxhohet manualisht në API-në e consumer-it Kafka duke vendosur parametrin enable.auto.commit në vlerën false dhe duke thirrur në mënyrë të qartë një nga metodat e mëposhtme:
void commitSync();
void commitAsync();
Nëse synoni ta përpunoni mesazhin «të paktën një herë», duhet ta bëni commit-in e offset-it manualisht me commitSync (), duke e ekzekutuar këtë komandë menjëherë pas përpunimit të mesazheve.
Këto metoda nuk lejojnë konfirmimin (acknowledged) të mesazheve përpara se të përpunohen, por nuk bëjnë asgjë për të eliminuar mundësinë e përpunimit të dyfishtë, ndërkohë që krijojnë përshtypjen e transaksionalitetit. Kafka nuk ka transaksione. Klienti nuk ka mundësi të bëjë sa vijon:
- Të kthejë automatikisht pas (roll back) një mesazh që ka dështuar. Consumer-ët duhet t’i trajtojnë vetë përjashtimet që lindin nga payload-et problematike dhe ndërprerjet e backend-it, pasi nuk mund të mbështeten te ridorëzimi i mesazheve nga broker-i.
- Të dërgojë mesazhe në disa topic-e brenda një operacioni të vetëm atomik. Siç do ta shohim së shpejti, kontrolli mbi topic-et dhe partition-et e ndryshme mund të jetë në makina të ndryshme në cluster-in Kafka, të cilat nuk koordinojnë transaksionet gjatë dërgimit. Në kohën e shkrimit të këtij artikulli, ishte bërë një punë e caktuar për ta bërë këtë të mundur me ndihmën e KIP-98.
- Të lidhë leximin e një mesazhi nga një topic me dërgimin e një mesazhi tjetër në një topic tjetër. Edhe këtu, arkitektura e Kafka-s mbështetet në shumë makina të pavarura që punojnë si një bus i vetëm dhe nuk bëhet asnjë përpjekje për ta fshehur këtë. Për shembull, nuk ekzistojnë komponentë API që do të bënin të mundur lidhjen e Consumer dhe Producer në transaksion. Në JMS kjo sigurohet nga objekti Session, prej të cilit krijohen MessageProducers dhe MessageConsumers.
Nëse nuk mund të mbështetemi te transaksionet, si mund të sigurojmë semantikë më të afërt me atë që ofrojnë sistemet tradicionale të mesazheve?
Nëse ekziston mundësia që offset-i i consumer-it të rritet përpara se mesazhi të jetë përpunuar, për shembull gjatë një dështimi të consumer-it, atëherë consumer-i nuk ka asnjë mënyrë të dijë nëse grupi i tij i consumer-ëve ka humbur mesazhe kur i caktohet një partition. Prandaj, një nga strategjitë është kthimi prapa (rewind) i offset-it në një pozicion të mëparshëm. API-ja e consumer-it të Kafka-s ofron metodat e mëposhtme për këtë:
void seek(TopicPartition partition, long offset);
void seekToBeginning(Collection  partitions);
Sanitizer.replaceElementWithChildren() seek () mund të përdoret me metodën
offsetsForTimes (Map timestampsToSearch) për t'u kthyer në gjendjen e një momenti të caktuar në të kaluarën.
Në mënyrë të nënkuptuar, përdorimi i kësaj qasjeje do të thotë se ka shumë gjasa që disa mesazhe që janë përpunuar më parë të lexohen dhe të përpunohen sërish. Për ta shmangur këtë, mund të përdorim lexim idempotent, siç përshkruhet në Kapitullin 4, për të gjurmuar mesazhet e shqyrtuara më parë dhe për të përjashtuar dublikatat.
Si alternativë, kodi i consumer-it tuaj mund të jetë i thjeshtë nëse humbja ose dublikimi i mesazheve është i pranueshëm. Kur shqyrtojmë rastet e përdorimit për të cilat Kafka përdoret zakonisht, si përpunimi i ngjarjeve të log-eve, metrikave, gjurmimi i klikimeve etj., kuptojmë se humbja e mesazheve të veçanta ka pak gjasa të ketë ndikim domethënës te aplikacionet përreth. Në raste të tilla, vlerat e parazgjedhura janë plotësisht të pranueshme. Nga ana tjetër, nëse aplikacioni juaj duhet të transmetojë pagesa, duhet të kujdeseni me vëmendje për çdo mesazh të vetëm. Gjithçka varet nga konteksti.
Vëzhgimet personale tregojnë se, me rritjen e intensitetit të mesazheve, vlera e secilit mesazh individual bie. Mesazhet në vëllim të madh, si rregull, bëhen të vlefshme kur shqyrtohen në formë të agreguar.
Disponueshmëri e lartë (High Availability)
Qasja e Kafka-s ndaj disponueshmërisë së lartë ndryshon ndjeshëm nga ajo e ActiveMQ. Kafka është projektuar mbi klasterë horizontalisht të shkallëzueshëm, ku të gjitha instancat e brokerit pranojnë dhe shpërndajnë mesazhe njëkohësisht.
Klasteri Kafka përbëhet nga disa instanca brokeri që funksionojnë në serverë të ndryshëm. Kafka është projektuar për të punuar në pajisje standarde të pavarura, ku çdo nyje ka hapësirën e vet të dedikuar të ruajtjes. Përdorimi i ruajtjes në rrjet (SAN) nuk rekomandohet, pasi disa nyje llogaritëse mund të konkurrojnë për intervalet kohore të ruajtjesDhe të krijojnë konflikte.
Kafka është një gjithmonë aktive sistem. Shumë përdorues të mëdhenj të Kafka-s nuk i fikin kurrë klasterët e tyre dhe softueri përditësohet gjithmonë përmes rinisjes sekuenciale. Kjo arrihet duke garantuar përputhshmëri me versionet e mëparshme për mesazhet dhe ndërveprimet midis brokerëve.
Brokerët lidhen me klasterin e serverëve , i cili vepron si regjistër i të dhënave të konfigurimit dhe përdoret për të koordinuar rolet e çdo brokeri. Vetë ZooKeeper është një sistem i shpërndarë që siguron disponueshmëri të lartë përmes replikimit të informacionit duke vendosur një kuorum.
Në rastin bazë, një topic krijohet në klasterin Kafka me vetitë e mëposhtme:
- Numri i particioneve. Siç u diskutua më herët, vlera e saktë e përdorur këtu varet nga niveli i dëshiruar i leximit paralel.
- Koeficienti (faktori) i replikimit përcakton sa instanca brokeri në klaster duhet të përmbajnë regjistrat për këtë particion.
Duke përdorur ZooKeeper për koordinim, Kafka përpiqet t’i shpërndajë në mënyrë të drejtë particionet e reja midis brokerëve në klaster. Kjo bëhet nga një instancë që kryen rolin e Kontrolluesit.
Gjatë ekzekutimit, për çdo particion të topic-ut Kontrolluesi i cakton brokerit rolet e liderit (leader, master, drejtues) dhe ndjekësve (followers, slaves, vartës). Brokeri që vepron si lider për këtë particion është përgjegjës për marrjen e të gjitha mesazheve që i dërgohen nga prodhuesit dhe për shpërndarjen e mesazheve te konsumatorët. Kur mesazhet dërgohen në particionin e topic-ut, ato replikohen në të gjitha nyjet e brokerit që veprojnë si vartëse për këtë particion. Çdo nyje që përmban log-et për particionin quhet replikë. Një broker mund të veprojë si lider për disa particione dhe si vartës për të tjerat.
Një vartës që përmban të gjitha mesazhet e ruajtura te lideri quhet replikë e sinkronizuar (replikë në gjendje sinkronizimi, in-sync replica). Nëse brokeri që vepron si lider për particionin shkëputet, çdo broker që është në gjendje të përditësuar ose të sinkronizuar për këtë particion mund të marrë rolin e liderit. Ky është një dizajn jashtëzakonisht i qëndrueshëm.
Pjesë e konfigurimit të prodhuesit është parametri acks, i cili përcakton sa replika duhet të konfirmojnë (acknowledge) marrjen e mesazhit përpara se rrjedha e aplikacionit të vazhdojë dërgimin: 0, 1 ose të gjitha. Nëse është caktuar vlera të gjitha, atëherë pas marrjes së mesazhit, lideri do t’i dërgojë konfirmimin (confirmation) prodhuesit sapo të marrë konfirmimin (acknowledgements) e shkrimit nga disa replika (duke përfshirë veten), të përcaktuara nga cilësimi i topic-ut min.insync.replicas (si parazgjedhje 1). Nëse mesazhi nuk mund të replikohet me sukses, atëherë prodhuesi do të shkaktojë një përjashtim për aplikacionin (NotEnoughReplicas ose NotEnoughReplicasAfterAppend).
Në një konfigurim tipik krijohet një topic me faktor replikimi 3 (1 lider, 2 vartës për çdo particion) dhe parametri min.insync.replicas caktohet në vlerën 2. Në këtë rast, klasteri do të lejojë që një nga brokerët që menaxhojnë particionin e topic-ut të mund të shkëputet pa ndikuar te aplikacionet kliente.
Kjo na kthen te kompromisi tashmë i njohur mes performancës dhe besueshmërisë. Replikimi kryhet me koston e kohës shtesë të pritjes për konfirmimet (acknowledgments) nga ndjekësit. Megjithatë, meqenëse bëhet paralelisht, replikimi, të paktën në tre nyje, ka të njëjtën performancë si edhe në dy (duke injoruar rritjen e përdorimit të bandwidth-it të rrjetit).
Duke përdorur këtë skemë replikimi, Kafka shmang me zgjuarsi nevojën për të garantuar shkrimin fizik të çdo mesazhi në disk përmes operacionit sync (). Çdo mesazh i dërguar nga prodhuesi do të shkruhet në log-un e particionit, por, siç u diskutua në Kapitullin 2, shkrimi në skedar fillimisht kryhet në buffer-in e sistemit operativ. Nëse ky mesazh replikohet në një instancë tjetër Kafka dhe ndodhet në memorien e saj, humbja e liderit nuk do të thotë se vetë mesazhi është humbur — atë mund ta marrë përsipër replika e sinkronizuar.
Heqja dorë nga nevoja për të kryer operacionin sync () do të thotë se Kafka mund të pranojë mesazhe me shpejtësinë me të cilën mund t’i shkruajë ato në memorie. Anasjelltas, sa më gjatë të mund të shmanget flushing i memories në disk, aq më mirë. Për këtë arsye, nuk janë të rralla rastet kur brokerëve Kafka u caktohen 64 GB memorie ose më shumë. Ky përdorim i memories do të thotë se një instancë Kafka mund të funksionojë lehtësisht me shpejtësi shumë mijëra herë më të lartë se një broker tradicional mesazhesh.
Kafka mund të konfigurohet gjithashtu për të zbatuar operacionin sync () mbi paketat e mesazheve. Meqenëse gjithçka në Kafka është e orientuar drejt punës me paketa, kjo në fakt funksionon mjaft mirë për shumë skenarë përdorimi dhe është një mjet i dobishëm për përdoruesit që kërkojnë garanci shumë të forta. Pjesa më e madhe e performancës së lartë të Kafka-s lidhet me mesazhet që i dërgohen brokerit në formë paketash dhe me faktin që këto mesazhe lexohen nga brokeri në blloqe sekuenciale duke përdorur operacioneve (me operacione gjatë të cilave nuk kryhet detyra e kopjimit të të dhënave nga një zonë e memories në tjetrën). Kjo e fundit është një përfitim i madh për sa i përket performancës dhe burimeve dhe bëhet e mundur vetëm falë përdorimit të strukturës së të dhënave së jurnalit në bazë, e cila përcakton skemën e particionimit.
Në një klaster Kafka, mund të arrihet performancë shumë më e lartë sesa me përdorimin e një brokeri të vetëm Kafka, sepse particionet e topic-ut mund të shkallëzohen horizontalisht në shumë makina të veçanta.
Përfundime
Në këtë kapitull pamë se si arkitektura e Kafka-s rishikon marrëdhënien midis klientëve dhe brokerëve për të siguruar një pipeline jashtëzakonisht të qëndrueshëm të shkëmbimit të mesazheve, me throughput shumë herë më të lartë se ai i një brokeri të zakonshëm të mesazheve. Diskutuam funksionalitetin që përdor për ta arritur këtë qëllim dhe shqyrtuam shkurt arkitekturën e aplikacioneve që e mundësojnë këtë funksionalitet. Në kapitullin tjetër do të shohim problemet e përgjithshme që duhet të zgjidhin aplikacionet e bazuara në shkëmbimin e mesazheve dhe do të diskutojmë strategjitë për t’i adresuar ato. Kapitullin do ta përmbyllim duke përshkruar se si të arsyetohet për teknologjitë e mesazheve në tërësi, në mënyrë që të vlerësoni përshtatshmërinë e tyre për skenarët tuaj të përdorimit.
Pjesa e mëparshme e përkthyer:
Përkthimi u krye:
To be continued...
Vetëm përdoruesit e regjistruar mund të marrin pjesë në anketë. , ju lutem.
A përdoret Kafka në organizatën tuaj?
Po.
Jo
Përdorej më parë, tani jo
Planifikojmë ta përdorim
Kanë votuar 38 përdorues. Kanë abstenuar 8 përdorues.
Burimi: habr.com
