

Efekti i fryrjes së tabelave dhe indekseve (bloat) është i njohur gjerësisht dhe është i pranishëm jo vetëm në Postgres. Ekzistojnë mënyra për ta luftuar atë “nga kutia” siç janë VACUUM FULL ose CLUSTER, por ato bllokojnë tabelat gjatë funksionimit dhe prandaj nuk mund të përdoren gjithmonë.
Ky artikull do të ofrojë pak teori se si ndodh bloat, si mund ta luftojmë atë, për pengesat e shtyrë dhe për problemet që ato sjellin në përdorimin e zgjerimit pg_repack.
Ky artikull është shkruar mbi baza në PgConf.Russia 2020.
Pse ndodh bloat
Në thelb, Postgres mbështetet në një model shumëversional (). Thelbi i saj është se secila rresht në tabelë mund të ketë disa versione, përkatësisht transaksionet shohin jo më shumë se një nga këto versionet, por jo domosdoshmërisht të njëjtën. Kjo lejon që disa transaksione të punojnë në të njëjtën kohë dhe të mos ndikojnë shumë në njëra-tjetrën.
E qartë është se të gjitha këto versione duhet të ruhen. Postgres punon me kujtesën sipas faqeve dhe faqja është minimumi i të dhënave që mund të lexohen nga disku apo të shkruhen. Le të shqyrtojmë një shembull të vogël për të kuptuar si ndodh kjo.
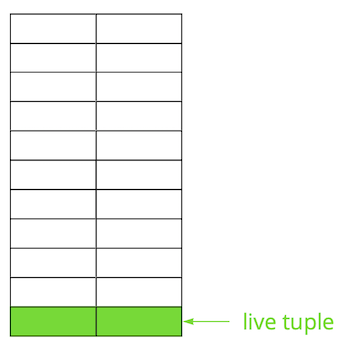
Supozoni se kemi një tabelë në të cilën shtuam disa regjistra. Në faqen e parë të skedarit ku ruhet tabela, u shfaqën të dhëna të reja. Këto janë versione të gjalla të rreshtave, të cilat janë të disponueshme për transaksionet e tjera pas komitimimit (për thjeshtësi le të supozojmë se niveli i izolimit është Read Committed).
Pastaj, ne përditësuam një nga regjistrat dhe kështu shënuam versionin e vjetër si të pavlefshëm.
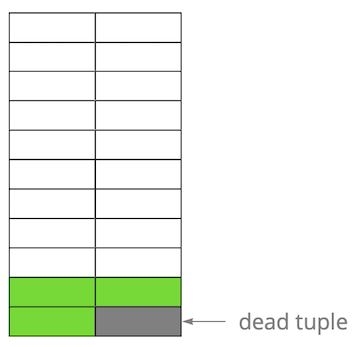
Hap pas hapi, duke përditësuar dhe fshirë versionet e rreshtave, morëm një faqe ku afërsisht gjysma e të dhënave janë “mbetje”. Këto të dhëna nuk i shohin asnjë transaksion.
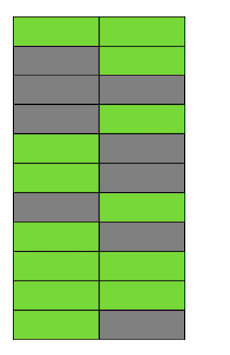
Në Postgres ekziston një mekanizëm , i cili pastron versionet e pavlefshme dhe liçon hapësirë për të dhëna të reja. Por nëse ai nuk është konfigururar mjaft agjresivisht ose është i angazhuar me punë në tabela të tjera, atëherë “të dhënat mbeturina” mbeten dhe na detyrojnë të përdorim faqe të tjera për të dhëna të reja.
Kështu, në shembullin tonë, në një moment të caktuar, tabela do të përbëhet nga katër faqe, por të dhëna të gjalla do të kenë vetëm gjysmën e saj. Si rezultat, kur i qasemi tabelës, ne do të lexojmë shumë më tepër të dhëna sesa nevojitet.
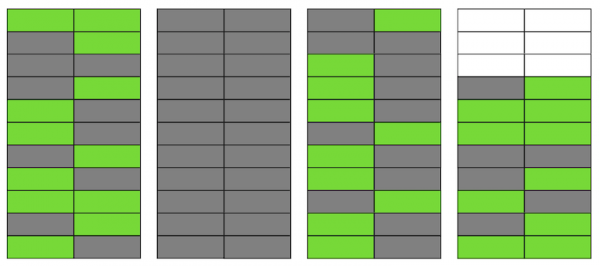
Edhe nëse tani VACUUM heq të gjitha versionet joaktuale të rreshtave, situata nuk do të përmirësohet drasti. Ne do të kemi hapësirë të lirë në faqe ose madje faqe të tëra për rreshta të rinj, por ne do të vazhdojmë të lexojmë më shumë të dhëna se sa është e nevojshme.
Për më tepër, nëse një faqe plotësisht e zbrazët (e dyta në shembullin tonë) do të ishte në fund të skedarit, atëherë VACUUM do ta priste atë. Por tani ajo ndodhet në mes, kështu që nuk mund të bëhet asgjë me të.
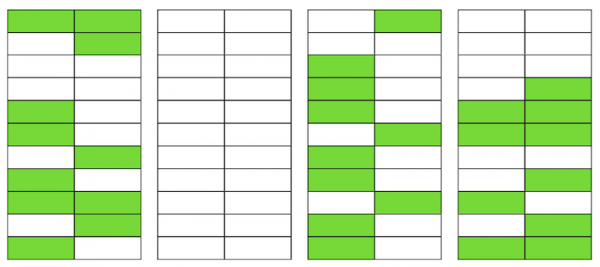
Kur numri i faqeve të tilla të zbrazëta ose shumë të zhvishtuara bëhet i madh, çka quhet bloat, kjo fillon të ndikojë në performancën.
E gjitha e përshkruar më sipër është mekanika e shfaqjes së bloat në tabela. Në indekra, ndodh në një mënyrë të ngjashme.
A kam bloat?
Ka disa mënyra për të përcaktuar nëse keni bloat. Ideja e parë është përdorimi i statistikave të brendshme të Postgres, të cilat përmbajnë informacione të përafërta për numrin e rreshtave në tabela, numrin e rreshtave 'të gjallë' dhe të tjera. Në internet mund të gjeni një mori variantësh të skripteve të gatshme. Ne e morëm si bazë nga PostgreSQL Experts, e cila mund të vlerësojë bloat-in e tabelave së bashku me toast dhe bloat-in e indekseve btree. Nga përvoja jonë, gabimi i saj është 10-20%.
Një mënyrë tjetër është përdorimi i zgjerimit , i cili lejon të shohim brenda faqeve dhe të marrim vlerësimet si të përafruara ashtu edhe të sakta për bloat. Por në rastin e dytë, do të duhet të skanojmë të gjithë tabelën.
Një vlerë e vogël e bloat, deri në 20%, ne e konsiderojmë të pranueshme. Mund të merren si analogjia e fillfactor për dhe . Në 50% ose më shumë mund të fillojnë problemet me performancën.
Mënyrat për të luftuar bloat-in
Në Postgres ka disa mënyra për të luftuar bloat-in 'nga kutia', megjithatë ato nuk janë gjithmonë të përshtatshme për të gjitha raste.
Konfiguroni AUTOVACUUM, që bloat-i të mos shfaqetDhe nëse jemi më të saktë, për ta mbajtur atë në një nivel të pranueshëm për ju. Duket si një këshillë "kapiteni", por në realitet nuk është gjithmonë e lehtë ta arrish. Për shembull, nëse jeni duke zhvilluar aktivisht me ndryshime të rregullta të schemës së të dhënave ose ndodhin disa migrime të të dhënave. Si pasojë, profili juaj i ngarkesës mund të ndryshojë shpesh dhe, zakonisht, ai është i ndryshëm për tabela të ndryshme. Kjo do të thotë se duhet të punoni vazhdimisht përpara dhe të përshtatni AUTOVACUUM për profilin e ndryshueshëm të secilës tabelë. Por është e qartë që ta bësh këtë nuk është e lehtë.
Një tjetër shkak i zakonshëm pse AUTOVACUUM nuk arrin të përpunojë tabelat është prania e transaksioneve të gjata, të cilat nuk e lejojnë atë të pastroni të dhënat sepse ato janë të aksesueshme për këto transaksione. Rekomandimi këtu gjithashtu është i qartë - të shkurtoni transaksionet "në pritje" dhe të minimizoni kohën e transaksioneve aktive. Por nëse ngarkesa e aplikacionit tuaj është një hibrid OLAP dhe OLTP, atëherë ju mund të keni njëkohësisht shumë përditësime të shpeshta dhe kërkesa të shkurtra, si dhe operacione të gjata - për shembull, ndërtimi i një raporti të caktuar. Në një situatë të tillë, është e mençur të mendoni për shpërndarjen e ngarkesës në baza të ndryshme, çka do të lejojë optimizimin më të hollë të secilës prej tyre.
Një tjetër shembull - edhe nëse profili është homogjen, por DB është nën një ngarkesë shumë të lartë, atëherë madje edhe AUTOVACUUM më agresiv nuk mund të përballojë, dhe bloati do të shfaqet. Shkallëzimi (vertikalisht ose horizontalisht) është zgjidhja e vetme.
Si të veproni kur AUTOVACUUM e keni konfiguruar, por bloat vazhdon të rritet.
Ekipa VACUUM FULL ristrukturon përmbajtjen e tabelave dhe indekseve dhe lë vetëm të dhënat aktuale në to. Për të eliminuar bloat, ajo punon në mënyrë ideale, por gjatë ekzekutimit të saj, merret një bllokim ekskluziv mbi tabelën (AccessExclusiveLock), i cili nuk lejon ekzekutimin e kërkesave për këtë tabelë, madje as të zgjedhurat. Nëse mund të lejoni një ndalesë të shërbimit tuaj ose të një pjese të tij për një kohë (nga dhjetëra minuta deri në disa orë, në varësi të madhësisë së DB-së dhe harduerit tuaj), atëherë ky opsion është më i miri. Ne, fatkeqësisht, nuk arrijmë të ekzekutojmë VACUUM FULL brenda kohës së planifikuar për mirëmbajtje, kështu që ky opsion nuk na përshtatet.
Ekipa CLUSTER po ashtu rindërton përmbajtjen e tabelave, siç bën VACUUM FULL, duke lejuar gjithashtu të specifikohet indeksi sipas të cilit të dhënat do të renditen fizikisht në disk (por në të ardhmen për rreshtat e rinj renditja nuk garanton). Në disa situata, kjo është një optimizim i mirë për një sërë kërkimesh – me leximin e disa regjistrave përmes indeksit. Disavantazhi i komandës është i njëjtë me atë të VACUUM FULL – ajo bllokon tabelën gjatë punës.
Ekipa REINDEX është e ngjashme me dy të mëparshmet, por kryen rindërtimin e një indeksi të caktuar ose të gjithë indekseve të tabelës. Bllokimet janë pak më të dobëta: ShareLock në tabelë (pengon modifikimet, por lejon ekzekutimin e select) dhe AccessExclusiveLock në indekson e rindërtuar (bllokon kërkesat që përdorin këtë indeks). Megjithatë, në versionin 12 të Postgres u shfaq një parameter , i cili lejon rindërtimin e indeksit, pa bllokuar shtimin, ndryshimin ose fshirjen e regjistrave paralelisht.
Në versionet më të hershme të Postgres, mund të arrihet një rezultat, i ngjashëm me REINDEX CONCURRENTLY, përmes . Ai lejon krijimin e një indeksi pa bllokim të rreptë (ShareUpdateExclusiveLock, i cili nuk pengon kërkesat paralel), pastaj zëvendësimin e indeksit të vjetër me të riun dhe fshirjen e indeksit të vjetër. Kjo lejon eliminimin e bloat të indekseve, pa penguar punën e aplikacionit tuaj. Është e rëndësishme të kihet parasysh se gjatë rindërtimit të indekseve do të ketë një ngarkesë të shtuar në sistemin e disqeve.
Pra, nëse për indekset ekzistojnë mënyra për të eliminuar bloat "në ngrohje", për tabelat nuk ka të tilla. Këtu hyjnë në lojë disa zgjerime të jashtme: (më parë pg_reorg), , dhe të tjerë. Në kuadër të kësaj artikulli, nuk do t'i krahasoj dhe do të flas vetëm për pg_repack, të cilin pas disa përmirësimesh e përdorim në kompaninë tonë.
Si funksionon pg_repack
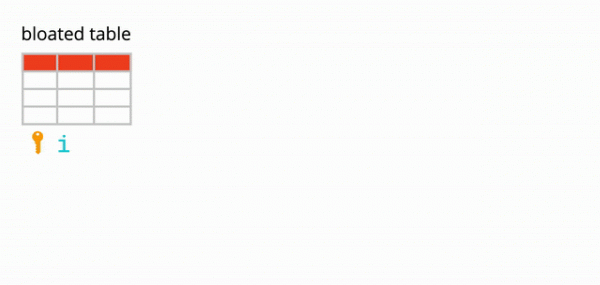
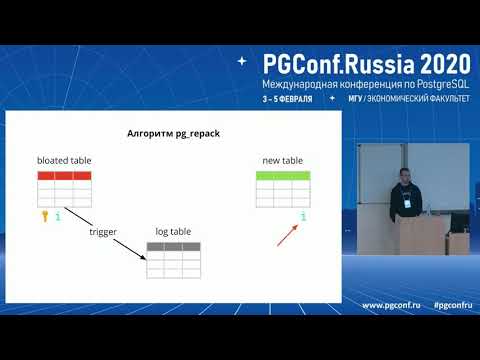
Supozoni se kemi një tabelë krejtësisht normale – me indekse, kufizime dhe, fatkeqësisht, me bloat. Hapi i parë që merr pg_repack është të krijojë një tabelë log, për të mbajtur të dhënat për të gjitha ndryshimet gjatë punës. Një trigger do të replikohet këto ndryshime në çdo insert, update dhe delete. Më pas krijohet një tabelë, e ngjashme me origjinalen në strukturë, por pa indekse dhe kufizime, për të mos ngadalësuar procesin e shtimit të të dhënave.
Pastaj pg_repack transferon në një tavolinë të re të dhënat nga e vjetra, duke filtruar automatikisht të gjitha rreshtat e papërshtatshëm, dhe më pas krijon indekset për tavolinën e re. Gjatë përfundimit të këtyre operacioneve, ndryshimet grumbullohen në tabelën e log.
Hapi qëndron në transferimin e ndryshimeve në tavolinën e re. Transferimi kryhet në disa iteracione dhe kur në tabelën e log mbeten më pak se 20 regjistra, pg_repack merr një bllokim të rreptë, transferon të dhënat e fundit dhe zëvendëson tavolinën e vjetër me atë të re në tabelat sistemike të Postgres. Ky është momenti i vetëm dhe shumë i shkurtër kur nuk do të mund të punoni me tavolinën. Pas kësaj, tavolina e vjetër dhe tabela me logjet fshihen dhe në sistemin e skedarëve lirohet hapësirë. Procesi ka përfunduar.
Në teori gjithçka duket e shkëlqyer, çfarë ndodh në praktikë? Ne e testuam pg_repack pa ngarkesë dhe nën ngarkesë, kontrolluam funksionimin e saj në rast të ndalimit të parakohshëm (thjesht përmes Ctrl+C). Të gjitha testet ishin pozitive.
Shkuam në prodhim - dhe këtu gjithçka shkoi ndryshe nga sa prisnim.
Blin i parë në prodhim
Në klasën e parë morëm një gabim për shkelje të kufizimit unik:
$ ./pg_repack -t tablename -o id
INFO: po ribëhet tavolina "tablename"
ERROR: kërkesa dështoi:
    ERROR: vlera e dyfishuar e çelësit shkel kufizimin unik "index_16508"
DETALJ:  Çelësi (id, index)=(100500, 42) ekziston tashmë.
Ky kufizim kishte një emër të gjeneruar automatikisht index_16508 – e krijoi pg_repack. Sipas atributeve që përbëjnë këtë kufizim, ne e identifikuam "kufizimin tonë" që i përgjigjej. Problemi ishte se ky nuk ishte një kufizim të zakonshëm, por një i vonuar (), domethënë, kontrolli i tij kryhet pas komandës sql, gjë që çon në pasoja të papritura.
Kufizimet e vonuara: përse janë të nevojshme dhe si funksionojnë
Pak teori rreth kufizimeve të vonuara.
Le të shqyrtojmë një shembull të thjeshtë: ne kemi një tabelë referimi për automjete me dy atribute – emrin dhe rendin e automjetit në referencë.
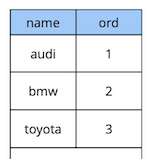
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique
);
Supozoni se na nevojitet të këmbim automobilin e parë dhe të dytë. Zgjidhja "e drejtë" – të përditësojmë vlerën e parë me atë të dytë dhe të dytën me atë të parë:
begin;
  update cars set ord = 2 where name = 'audi';
  update cars set ord = 1 where name = 'bmw';
commit;
Por kur e ekzekutojmë këtë kod, ne pritet të marrim një shkelje të kufizimit, sepse rendi i vlerave në tabelë është unik:
[23305] ERROR: vlera e kyçit të përsëritur shkel kufizimin unik “uk_cars”
Detaj: Kyçi (ord)=(2) ekziston tashmë.
Si ta bëjmë ndryshe? Opsioni i parë: shtoni një zëvendësim të shtesave me një vlerë renditje që garanton që nuk ekziston në tabelë, për shembull “-1”. Në programim kjo quhet “ndërrimi i vlerave të dy variablave përmes një të tretë”. E vetmja disavantazh i këtij metodi është përditësimi shtesë.
Opsioni i dytë: riprojektimi i tabelës për të përdorur një tip të dhënash me pikë float për vlerën e renditjes në vend të numrave të plotë. Kështu, kur përditësoni vlerën nga 1, për shembull, në 2.5, regjistrimi i parë automatikisht “qëndron” ndërmjet të dytit dhe të tretit. Ky zgjidhje është funksionale, por ka dy kufizime. Së pari, kjo nuk do të jetë e përshtatshme për ju nëse vlera përdoret diku në ndërfaqe. Së dyti, në varësi të saktësisë së tipit të të dhënave, do të keni një numër të kufizuar mundësish për t’u futur përpara se të bëni ricakullimin e të gjitha vlerave të regjistrimeve.
Opsioni i tretë: bëni kufizimin të vonuar, që do të kontrollohet vetëm në momentin e angazhimit:
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique deferrable initially deferred
);
Pavarësisht se logjika e kërkesës sonë fillestare garanton që në momentin e angazhimit të gjitha vlerat janë unike, ajo do të ekzekutohet me sukses.
Shembulli i trajtuar më sipër, natyrisht, është shumë sintetik, por ideja qartësohet. Në aplikacionin tonë ne përdorim kufizime të vonuara për të implementuar logjikën që ndihmon në zgjidhjen e konflikteve ndërkohë që përdoruesit punojnë paralelisht me objekte të përbashkëta-widget në tabelën. Përdorimi i këtyre kufizimeve na lejon të bëjmë kodin aplikativ pak më të thjeshtë.
Në përgjithësi, në varësi të tipit të kufizimit në Postgres ekzistojnë tre nivele granulariteti për kontrollin e tyre: niveli i rreshtit, transaksioni dhe shprehja.
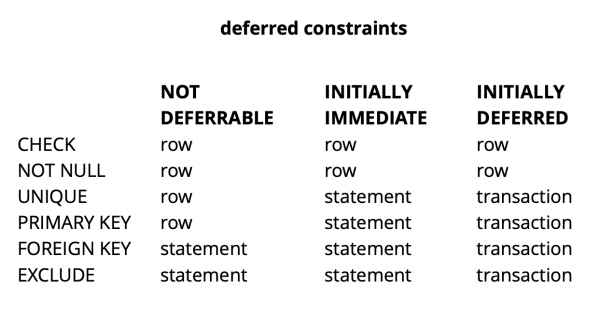
Burimi:
CHECK dhe NOT NULL kontrollohen gjithmonë në nivelin e rreshtit, për kufizimet e tjera, siç shihet nga tabela, ka mundësi të ndryshme. Më shumë mund të lexoni .
Nëse e përmbledhim shkurt, kufizimet e vonuara në disa situata japin një kod më të lehtë për t'u lexuar dhe një numër më të vogël komandash. Megjithatë, për këtë duhet të paguajmë me komplikimin e procesit të debagimit, pasi momenti i shfaqjes së gabimit dhe momenti kur e zbuloni atë janë të shpërndara në kohë. Një problem tjetër i mundshëm lidhet me faktin se planifikuesi nuk mund të ndërtojë gjithmonë një plan optimal, nëse në kërkesë përfshihet një kufizim i vonuar.
Përmirësimi i pg_repack
Kemi kuptuar se çfarë janë kufizimet e vonuara, por si lidhen ato me problemin tonë? Le të rikujtojmë gabimin që morëm më parë:
$ ./pg_repack -t tablename -o id
INFO: po ribëhet tavolina "tablename"
ERROR: kërkesa dështoi:
    ERROR: vlera e dyfishuar e çelësit shkel kufizimin unik "index_16508"
DETALJ:  Çelësi (id, index)=(100500, 42) ekziston tashmë.
Ai ndodh në momentin e kopjimit të të dhënave nga tabela e logëve në një tabelë të re. Kjo duket e çuditshme, pasi të dhënat në tabelën e logëve komitohen së bashku me të dhënat e tabelës origjinale. Nëse ato përmbushin kufizimet e tabelës origjinale, si mund të shkelin të njëjtat kufizime në të re?
Siç duket, rrënjët e problemit qëndrojnë në hapin e mëparshëm të funksionimit të pg_repack, ku krijohen vetëm indeksat, por jo kufizimet: në tabelën e vjetër kishte një kufizim unik, ndërsa në të reën është krijuar një indeks unik në vend të tij.
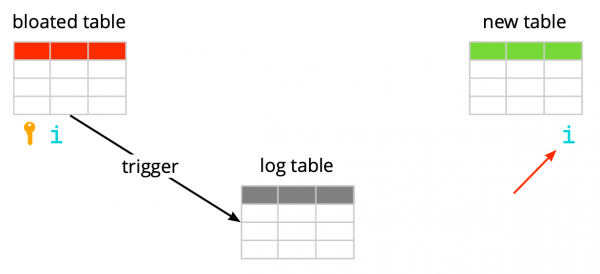
Është e rëndësishme të theksohet se nëse kufizimi është i zakonshëm dhe jo i vonuar, indeksi unik i krijuar në vend të tij është i barabartë me këtë kufizim, pasi kufizimet unike në Postgres realizohen përmes krijimit të një indeksi unik. Por në rastin e kufizimeve të vonuara, sjellja nuk është e njëjtë, sepse indeksi nuk mund të jetë i vonuar dhe gjithmonë kontrollohet në momentin e ekzekutimit të komandës SQL.
Pra, thelbi i problemit qëndron në "vonueshmërinë" e kontrollit: në tabelën origjinale ajo ndodh në momentin e komitimit, ndërsa në të reën – në momentin e ekzekutimit të komandës SQL. Pra, na nevojitet të sigurojmë që kontrollet të kryhen në mënyrë të njëjtë në të dy rastet: ose gjithmonë të vonuara, ose gjithmonë menjëherë.
Pra, cilat ide kemi pasur.
Të krijojmë një indeks, të ngjashëm me i vonuar
Ideja e parë është të kryhen të dy verifikimet në mënyrë të menjëhershme. Kjo mund të sjellë disa false positive në kufizimin e mundësive, por nëse ato janë të pakta, nuk duhet të ndikonin në punën e përdoruesve, pasi për ta këto konflikte janë një situatë normale. Ndodhin, për shembull, kur dy përdorues fillojnë të redaktojnë një widget të njëjtë në të njëjtën kohë, dhe klienti i përdoruesit të dytë nuk arrin të marrë informacion se widget-i tashmë është bllokuar për redaktim nga përdoruesi i parë. Në një situatë të tillë, serveri i përgjigjet përdoruesit të dytë me një refuzim, dhe klienti i tij rikthen ndryshimet dhe bllokon widget-in. Pak më vonë, kur përdoruesi i parë përfundon redaktimin, i dyti do të marrë informacionin që widget-i nuk është më i bllokuar dhe do të mund të ripërsërisë veprimin e tij.
Për të garantuar që verifikimet të jenë gjithmonë në regjim të menjëhershëm, ne kemi krijuar një indeks të ri, të ngjashëm me kufizimin origjinal të vonuar:
CREATE UNIQUE INDEX CONCURRENTLY uk_tablename__immediate ON tablename (id, index);
-- run pg_repack
DROP INDEX CONCURRENTLY uk_tablename__immediate;
Në ambientin e testimit morëm vetëm disa gabime të pritura. Sukces! Përsëri e nisëm pg_repack në prodhim dhe morëm 5 gabime në klasterin e parë për një orë punë. Ky është një rezultat i pranueshëm. Megjithatë, në klasterin e dytë numri i gabimeve u rrit shumë dhe na u detyruam të ndalnim pg_repack.
Pse ndodhi kështu? Probabiliteti i shfaqjes së gabimit varet nga numri i përdoruesve që punojnë njëkohësisht me widget-et e njëjta. Siç duket, në atë moment, të dhënat e ruajtura në klasterin e parë kishin shumë më pak ndryshime konkurruese se në të tjerët, dmth. thjesht kemi pasur 'fat'.
Ideja nuk funksionoi. Në atë moment, ne pamë dy variante të tjera zgjidhjeje: të rishkruhej kodi ynë aplikativ për të braktisur kufizimet e vonuara, ose të 'mësonim' pg_repack të punonte me to. Ne zgjodhëm të dytën.
Të zëvendësohen indekset në tabelën e re me kufizime të vonuara nga tabela origjinale.
Qëllimi i përmirësimit ishte i qartë – nëse tabela origjinale ka një kufizim të vonuar, atëherë për të rejën duhet të krijohet një kufizim të tillë, e jo një indeks.
Për të verifikuar ndryshimet tona, shkruam një test të thjeshtë:
- tabela me kufizim të vonuar dhe një regjistrim;
- në mënyrë ciklike fusim të dhëna që bien ndesh me regjistrimin ekzistues;
- po bëjmë update – të dhënat tani nuk janë më në konflikt;
- komitimi i ndryshimeve.
krijo tavolinen test_table
(
  id serial,
  val int,
  kushti uk_test_table__val unik (val) deferrable fillimisht i çuar mbrapa
);
SHKRUAJ në test_table (val) VLERAT (0);
Për i NGA 1..10000 LOOP
  fillo
    SHKRUAJ në test_table VLERAT (0) KTHE ID në v_id;
    UPDATE test_table vendos val = i ku id = v_id;
    COMMIT;
  FUND;
END LOOP;
Versioni origjinal i pg_repack gjithmonë binte në regjistrin e parë, versioni i përmirësuar punonte pa gabime. Shumë mirë.
Shkoni në prodhim dhe përsëri marrim një gabim në të njëjtën fazë të kopjimit të të dhënave nga tabela log në të re:
$ ./pg_repack -t tablename -o id
INFO: po ribëhet tavolina "tablename"
ERROR: kërkesa dështoi:
    ERROR: vlera e dyfishuar e çelësit shkel kufizimin unik "index_16508"
DETALJ:  Çelësi (id, index)=(100500, 42) ekziston tashmë.
Situata klasike: në ambientet testuese gjithçka funksionon, por në prodhim – jo?!
APPLY_COUNT dhe ndërprerja e dy grupeve
Filluam të analizojmë kodin fjalë për fjalë dhe zbuluam një moment të rëndësishëm: derdhja e të dhënave nga tabela log në të re ndodh me grupe, konstanta APPLY_COUNT tregonte madhësinë e grupit:
për (;;)
{
num = apply_log(connection, table, APPLY_COUNT);

nëse (num > MIN_TUPLES_BEFORE_SWITCH)
     vazhdo;
 /* mund të ketë ende disa tuple, përsërit. */
...
}
Problemi është se të dhënat e transaksionit origjinal, në të cilin disa operacione mund potencialisht të shkelin kufizimin, gjatë transferimit mund të përfundojnë në ndërprerjen e dy grupeve – gjysma e komandave do të jetë e angazhuar në grupin e parë, ndërsa gjysma tjetër – në të dytin. Dhe këtu si do që të ndodhë: nëse komandat në grupin e parë nuk shkelin asgjë, atëherë gjithçka është mirë, por nëse shkelin – ndodh një gabim.
APPLY_COUNT është 1000 regjistrime, që shpjegon pse testet tona kaluan me sukses – ato nuk mbulonin rastin e "ndryshimit të grupeve". Ne përdorëm dy komanda – insert dhe update, kështu që 500 transaksione, për dy komanda, gjithmonë vendoseshin në grup dhe nuk patëm probleme. Pas shtimit të azhurnimit të dytë, ndryshimi ynë pushoi së punuari:
PËR i NGA 1..10000 LOOP
  fillo
    SHKRUAJ në test_table VLERAT (1) KTHE ID në v_id;
    UPDATE test_table vendos val = i ku id = v_id;
    UPDATE test_table vendos val = i ku id = v_id; -- një azhurnim më shumë
    COMMIT;
  FUND;
END LOOP;
Pra, detyra e ardhshme është që të bëjmë që të dhënat nga tabela origjinale, të cilat u ndryshuan në një transaksion, të kalonin gjithashtu në tabelën e re brenda të njëjtit transaksion.
Heqja dorë nga batching
Në këtë rast, kishim sërish dy opsione zgjidhjeje. E para: le të heqim dorë krejtësisht nga ndarja në grupe dhe të bëjmë transferimin e të dhënave me një transaksion. Në favor të kësaj zgjidhjeje ishte thjeshtësia e saj – ndryshimet e nevojshme në kod janë minimale (për më tepër, në versionet më të vjetra, pg_reorg funksiononte pikërisht në këtë mënyrë). Por ka një problem — krijojmë një transaksion të gjatë, dhe kjo, siç u tha më parë, është një kërcënim për shfaqjen e bloat-it të ri.
E dyta — një zgjidhje më e komplikuar, por ndoshta më e saktë: të krijojmë në tabelën log një kolonë me identifikuesin e atij transaksioni që shtoi të dhënat në tabelë. Kështu, gjatë kopjimit të të dhënave, ne do të mund të grumbullojmë ato sipas këtij atributi dhe të garantojmë që ndryshimet e lidhura të transferohen së bashku. Grupi do të formohet nga disa transaksione (ose një e madhe) dhe madhësia e tij do të varirojë në varësi të sasisë së të dhënave që janë ndryshuar në këto transaksione. Është e rëndësishme të theksohet se, pasi të dhënat nga transaksione të ndryshme hyjnë në tabelën log në një rend të rastësishëm, nuk do të jetë më e mundur ta lexojmë atë në mënyrë të rregullt, siç ishte më parë. seqscan gjatë çdo kërkese me filtrimin sipas tx_id - është shumë e shtrenjtë, ne kemi nevojë për një indeks, por dhe ai do ta ngadalësojë metodën për shkak të kostove të saj të përditësimit. Në përgjithësi, si gjithmonë duhet të sakrifikojmë diçka.
Pra, vendosëm të fillojmë me opsionin e parë, si më të thjeshtin. Së pari, duhej të kuptonim nëse transaksioni i gjatë do të ishte një problem i vërtetë. Duke qenë se transferimi kryesor i të dhënave nga tabela e vjetër në të re po bëhej gjithashtu në një transaksion të gjatë, pyetja u transformua në “sa do ta rrisim këtë transaksion?” Zgjatja e transaksionit të parë varet kryesisht nga madhësia e tabelës. Zgjatja e re – nga sa shumë ndryshime do të grumbullohen në tabelë gjatë periudhës së transferimit të të dhënave, dmth nga intensiteti i ngarkesës. Rregullimi i pg_repack u realizua gjatë ngarkesës minimale në shërbim, dhe sasia e ndryshimeve ishte asnjëherë e krahasueshme me volumet origjinale të tabelës. Vendosëm se mund të injorojmë kohëzgjatjen e transaksionit të ri (për krahasim, mesatarisht është 1 orë dhe 2-3 minuta).
Eksperimentet ishin pozitive. Aktivizimi në prodhim gjithashtu. Për qartësi – një imazh me madhësinë e një prej bazave pas rregullimit:
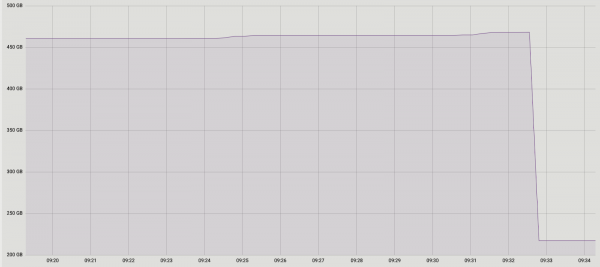
Për sa kohë që kjo zgjidhje na përmbushi plotësisht, ne nuk u përpoqëm të realizonim të dytën, por po shqyrtojmë mundësinë e diskutimit të saj me zhvilluesit e zgjerimit. Përshkak se përmirësimi ynë aktual, fatkeqësisht, ende nuk është i gatshëm për publikim, pasi ne zgjidhëm problemin vetëm me kufizime të veçanta të shtyra, dhe për një patch të plotë është e nevojshme të bëhet mbështetje e llojeve të tjera. Shpresojmë se do të arrijmë ta realizojmë këtë në të ardhmen.
Ndoshta keni pyetur pse ne u angazhuam në këtë histori me përmirësimin e pg_repack, dhe nuk filluam të përdorim alternativat e tij? Në një moment, edhe ne menduam për këtë, por përvoja pozitive e përdorimit të tij më parë, në tabela pa kufizime të shtyra, na motivoi të përpiqeshim të kuptonim thelbin e problemit dhe ta rregullojmë atë. Për më tepër, për të përdorur zgjidhje të tjera gjithashtu kërkohet kohë për të kryer teste, prandaj ne vendosëm që së pari të përpiqeshim ta rregullojmë problemin në të, dhe nëse kuptojmë se nuk do të jemi në gjendje ta bëjmë këtë në një kohë të arsyeshme, atëherë do të fillojmë të shqyrtojmë alternativat.
Përfundimet
Çfarë mund të rekomandojmë nga përvoja jonë:
- Monitoroni bloat-in tuaj. Në bazë të të dhënave të monitorimit do të mund të kuptoni sa mirë është konfiguruar autovacuum.
- Konfiguroni AUTOVACUUM-in për të mbajtur bloat-in në një nivel të pranueshëm.
- Nëse bloat-i ende rritet dhe nuk mund ta mposhtni atë me mjete "në kuti", mos e frikësoni të përdorni zgjerime të jashtme. E rëndësishme është që të testoni gjithçka mirë.
- Mos kini frikë të përmirësoni zgjidhje të jashtme sipas nevojave tuaja – ndonjëherë kjo mund të jetë më efektive dhe madje më e lehtë se sa ndryshimi i kodit tuaj.
Burimi: habr.com
