

— një mekanizëm shumë i fuqishëm dhe të dobishëm, nëse veprimet e njëjta bëhen 'thellë' mbi të dhënat e lidhura. Por rekursioni i pakontrolluar është një e keqe që mund të çojë ose në ekzekutimin e pafund të procesit, ose (çka ndodh më shpesh) në ‘shkrirjen’ e gjithë memories së disponueshme.
Baza e të dhënave në këtë drejtim operojnë sipas të njëjtave principe — 'thanë të gërmoj, unë po gërmoj' . Kërkesa juaj mund të ngadalësojë jo vetëm proceset përreth, duke zënë vazhdimisht burimet e procesorit, por gjithashtu mund të 'ngrejë' të gjithë bazën,e cila 'ha' gjithë memorien e disponueshme. Prandaj mbrojtja nga rekursioni i pafund është detyrë e zhvilluesit.
Në PostgreSQL, mundësia për të përdorur kërkesa rekursive përmes u shfaq që në kohët e vona të versionit 8.4, por ende mund të hasen rregullisht 'kërkesa të pambrojtura' potencialisht të cenueshme. Si të shpëtojmë nga probleme të tilla?
Mos shkruani kërkesa rekursive
Por shkruani të pa-rekursive. Me respekt, K.O. juaj.
Në të vërtetë, PostgreSQL ofron një numër të konsiderueshëm funksionaliteti, që mund të shfrytëzohet për të jo aplikuar rekursioni.
Përdorni një qasje krejt tjetër për problemin
Ndonjëherë mund të shikoni thjesht problemin 'nga një kënd tjetër'. Një shembull i tillë unë e kam përmendur në artikullin — shumëzimi i një seti numrash pa përdorur funksione të agregimit të personalizuara:
ME REKURSIVE src SI (
  SELECT '{2,3,5,7,11,13,17,19}'::integer[] arr
)
, T(i, val) SI (
  SELECT
    1::bigint
  , 1
UNION ALL
  SELECT
    i + 1
  , val * arr[i]
  FROM
    T
  , src
  WHERE
    i <= array_length(arr, 1)
)
SELECT
  val
FROM
  T
ORDER BY -- renditje e rezultatit final
  i DESC
LIMIT 1;
Kjo kërkesë mund të zëvendësohet me një variant nga njohësit e matematikës:
ME src SI (
  SELECT unnest('{2,3,5,7,11,13,17,19}'::integer[]) prime
)
SELECT
  exp(sum(ln(prime)))::integer val
FROM
  src;
Përdorni generate_series në vend të cikleve
Le të themi se na qëndron para një problemi për të gjeneruar të gjitha prefikset e mundshme për vargun 'abcdefgh':
ME REKURSIVE T SI (
  SELECT 'abcdefgh' str
UNION ALL
  SELECT
    substr(str, 1, length(str) - 1)
  FROM
    T
  WHERE
    length(str) > 1
)
TABELA T;
A është e nevojshme rikursioni këtu?.. Nëse shfrytëzojmë LATERAL dhe generate_series, atëherë as CTE nuk do të nevojiten:
SELECT
  substr(str, 1, ln) str
FROM
  (VALUES('abcdefgh')) T(str)
, LATERAL(
    SELECT generate_series(length(str), 1, -1) ln
  ) X;
Ndryshoni strukturën e BDs
Për shembull, keni një tabelë mesazhesh në forum me lidhjet se kush iu përgjigj kujt ose tema në :
KRIJONI TABELEN mesazh(
  mesazh_id
    uuid
      KLAVË E VETME
, përgjigje_në
    uuid
      REFERENCË në mesazh
, trupi
    tekst
);
KRIJONI INDEKSE NË mesazh(përgjigje_në); 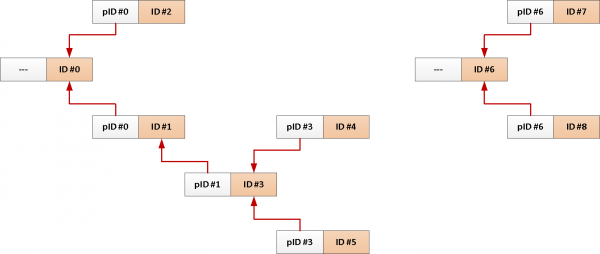
Një pyetje tipike për të ngarkuar të gjitha mesazhet për një temë duket afërsisht kështu:
ME RECURSIVE T AS (
  ZGJEDH
    *
  NGA
    mesazh
  KU
    mesazh_id = $1
BASHKOHU TË GJITHA
  ZGJEDH
    m.*
  NGA
    T
  BASHKOHUNI
    mesazh m
      NË m.përgjigje_në = T.mesazh_id
)
TABELA T;
Por, për shkak se gjithmonë na nevojitet e gjithë tema nga mesazhi rrënjor, pse të mos shtojmë identifikatorin e tij në çdo shënim automatikisht?
-- shtojmë një fushë me identifikatorin e përbashkët të temës dhe një indeks për të
MODIFIKOHEN TABELA mesazh
  SHTO FUSHËN theme_id uuid;
KRIJONI INDEKSE NË mesazh(theme_id);

-- inicializojmë identifikatorin e temës në trigger gjatë insertimit
KRIJONI OSE ZËVENDËSONI FUNKSIONIN ins() KTHEN TRIGGER AS $$
FILLIM
  NEW.theme_id = RASTISHT
    NËSE NEW.përgjigje_në ËSHTË NULL ATËHERË NEW.mesazh_id -- e marrim nga ngjarja fillestare
    PËRNDYSHË ( -- ose nga mesazhi që përgjigjemi
      ZGJEDH
        theme_id
      NGA
        mesazh
      KU
        mesazh_id = NEW.përgjigje_në
    )
  MARRIN;
  KTHEN NEW;
FUND;
$$ GJUHA plpgsql;

KRIJONI TRIGGER ins PARA INSERTIT
  NË mesazh
    PËR ÇDO RRESHT
EKZEKUTO PROCEDURËN ins(); 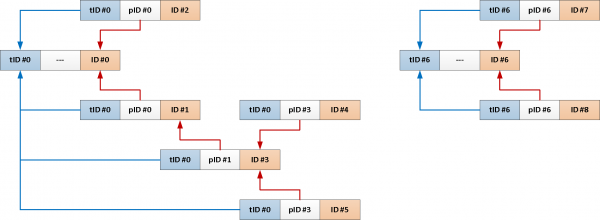
Tani, gjithë pyetja jonë rekurzive mund të reduktohet vetëm në këtë:
ZGJEDH
  *
NGA
  mesazh
KU
  theme_id = $1;
Përdorni "kufizues" aplikativë
Nëse për ndonjë arsye nuk mund të ndryshojmë strukturën e bazës, le të shohim se çfarë mund të mbështetem, në mënyrë që ndonjë gabim në të dhëna të mos çojë në ekzekutimin e pafund të rekursivitetit.
Numëruesi "thellësisë" së rekursivitetit
Thjesht rrisim numëruesin me një në çdo hap të rekursivitetit deri në momentin që arrijmë kufirin, të cilin e konsiderojmë si të papranueshëm:
ME RECURSIVE T AS (
  ZGJEDH
    0 i
  ...
BASHKOHU TË GJITHA
  ZGJEDH
    i + 1
  ...
  KU
    T.i < 64 -- kufiri
)
Pro: Në përpjekjen për t'u cikluar, ne gjithsesi do të bëjmë jo më shumë se kufiri i përcaktuar i iteracioneve "thellë".
Kundra: Nuk ka garanci se nuk do të përpunojmë përsëri të njëjtën shënim — për shembull, në thellësinë 15 dhe 25, dhe më pas çdo +10. Edhe për "gjerë" asnjë gjë nuk u premtua.
Formalisht, një kështu rekurzivitet nuk do të jetë i pafund, por nëse në çdo hap numri i shënimeve rritet eksponencialisht, ne të gjithë e dimë se çfarë ndodh...
Ruajtësi "rrugës"
Radhitshëm shtojmë të gjitha identifikatorët që na takojnë në rrugën e rekursivitetit në një массив që është "rruga" unike deri te ai:
ME RECURSIVE T AS (
  ZGJEDH
    ARRAY[id] rruga
  ...
BASHKOHU TË GJITHA
  ZGJEDH
    rruga || id
  ...
  KU
    id  T.rruga -- nuk përputhet me asnjë prej
)
Pro: Nëse ka një cikël në të dhëna, ne me siguri nuk do ta përpunojmë sërish të njëjtën regjistër brenda një rruge.
Kundra: Por megjithatë mund të kalojmë përmes të gjitha regjistrimeve, pa u përsëritur.
Kufizimi i gjatë të rrugës
Për të shmangur situatën e "wanderings" në thellësi të paqartë recursioni, ne mund të kombinojmë dy metodat e mëparshme. Ose, nëse nuk duam të mbajmë fusha të panevojshme, ta plotësojmë kushtin për vazhdimin e recursioni me një vlerësim të gjatë të rrugës:
ME RECURSIVE T SI (
  SELECT
    ARRAY[id] path
  ...
UNION ALL
  SELECT
    path || id
  ...
  KU
    id  ALL(T.path) DHE
    array_length(T.path, 1) < 10
)
Zgjidhni metodën sipas shijes tuaj!
Burimi: habr.com
