

Për shkak të natyrës së punës, përballë situatave kur një zhvillues shkruan një kërkesë dhe mendon "baza është e mençur, do t'i zgjidhë vetë çdo gjë!"«
Në disa raste (pjesërisht për shkak të mosnjohjes së mundësive të DB, pjesërisht për shkak të optimizimeve të parakohshme) ky qasje sjell në krijimin e "frankenshtainëve".
Fillimisht do të sjell një shembull të tillë të kërkesës:
-- për çdo çift kyç gjejmë vlerat e asociuara të fushave
WITH RECURSIVE cte_bind AS (
  SELECT DISTINCT ON (key_a, key_b)
    key_a a
  , key_b b
  , fld1 bind_fld1
  , fld2 bind_fld2
  FROM
    tbl
)
-- gjejmë min/max vlerat për çdo kyç të parë
, cte_max AS (
  SELECT
    a
  , max(bind_fld1) bind_fld1
  , min(bind_fld2) bind_fld2
  FROM
    cte_bind
  GROUP BY
    a
)
-- lidhim sipas kyçit të parë çiftet kyçe dhe min/max-vlerat
, cte_a_bind AS (
  SELECT
    cte_bind.a
  , cte_bind.b
  , cte_max.bind_fld1
  , cte_max.bind_fld2
  FROM
    cte_bind
  INNER JOIN
    cte_max
      ON cte_max.a = cte_bind.a
)
SELECT * FROM cte_a_bind;
Për të vlerësuar cilësinë e kërkesës në mënyrë substanciale, le të krijojmë një grup të rastësishëm të të dhënave:
CREATE TABLE tbl AS
SELECT
  (random() * 1000)::integer key_a
, (random() * 1000)::integer key_b
, (random() * 10000)::integer fld1
, (random() * 10000)::integer fld2
FROM
  generate_series(1, 10000);
CREATE INDEX ON tbl(key_a, key_b);
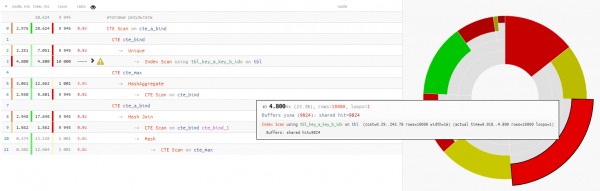
Duket se vetë leximi i të dhënave zuri më pak se një katror të gjithë kohës së realizimit të kërkesës:
Le të analizojmë në detaje
Të shohim me kujdes kërkesën dhe të çuditemi:
- Pse është këtu WITH RECURSIVE, nëse nuk ka CTE-rekurzive?
- Pse të grupohen min/max-vlerat në një CTE të veçantë, nëse pastaj ato lidheshin përsëri me zgjedhjen origjinale?
+25% kohë - Pse të përdoret në fund kërkesa e përsëritur nga CTE e mëparshme përmes ‘SELECT * FROM’?
+14% kohë
Në këtë rast na ndihmoi shumë që për bashkimin u zgjodh Hash Join, e jo Nested Loop, sepse ndryshe do të kishim një kalim të vetëm të CTE Scan, por 10K!
pak për CTE ScanKëtu duhet të kujtojmë se CTE Scan është ekuivalenti i Seq Scan -- dmth pa ndonjë indeksem, vetëm për të bërë një përzgjedhje të plotë, e cila do të kërkonte 10K x 0.3ms = 3000ms në ciklet e cte_max ose 1K x 1.5ms = 1500ms në ciklet e cte_bind!
Në realitet, çfarë donim të merrnim në rezultat? Po, zakonisht ky është pikërisht pyetja që viziton diku në minutën e 5-të të analizës së kërkesave "trekatëshe".
Donim për çdo çift unik kyç të nxirrnim min/max nga grupi sipas key_a.
Le të përdorim për këtë :
SELECT DISTINCT ON(key_a, key_b)
	key_a a
,	key_b b
,	max(fld1) OVER(w) bind_fld1
,	min(fld2) OVER(w) bind_fld2
FROM
	tbl
WINDOW
w AS (PARTITION BY key_a); 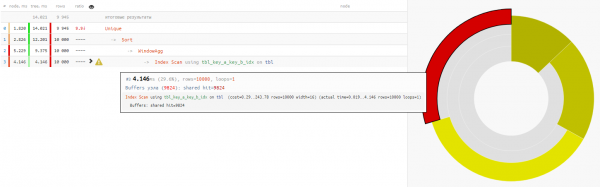
Duke leximi i të dhënave në të dy variantet zë rreth 4-5ms, kështu që gjithçka që fitojmë në kohë -32% — është krejtësisht ngarkesë, e hequr nga CPU i bazës, nëse një kërkesë e tillë ekzekutohet mjaft shpesh.
Në përgjithësi, nuk duhet ta detyroni bazën të "mbajë të rrumbullakët, të rrotullojë katrorin".
Burimi: habr.com
