

Në SQL, ju përshkruani «çfarë» dëshironi të merrni, dhe jo «si» duhet të zbatohet. Prandaj, problemi i zhvillimit të pyetjeve SQL në stilin «si dëgjohet, ashtu shkruhet» mban vendin e tij të nderuar, së bashku me .
Sot do të shohim disa shembuj të thjeshtë se ku mund të çojë kjo në kontekstin e përdorimit të GROUP/DISTINCT dhe KUFIZO së bashku me ta.
Ja, nëse shkruani në pyetje «së pari bashkoni këto tabela, pastaj heqni të gjithë dublikatë, duhet të mbetet vetëm një exemplar për çdo çelës» — pikërisht kështu do të funksionojë, edhe nëse bashkimi nuk ishte i nevojshëm fare.
Dhe ndonjëherë ndihmohet dhe kjo «thjesht funksionon», ndonjëherë—ka një efekt negativ në performancë, e ndonjëherë jep rezultate krejtësisht të papritura për zhvilluesin.
Epo, ndoshta jo aq spektakolar, por…
«Çifti i ëmbël»: JOIN + DISTINCT
SELECT DISTINCT
  X.*
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
WHERE
  Y.bool_condition;
Duket e qartë se çfarë dëshironin të merrni ato regjistrime X, për të cilat në Y ka lidhje me kushtin e ekzekutuar. e kishim shkruar pyetjen përmes JOIN — morëm disa vlera pk disa herë (aq sa ishin regjistrimet përkatëse në Y). Si ta heqim? Sigurisht DISTINCT!
Veçanërisht «gëzon» kur për çdo regjistrim X ndodhen disa qindra regjistrime të lidhura Y, dhe pastaj heroikisht hiqen dublikatë…
Si ta rregullojmë? Së pari, duhet të kuptojmë se detyra mund të modifikohet në «të marrë regjistrimet X, për të cilat në Y ka TË PAKTË NËNJË lidhje me kushtin e ekzekutuar» — sepse nga regjistrimi Y nuk na nevojitet asgjë.
EXISTS e vendosur
SELECT
  *
FROM
  X
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  );
Disa versione të PostgreSQL kuptojnë se në EXISTS është mjaft të gjejnë regjistrimin e parë që del, versionet më të vjetra — jo. Prandaj, unë preferoj gjithmonë të specifikoj LIMIT 1 brenda EKZISTON.
LATERAL JOIN
SELECT
  X.*
FROM
  X
, LATERAL (
    SELECT
      Y.*
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  ) Y
WHERE
  Y IS DISTINCT FROM NULL;
Ky opsion gjithashtu lejon, nëse është e nevojshme, të kthehet menjëherë ndonjë të dhënë nga regjistrimi i lidhur Y që u gjet. Një variant i ngjashëm është shqyrtuar në artikullin .
«Pse të paguajmë më shumë»: DISTINCT [ON] + LIMIT 1
Një avantazh tjetër i tillë të transformimeve të pyetjes është mundësia për të kufizuar lehtësisht shfrytëzimin e regjistrave, nëse nevojiten vetëm një/s disa prej tyre, si në rastin e mëposhtëm:
SELECT DISTINCT ON(X.pk)
  *
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Tani lexojmë pyetjen dhe përpiqemi të kuptojmë se çfarë propozohet të bëjë DBMS:
- bashkojmë tabelat
- e unikizojmë sipas X.pk
- nga regjistrat e mbetur zgjedhim një të vetëm
Pra, çfarë morëm? „Një regjistër të caktuar“ nga të unikizuarit — dhe sikur ta marrim këtë një nga ata që nuk janë unikë, rezultatet do të ndryshonin ndonjëherë?.. „E nëse nuk ka dallime, përse të paguajmë më shumë?“
SELECT
  *
FROM
  (
    SELECT
      *
    FROM
      X
    -- këtu mund të fusim kushte të përshtatshme
    LIMIT 1 -- +1 Limit
  ) X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Dhe një temë e ngjashme me GROUP BY + LIMIT 1.
„Më duhet vetëm të pyes”: GROUP implicit + LIMIT
Këto gjëra ndodhin në kontrollin e ndryshueshmërisë tabelës ose CTE gjatë ekzekutimit të pyetjeve: ... CASE WHEN ( SELECT count(*) FROM X LIMIT 1 ) = 0 THEN ...
Funksionet agreguese ( count/min/max/sum/...) përfundojnë me sukses në të gjithë grupin, edhe pa një tregues të dukshëm. Por me GRUPIM NGAnuk janë shumë të lidhura. KUFIZO Programuesi mund të mendojë
„po nëse ka regjistra, atëherë më duhet jo më shumë se LIMIT“ . Por nuk është ashtu! Sepse për bazën e të dhënave, kjo është:numëro se çfarë duan
- për të gjitha regjistrat kthe sa rreshta kërkohen
- Në varësi të kushteve të synuara, këtu është e përshtatshme të bëhet një nga zëvendësimet:
(count + LIMIT 1) = 0
NOT EXISTS(LIMIT 1)në(count + LIMIT 1) > 0EXISTS(LIMIT 1)nëcount >= N(SELECT count(*) FROM (... LIMIT N))në„Sa të varfër në gramë”: DISTINCT + LIMIT
SELECT DISTINCT pk FROM X LIMIT $1
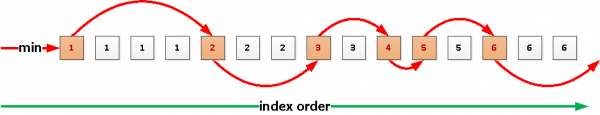
Programuesi naiv mund të mendojë sinqerisht se ekzekutimi i pyetjes do të ndalet,sa herë që të gjejmë $1 vlerat e para të rastësishme të ndryshme Në të ardhmen, mund të funksionojë në këtë mënyrë falë nyjës së re.
Index Skip Scan , implementimi i së cilës tani po zhvillohet, por për momentin - jo.Për momentin, fillimisht
do të nxirren të gjitha regjistrat , do të unikizohen, dhe vetëm nga ato do të kthehet aq sa është kërkuar. Sidomos është e trishtueshme nëse dëshironim diçka si, dhe regjistrat në tabelë — qindra mijëra… $1 = 4Që të mos trishtohemi kot, le të përdorim pyetjen rikursive
„DISTINCT për të varfrit” nga PostgreSQL Wiki :
Burimi: habr.com
