

Për herë pas here, zhvilluesi ka nevojë të dërgojë një grup parametrash në kërkesë ose madje një sërsish të plotë në hyrje. Ndonjëherë, hasen zgjidhje të çuditshme për këtë problem.
Le të shikojmë "nga e kundërta" dhe të shohim se si nuk duhet bërë, pse, dhe si mund të bëhet më mirë.
Ngritja e drejtpërdrejtë e vlerave në trupin e kërkesës
Duket zakonisht kështu:
query = "SELECT * FROM tbl WHERE id = " + value... ose kështu:
query = "SELECT * FROM tbl WHERE id = :param".format(param=value)Për këtë metodë është thënë, shkruar dhe në sasi të mjaftueshme:
Gati gjithmonë kjo është -- një rrugë e drejtpërdrejtë drejt SQL-injeksioneve dhe një ngarkesë e tepruar në logjikën e biznesit, e cila është e detyruar "të ngjisë" vargun e kërkesës tuaj.
Një qasje e tillë mund të justifikohet pjesërisht vetëm në rastin e nevojës për përdorimin e segmentimit në versionet PostgreSQL 10 dhe më poshtë për të marrë një plan më efektiv. Në këto versione, lista e segmenteve që skanohet përcaktohet ende pa marrë parasysh parametrat e dërguar, vetëm mbi bazën e trupit të kërkesës.
$n-argumentet
Përdorimi parametrat - kjo është mirë, ajo lejon përdorimin e , duke reduktuar ngarkesën si në logjikën e biznesit (në vargun e kërkesës formohet dhe dërgohet vetëm një herë), ashtu edhe në serverin e DB (nuk kërkohet analizë dhe planifikim i përsëritur për çdo instancë të kërkesës).
Numri i ndryshueshëm i argumenteve
Problemet do të na presin kur të dëshirojmë të dërgojmë një numër të panjohur më parë argumentesh:
... id IN ($1, $2, $3, ...) -- $1 : 2, $2 : 3, $3 : 5, ...Nëse e lëmë kërkesën në këtë formë, atëherë kjo do të na mbrojë nga injeksionet potenciale, por prapë do të çojë në nevojën e ngjitjes/analisë së kërkesës për çdo variant nga numri i argumenteve.Tani është më mirë, se sa ta bëjmë këtë çdo herë, por mund të kalojmë edhe pa këtë.
Mjafton të dërgohet vetëm një parametr, që përmban paraqitjen e serializuar të një array:
... id = ANY($1::integer[]) -- $1 : '{2,3,5,8,13}'Dallimi i vetëm - nevoja për të konvertuar parametrin në tipin e duhur të array. Por kjo nuk shkakton probleme, pasi ne gjithashtu e dimë paraprakisht se ku po drejtohemi.
Dërgimi i një grumbulli (matricës)
Zakonsht, kjo është çdo formë e dërgimit të grupeve të dhënash për t'u futur në bazën "me një kërkesë":
INSERT INTO tbl(k, v) VALUES($1,$2),($3,$4),...Përveç problemeve të përshkruara më sipër me "ngjitjen" e kërkësës, kjo mund të na çojë gjithashtu në jashtë memories dhe rënies së serverit. Arsyeja është e thjeshtë — nën argumentet PG rezervon memorie shtesë, dhe numri i regjistrimeve në grupin e rezultateve është i kufizuar vetëm nga dëshirat e logjikës së biznesit. Në raste veçanërisht klinike, kam parë argumente "numerike" më shumë se $9000 - nuk e bëni kështu.
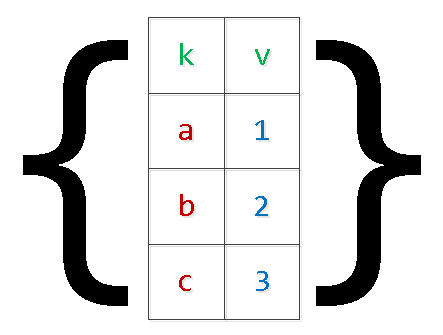
Do ta ripëshkruajmë kërkesën, duke aplikuar tashmë serializimin "me dy nivele":
INSERT INTO tbl
SELECT
  unnest[1]::text k
, unnest[2]::integer v
FROM (
  SELECT
    unnest($1::text[])::text[] -- $1 : '{"{a,1}","{b,2}","{c,3}","{d,4}"}'
) T;
Po, në rastin e "vlerave të komplikuara" brenda një array, ato duhet të janë të rrethuar me thonjëza.
E qartë se në këtë mënyrë mund të "zhvillohet" një zgjedhje me një numër të rastësishëm fushash.
unnest, unnest, …
Herë pas here gjejmë variante të kalimit të disa "array-ve kolonnash" në vend të "array-ve me array" shumëfishe, për të cilat kam përmendur :
SELECT
  unnest($1::text[]) k
, unnest($2::integer[]) v;
Me këtë metodë, nëse gaboni gjatë krijimit të listave të vlerave për kolonat e ndryshme, është shumë e lehtë të merrni rezultate krejtësisht të papritura, të varura gjithashtu nga versioni i serverit:
-- $1 : '{a,b,c}', $2 : '{1,2}'
-- PostgreSQL 9.4
k | v
-----
a | 1
b | 2
c | 1
a | 2
b | 1
c | 2
-- PostgreSQL 11
k | v
-----
a | 1
b | 2
c |
JSON
Që nga versioni 9.3, PostgreSQL ka të gjitha funksionet për të punuar me tipin json. Prandaj, nëse definimi i parametrave hyrëse ndodh në shfletues, mund të formoni drejtpërdrejt objektin json për kërkesën SQL:
SELECT
  key k
, value v
FROM
  json_each($1::json); -- '{"a":1,"b":2,"c":3,"d":4}'
Për versionet e mëparshme, mund të përdorni të njëjtin metodë për each(hstore), por "përmbledhja" e saktë me ekranuar objekte të komplikuara në hstore mund të shkaktojë probleme.
json_populate_recordset
Nëse e dini paraprakisht se të dhënat nga "array json" do të shkojnë për të mbushur ndonjë tabelë, mund të kurseni shumë në "deshifrimin" e fushave dhe shndërrimin në tipet e nevojshme, duke përdorur funksionin json_populate_recordset:
SELECT
  *
FROM
  json_populate_recordset(
    NULL::pg_class
  , $1::json -- $1 : '[{"relname":"pg_class","oid":1262},{"relname":"pg_namespace","oid":2615}]'
  );
json_to_recordset
Ky funksion thjesht "zhvillon" array-in e objekteve të dhëna në zgjedhje, pa u mbështetur në formatin e tabelës:
SELECT
  *
FROM
  json_to_recordset($1::json) T(k text, v integer);
-- $1 : '[{"k":"a","v":1},{"k":"b","v":2}]'
k | v
-----
a | 1
b | 2
TABEL TEMPORARE
Por nëse volumi i të dhënave në zgjedhjen e dërguar është shumë i madh, atëherë të futet në një parametr të vetëm të serializuar — është e vështirë, ndonjëherë edhe e pamundur, pasi kërkon një ndarje të madhe të memorie. Për shembull, ju nevojitet të grumbulloni për një kohë të gjatë një paketë të madhe të dhënash për ngjarjet nga një sistem të jashtëm, dhe më pas dëshironi ta përpunoni atë një herë në anën e DB.
Në këtë rast, zgjidhja më e mirë është përdorimi i :
CREATE TEMPORARY TABLE tbl(k text, v integer);
...
INSERT INTO tbl(k, v) VALUES($1, $2); -- përsëritni shumë-mjaft herë
...
-- këtu bëjmë diçka të dobishme me të gjithë këtë tabelë në tërësi
Mënyra është e mirë pikërisht për kalimin e rrallë të sasisë së madhe të dhënave.
Nga pikëpamja e përshkrimit të strukturës së të dhënave tuaja, tabela përkohshme dallon nga "tabela e zakonshme" vetëm në një tipar në tabelën sistematike pg_class, ndërsa në pg_type, pg_depend, pg_attribute, pg_attrdef, ... — kështu që asgjë.
Prandaj, në sistemet web me një numër të madh të lidhjeve të shkurtra, për secilën nga ato tabela do të prodhojë regjistrime të reja sistemike çdo herë, të cilat hiqen me mbylljen e lidhjes me DB. Si rezultat, përdorimi i pa kontrolluar i TEMP TABLE çon në "mbushjen" e tabelave në pg_catalog dhe ngadalësimin e shumë operacioneve që i përdorin ato.
Natyrisht, me këtë mund të luftojmë përmes kalimit të rregullt VACUUM FULL në tabelat e katalogut sistemor.
Variablat e sesionit
Le të supozojmë se përpunimi i të dhënave nga rasti i mëparshëm është mjaft i ndërlikuar për një kërkesë SQL, por dëshirojmë ta bëjmë atë mjaft shpesh. Kështu, ne duam të përdorim përpunimin proceduror në , por përdorimi i transmetimit të të dhënave përmes tabelave të përkohshme do të ishte tepër i kushtueshëm.
Përdorimi i parametrave $n për të transmetuar në blokun anonim gjithashtu nuk do të na ndihmojë. Të zgjidhim situatën do të na ndihmojnë variablat e sesionit dhe funksioni current_setting.
Para versionit 9.2, duhej të konfigurohej paraprakisht custom_variable_classes për "variablat" e vet sesionet. Në versionet aktuale mund të shkruani pak a shumë kështu:
SET my.val = '{1,2,3}';
DO $$
DECLARE
  id integer;
BEGIN
  FOR id IN (SELECT unnest(current_setting('my.val')::integer[])) LOOP
    RAISE NOTICE 'id : %', id;
  END LOOP;
END;
$$ LANGUAGE plpgsql;
-- NOTICE:  id : 1
-- NOTICE:  id : 2
-- NOTICE:  id : 3
Në gjuhët e tjera procedurale të mbështetura, mund të gjeni edhe zgjidhje të tjera.
Dini ndonjë mënyrë tjetër? Ndani në komentet!
Burimi: habr.com
