

Mijëra menaxherë nga zyrat e shitjeve në të gjithë vendin regjistrojnë në çdo ditë dhjetëra mijëra kontakte — fakte të komunikimit me klientët potencialë ose ata që tashmë punojnë me ne. Dhe për këtë klient duhet fillimisht ta gjejmë, dhe është e dëshirueshme që ta bëjmë shumë shpejt. Kjo ndodh shpesh nëpërmjet emrit.
Prandaj nuk është e çuditshme që, duke analizuar sërish "kërkesat e rënda" në një nga bazat më të ngarkuara — llogarinë tonë , kam zbuluar "në majë" kërkesën për "kërkimin e shpejtë" sipas emrit për kartat e organizatave.
Dhe hulumtimi i mëtejshëm zbuloi një shembull interesant fillimisht të optimizimit dhe më pas të degradimit të performancës të kërkesës gjatë përmirësimit të saj të vazhdueshëm nga disa ekipe, çdo njëra prej të cilave vepronte ekskluzivisht me qëllime të mira.
0: çfarë donte përdoruesi
 [KDPV ]
Çfarë nënkupton zakonisht përdoruesi kur flet për "kërkimin e shpejtë" sipas emrit? Pothuajse kurrë nuk është "kërkimi i ndershëm" sipas një nënstrinje si ... LIKE '%rosë%' — përndryshe në rezultat merren jo vetëm 'Rosalia' dhe 'Dyqan Rosa', por edhe 'Grosë' dhe madje 'Shtëpia e Dedë Morosë'.
Përdoruesi e nënkupton në një nivel të zakonshëm se ju do t'i siguroni kërkimin sipas fillimit të fjalës në emër dhe do të tregoni më të relevuara ato që fillojnë me ato që është futur. Dhe do ta bëni këtë praktikisht menjëherë — me hyrje për substrat.
1: kufizojmë detyrën
Dhe për më tepër, nuk ka asnjë shans që një njeri të futë veçmas 'roz dyqan', për të kërkuar çdo fjalë sipas prefiksit. Jo, për përdoruesin është shumë më e lehtë të reagojë ndaj sugjerimit të shpejtë për fjalën e fundit sesa të "mos e mbushë" me qëllim fjalët e mëparshme — shikoni sesi çdo motor kërkimi e bën këtë.
Në përgjithësi, është e drejtë të formulojmë kërkesat për detyrën — më shumë se gjysma e zgjidhjes. Ndonjëherë një analizë e kujdesshme e rastit të përdorimit .
Çfarë bën zhvilluesi abstrakt?
1.0: motorin e kërkimit të jashtëm
Oh, searching is hard, I don't even want to deal with it — let's hand it off to devops! Let them set up an external search system relative to the database: Sphinx, ElasticSearch,…
It's a workable option, although labor-intensive in terms of synchronization and timely changes. But not in our case, since the search is carried out for each client only within the data of their account. And the data has quite high variability — and if now the manager has added a card 'Rose Store', in 5-10 seconds he may remember that he forgot to include the email and want to find and correct it.
So, let's search "directly in the database". Fortunately, PostgreSQL allows us to do this in multiple ways — we will explore them.
1.1: "honest" substring
We focus on the word "substring". Indeed, there is an excellent for indexed searching by substring (and even by regular expressions!) Only then we will need to sort it correctly.
Let's take a simple table for our model:
CREATE TABLE firms(
  id
    serial
      PRIMARY KEY
, name
    text
);
We insert 7.8 million records of real organizations and index them:
CREATE EXTENSION pg_trgm;
CREATE INDEX ON firms USING gin(lower(name) gin_trgm_ops);
Let's search for the first 10 records for substring search:
SELECT
  *
FROM
  firms
WHERE
  lower(name) ~ ('(^|\s)' || 'rose')
ORDER BY
  lower(name) ~ ('^' || 'rose') DESC -- first "those starting with"
, lower(name) -- the rest alphabetically
LIMIT 10;
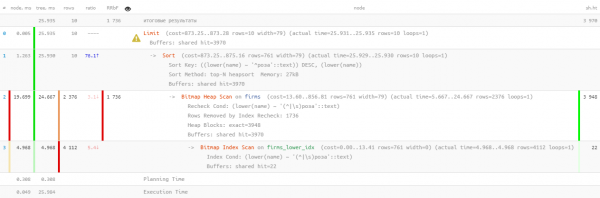
Well, something like that… 26ms, 31MB of read data and more than 1.7K filtered records — for 10 sought. The overhead is too high, can't we do it more efficiently?
1.2: searching by text? Isn't that FTS!
Indeed, PostgreSQL provides a very powerful (Full Text Search), including prefix search capabilities. A great option, and no need to install extensions! Let's give it a try:
CREATE INDEX ON firms USING gin(to_tsvector('simple'::regconfig, lower(name)));SELECT
*
FROM
firms
WHERE
to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'rose:*')
ORDER BY
lower(name) ~ ('^' || 'rose') DESC
, lower(name)
LIMIT 10; 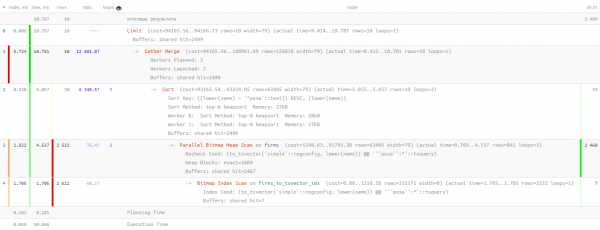
Here, parallel execution of the query helped us a bit, cutting the time in half to 11ms. And we had to read 1.5 times less — just 20MB. Këtu, më pak është më mirë, sepse sa më shumë informacion të shfletojmë, aq më të larta janë shanset për të pasur cache miss, dhe çdo faqe e lexuar e cila është e tepërt nga disku është një potencial "ngadalësim" për kërkesën.
1.3: A të përdorim LIKE?
Të gjitha kërkesat e mëparshme janë të mira, por nëse e tërheqim atë njëqind mijë herë në ditë, atëherë do të akumulohet 2TB të dhënash të lexuara. Në rastin më të mirë, nga memoria, por nëse nuk kemi fat, atëherë edhe nga disku. Pra, le të provojmë ta bëjmë më të vogël.
Le të kujtojmë se përdoruesi dëshiron të shohë fillimisht "atë që fillon me ...". Pra, kjo është në forma të pastër nëpërmjet text_pattern_ops! Dhe vetëm nëse nuk kemi "mjaft" deri në 10 regjistrat e kërkuar, atëherë do të duhet t’i lexojmë ato me kërkimin FTS:
KRIJO INDIREKT NË firmat(lower(name) text_pattern_ops);Zgjedh
*
Për
firmat
KU
lower(name) LIKE ('roza' || '%')
KUFIZO 10; 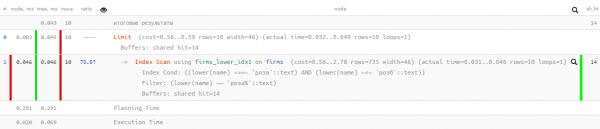
Të dhëna të shkëlqyera — vetëm 0.05ms dhe pak më shumë se 100KB të lexuara! Por ne harrojmë renditjen sipas emrit, në mënyrë që përdoruesi të mos humbasë në rezultatet:
Zgjedh
  *
Për
  firmat
KU
  lower(name) LIKE ('roza' || '%')
RENDIT NGA
  lower(name)
KUFIZO 10; 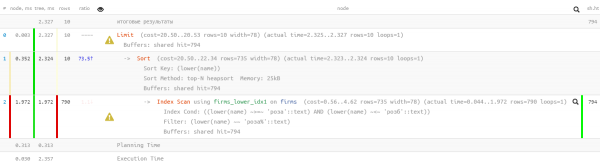
Ooh, diçka nuk është më kaq e bukur — duket se ka një indeks, por renditja po kalon përtej tij... Natyrisht, tashmë është shumë më efektive se opsioni i mëparshëm, por...
1.4: "të përmirësohet me skrap"
Por ekziston një indeks që lejon të kërkosh në mënyrë të rregullt dhe të përdorësh renditjen në mënyrë të duhur — indeksi btree!
KRIJO INDIREKT NË firmat(lower(name));Vetëm se kërkesa për të do të duhet "të ndërtohet manualisht":
Zgjedh
  *
Për
  firmat
KU
  lower(name) >= 'roza' DHE
  lower(name) <= ('roza' || chr(65535)) -- për UTF8, për një-byte - chr(255)
RENDIT NGA
   lower(name)
KUFIZO 10; 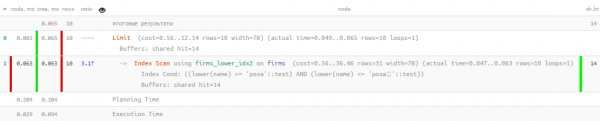
Shkëlqyeshëm — dhe renditja funksionon, dhe konsumi i burimeve ka mbetur "mikroskopik" më efektive një mijë herë se "FTS i pastër"! E vetmja gjë që duhet të bëjmë është të mbledhim në një kërkesë të vetme:
(
  Zgjedh
    *
  Për
    firmat
  KU
    lower(name) >= 'roza' DHE
    lower(name) <= ('roza' || chr(65535)) -- për UTF8, për kodet e një-byte - chr(255)
  RENDIT NGA
     lower(name)
  KUFIZO 10
)
UNION ALL
(
  Zgjedh
    *
  Për
    firmat
  KU
    to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'roza:*') DHE
    lower(name) NOT LIKE ('roza' || '%') -- "që fillon me" ne e gjetëm më lart
  RENDIT NGA
    lower(name) ~ ('^' || 'roza') DESC -- përdorim të njëjtin renditje, për të mos kaluar në indeksin btree
  , lower(name)
  KUFIZO 10
)
KUFIZO 10;
Vërej se, nënkërkesa e dytë ekzekutohet vetëm nëse e para kthen më pak nga sa pritej të fundit KUFIZO numri i rreshtave. Për këtë mënyrë optimizimi të kërkesave kam .
Saktë, tani kemi në tabelë njëkohësisht btree dhe gin, por statistikat tregojnë se më pak se 10% e kërkesave arrijnë në ekzekutimin e bllokut të dytë. Pra, me këto kufizime të njohura përpara, arritëm të reduktojmë konsumimin e burimeve të serverit pothuajse në mijëra herë!
1.5*: do ta kalojmë pa dorëzë
Më lart LIKE na pengoi përdorimi i renditjes së gabuar. Por mund ta 'orientojmë në rrugën e duhur' me ndihmën e operatorit USING:
Për parazgjedhje, nënkuptohet
ASC. Për më tepër, mund të caktoni emrin e operatorit specifik të renditjes në propoziminUSING. Operatorët e renditjes duhet të jenë anëtarë të familjes së operatorëve B-tree të 'më pak' ose 'më shumë'.ASCzakonisht është e barabartë meUSING <dheDESCzakonisht është e barabartë meUSING >.
Në rastin tonë 'më pak' është ~<~:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('rozë' || '%')
ORDER BY
  lower(name) USING ~<~
LIMIT 10; 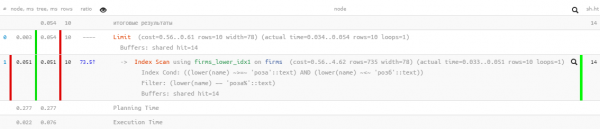
2: si 'fermentohen' kërkesat
Tani e lëmë kërkesën tonë të 'nastohet' për gjashtë muaj deri në një vit, dhe me habi e gjejmë përsëri në 'top' me treguesit e konsumit të përditshëm të 'përmirësimit' të memories (buffers shared hit) në 5.5TB — domethënë më shumë se sa ishte në fillim.
Jo, sigurisht, dhe biznesi ynë është rritur, si dhe ngarkesa është rritur, por jo aq shumë! Kështu që, është diçka këtu që nuk është në rregull — le të merremi me këtë.
2.1: lindja e paginimit
Në një moment, një ekip tjetër zhvilluesish dëshiron të bëjë të mundur që nga kërkimi i shpejtë të 'kalohet' në regjistrin me të njëjtat por rezultate të zgjeruara. Dhe cila është regjistri pa navigim faqe për faqe? Le ta shtojmë!
( ... LIMIT  + 10)
UNION ALL
( ... LIMIT  + 10)
LIMIT 10 OFFSET ;
Tani ishte e mundur të shfaqnim regjistrin e rezultateve të kërkimit me 'ngarkim faqe për faqe' pa ndonjë vështirësi për zhvilluesin.
Sigurisht, në të vërtetë, për çdo faqe të re të dhënash, lexohen gjithnjë e më shumë (të gjitha nga hera e kaluar që do t'i heqim, plus 'bishtin' e nevojshëm) — që do të thotë se kjo është një antipatër dhe më e drejtë do të ishte të fillonim kërkimin në iteracionin e ardhshëm nga kyçja e mbajtur në ndërfaqe, por për këtë do të flasim një herë tjetër.
2.2: dëshira për egzotizëm
Në një moment zhvilluesi dëshiron të pasurojë zgjedhjen e rezultateve me të dhëna nga tabela tjetër, për të cilin të gjithë kërkesa e mëparshme u dërgua në CTE:
ME Q AS (
  ...
  LIMIT  + 10
)
SELECT
  *
, (SELECT ...) sub_query -- një pyetje për tryezën e lidhur
FROM
  q
LIMIT 10 OFFSET ;
Madje, ashtu — nuk është keq, sepse pyetja e brendshme llogaritet vetëm për 10 regjistrimet që kthehen, po sikur të mos ishte...
2.3: DISTINCT pa kuptim dhe pa mëshirë
Diku gjatë këtij procesi të evoluimit nga nënpyetja e 2-të u humb NOT LIKE kushti. Është e qartë se pas kësaj UNION ALL filloi të kthente disa regjistrime dy herë — në fillim të gjetur sipas fillimit të vargut, dhe pastaj përsëri — sipas fillimit të fjalës së parë të atij vargu. Në limit, të gjitha regjistrimet e nënpyetjes 2 mund të përputhen me regjistrimet e para.
Çfarë bën zhvilluesi në vend të kërkimit të arsyes?.. Jo një pyetje!
- do ta zgjerojmë dyfish madhësinë e grupeve fillestare
- do të aplikojmë DISTINCT, në mënyrë që të kemi vetëm një ekzekutim të çdo rreshti
ME Q AS (
  ( ... LIMIT  + 10)
  UNION ALL
  ( ... LIMIT  + 10)
  LIMIT  + 10
)
SELECT DISTINCT
  *
, (SELECT ...) sub_query
FROM
  q
LIMIT 10 OFFSET ;
Pra, është e qartë se rezultati, në fund, është pikërisht i njëjtë, por shansi për të 'shkëputur' në nënpyetjen e 2-të CTE është rritur ndjeshëm, dhe pa këtë, lexohet qartë më shumë.
Por kjo nuk është trishtimi më i madh. Sepse zhvilluesi kërkoi të seleksionojë DISTINCT jo sipas të dhënave specifike, por direkt sipas të gjithë fushave regjistrimet, kështu që automatikisht ra në fushën sub_query — rezultati i nënpyetjes. Tani, për të realizuar DISTINCT, baza duhej të kryente tashmë jo 10 nënpyetje, por të gjitha + 10!
2.4: kooperimi mbi të gjitha!
Ja si jetonin zhvilluesit — pa u shqetësuar, sepse në regjistrin 'të rrisin' N të rëndësishme në mënyrë kronike për të përshpejtuar marrjen e secilës 'faqe' të re për përdoruesin, qartë nuk kishin durim.
Derisa iu erdhi zhvilluesit nga një departament tjetër, dhe nuk deshën të shfrytëzojnë këtë metodë të përshtatshme për kërkimin iterativ — dmth marrim një copë nga një grup, filtrojmë sipas kushteve shtesë, vizatojmë rezultatin, pastaj copën tjetër (gjë që në rastin tonë arrihet duke rritur N), dhe kështu deri sa ta mbushim ekranin.
Në përgjithësi, në ekzemplarin e kapur N arriti vlera gati në 17K, dhe brenda një dite u ekzekutuan 'në zinxhir' jo më pak se 4K kërkesa të tilla. Të fundit prej tyre e skanuan me guxim tashmë sipas 1GB memorjeje në çdo iteracion…
Përveç kësaj
Burimi: habr.com
