

Veçoritë e funksionimit të mekanizmave të brendshëm të PostgreSQL e lejojnë atë të jetë shumë i shpejtë në disa situata dhe "jo shumë" në të tjera. Sot do të ndalemi në një shembull klasik të konfliktit midis mënyrës si funksionon DBMS dhe asaj që bën me të zhvilluesi — UPDATE vs parimet MVCC.
Në përmbledhje, historia nga :
Kur një rresht ndryshohet me komandën UPDATE, në fakt kryhen dy operacione: DELETE dhe INSERT. Në versionin aktual të rreshtit vendoset xmax, i barabartë me numrin e transaksionit që kryen UPDATE. Pastaj krijohet versioni i ri i njëjtë rreshti; vlera xmin në të është e barabartë me vlerën xmax të versionit të mëparshëm.
Pas njëfarë kohe pas përfundimit të kësaj transaksioni, versioni i vjetër ose i ri, në varësi të COMMIT/ROLLBACK, do të pranohet si "të vdekur" (dead tuples) në procesin VACUUM në tabelë dhe do të pastruar.
Por kjo nuk do të ndodhë menjëherë, kurse problemet me "të vdekurit" mund të lindin shumë shpejt — gjatë përditësimeve të shumta ose në një tabelë të madhe, dhe pak më vonë mund të përballeni me situatën që dhe .
#1: I Like To Move It
Imagine se metoda juaj në logjikën e biznesit funksionon mirë, dhe papritur kupton se duhet të përditësojë fushën X në një regjistrim:
UPDATE tbl SET X = WHERE pk = $1;Pastaj, gjatë ekzekutimit, zbulon se duhet të përditësojë gjithashtu fushën Y:
UPDATE tbl SET Y = WHERE pk = $1;… dhe pastaj edhe Z — pse të mos e bëjmë këtë?
UPDATE tbl SET Z = WHERE pk = $1;Sa versione të kësaj regjistrimi kemi tani në bazë? Aha, 4 copë! Prej tyre një është aktuale, dhe 3 do t'i pastroni pas jush [auto]VACUUM.
Mos e bëni kështu! Përdorni përditësimin e të gjitha fushave me një kërkesë — pothuajse gjithmonë logjika e funksionit mund të ndryshohet kështu:
UPDATE tbl SET X = , Y = , Z = WHERE pk = $1;#2: Use IS DISTINCT FROM, Luke!
Pra, ju tërhoqi gjithsesi dëshira të (ndërsa zbatoni skriptin ose konvertorin, për shembull). Dhe në skript dërgohet diçka si kjo:
UPDATE tbl SET X = WHERE pk BETWEEN $1 AND $2;Në këtë format, kjo kërkesë haset mjaft shpesh dhe pothuajse gjithmonë jo për të mbushur një fushë të re bosh, por për të korrigjuar ndonjë gabim në të dhëna. Në të njëjtën kohë, vetë saktësia e të dhënave ekzistuese, thuajse nuk merret parasysh — dhe kot! Do të thotë se regjistrimi ri-shkruhet, edhe nëse aty ishte pikërisht ajo që donte — e pse? Ndryshojmë:
UPDATE tbl SET X = WHERE pk BETWEEN $1 AND $2 AND X IS DISTINCT FROM ; Më shumë njerëz nuk janë të informuar për ekzistencën e një operatori kaq të mrekullueshëm, prandaj këtu është një shënim për IS DISTINCT FROM dhe operatorët e tjerë logjikë për ndihmë:
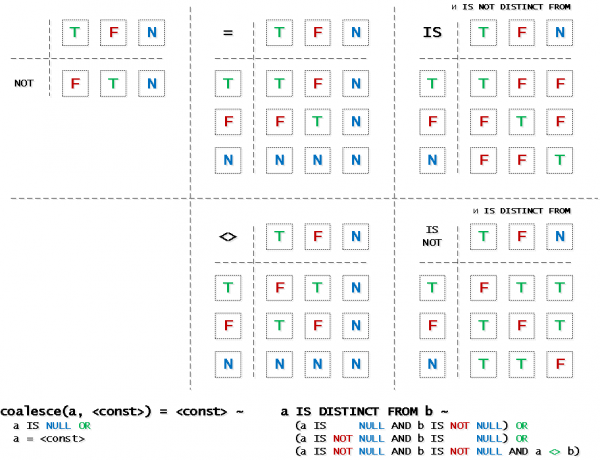
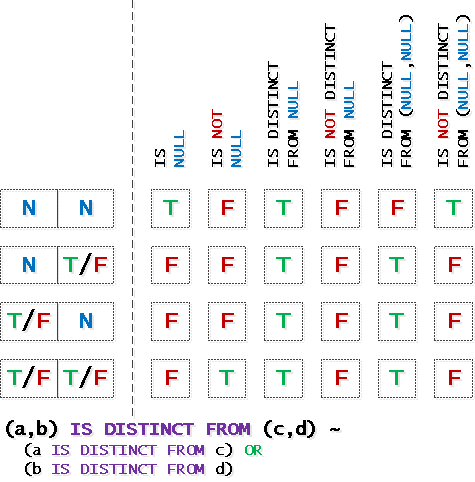
… dhe pak për operacionet mbi shprehjet e ndërlikuara: ROW()-shprehje:
#3: А я милого узнаю по… блокировке
Nisin dy procese paralele identike, secili prej të cilëve përpiqet të shënojë në shkrim se ai është 'në punë':
UPDATE tbl SET processing = TRUE WHERE pk = $1;Edhe nëse këto procese bëjnë pavarësisht nga njëra-tjetra, në kuadër të një ID, në këtë kërkesë klienti i dytë 'do të bllokohet' derisa të përfundojë transaksioni i parë.
Zgjidhja №1: detyra është reduktuar në të mëparshmen
Thjesht shtojmë përsëri IS DISTINCT FROM:
UPDATE tbl SET processing = TRUE WHERE pk = $1 AND processing IS DISTINCT FROM TRUE;Në këtë formë, kërkesa e dytë thjesht nuk do të ndryshojë asgjë në bazë të të dhënave, pasi aty gjithçka është 'siç duhet' – prandaj dhe bllokimi nuk do të ndodhë. Më pas, fakti i 'mosgjetjes' së shkrimit trajtohet në algoritmin aplikativ.
Zgjidhja №2: bllokada këshilluese
Një temë e madhe për një artikull të veçantë, në të cilin mund të lexoni për .
Zgjidhja №3: thirrje pa[kuptim]
Por me të vërtetë duhet të ndodhë puna e përbashkët me të njëjtin shkrim? Или вы все-таки накосячили с алгоритмами вызовов бизнес-логики со стороны клиента, например? А если подумать?..
Burimi: habr.com
