

Përkthimi i artikullit është përgatitur veçanërisht për studentët e kursit .
Në javët e fundit, ne kemi shtuar në formatin binar të transmetimit, duke plotësuar formatin ekzistues të skedarëve për akses të rastësishëm/IPC. Ne kemi implementime në Java dhe C++ dhe lidhje për Python. Në këtë artikull do të shpjegoj se si funksionon formati dhe do të tregoj si mund të arrihet një kapacitet shumë i lartë i transmetimit të të dhënave për DataFrame pandas.
Transmetimi i të dhënave kolonare
Një pyetje e zakonshme që marr nga përdoruesit e Arrow është ajo për kostot e larta të transferimit të grupeve të mëdha të të dhënave tabelare nga formati i orientuar drejt rreshtave apo regjistrave në formatin kolonare. Për datasetet shumëgiga, transponimi në memorie ose në disk mund të jetë një detyrë e papërballueshme.
Për transmetimin e të dhënave, pavarësisht nëse të dhënat përshtaten me rreshta apo kolona, një nga mundësitë mbetet dërgimi i paketeve të vogla të rreshtave, secila përmban brenda renditjen në kolona.
Në Apache Arrow, një koleksion i grupeve kolonare në memorie, që përfaqëson një bllok tabelar, quhet paketë regjistrash (record batch). Për t'i dhënë një strukturë të vetme të dhënash në formën e një tabele logjike, mund të bashkohen disa paketa regjistrash.
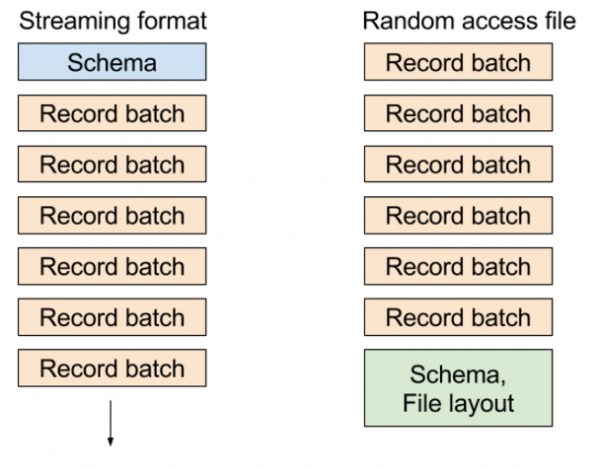
Në formatin ekzistues të skedarëve 'random access', ne shkruajmë metadata që përmban skemën e tabelës dhe pozitat e blloqeve në fund të skedarit, duke ju lejuar të zgjidhni shumë lirë çdo paketë regjistrash ose çdo kolonë nga dataseti. Në formatin e transmetimit ne dërgojmë një seri mesazhesh: skemën, dhe pastaj një ose më shumë paketa regjistrash.
Formate të ndryshme duken përafërsisht siç përshkruhet në këtë figurë:
Transmetimi i të dhënave në PyArrow: aplikimi
Për t'ju treguar se si funksionon, do të krijoj një shembull dataset që përfaqëson një bllok të transmetimit:
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = int(total_size / ncols / np.dtype('float64').itemsize)
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })
Tani, le të supozojmë se duam të shkruajmë 1 GB të dhënash, të përbërë nga blloqe me përmasa 1 MB secili, gjithsej 1024 blloqe. Fillimisht, le të krijojmë një DataFrame me përmasa 1 MB me 16 kolona:
KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

df = generate_data(MEGABYTE, NCOLS)
Pastaj unë i konvertoj në pyarrow.RecordBatch:
batch = pa.RecordBatch.from_pandas(df) Tani, do krijoj një rrjedhë dalëse që do të shkruaj në kujtesë dhe do të krijoj StreamWriter:
sink = pa.InMemoryOutputStream()
stream_writer = pa.StreamWriter(sink, batch.schema)
Më pas do të shkruajmë 1024 blloqe, të cilat përfundimisht do të formojnë 1GB të dhënash:
for i in range(DATA_SIZE // MEGABYTE):
    stream_writer.write_batch(batch)
Pasi shkruam në RAM, ne do të jemi në gjendje ta marrim të gjithë rrjedhën në një tampon:
In [13]: source = sink.get_result()

In [14]: source
Out[14]:

In [15]: source.size
Out[15]: 1074750744
Pasi këto të dhëna ndodhen në kujtesë, leximi i paketave të skedarëve Arrow bëhet një operacion zero-copy. Unë hap StreamReader, lexoj të dhënat në pyarrow.Table, pastaj i konvertit në DataFrame pandas:
In [16]: reader = pa.StreamReader(source)

In [17]: table = reader.read_all()

In [18]: table
Out[18]:

In [19]: df = table.to_pandas()

In [20]: df.memory_usage().sum()
Out[20]: 1073741904
E gjithë kjo, natyrisht, është mirë, por ndoshta keni disa pyetje. Sa shpejt ndodh kjo? Si ndikon madhësia e bllokut në performancën e marrjes së DataFrame pandas?
Performanca e transmetimit të të dhënave
Me zvogëlimin e madhësisë së bllokut të transmetimit, kostoja e rindërtimit të një kadri të vazhdueshëm kolone të DataFrame në pandas rritet për shkak të skemave të paefektshme të qasjes në memorie. Ka gjithashtu disa shpenzime për shkak të punës me struktura të dhënash C++ dhe array-t e tyre dhe tamponet e kujtesës.
Për 1 MB, siç u përmend më sipër, në notebooks-in tim (Quad-core Xeon E3-1505M) rezulton:
In [20]: %timeit pa.StreamReader(source).read_all().to_pandas()
10 loops, best of 3: 129 ms per loop
Pra, ethekuar përshkueshmëria efektive është 7.75 GB/s për rikthimin e DataFrame me volum 1GB nga 1024 blloqe prej 1MB. Çfarë ndodh nëse përdorim blloqe më të mëdha ose më të vogla? Këto janë rezultatet:
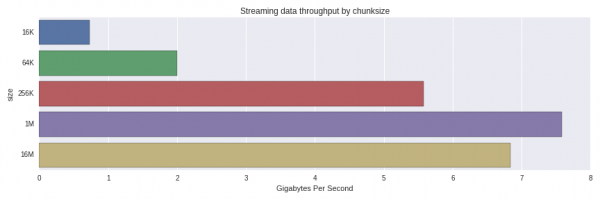
Performanca zvogëlohet ndjeshëm nga 256K në 64K blloqe. Më befason që blloqet me madhësi 1 MB u përpunuan më shpejt se ato me 16 MB. Duhet të bëhet një studim më i detajuar për të kuptuar nëse ky është një shpërndarje normale apo ndikon diçka tjetër.
Në zbatimin aktual të formatit, të dhënat nuk kompresohen në parim, prandaj madhësia në kujtesë dhe "nëpër tela" është përafërsisht e njëjtë. Në të ardhmen, kompresimi mund të bëhet një mundësi shtesë.
Përfundimi
Transmetimi i të dhënave kolonore mund të jetë një mënyrë efektive për të transferuar grupe të mëdha të dhënash në instrumentet analitikë kolonore, siç është pandas, përmes grumbujve të vogla. Shërbimet e të dhënave që përdorin një depo të orientuar drejt rreshtave mund të transmetojnë dhe transponojnë grumbuj të vegjël të dhënash, që janë më të favorshëm për caches L2 dhe L3 të procesorit tuaj.
Kodi i plotë
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = total_size / ncols / np.dtype('float64').itemsize
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })

KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

def get_timing(f, niter):
    start = time.clock_gettime(time.CLOCK_REALTIME)
    for i in range(niter):
        f()
    return (time.clock_gettime(time.CLOCK_REALTIME) - start) / NITER

def read_as_dataframe(klass, source):
    reader = klass(source)
    table = reader.read_all()
    return table.to_pandas()
NITER = 5
results = []

CHUNKSIZES = [16 * KILOBYTE, 64 * KILOBYTE, 256 * KILOBYTE, MEGABYTE, 16 * MEGABYTE]

for chunksize in CHUNKSIZES:
    nchunks = DATA_SIZE // chunksize
    batch = pa.RecordBatch.from_pandas(generate_data(chunksize, NCOLS))

    sink = pa.InMemoryOutputStream()
    stream_writer = pa.StreamWriter(sink, batch.schema)

    for i in range(nchunks):
        stream_writer.write_batch(batch)

    source = sink.get_result()

    elapsed = get_timing(lambda: read_as_dataframe(pa.StreamReader, source), NITER)

    result = (chunksize, elapsed)
    print(result)
    results.append(result)
Burimi: habr.com
